mindmap
  root((변수 제거의 3대 목적))
    통계적 관점
      ["회귀계수 해석의 안정성"]
      ["p-value 유의성 확보"]
      ["다중공선성 제거 (Multicollinearity)"]
    데이터마이닝 관점
      ["중복 정보 요약 및 압축"]
      ["잠재 패턴 및 군집 탐지"]
      ["차원 축소 (PCA / PLS)"]
    머신러닝 관점
      ["일반화 예측 성능 극대화"]
      ["과적합 방지 (Overfitting)"]
      ["추론 및 연산 비용 절감"]
0. 변수 제거의 핵심 철학: 3대 관점 통합
데이터 분석 실무에서 “불필요한 변수를 어떻게 제거할 것인가?”라는 질문은 단순히 열(Column)의 개수를 줄이는 기술적 작업이 아닙니다. 분석의 목적(해석, 요약, 예측)에 따라 ’불필요함’을 정의하는 기준이 근본적으로 달라지기 때문입니다.
0-1. 3대 분석 관점별 ’불필요한 변수’의 정의
- 통계적 관점 (목표: 모델의 명확한 해석과 추정 안정성):
- 불필요한 변수: 다른 독립변수와 정보가 지나치게 겹쳐 회귀계수의 표준오차를 부풀리고 부호를 왜곡하는 다중공선성 유발 변수, 또는 설명력에 기여하지 못하는 비유의한 변수.
- 데이터마이닝 관점 (목표: 데이터 구조 요약과 잠재 패턴 탐색):
- 불필요한 변수: 분산이 거의 없어 정보량이 0에 가깝거나, 강한 상관관계로 인해 고차원 공간에서 잡음(Noise)으로 작용하는 중복 변수.
- 머신러닝 관점 (목표: 미지의 데이터에 대한 일반화 예측 성능):
- 불필요한 변수: 학습 데이터의 지엽적인 노이즈를 모델이 억지로 암기하게 만들어 과적합(Overfitting)을 일으키고, 테스트 세트의 손실(Loss)을 증가시키는 변수.
1. 변수 선택 & 차원 축소 4대 방법론 체계 (Taxonomy)
머신러닝과 데이터 사이언스에서 특성을 정제하는 기법은 크게 변수 선택(Feature Selection)과 차원 축소(Feature Extraction)로 구분되며, 구체적으로 4가지 계열로 분류됩니다.
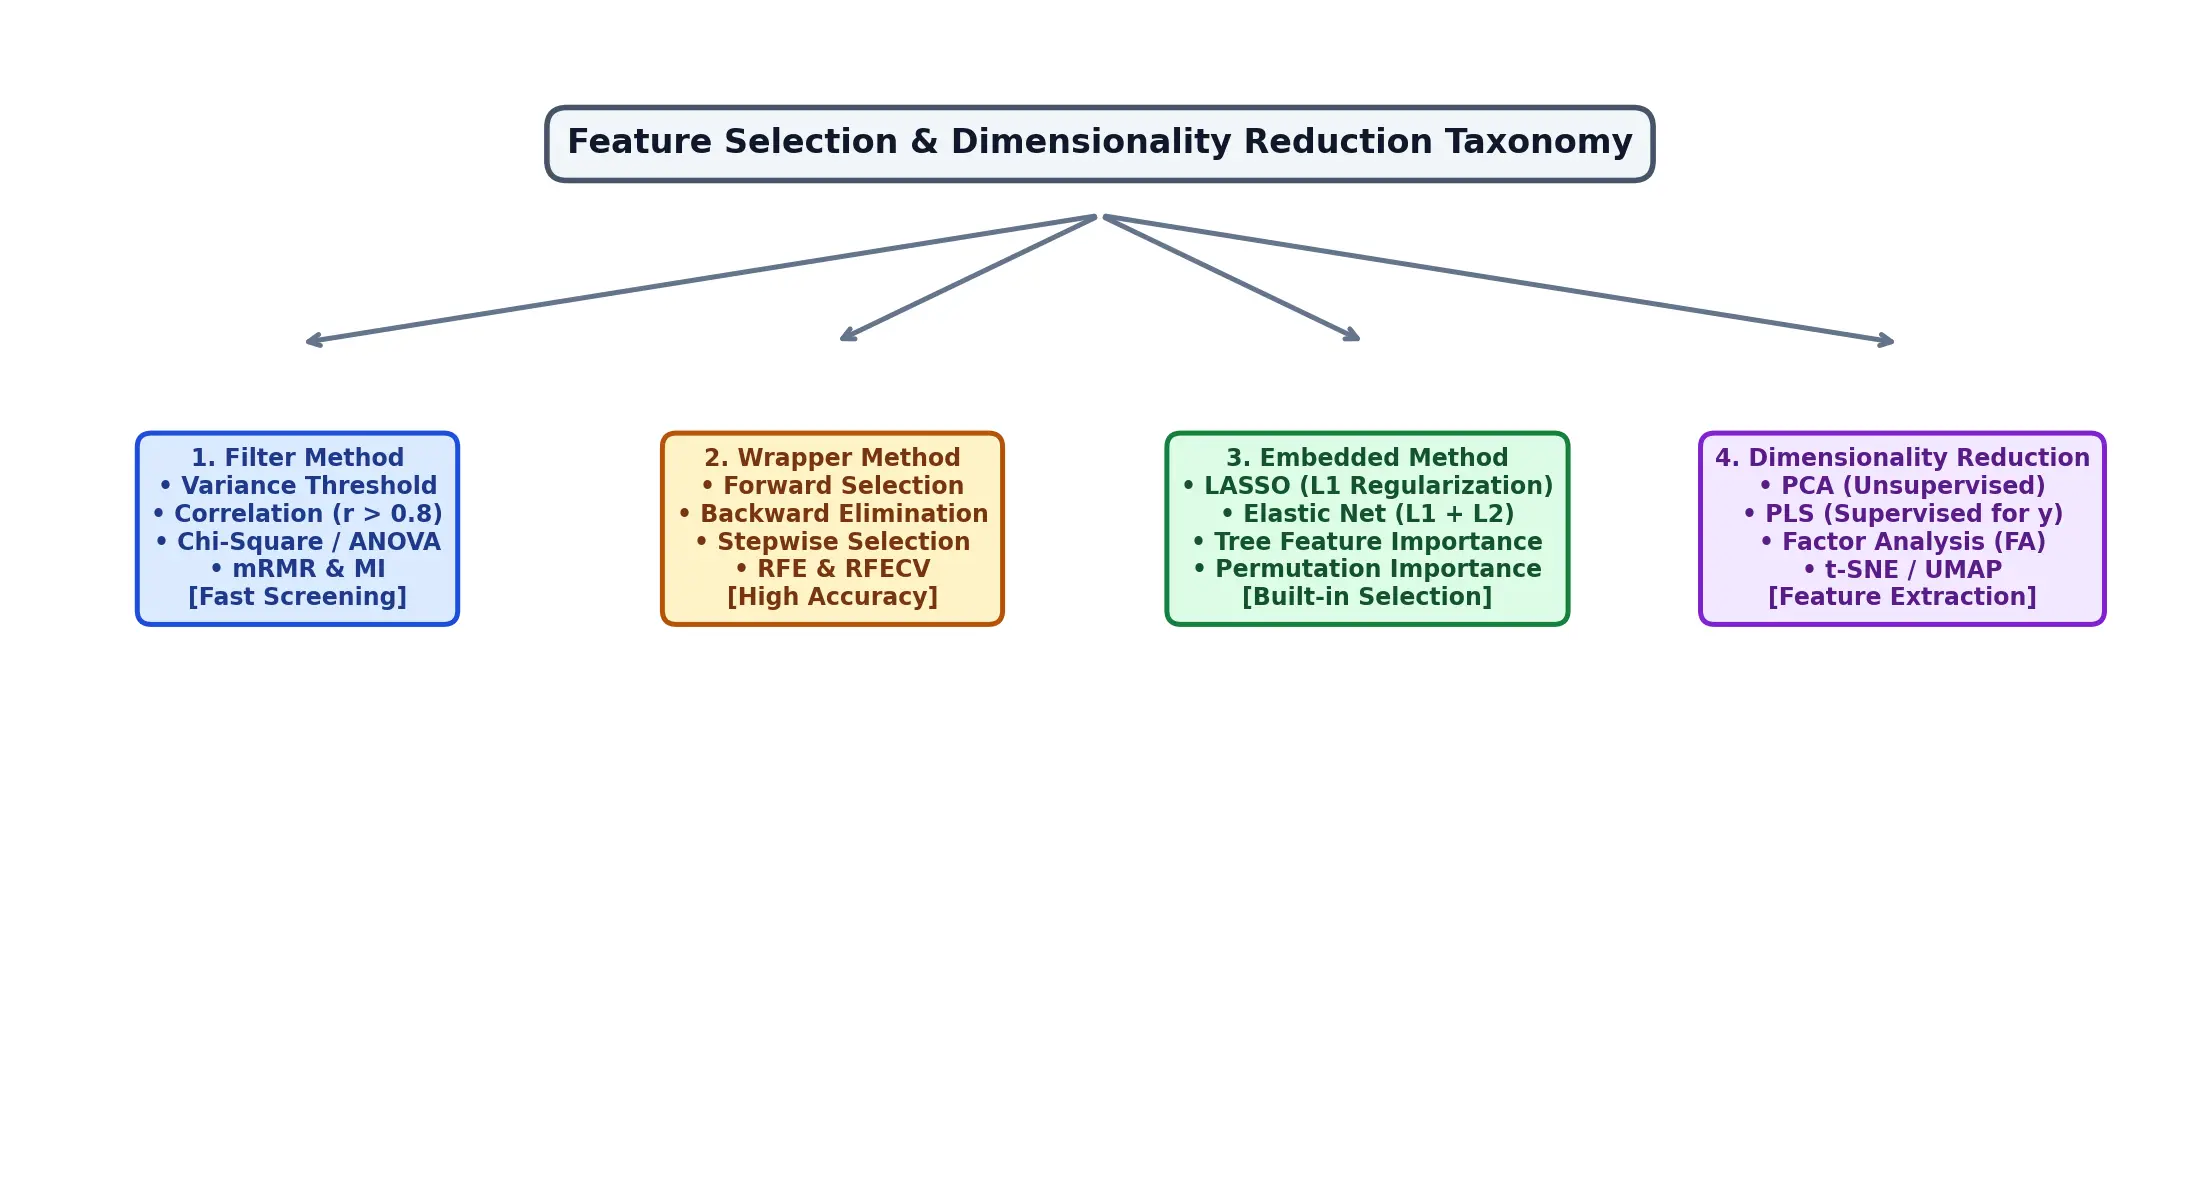
1-1. 변수 선택(Selection) vs 차원 축소(Extraction)
- 변수 선택 (Feature Selection): 기존 30개 변수 중 모델에 가장 유의미한 8개 변수를 골라 남김 \(\rightarrow\) 원래 도메인 변수의 이름과 단위가 유지되므로 해석력과 보고서 작성에 탁월.
- 차원 축소 (Feature Extraction): 기존 30개 변수를 선형/비선형 결합하여 \(PC_1, PC_2, PC_3\) 등 새로운 합성 축으로 압축 \(\rightarrow\) 다중공선성을 100% 해소하고 정보 손실을 최소화하지만, 합성 축의 도메인 의미 해석이 다소 난해함.
1-2. 4대 방법론 비교 요약표
| 계열 | 동작 메커니즘 | 대표 기법 | 장점 | 단점 및 고려사항 |
|---|---|---|---|---|
| 필터 (Filter) | 모델 학습 전 통계량 지표(분산, 상관계수, 상호정보량)로 고속 스크리닝 | 저분산 필터, Pearson/Spearman 상관분석, 카이제곱 검정, mRMR, ANOVA F-검정 | 연산 속도가 극도로 빠르고 모델 독립적 | 변수 간 상호작용 및 다변량 조합 효과 포착 불가 |
| 래퍼 (Wrapper) | 머신러닝 모델의 성능(CV Accuracy, RMSE)을 평가 지표로 삼아 변수 부분집합을 탐색 | 전진선택(Forward), 후진소거(Backward), 단계적(Stepwise), RFE, RFECV | 최종 모델과 가장 최적화된 변수 조합 탐색 | 연산량이 매우 크고 과적합 위험 존재 |
| 임베디드 (Embedded) | 모델 학습 과정의 손실 함수(Loss)에 정규화 페널티를 부여해 자체적으로 변수 도태 | LASSO (L1), Elastic Net (L1+L2), Random Forest 특성 중요도, LightGBM Gain | 모델 학습과 변수 선택이 한 번에 수행됨 | 특정 알고리즘에 종속적 |
| 차원축소 (Extraction) | 변수들을 버리지 않고 분산을 극대화하거나 타겟을 설명하는 새로운 잠재 축으로 변환 | PCA (비지도), PLS (지도형), Factor Analysis, t-SNE, UMAP | 공선성 완벽 제거, 시각화 용이 | 원본 변수의 개별 해석 불가 |
2. [방법론 1] 필터 기법 (Filter Method): 초고속 통계 스크리닝
2-1. 저분산 제거 (Variance Threshold)
모든 샘플에서 거의 동일한 값을 갖는 변수는 정보량이 없습니다. * 예: 10,000명의 고객 데이터에서 9,995명이 ’한국 국적’인 경우, 해당 변수는 분산이 거의 0에 수렴하므로 모델 학습 전에 즉시 제거합니다. * 결측치 비율이 40~50%를 초과하는 변수 역시 대체(Imputation)보다 선제적 제거를 우선 고려합니다.
2-2. 상관분석 (Correlation Analysis)과 주의사항
두 독립변수 간의 피어슨 상관계수(\(r\))가 높다면 쌍둥이 지표일 가능성이 높습니다.
[ 상관계수의 직관적 이해 ]
강한 양의 상관 (r > 0.85): ────────► 집의 '전용면적'과 '바닥면적' (하나만 남겨도 무방)
상관관계 없음 (r ≒ 0.00): ────────► '고객 연령'과 '웹사이트 체류시간' (각자 고유 정보 보존)
⚠️ 주의: 상관계수만 보고 맹목적으로 삭제하면 안 되는 이유: ’매출액’과 ’영업이익’처럼 상관계수가 높아도 비즈니스 관점에서 전혀 다른 인사이트를 제공하는 변수가 있습니다. 상관분석은 단독 삭제 도구가 아니라 “중복 후보를 추려내는 1차 스크리닝 단계”로 활용해야 합니다.
2-3. 고급 필터: mRMR (Minimum Redundancy Maximum Relevance)
mRMR은 종속변수(\(y\))와의 관련성(Relevance)은 극대화하면서, 이미 선택된 독립변수들과의 중복성(Redundancy)은 최소화하는 최적의 변수 조합을 탐욕적(Greedy)으로 찾아내는 강력한 필터 기법입니다.
3. [방법론 2] 다중공선성 진단과 VIF(분산팽창계수) 마스터
3-1. 다중공선성(Multicollinearity)이 초래하는 3대 치명적 재앙
회귀분석에서 독립변수 간 강한 선형 관계가 존재하면 다음과 같은 문제가 발생합니다: 1. 회귀계수 분산의 팽창: 추정된 계수의 표준오차가 비정상적으로 커져 신뢰구간이 지나치게 넓어집니다. 2. 유의성 하락 (p-value 왜곡): 실제로는 매우 중요한 변수임에도 불구하고 p-value가 0.05 이상으로 치솟아 무의미한 변수처럼 오판됩니다. 3. 부호 역전 (Sign Reversal): 상식적으로 양(+)의 영향을 미쳐야 하는 변수의 계수가 음(-)으로 뒤집히는 왜곡이 발생합니다.
3-2. VIF의 수학적 공식과 작동 원리
VIF(Variance Inflation Factor, 분산팽창계수)는 “어떤 독립변수 \(X_j\)가 다른 모든 독립변수들의 선형 결합으로 얼마나 잘 설명되는가?”를 측정하는 지표입니다.
\[VIF_j = \frac{1}{1 - R_j^2}\]
여기서 \(R_j^2\)는 \(X_j\)를 종속변수로 두고, 나머지 모든 독립변수들을 설명변수로 하여 적합한 보조 회귀식(Auxiliary Regression)의 결정계수입니다.
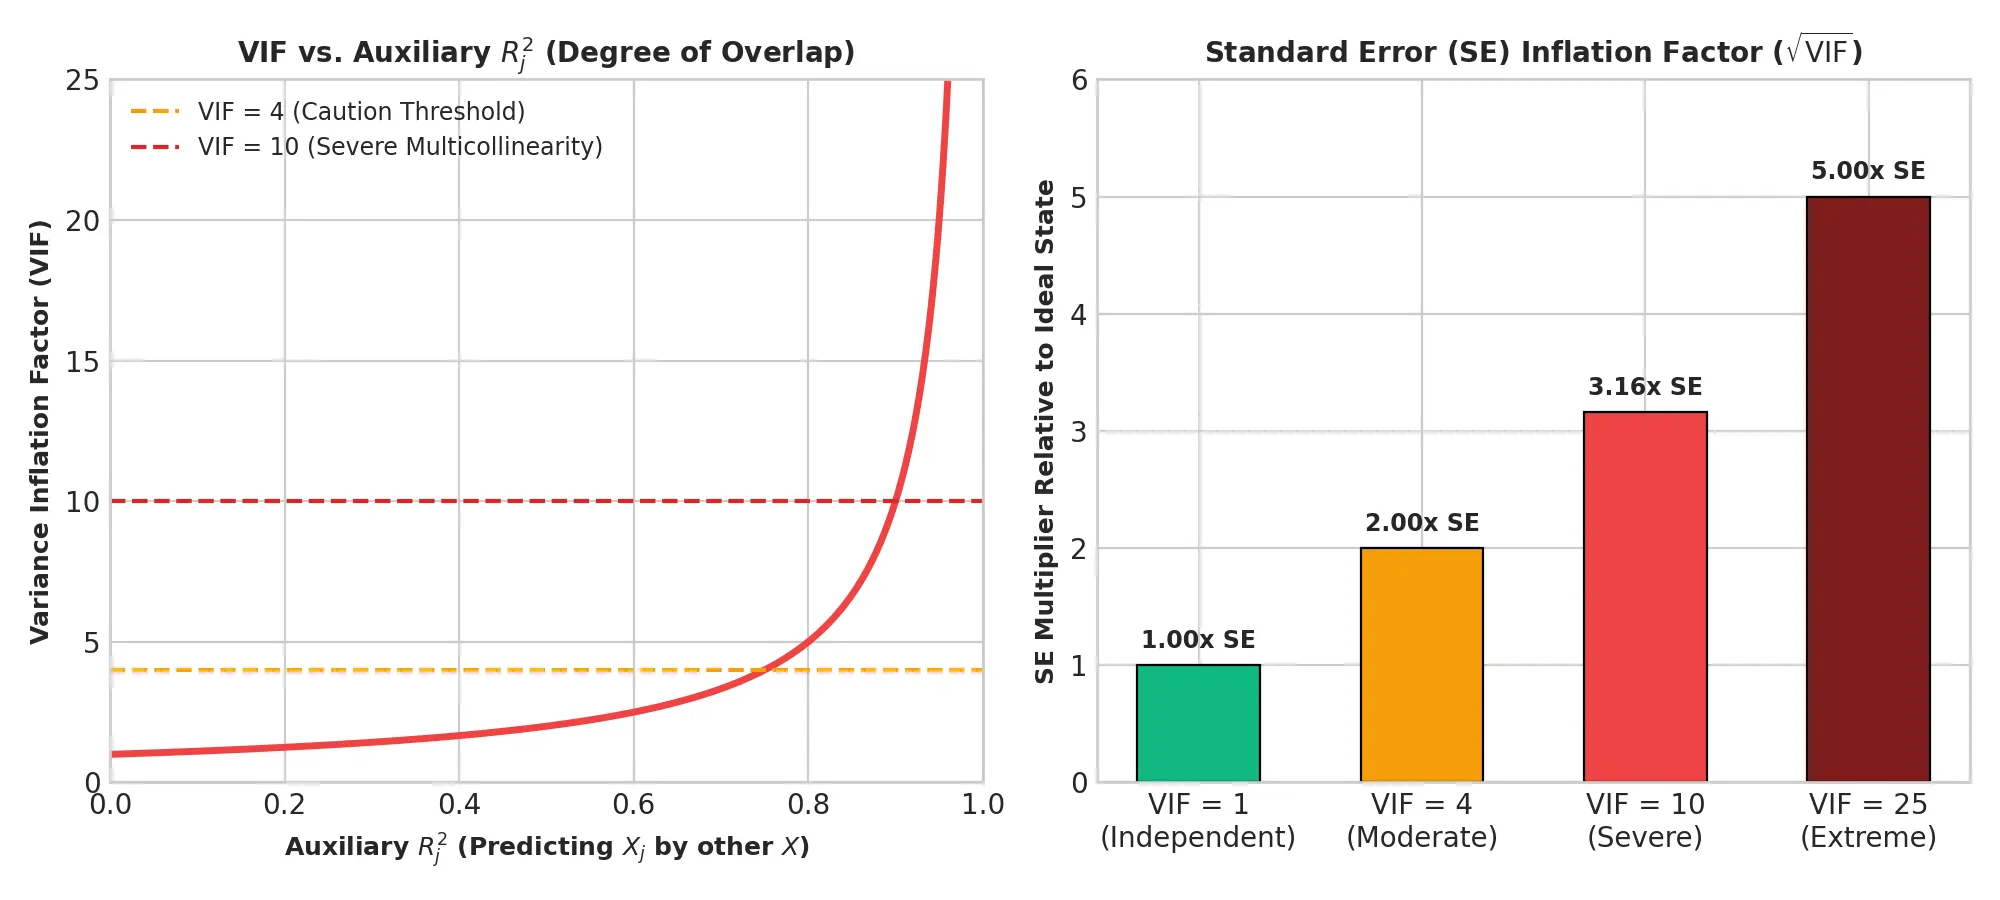
3-3. VIF 해석 기준표 (경험칙)
| VIF 값 | 다중공선성 진단 수준 | 권장 조치 사항 |
|---|---|---|
| \(VIF = 1\) | 다른 독립변수와 완전히 독립적임 | 최상의 상태, 안심하고 포함 |
| \(1 \le VIF < 4\) | 미미한 수준의 중복 존재 | 통계적 문제 없음, 모델 유지 |
| \(4 \le VIF < 10\) | 중등도 다중공선성 우려 (경고 신호) | 변수 간 상관성 확인 및 계수 안정성 추가 점검 |
| \(VIF \ge 10\) | 심각한 다중공선성 상태 (위험) | 반드시 조치 필요 (변수 삭제, 결합, 규제회귀, PCA 적용) |
3-4. 🚨 범주형 변수 포함 시: GVIF와 올바른 해석법
더미 변수로 변환되는 범주형(Factor) 변수가 포함되면 자유도(\(df\))가 커지므로, car::vif()는 일반 VIF 대신 일반화 분산팽창계수(GVIF)를 반환합니다.
- ❌ 흔한 실수: 자유도가 2 이상인 범주형 변수의
GVIF원값을 연속형 변수의VIF와 직접 비교하는 행위. - ✅ 올바른 해석법: 자유도의 차이를 1차원 스케일로 보정한 \(GVIF^{1/(2 \times df)}\) 열을 기준으로 비교합니다. (이 값을 제곱한 수치가 일반 VIF 기준치인 4 또는 10과 대응됩니다.)
3-5. 구조적 공선성 해결: 평균 중심화 (Mean Centering)
모형에 제곱항(\(X^2\))이나 상호작용항(\(X_1 \times X_2\))을 추가하면 원본 변수와의 유사성 때문에 VIF가 폭발합니다. 이를 구조적 다중공선성(Structural Multicollinearity)이라고 부릅니다. * 해결법: 각 변수에서 표본 평균을 뺀 평균 중심화 변수(\(X - \bar{x}\))를 생성한 후 제곱항/상호작용항을 구성하면 공선성이 획기적으로 낮아집니다.
4. [방법론 3] 래퍼 & 임베디드 기법: 모델 기반 지능형 변수 선택
4-1. 래퍼 기법: RFE (Recursive Feature Elimination)
RFE는 전체 변수로 초기 모델을 학습한 뒤, 중요도가 가장 낮은 변수를 순차적으로 하나씩 제거하면서 교차검증(CV) 성능이 최대가 되는 최적의 변수 개수를 탐색합니다 (RFECV).
4-2. 임베디드 기법: LASSO (L1) vs Ridge (L2) vs Elastic Net
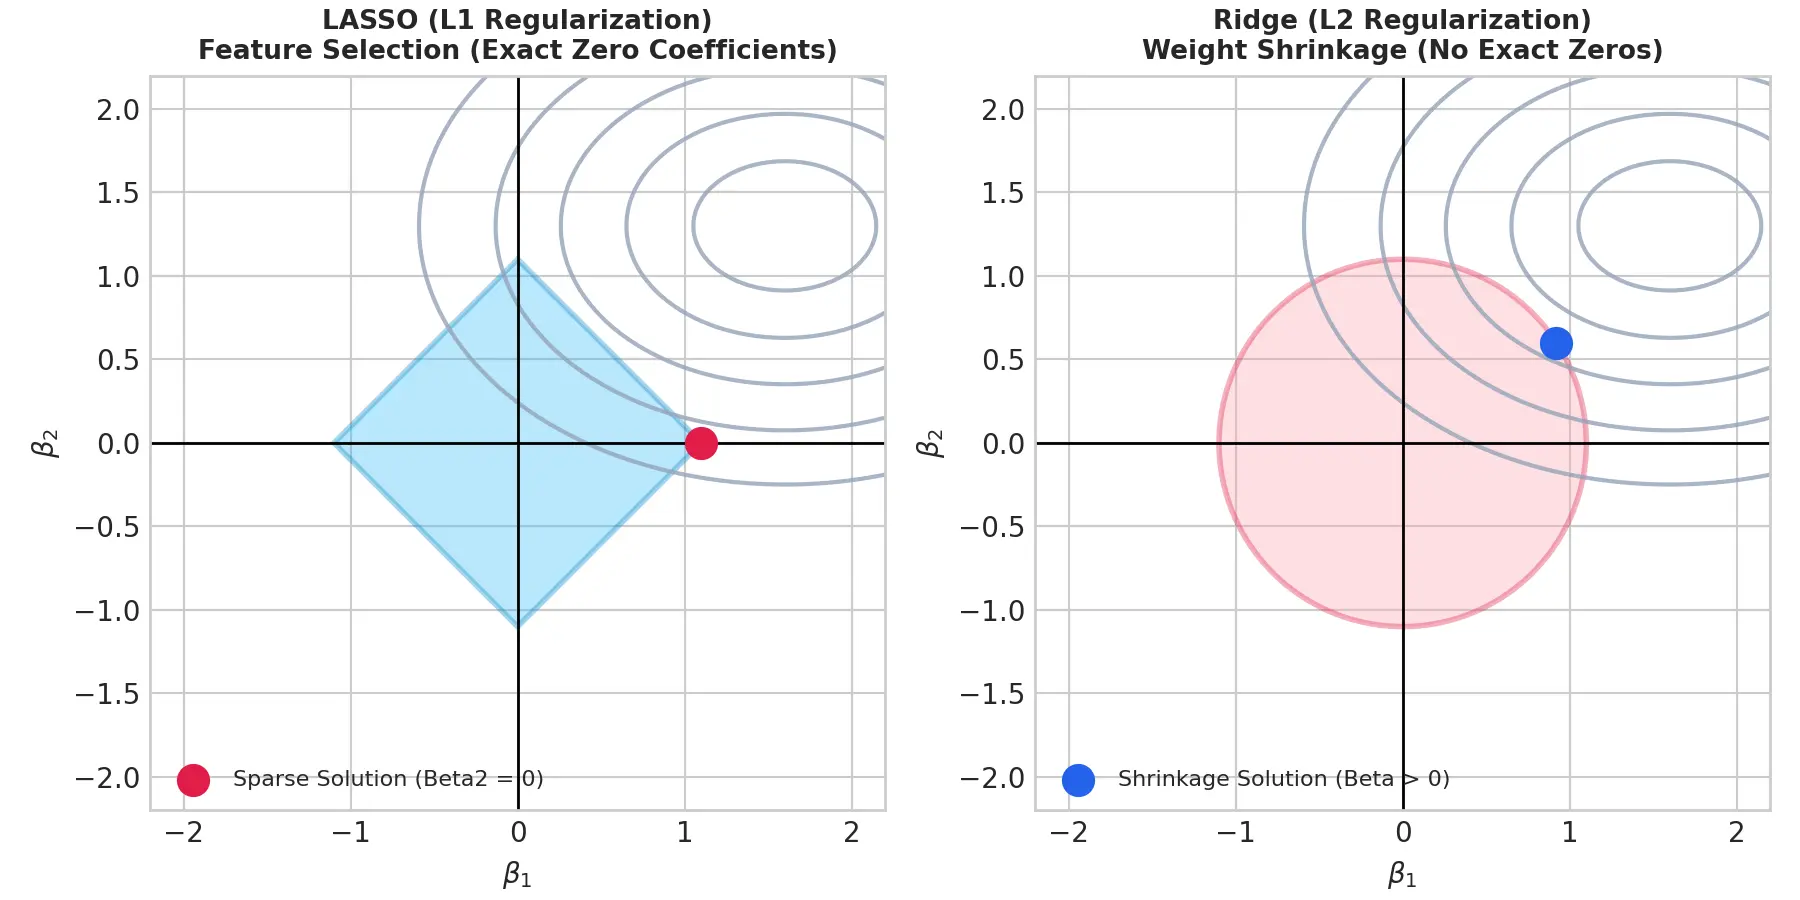
- LASSO (L1 Regularization, \(\lambda \sum |\beta_j|\)):
- 제약 조건 영역이 뾰족한 다이아몬드 형태를 띠어, 타원형 손실 함수의 등고선이 모서리(축)와 먼저 접촉합니다.
- 덜 중요한 변수의 회귀계수를 정확히 0으로 축소시켜 자동 변수 선택을 수행합니다.
- Ridge (L2 Regularization, \(\lambda \sum \beta_j^2\)):
- 원형 제약 영역으로 인해 계수를 0에 가깝게 줄이지만 완전히 0으로 만들지는 못합니다 (변수 선택 불가).
- Elastic Net (L1 + L2 혼합):
- 상관관계가 높은 변수 무리가 있을 때 한 놈만 무작위로 남기고 나머지를 버리는 LASSO의 단점을 극복하여, 상관 변수군을 그룹 단위로 함께 선택합니다. 실무에서 가장 권장됩니다.
4-3. 특성 중요도(Feature Importance)와 순열 중요도
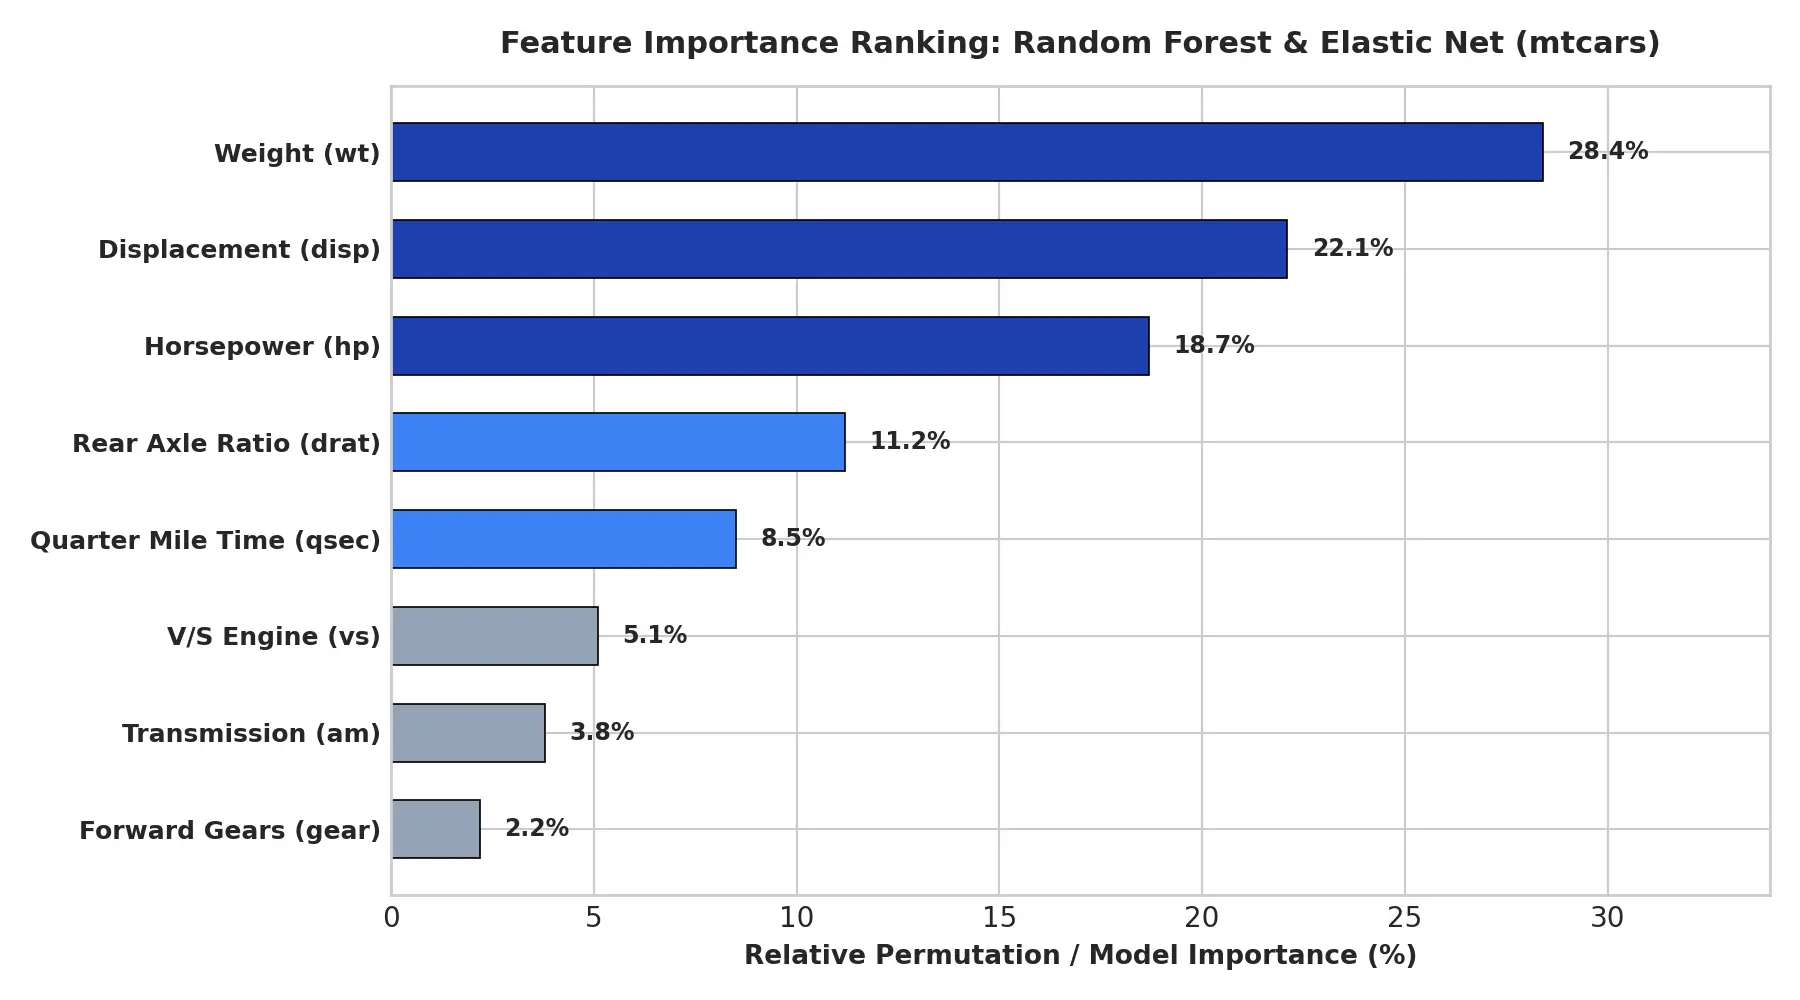
- Permutation Importance (순열 중요도): 검증 데이터에서 특정 변수의 값을 무작위로 섞었을 때 모델 성능이 하락하는 폭을 측정합니다. 모델 비의존적(Model-Agnostic)이며 가장 공정한 평가를 제공합니다.
5. [방법론 4] 차원 축소: PCA와 PLS
- PCA (Principal Component Analysis, 비지도):
- 타겟(\(y\))을 보지 않고, 오직 설명변수(\(X\)) 공간 내에서 분산이 최대가 되는 직교 주성분 축을 도출합니다.
- Biplot에서 화살표 방향이 거의 겹치는 변수군을 시각적으로 파악하여 중복성을 진단할 수 있습니다.
- PLS (Partial Least Squares, 지도형):
- \(X\)의 분산뿐만 아니라 종속변수 \(y\)와의 공분산을 동시에 최대화하는 잠재 축을 추출하므로, 예측 모델링 관점에서 PCA보다 우수합니다.
6. 실무 6단계 통합 파이프라인 & 상황별 맞춤 치트시트
6-1. ⚠️ 절대 원칙: Data Leakage 방지
“시험 답안지를 미리 보고 공부할 핵심 개념을 고르면 시험 점수가 가짜로 높아집니다.” 변수 선택, 표준화(Scaling), PCA 등의 모든 전처리 및 특성 선택 작업은 반드시 학습 세트(Train Set) 내에서만 학습되어야 하며, 테스트 세트(Test Set)의 정보가 유입되어서는 안 됩니다.
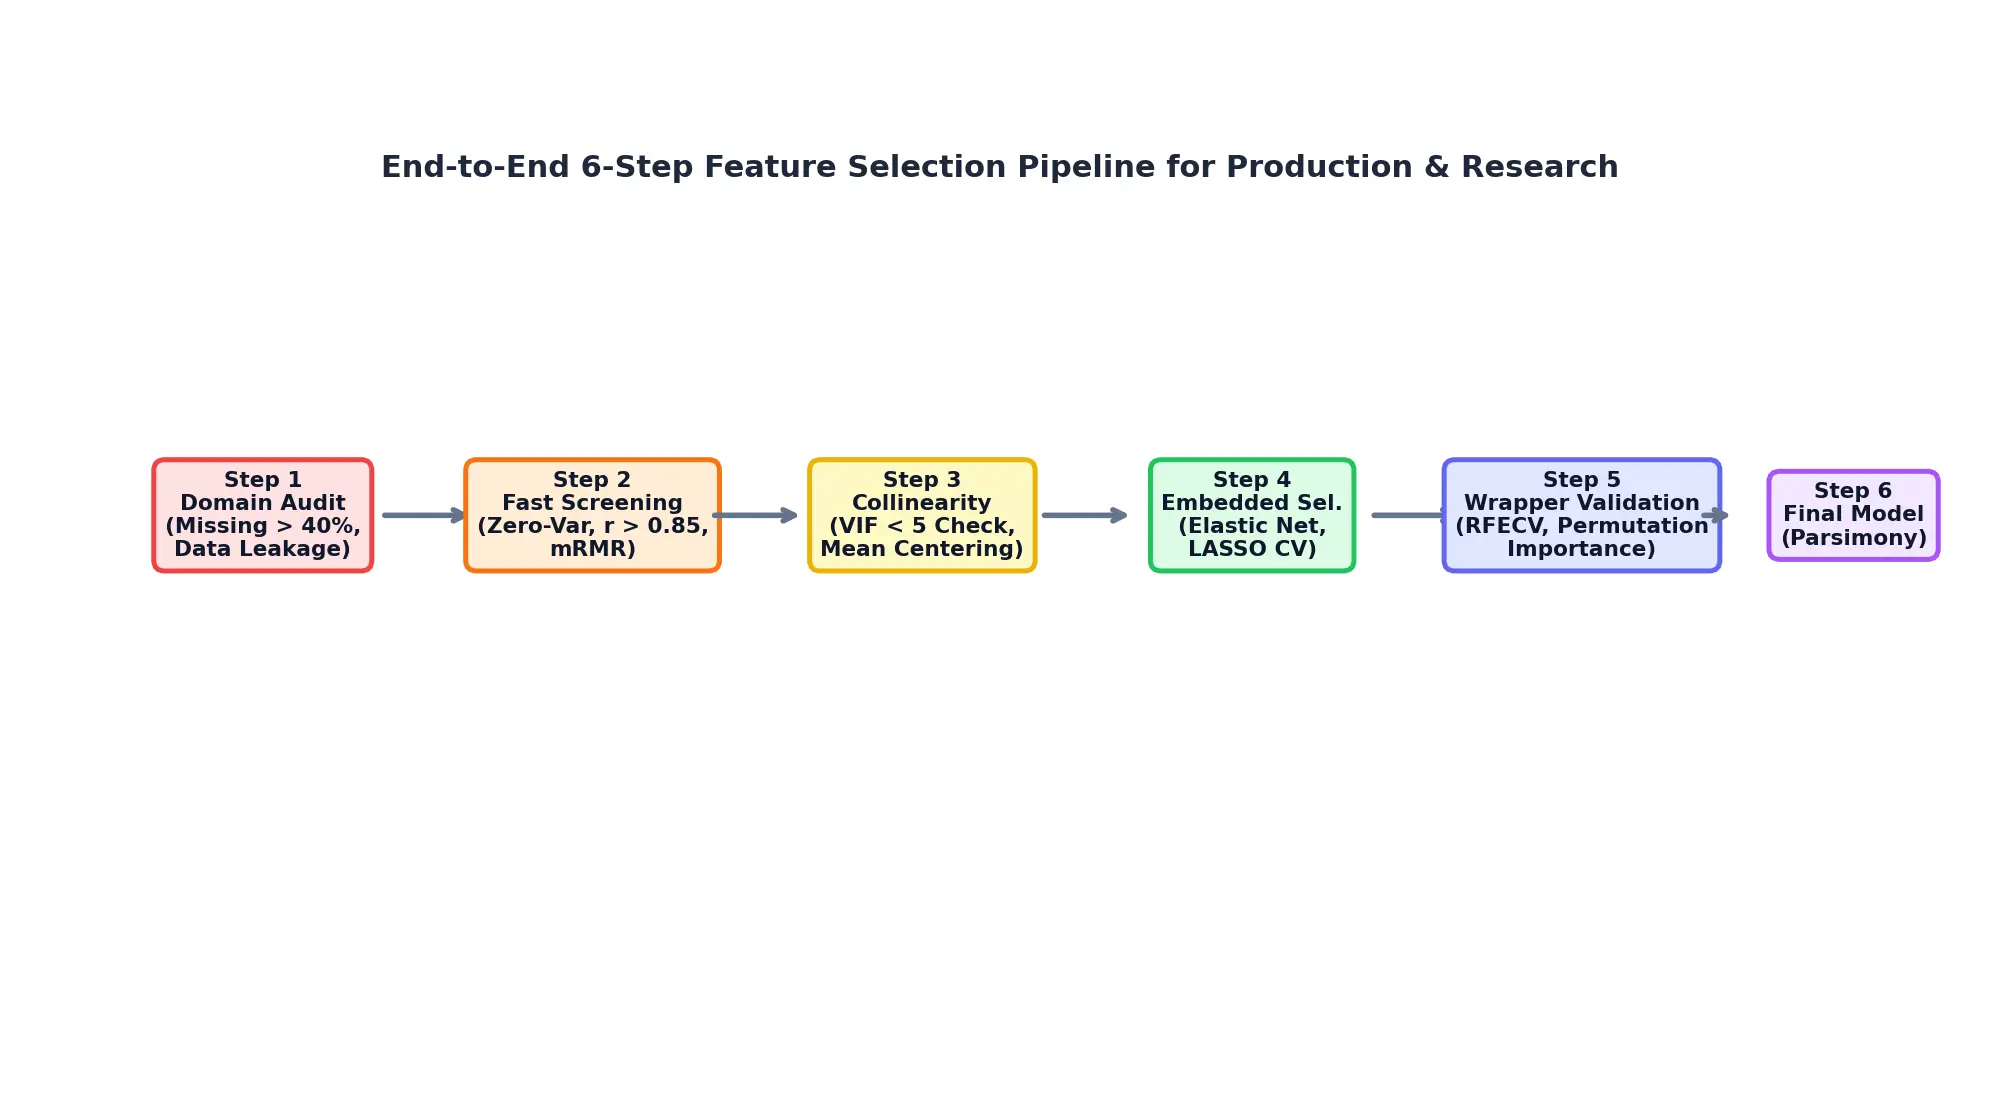
6-2. 엔드투엔드 6단계 변수 선택 프로세스
6-3. 상황별 의사결정 매트릭스
| 분석 상황 및 비즈니스 요건 | 1차 권장 기법 | 보조 검증 기법 | 최종 의사결정 기준 |
|---|---|---|---|
| 명확한 인과관계 및 설명이 중요함 (논문/보고서) | 상관분석 + VIF 진단 | 후진소거법, Elastic Net | VIF < 4 유지 및 계수 p-value |
| 순수 예측 성능이 최우선임 (ML 경진대회/배포) | Elastic Net, RFECV | Permutation Importance | 교차검증(CV) RMSE/AUC 극대화 |
| 변수가 수백~수천 개로 너무 많음 | 저분산 필터 + mRMR | LASSO, PCA | 연산 속도 및 차원의 저주 해소 |
| 변수 간 복잡한 다중공선성이 얽혀 있음 | Elastic Net, PLS | PCA Biplot 시각화 | 잠재 합성 축 구성 또는 대표 변수 추출 |
| 비선형 관계 및 상호작용이 지배적임 | Random Forest / XGBoost 중요도 | Boruta 알고리즘 | 순열 중요도 기반 상위 특성 채택 |
7. R 실전 코드: mtcars 데이터셋 완벽 실습
# ==============================================================
# R 변수 선택 및 다중공선성(VIF) 마스터 실습 스크립트
# ==============================================================

# 1. 필수 패키지 로드
if (!requireNamespace("car", quietly = TRUE)) install.packages("car")
if (!requireNamespace("glmnet", quietly = TRUE)) install.packages("glmnet")
if (!requireNamespace("performance", quietly = TRUE)) install.packages("performance")

library(car)
library(glmnet)
library(performance)

# --------------------------------------------------------------
# [실습 1] 연속형 다중회귀모형 적합 및 VIF 진단
# --------------------------------------------------------------
cat("
=== [1] 다중회귀모형 적합 및 VIF 진단 ===
")
fit_linear <- lm(mpg ~ wt + disp + hp + drat + qsec, data = mtcars)
print(summary(fit_linear))

# VIF 산출
vif_results <- vif(fit_linear)
cat("
[VIF 결과 (car 패키지)]:
")
print(round(vif_results, 3))

# --------------------------------------------------------------
# [실습 2] 범주형 변수 포함 시 GVIF 해석
# --------------------------------------------------------------
cat("
=== [2] 범주형 변수 포함 모형 (GVIF 산출) ===
")
mt_factor <- mtcars
mt_factor$cyl  <- factor(mt_factor$cyl)
mt_factor$gear <- factor(mt_factor$gear)

fit_factor <- lm(mpg ~ wt + cyl + gear, data = mt_factor)
cat("
[GVIF 출력 결과 (마지막 열 GVIF^(1/(2*Df)) 기준 해석)]:
")
print(vif(fit_factor))

# --------------------------------------------------------------
# [실습 3] 구조적 다중공선성과 평균 중심화(Mean Centering)
# --------------------------------------------------------------
cat("
=== [3] 제곱항 모형의 평균 중심화 전후 비교 ===
")
mt_poly <- mtcars
mt_poly$wt_c <- scale(mt_poly$wt, center = TRUE, scale = FALSE) # 평균 중심화

fit_raw_poly  <- lm(mpg ~ wt + I(wt^2), data = mt_poly)
fit_cent_poly <- lm(mpg ~ wt_c + I(wt_c^2), data = mt_poly)

cat("중심화 전 wt VIF:", round(vif(fit_raw_poly)[1], 2), "
")
cat("중심화 후 wt_c VIF:", round(vif(fit_cent_poly)[1], 2), "
")

# --------------------------------------------------------------
# [실습 4] LASSO (L1) 기반 자동 변수 선택
# --------------------------------------------------------------
cat("
=== [4] glmnet 패키지 기반 LASSO 교차검증 변수 선택 ===
")
X <- as.matrix(mtcars[, -1]) # mpg 제외한 모든 독립변수
y <- mtcars$mpg

set.seed(42)
cv_lasso <- cv.glmnet(X, y, alpha = 1) # alpha = 1: LASSO
best_lambda <- cv_lasso$lambda.min
lasso_coefs <- coef(cv_lasso, s = "lambda.min")

cat("최적 Lambda (min):", round(best_lambda, 4), "
")
cat("LASSO 선택 회귀계수 (0으로 제거된 변수 확인):
")
print(lasso_coefs)
8. 📝 논문 및 실무 보고서용 표준 해석 문장 템플릿
실제 학술 논문, 분석 보고서, 모델링 산출물 문서 작성 시 상황에 맞추어 활용할 수 있는 표준 문안입니다.
- 템플릿 1: 다중공선성 점검 완료 (모든 VIF < 4): > “회귀모형의 다중공선성 발생 가능성을 점검하기 위해 분산팽창계수(VIF)를 산출한 결과, 모든 독립변수의 VIF가 4.0 미만(최대 \(VIF = 2.45\))으로 나타나 변수 간 공선성에 따른 추정 왜곡 위험은 매우 낮은 것으로 확인되었다.”
- 템플릿 2: 고공선성 변수 제거 및 정제 보고 (VIF \(\ge 10\)): > “초기 다중회귀모형 진단 결과, 배기량(disp) 변수의 VIF가 10.5로 심각한 수준의 공선성이 식별되었다. 해당 변수는 차량 중량(wt)과 개념적·통계적 중복도가 높다고 판단되어 모형의 간명성과 계수 추정의 안정성을 위해 최종 모형에서 제외하였다.”
- 템플릿 3: 범주형 변수 GVIF 조정값 해석: > “범주형 변수가 포함된 모형에서는 자유도 차이를 보정하기 위해 일반화 분산팽창계수(\(GVIF\))를 산출하였으며, 조정 지표인 \(GVIF^{1/(2 \times df)}\) 값이 모두 기준 임계치인 2.0 미만으로 확인되어 모형 안정성을 확보하였다.”
- 템플릿 4: LASSO 규제 기반 변수 선택 결과 보고: > “고차원 특성 공간에서 과적합을 방지하고 일반화 성능을 극대화하기 위해 10-Fold 교차검증 기반의 LASSO(L1 정규화) 모형을 적용하였다. 총 10개 독립변수 중 예측 오차를 최소화하는 최적 \(\lambda\) 지점에서 유의미한 4개 특성(wt, hp, qsec, am)이 최종 선택되었다.”
📚 참고 문헌 및 공식 출처
| 구분 | 자료명 및 공식 도서 | 주요 내용 | 바로가기 |
|---|---|---|---|
| R 통계학 바이블 | An R Companion to Applied Regression (3rd Ed.) | John Fox, Sanford Weisberg 저, car 패키지 저자 직강, VIF 및 GVIF의 수학적 배경 |
공식 도서 사이트 |
| 머신러닝 교과서 | The Elements of Statistical Learning (ESL) | Trevor Hastie, Robert Tibshirani 저, LASSO, Ridge, Elastic Net 수리적 최적화 | 원문 PDF 무료 공개 |
| 예측 모델링 실무 | Applied Predictive Modeling | Max Kuhn, Kjell Johnson 저, R caret 패키지 창시자, 실무 Feature Selection 파이프라인 |
도서 정보 |
| R 공선성 진단 패키지 | CRAN performance Package Guide |
Daniel Lüdecke et al., check_collinearity() 시각화 및 지표 통합 산출 |
easystats 공식 포털 |