flowchart LR
    S1["1단계 분류<br>(99%)"] --> S2["2단계 추출<br>(99%)"]
    S2 --> S3["3단계 검증<br>(99%)"]
    S3 --> S4["... N단계 연쇄"]
    S4 --> SN["100단계 파이프라인<br>최종 신뢰도: 36.6%"]
“반드시 JSON 포맷으로만 답변하고, 마크다운 코드 블록이나 불필요한 설명은 일절 생략할 것.”
백엔드 파이프라인에 거대언어모델(LLM)을 연동해 본 엔지니어라면 누구나 프롬프트 맨 위에 이 문장을 적어보았을 것입니다. 하지만 온갖 당부에도 불구하고 새벽 3시 프로덕션 환경에서 가끔씩 튀어나오는 json ... 래핑이나 “네, 요청하신 JSON입니다”라는 친절한 사족 때문에 JSONDecodeError가 발생하고 백엔드 서버가 중단되는 경험을 겪게 됩니다.
수학 올림피아드 문제를 척척 풀고 변호사 시험에서 상위 1%를 기록하는 최첨단 AI가 왜 엔터프라이즈 소프트웨어의 단순한 if (is_fraud) 조건문 하나조차 마음 놓고 대체하지 못할까요?
2026년 9월 15일, OpenAI에서 InstructGPT 핵심 연구를 주도하며 ChatGPT의 산파 역할을 했던 디오고 알메이다(Diogo Almeida)가 이끄는 TypeSafe AI가 오랜 스텔스 기간을 깨고 첫 번째 모델 Jev(제브)를 전격 공개했습니다.
TypeSafe는 Jev를 기존 생성형 LLM(Generative LLM)과 명확히 선을 긋는 ‘System One Model(시스템 원 모델)’로 정의하며, 그 역할을 단 한 문장으로 압축했습니다:
“Unstructured state in, typed probabilistic decisions out.”
(비정형 상태 정보를 입력받아, 정해진 타입의 확률적 판단을 출력한다.)
사람에게 읽힐 긴 글을 쓰지 않는 대신, 소프트웨어 백엔드가 즉시 신뢰하고 실행할 수 있는 정형화된 확률과 타입을 초고속(70ms~500ms)·초저비용($0.042/1M 토큰)으로 뱉어내는 AI. 이번 글에서는 Jev의 설계 철학, 사후학습(Post-Training)의 새 지평인 RLCD, 3대 판단 원형(Primitive), 그리고 실무 프로덕션 아키텍처를 하나씩 짚어보겠습니다.
1. 챗봇의 역설: “능력(Capability)은 넘치는데, 왜 자동화(Automation)는 멈춰 있을까?”
1.1 99%의 함정과 연속 공정의 법칙
대다수 LLM 벤치마크는 단일 프롬프트에 대한 정답률을 평가합니다. “단일 판단 성공률 99%”. 언뜻 보면 사람이 개입하지 않아도 될 완벽한 수치처럼 느껴집니다.
하지만 실제 기업의 비즈니스 소프트웨어는 하나의 거대한 모놀리스가 아니라 수십, 수백 개의 마이크로서비스와 조건문이 얽힌 연속 파이프라인(Chained Pipeline)입니다.
단일 단계의 정확도가 \(99\%\)라 하더라도, 100개의 조건 판단이 직렬로 연결되면 전체 파이프라인의 성공 확률은 급격히 추락합니다:
\[0.99^{100} \approx 0.366 \quad (36.6\%)\]
열 번 중 일곱 번 가까이 장애를 내는 소프트웨어를 프로덕션 백엔드에 배포할 수 있는 엔지니어링 팀은 없습니다. 이것이 바로 프론티어 AI가 쏟아져 나오는 시대에도 실제 기업 현장에서는 여전히 사람이 단순 문의를 분류하고, 영수증 번호를 대조하며, 최종 승인 버튼을 누르고 있는 ‘AI 자동화의 역설’입니다.
1.2 Assistance(인간 보조) vs Automation(자율 자동화)
디오고 알메이다는 OpenAI를 떠나 TypeSafe를 창업하며 “생성형 AI는 인간을 돕는 Assistance(보조)에는 최적화되었지만, 기계가 스스로 작동하는 Automation(자동화)의 영역에서는 근본적인 설계 결함을 안고 있다”고 지적했습니다.
| 비교 항목 | 기존 생성형 LLM (Assistance) | System One 모델 Jev (Automation) |
|---|---|---|
| 핵심 인터페이스 | 대화창(Chatbot), 코파일럿, 글쓰기 비서 | 백엔드 코드 내부의 퍼지 조건문 (if-statement) |
| 최종 소비자 | 자연어를 읽고 검토하는 인간(Human) | 파싱 없이 즉시 분기하는 소프트웨어(Code) |
| 출력 형태 | 가변적인 자유 텍스트 문자열 (Strings) | 컴파일러가 보장하는 타입 값 (Typed Values) |
| 추론 방식 | 단어 단위의 순차 생성 (Autoregressive) | 단일 순전파 병렬 추출 (Parallel Sampler) |
| 응답 지연시간 | 3초 ~ 30초 (대화에는 무난하나 백엔드엔 병목) | 70ms ~ 500ms (마이크로서비스 실시간 연동) |
| 토큰 비용 | 입력 $0.20~$10 / MTok, 출력은 3~5배 비쌈 | 입력 $0.042 / MTok, 출력 토큰 무료 |
| 불확실성 표현 | 과신(Overconfident) 경향, 일관성 결여 | 엄격하게 보정된 확률 분포 및 신뢰도 점수 |
기존 LLM은 언제든 엉뚱한 대답을 늘어놓을 수 있는 ’유능하지만 통제하기 힘든 외주 컨설턴트’였다면, Jev는 비정형 데이터를 입력받아 약속된 데이터 구조체만을 칼같이 반환하는 ‘초고속 퍼지 연산자(Fuzzy Logic Operator)’에 가깝습니다.
2. 왜 ’System One’이며 왜 ’Jev’인가?
2.1 대니얼 카너먼의 System 1과 System 2
모델명 ’System One’은 노벨경제학상 수상자 대니얼 카너먼(Daniel Kahneman)의 명저 《생각에 관한 생각(Thinking, Fast and Slow)》의 인지 모델에서 직접 차용했습니다.
- System 1 (빠르고 직관적인 사고): 복잡한 수식을 계산하지 않고도 날아오는 공을 순간적으로 피하거나, 상대방의 얼굴 표정만 보고 화가 났음을 즉시 알아채는 인지 체계입니다.
- System 2 (느리고 깊은 논리적 추론): ’17 × 24’를 암산하거나 장기 전략을 세울 때처럼 의식적인 노력을 들여 단계별로 사고하는 체계입니다.
OpenAI o1, o3나 DeepSeek-R1과 같은 추론 특화 모델이 장시간 생각(Chain-of-Thought)을 거치는 System 2의 극단에 서 있다면, Jev는 “장황한 고민 없이 상태를 보자마자 100ms 안에 직관적인 패턴을 감지하고 확률적 결정을 내리는 System 1”의 자리를 차지합니다.
2.2 제본스의 역설 (Jevons Paradox)
모델의 이름인 Jev(제브)는 19세기 영국의 경제학자 윌리엄 스탠리 제본스(William Stanley Jevons)의 이름에서 따왔습니다.
제본스의 역설 (Jevons Paradox):
기술의 진보로 어떤 자원의 이용 효율이 극적으로 높아져 단위당 소비 비용이 급감하면, 자원의 총소비량은 줄어드는 것이 아니라 오히려 폭발적으로 증가하여 새로운 산업 생태계를 창출한다.
과거 제임스 와트가 증기기관의 석탄 소비 효율을 수직 상승시켰을 때, 석탄 소비는 감소하지 않고 기차, 기선, 공장으로 확산되며 산업혁명의 방아쇠를 당겼습니다.
TypeSafe는 인공지능의 지능 비용 역시 동일한 궤적을 밟을 것으로 전망합니다. 지금까지 $10~30달러를 주고 10초씩 기다려야 했던 LLM 의사결정 비용이 100만 토큰당 $0.042(약 58원), 응답 시간 70ms 수준으로 떨어지면 어떻게 될까요?
지금까지는 감히 AI를 쓸 생각조차 못 했던 영역—초당 수천 건의 네트워크 패킷 스크리닝, 데이터베이스 파이프라인의 실시간 ETL 분기, 비디오 게임 NPC의 리액션 루프, 수천만 건의 댓글 필터링에 이르기까지 전 세계 소프트웨어의 수십억 개 if 문이 Jev로 치환되는 전환점이 열리게 됩니다.
3. 포스트 트레이닝의 3대 진화: RLHF \(\rightarrow\) RLVR \(\rightarrow\) RLCD
사전학습(Pre-training)이 신경망에 인류의 지식을 압축하는 과정이라면, 그 모델의 성격과 행동 양식을 결정하는 진짜 핵심은 사후학습(Post-Training)입니다. TypeSafe는 Jev를 만들기 위해 사후학습 방법론 자체를 완전히 새로 정립했습니다.
flowchart TD
    Pre["사전학습 (Pre-training)<br>웹 텍스트 압축"] --> Post{"사후학습 패러다임"}
    Post -->|"1세대 (인간 선호도)"| RLHF["RLHF (인간 피드백)<br>장황함·아첨·환각 발생"]
    Post -->|"2세대 (기계적 검증)"| RLVR["RLVR (검증 가능한 보상)<br>수학·코드에 국한"]
    Post -->|"3세대 (확률 보정)"| RLCD["★ RLCD (보정된 결정)<br>엄격한 타입 + 정밀한 확률 보정"]
3.1 RLHF의 한계: “인간 평가자에게 아첨(Sycophancy)하는 챗봇”
ChatGPT 시대를 연 RLHF(Reinforcement Learning from Human Feedback)는 인간 검수자가 선호하는 답변에 높은 보상을 부여합니다. 그러나 인간 평가자는 다음과 같은 치명적인 편향을 가지고 있습니다:
- 장황함 편향 (Verbosity Bias): 짧고 간결한 답변보다 그럴듯하게 길고 포장된 문장에 더 높은 점수를 줍니다.
- 아첨 편향 (Sycophancy): “잘 모르겠습니다”라고 솔직하게 고백하는 모델보다, 틀린 정보라도 자신감 넘치는 어조로 설득력 있게 꾸며낸 답변을 선호합니다.
그 결과, RLHF로 훈련된 챗봇은 실제로는 정답을 모르는 상황에서도 99% 확신하는 척 거짓말을 지어내는 치명적인 비일관성을 학습하게 되었습니다.
3.2 RLVR의 한계: “채점기가 없는 실무 비즈니스”
최근 OpenAI o 시리즈와 DeepSeek-R1이 채택한 RLVR(Reinforcement Learning with Verifiable Rewards)은 인간의 주관적 평가 대신 파이썬 인터프리터, 컴파일러, 수학 공식 같은 객관적 채점기를 통해 정답 여부를 기계적으로 검증합니다.
수학 정리 증명이나 알고리즘 문제 해결에는 최적이지만, 현실의 비즈니스 세계에는 명확한 채점기가 존재하지 않습니다: * “이 고객의 불만 제기가 서비스 해지(Churn)로 이어질 것인가?” * “이 법률 계약서의 독소 조항이 우리 회사에 실질적 손해를 끼칠 것인가?”
이러한 현실 세계의 개방형 질문(Open-ended Questions)에는 컴파일러가 존재하지 않으므로 RLVR을 적용할 수 없습니다.
3.3 RLCD의 등장: 확률 보정(Calibration)과 브라이어 점수
TypeSafe가 창안한 RLCD(Reinforcement Learning for Calibrated Decisions)의 북극성은 “사람이 좋아하는 글을 쓰는 것”도, “코드를 통과시키는 것”도 아닙니다.
RLCD의 핵심 지향점:
모델이 출력하는 예측 확률이 현실 세계의 통계적 발생 빈도와 오차 없이 정확하게 일치하도록 확률 보정(Statistical Calibration)을 달성하는 것.
완벽하게 보정된 모델 (Well-Calibrated Model)이란?
어떤 AI 모델이 “이 고객은 이탈할 가능성이 80%다(\(p=0.80\))”라고 예측한 사건 1,000건을 장기 추적했을 때, 실제로 그중 정확히 800건이 이탈로 이어져야 그 모델은 잘 보정(Calibrated)되었다고 말할 수 있습니다:
\[P(Y = 1 \mid \hat{P} = p) \approx p \quad (\forall p \in [0, 1])\]
브라이어 점수(Brier Score)에 의한 엄격한 페널티
RLCD는 잘못된 예측에 과도한 확신을 품는 모델을 징벌하기 위해 기상 예측 등에서 활용되는 브라이어 점수(Brier Score)를 손실 함수로 최적화합니다:
\[BS = \frac{1}{N} \sum_{t=1}^{N} (f_t - o_t)^2\]
- \(f_t\): 모델이 예측한 확률 (\(0.0 \le f_t \le 1.0\))
- \(o_t\): 실제 발생 여부 (발생 시 \(1\), 미발생 시 \(0\))
만약 모델이 \(95\%\)의 높은 확신(\(f_t = 0.95\))을 가졌는데 실제 결과가 거짓(\(o_t = 0\))으로 드러나면, 제곱 오차 \((0.95 - 0)^2 = 0.9025\)라는 치명적인 벌점이 가해집니다. 이 강력한 제약 덕분에 Jev는 자신이 불확실한 영역에서는 정직하게 낮은 확률과 넓은 분산을 드러내도록 훈련됩니다.
4. Jev의 핵심 아키텍처: 병렬 샘플러와 3대 판단 원형
4.1 비자기회귀 병렬 샘플러(Parallel Sampler)
기존 생성형 트랜스포머는 이전 단어들을 바탕으로 다음 단어 하나를 순차적으로 계산하는 자기회귀(Autoregressive) 생성 방식을 취합니다:
\[P(x_1, x_2, \dots, x_n) = \prod_{t=1}^{n} P(x_t \mid x_1, \dots, x_{t-1})\]
100단어로 이루어진 JSON 응답을 얻으려면 신경망의 전방향 패스(Forward Pass)를 무려 100번 직렬로 반복해야만 합니다. 이것이 프론티어 LLM의 지연시간이 3초~30초 밑으로 내려가지 못하는 물리적 이유입니다.
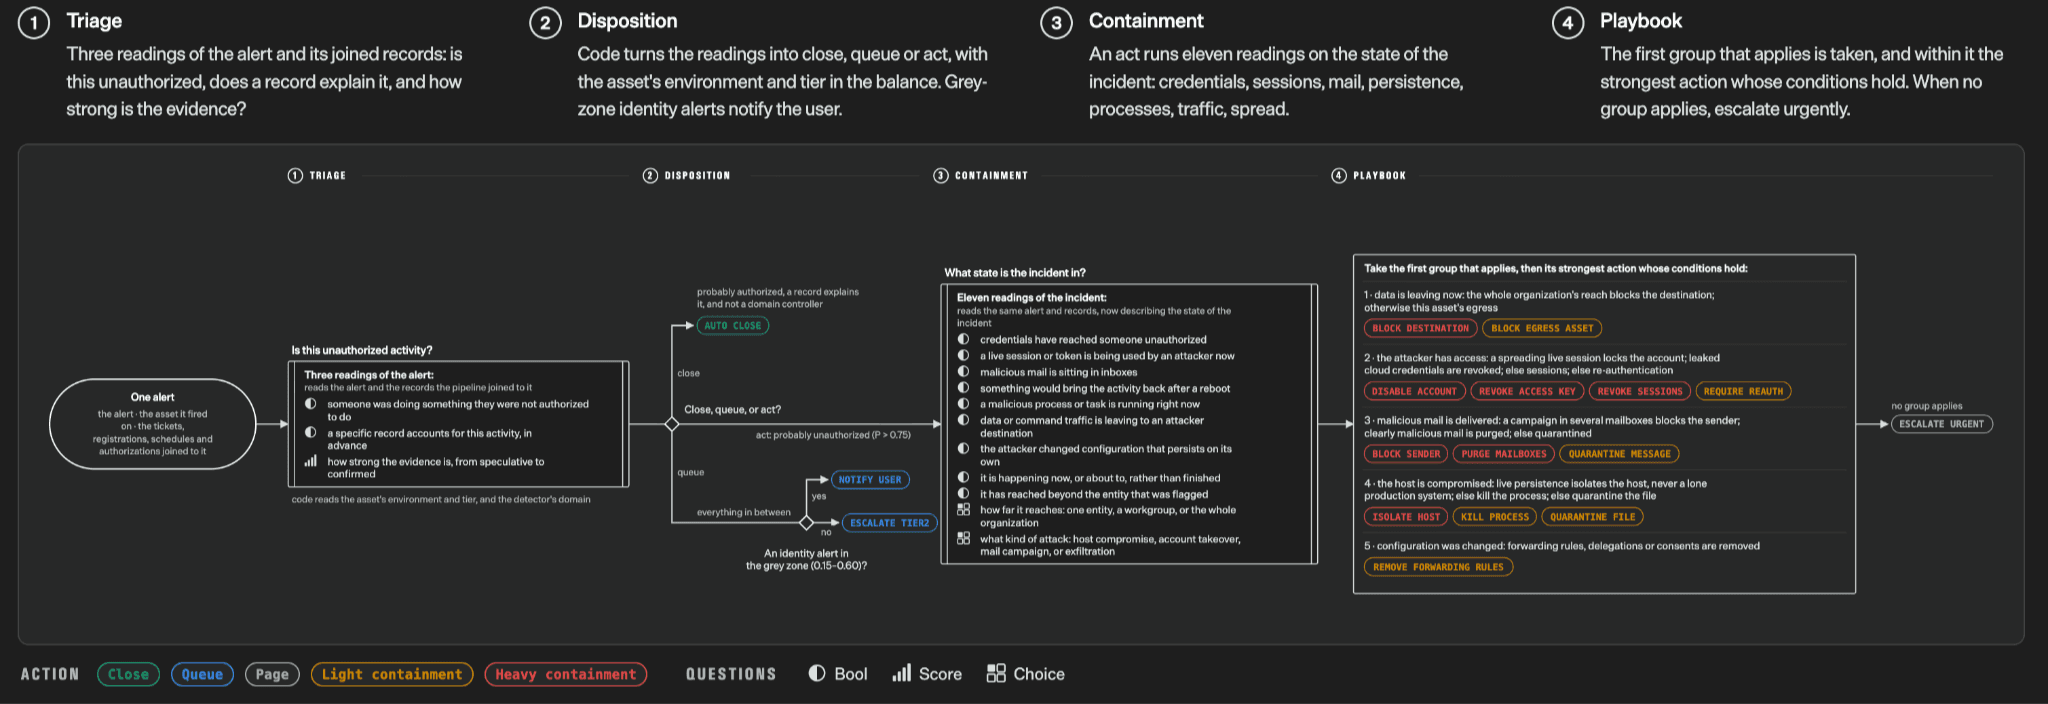
반면 Jev는 자연어 문장을 만들지 않습니다. 하나의 비정형 상태(Shared State)를 메모리에 올려둔 채, 등록된 복수의 의사결정 질문을 단 한 번의 전방향 연산으로 동시에 추출하는 병렬 샘플러(Parallel Sampler)를 채택했습니다.
공식 벤치마크에 따르면 Jev는 기존 프론티어 LLM 대비 최대 193.6배 빠르고, 비용은 444.6배 저렴한 수준으로 파레토 프론티어(Pareto Frontier)를 압도하고 있습니다.
4.2 실무를 지탱하는 3대 판단 원형 (Primitives)
Jev API는 제멋대로인 자연어 출력을 원천 차단하며, 오직 엄격하게 정의된 3가지 수학적 원형(Primitive)만을 반환합니다.
① Noul — 이진 참/거짓 확률 (Binary Probability)
전통적인 Boolean을 대체합니다. 특정 명제가 참일 확률을 \(0.0\)에서 \(1.0\) 사이의 단일 실수(Float)로 반환합니다.
{
  "type": "noul",
  "noul": 0.942
}
[!NOTE] Noul에는 별도의
confidence필드가 없습니다. 값 자체가 보정된 사후 확률 \(P(\text{YES}) = 0.942\)이므로, 자동화 분기 여부는 엔지니어가 설정한 비즈니스 임계값(Threshold)에 따라 결정됩니다 (if result.noul >= 0.85:).
② Choice — 다항 범주 선택 (Categorical Distribution)
사전에 정의된 상호 배타적인 옵션(최대 255개) 중 하나를 선택하고, 전체 확률 분포와 신뢰도(Confidence) 점수를 함께 제공합니다.
{
  "type": "choice",
  "choice": "technical_support",
  "probabilities": {
    "billing": 0.04,
    "technical_support": 0.91,
    "sales": 0.03,
    "other": 0.02
  },
  "confidence": 0.88
}
[!TIP] Choice 설계 시 엔지니어링 팁: 반드시 ‘Other’ 슬롯을 열어둘 것
선택지를[billing, technical, sales]처럼 닫힌 구조로 만들면, “채용 문의” 같은 엉뚱한 요청이 들어왔을 때 모델이 억지로 셋 중 하나를 고르는 왜곡이 발생합니다. 반드시other범주를 배기 밸브로 열어두어야 이상치가 안전하게 격리됩니다.
③ Score — 순서형 척도 평가 (Ordinal Scale Expectation)
\(2 \sim 10\)단계의 순서형 레벨을 기준으로 가중 확률 평균인 연속 기댓값(Expected Value)을 계산합니다:
\[\text{Score} = \sum_{i=0}^{K-1} i \cdot P(L_i)\]
{
  "type": "score",
  "score": 2.85,
  "legend": [
    "0: 전혀 긴급하지 않음",
    "1: 일반 문의",
    "2: 빠른 처리 요망",
    "3: 업무 중단 장애 (최고 긴급)"
  ],
  "probabilities": [0.01, 0.04, 0.04, 0.91],
  "confidence": 0.89
}
단순히 정수 라벨(0, 1, 2, 3)을 던지는 것과 달리, \(1.9\)점과 \(2.1\)점은 미세한 뉘앙스가 다릅니다. \(1.9\)점은 1단계에서 올라온 신호이고, \(2.1\)점은 3단계 장애의 전조 증상이 섞여 있음을 연속적인 실수 수치를 통해 조기에 감지할 수 있습니다.
5. “Zero Hallucination”의 공학적 진실: Type Safety vs Semantic Correctness
TypeSafe의 발표 중 가장 큰 화제를 모은 문구는 단연 “Zero Hallucination(환각 제로)”였습니다. 하지만 시니어 엔지니어라면 이 주장을 비판적인 엔지니어링 렌즈로 투과해 보아야 합니다.
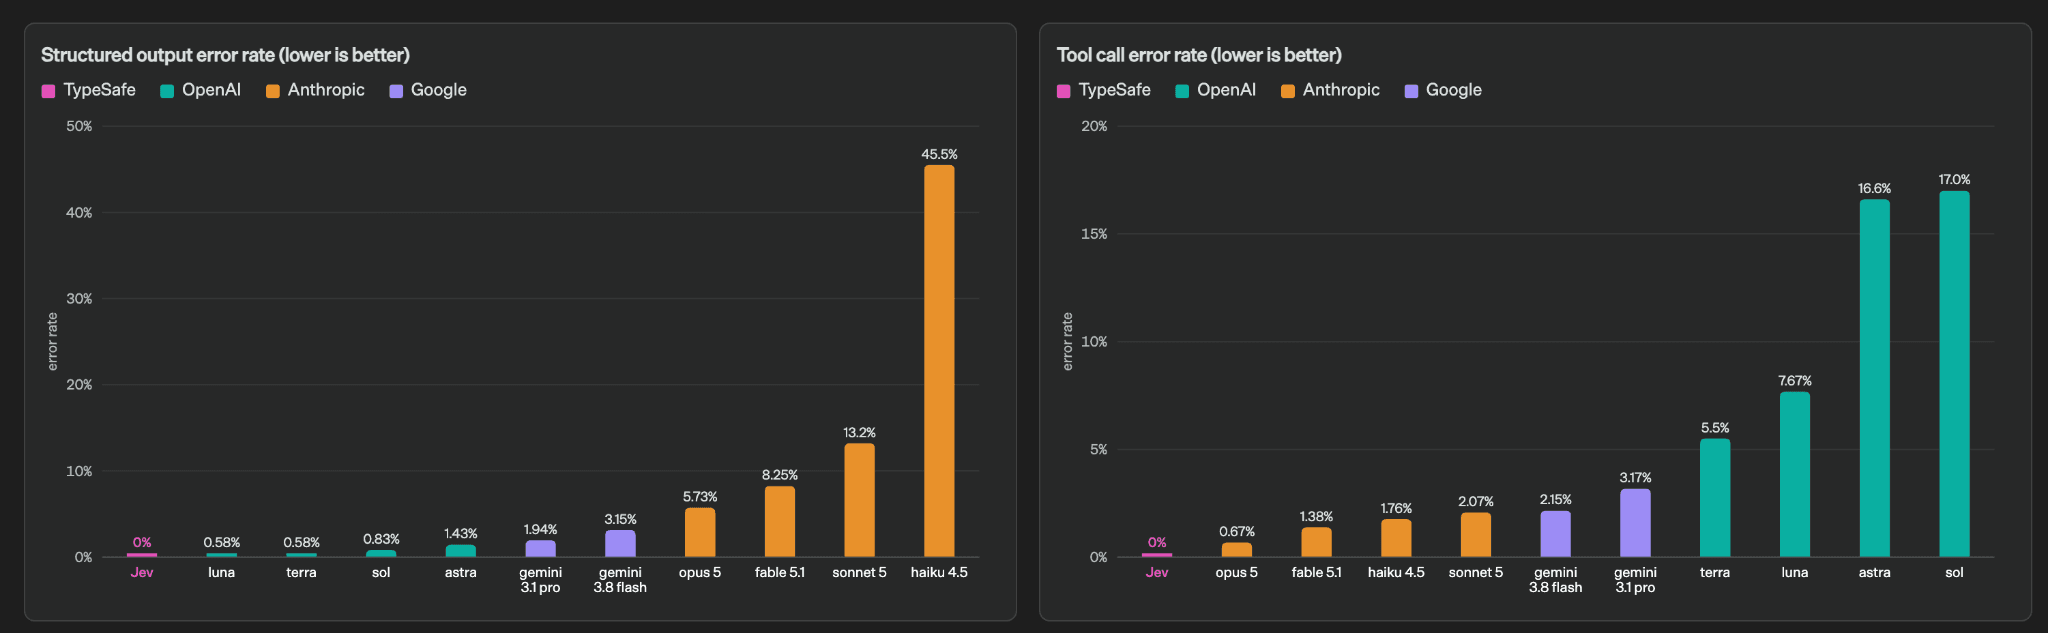
TypeSafe가 차트에 0%를 기록할 수 있었던 이유는 수학적 스키마 제약 때문입니다:
\[\text{Type Safety (타입 안전성)} \neq \text{Semantic Correctness (의미론적 정답성)}\]
- 타입 안전성 (Type Safety = 100% 보장):
모델이 정의되지 않은 Enum 라벨을 만들어내거나, JSON 문법을 깨뜨리거나, 숫자 자리에 문자열을 채우는 구문적 오류(Syntax Error)는 0%입니다. 컴파일러 레벨의 충돌(Crash)은 발생하지 않습니다. - 의미론적 정답성 (Semantic Correctness \(\ne\) 100%):
고객의 문의가 실제로는 환불 요청인데 기술 지원으로 잘못 분류할 확률은 여전히 통계적으로 존재합니다. 세상에 100% 완벽한 AI 판정이란 존재하지 않습니다.
따라서 Jev를 도입할 때는 “모델이 절대 틀리지 않는다”고 맹신하는 것이 아니라, “타입 오류로 시스템이 다운될 염려는 없으니, 모델이 함께 전달하는 Confidence 점수를 기반으로 예외 처리를 정밀하게 설계한다”는 관점으로 접근해야 합니다.
6. 실전 프로덕션 아키텍처: 4계층 하이브리드 캐스케이드
현실 세계의 고신뢰성 시스템은 Jev 단독으로 구축되지 않습니다. 가장 이상적인 형태는 결정론적 코드, System One 모델, Frontier LLM, 그리고 인간이 상호 보완하는 4계층 캐스케이드(Cascade) 파이프라인입니다.
flowchart TD
    Req["외부 고객 문의 유입 (비정형 텍스트)"] --> T1{"1계층: 정규식·규칙 기반 필터<br>(Deterministic Rule)"}

    T1 -->|"명백한 스팸/형식 오류"| Drop["즉시 차단 (지연시간: 0ms / 비용: $0)"]
    T1 -->|"판단 필요"| T2["2계층: System One 모델 Jev<br>(초고속 다차원 병렬 평가)"]

    T2 --> ConfCheck{"신뢰도 평가<br>(Confidence >= 0.85?)"}

    ConfCheck -->|"High Confidence (명확함)"| AutoRoute["소프트웨어 자동 처리<br>(DB 갱신, 슬랙 알림, API 호출)"]
    ConfCheck -->|"Low Confidence / 복합 질문"| T3["3계층: Frontier LLM (System Two)<br>(심층 이유 분석 및 정밀 처리)"]

    T3 --> ReasonCheck{"최종 확신 여부"}
    ReasonCheck -->|"해결"| AutoRoute
    ReasonCheck -->|"고위험 / 불확실"| T4["4계층: Human-in-the-Loop<br>(담당자 검토 대기열 라우팅)"]
4단계 계층별 역할 분담
- 1계층 (규칙 기반 필터): 발신자 화이트리스트, 명백한 스팸 키워드, 문자 길이 제한 등 비용이 들지 않는 하드코딩 규칙을 먼저 통과시킵니다. (비용 $0, 지연시간 0ms)
- 2계층 (System One 모델 Jev): 전체 트래픽의 90% 이상을 Jev로 받아 카테고리, 긴급도, 처리 방식을 100ms 안에 병렬 판정합니다. (비용 $0.042/1M 토큰)
- 3계층 (Frontier LLM / System Two): Jev의 Confidence가 0.85 미만으로 떨어지거나, 고객에게 장문의 정중한 사과 메일을 직접 생성해야 하는 경우에만 고비용 모델(Claude 3.7 Sonnet, GPT-5 등)을 조건부 호출합니다.
- 4계층 (인간 개입): 법적 리스크가 높거나 거래 금액이 큰 이상 건수는 상담원 대시보드로 안전하게 에스컬레이션합니다.
이 구조를 채택하면 기존에 모든 요청을 GPT-4o나 Claude에 보내던 아키텍처 대비 API 비용을 95% 이상 절감하면서도, 응답 속도는 초 단위에서 밀리초 단위로 단축할 수 있습니다.
7. 실제 워크플로우 벤치마크 및 코드 구현
TypeSafe는 단순한 입출력 테스트를 넘어, 실제 프로덕션 환경의 복잡한 비즈니스 그래프를 시뮬레이션한 워크플로우 평가(Workflow Evals)를 공개했습니다.
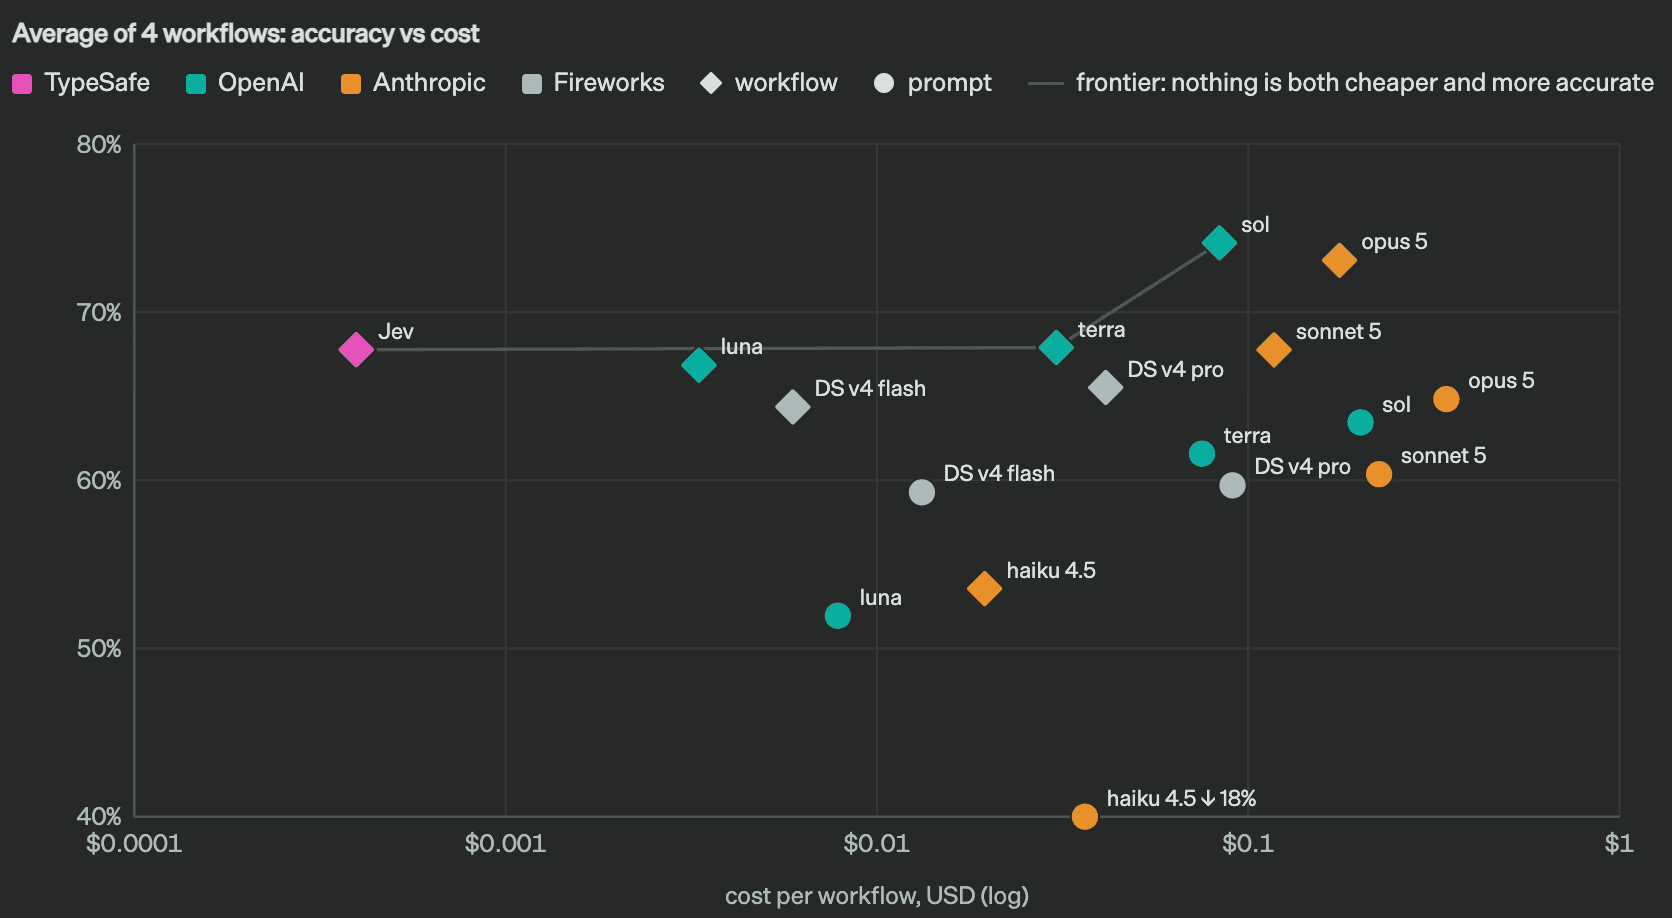
GPT-6 Astra와 Fable 5.1 같은 최상위 프론티어 모델의 의사결정 분포를 레퍼런스로 삼아 비교했을 때, Jev는 복잡한 다단계 의사결정 트리에서도 최상위 LLM과 대등한 수준의 판단 지능을 입증했습니다.
Python SDK를 활용한 실전 구현 예제
아래는 비정형 고객 불만 문의를 입력받아 Jev의 3대 원형(Noul, Choice, Score)을 단 한 번의 네트워크 요청으로 병렬 처리하는 예제 코드입니다:
import os
from typesafe import TypeSafeClient
from typesafe.primitives import Noul, Choice, Score

# 1. 클라이언트 초기화
client = TypeSafeClient(api_key=os.environ.get("TYPESAFE_API_KEY"))

# 2. 분석 대상 비정형 텍스트 (State)
customer_message = """
지난주에 결제한 엔터프라이즈 플랜 요금이 이중 청구되었습니다.
벌써 세 번째 메일을 보내는데 고객센터 응답이 전혀 없네요.
오늘 오후까지 환불 승인 안 되면 금융감독원에 민원 접수하고 법적 조치 들어가겠습니다.
빠른 확인 부탁드립니다.
"""

# 3. 단일 병렬 호출을 통한 다차원 의사결정 (Fan-out Query)
decisions = client.decide(
    state=customer_message,
    queries={
        # Noul: 이중 결제/환불 건인가?
        "is_refund_request": Noul(
            question="고객이 결제 취소 또는 이중 결제 환불을 강력히 요구하고 있는가?"
        ),
        # Choice: 담당 배정 부서 선택
        "target_department": Choice(
            question="이 티켓을 최우선으로 배정해야 할 부서는 어디인가?",
            options=["billing", "technical_support", "sales", "legal_risk", "other"]
        ),
        # Score: 고객의 이탈(Churn) 및 법적 위협 수준 평가 (0~4단계)
        "churn_risk_level": Score(
            question="고객의 불만 및 서비스 이탈 위협 수준은 어느 정도인가?",
            levels=[
                "0: 평온한 일반 문의",
                "1: 경미한 불편 제기",
                "2: 강한 어조의 항의",
                "3: 법적 조치 및 공공기관 민원 언급",
                "4: 회복 불가능한 극단적 이탈 확정"
            ]
        )
    }
)

# 4. 결과 추출 및 분기문 처리
is_refund = decisions["is_refund_request"].noul  # float (예: 0.96)
dept_choice = decisions["target_department"]     # choice 객체
risk_score = decisions["churn_risk_level"].score # float (예: 3.24)

print(f"[환불 확률] {is_refund:.3f}")
print(f"[배정 부서] {dept_choice.choice} (신뢰도: {dept_choice.confidence:.2f})")
print(f"[위험 점수] {risk_score:.2f} / 4.0")

# 5. 프로덕션 조건문 분기
if is_refund > 0.85 and dept_choice.choice == "billing":
    if risk_score >= 3.0:
        print("🚨 [긴급] 법적 대응 경고 고객! 당직 재무팀 팀장에게 즉시 PagerDuty 호출")
    else:
        print("✅ 정규 환불 대기열 자동 접수")
네트워크 호출 1회, 150ms 미만의 지연시간 안에 완벽하게 파싱된 파이썬 객체가 반환되므로 try-except json.JSONDecodeError를 전전긍긍할 필요가 전혀 없습니다.
8. Jev를 쓰기 전 반드시 점검해야 할 5가지 제약
아무리 뛰어난 도구라도 모든 문제의 은탄환(Silver Bullet)은 아닙니다. 공식 문서와 기술 사양서를 통해 확인된 Jev의 대표적인 제약 사항은 다음과 같습니다:
- 자연어 텍스트 생성 불가: Jev는 문자열을 생성하지 않습니다. 이메일 초안 작성, 회의록 요약, 코드 리팩토링에는 반드시 Claude나 GPT를 써야 합니다.
- 사칙연산 및 계산 불가 (“Jev is not a calculator”): 날짜 간격 계산이나 복잡한 수치 연산은 파이썬 코드로 해결해야 합니다.
- 다단계 간접 추론 불가: “A는 B이고 B는 C이므로 D를 선택하라” 같은 복합 논리 추론은 System 2 모델(추론 전용 LLM)의 영역입니다.
- 거대 상태 입력 시 품질 저하: 64K 토큰을 지원하지만, 질문과 무관한 노이즈 텍스트가 지나치게 많으면 판단 정확도가 떨어집니다. 핵심 문맥 위주로 정제하여 전달해야 합니다.
- 선택지 255개 초과 시 제약: Choice 원형은 최대 255개 카디널리티까지만 지원하므로, 수천 개의 링크를 고를 때는 다단계 스코어링 전략을 설계해야 합니다.
9. 자주 묻는 질문 (FAQ)
Q1. 기존 LLM의 ’Structured Outputs(JSON Mode)’과 무엇이 다른가요?
기존 LLM의 구조화된 출력(JSON 모드)은 내부적으로 여전히 문자열 토큰을 하나씩 순차적으로 생성(Autoregressive)한 뒤 제약 문법(Grammar Constrained Decoding)을 덧씌운 방식입니다. 따라서 3~10초에 달하는 느린 지연시간과 높은 토큰 비용은 그대로 유지됩니다. 반면 Jev는 생성 단계를 아예 건너뛰고 단일 순전파에서 벡터 임베딩으로부터 직접 확률과 타입을 추출(Parallel Sampler)하므로 속도와 비용에서 40~200배 차이가 납니다.
Q2. Jev를 사내 로컬 서버(On-Premise)에 설치할 수 있나요?
현재 얼리 액세스 단계에서는 TypeSafe AI 클라우드 엔드포인트를 통한 관리형 API 형태로만 제공됩니다. 단, 엔터프라이즈 고객을 위한 전용 VPC 배포 옵션이 로드맵에 포함되어 있습니다.
Q3. 한국어 텍스트도 상태 정보로 정상 인식하나요?
네, 정상 지원합니다. 사전학습 코퍼스에 다국어 데이터가 포함되어 있어 한국어 고객 문의, 회의록, 계약서 텍스트를 state로 전달해도 높은 보정 확률로 의사결정을 수행합니다.
Q4. 텍스트를 출력하지 않는다면 최종 사용자 답변은 어떻게 처리하나요?
사용자에게 전달할 답변 문구는 ‘미리 준비된 템플릿(Canned Response)’과 결합하거나, 고품질 작성이 필요한 특수 케이스에 한해 ‘소형 생성 모델’을 후단에 붙여 생성합니다. 시스템의 로직 제어와 텍스트 작성을 분리하는 것이 핵심입니다.
Q5. 얼리 액세스는 어떻게 참여할 수 있나요?
TypeSafe 공식 홈페이지(typesafe.ai)에서 웨이트리스트를 접수받고 있으며, API 키 발급 후 제공되는 콘솔 플레이그라운드를 통해 브라우저 상에서 직접 쿼리를 시뮬레이션해 볼 수 있습니다.
10. 마치며: ’코드와 AI의 경계’가 허물어지는 시대
지난 3년간 생성형 AI는 ’인간과 대화하는 마법 같은 챗봇’으로 세상의 이목을 사로잡았습니다. 하지만 화려한 데모의 열기가 가라앉은 지금, 엔지니어들이 마주한 진짜 과제는 “어떻게 하면 이 불확실한 신경망을 견고한 소프트웨어 백엔드에 안전하게 편입시킬 것인가”입니다.
TypeSafe의 Jev는 AI를 ’신비로운 지능체’가 아니라 ‘신뢰할 수 있고, 측정 가능하며, 타입이 보장되는 고성능 소프트웨어 부품’으로 바라보는 첫 번째 패러다임 전환입니다.
# 미래의 소프트웨어 코드 한 줄
if jev.evaluate("이 트랜잭션이 비정상 패턴인가?", state=tx_log).noul >= 0.92:
    block_transaction()
말만 앞서며 엉뚱한 실수를 저지르는 챗봇에 지치셨다면, 이제 소프트웨어 내부에서 묵묵히 밀리초 단위로 정확한 결정을 내리는 System One 모델의 세계에 주목해 보시기 바랍니다.