- 트랜스포머의 기본 Q·K·V Attention 동작 원리와 행렬 연산 과정을 시각적으로 직관 이해
- 대규모 언어 모델(LLM) 추론 시 VRAM을 집어삼키는 KV Cache 폭발과 메모리 대역폭(Memory-bound) 병목의 본질 파악
- 기존 해결책이었던 MQA와 GQA의 한계(Head 공유로 인한 표현력 손실 딜레마)
- DeepSeek이 세계를 놀라게 한 MLA(Multi-Head Latent Attention)의 3대 핵심 기둥: 저차원 잠재 압축(Low-Rank Joint Compression), 가중치 흡수(Weight Absorption), 위치 분리(Decoupled RoPE)의 완벽한 수학적·공학적 원리 정복
최근 오픈소스 거대 언어 모델 진영에서 가장 거센 지각변동을 일으킨 주역을 꼽으라면 단연 DeepSeek입니다. 수백억 파라미터가 훌쩍 넘는 초대형 모델을 일반 서버에서도 믿기지 않는 속도와 저렴한 비용으로 구동해 내는 모습을 보면서, 도대체 아키텍처 내부에서 무슨 마법을 부린 것인지 며칠 동안 기술 보고서와 소스코드를 집요하게 파고들었습니다.
그 혁신의 한가운데에는 바로 MLA(Multi-Head Latent Attention)가 자리 잡고 있었습니다.
이번 글에서는 트랜스포머의 기본 Scaled Dot-Product Attention 행렬 곱셈부터, 현대 초거대 LLM 추론 환경을 짓누르는 하드웨어 메모리 병목, 그리고 DeepSeek이 선형대수학의 대수적 결합 법칙으로 이를 정면 돌파한 경이로운 여정을 20장의 시각 다이어그램과 함께 하나씩 명쾌하게 짚어보겠습니다.
1. 모든 것의 출발점: Attention 메커니즘과 Q·K·V의 본질
자연어는 단어들이 단순히 기계적으로 나열된 평면적 데이터가 아닙니다. 문장 속 단어들은 서로 문법적, 의미론적으로 거미줄처럼 얽혀 문맥(Context)을 빚어냅니다.
“The animal didn’t cross the street because it was too tired.”
(그 동물은 너무 피곤했기 때문에 길을 건너지 않았다.)
사람은 이 문장을 볼 때 대명사 “it”이 가리키는 대상이 길(street)이 아니라 동물(animal)이라는 사실을 0.1초 만에 알아챕니다. 뒤에 나오는 ’tired(피곤한)’라는 상태 서술어와 상식을 연결하기 때문입니다.
하지만 숫자로만 세상을 바라보는 인공지능 모델에게 문맥을 가르치려면 어떻게 해야 할까요? 과거 RNN처럼 단어를 순차적으로 훑다 보면 문장이 길어질수록 앞쪽 정보가 지워지는 장거리 의존성 손실(Long-range Dependency Loss)이 필연적으로 발생했습니다.
트랜스포머의 창시자들은 이 문제를 해결하기 위해 검색 엔진의 색인 시스템에서 영감을 얻은 세 가지 벡터, Query, Key, Value를 고안했습니다.
1.1 도서관 검색 시스템으로 이해하는 Q, K, V
입력된 각 토큰의 은닉 상태 벡터 \(X\)에 학습 가능한 가중치 행렬을 곱하면 세 가지 벡터가 탄생합니다.
\[Q = XW^Q, \quad K = XW^K, \quad V = XW^V\]
이 세 요소는 거대한 국립중앙도서관의 검색 파이프라인과 완벽히 일치합니다.
| 구성 요소 | 도서관 비유 | 수학적 / 모델링 관점의 역할 |
|---|---|---|
| Query (\(Q\)) | 사용자가 검색창에 입력한 검색어 | “현재 내가 풀고자 하는 문맥적 의문은 무엇인가?” 현재 토큰이 문장 속 다른 단어들에게 던지는 질문 |
| Key (\(K\)) | 책 표지에 붙은 도서 분류 태그 및 색인 | “내가 어떤 주제의 정보를 담고 있는가?” 각 토큰이 자신이 품은 정보의 성격을 외부에 알리는 명함 |
| Value (\(V\)) | 서가에 꽂힌 책의 실제 본문 내용 | “실제로 가져갈 알맹이 정보는 무엇인가?” 유사도가 검증되었을 때 다음 층으로 전달할 실질적 의미 벡터 |
[현재 단어의 질문 (Query)] ───▶ 도서관 카탈로그 색인(Key)과 대조
                                      │
                                      ▼
             [유사도(Attention Score) 계산: 일치율 85%, 10%, 5%]
                                      │
                                      ▼
       [높은 유사도를 가진 책의 본문(Value)을 일치 비율만큼 섞어서 가져옴!]
1.2 행렬 곱셈으로 펼쳐지는 유사도 계산 (\(QK^T\))
문장 안의 모든 단어가 서로를 어떻게 바라보고 있는지 확인하려면, 모든 Query와 모든 Key의 내적(Dot-Product)을 일괄 계산해야 합니다.
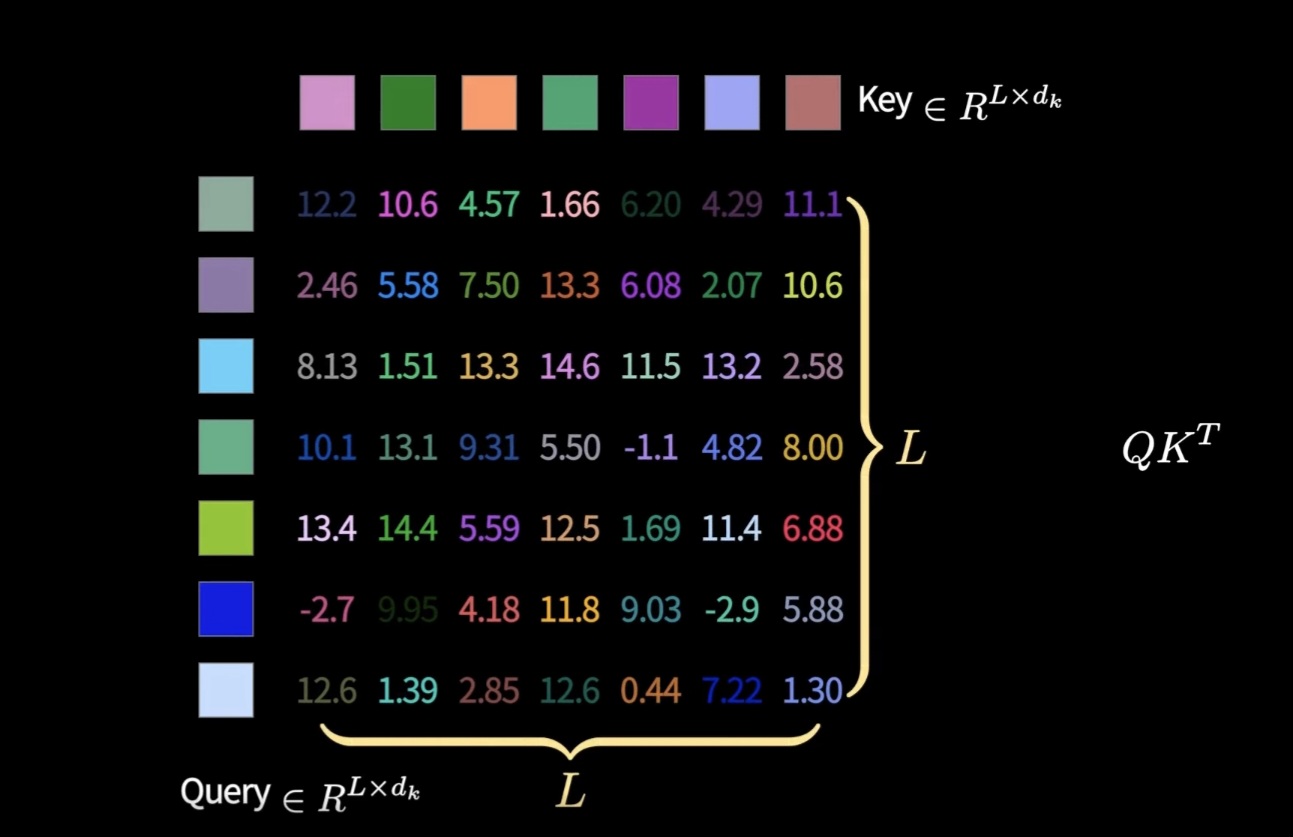
위 다이어그램처럼 시퀀스 길이 \(L\)을 갖는 Query 행렬(\(\mathbb{R}^{L \times d_k}\))과 Key의 전치 행렬 \(K^T\)(\(\mathbb{R}^{d_k \times L}\))을 행렬곱하면, 한 번의 연산으로 \(L \times L\) 크기의 거대한 유사도 점수 행렬이 만들어집니다.
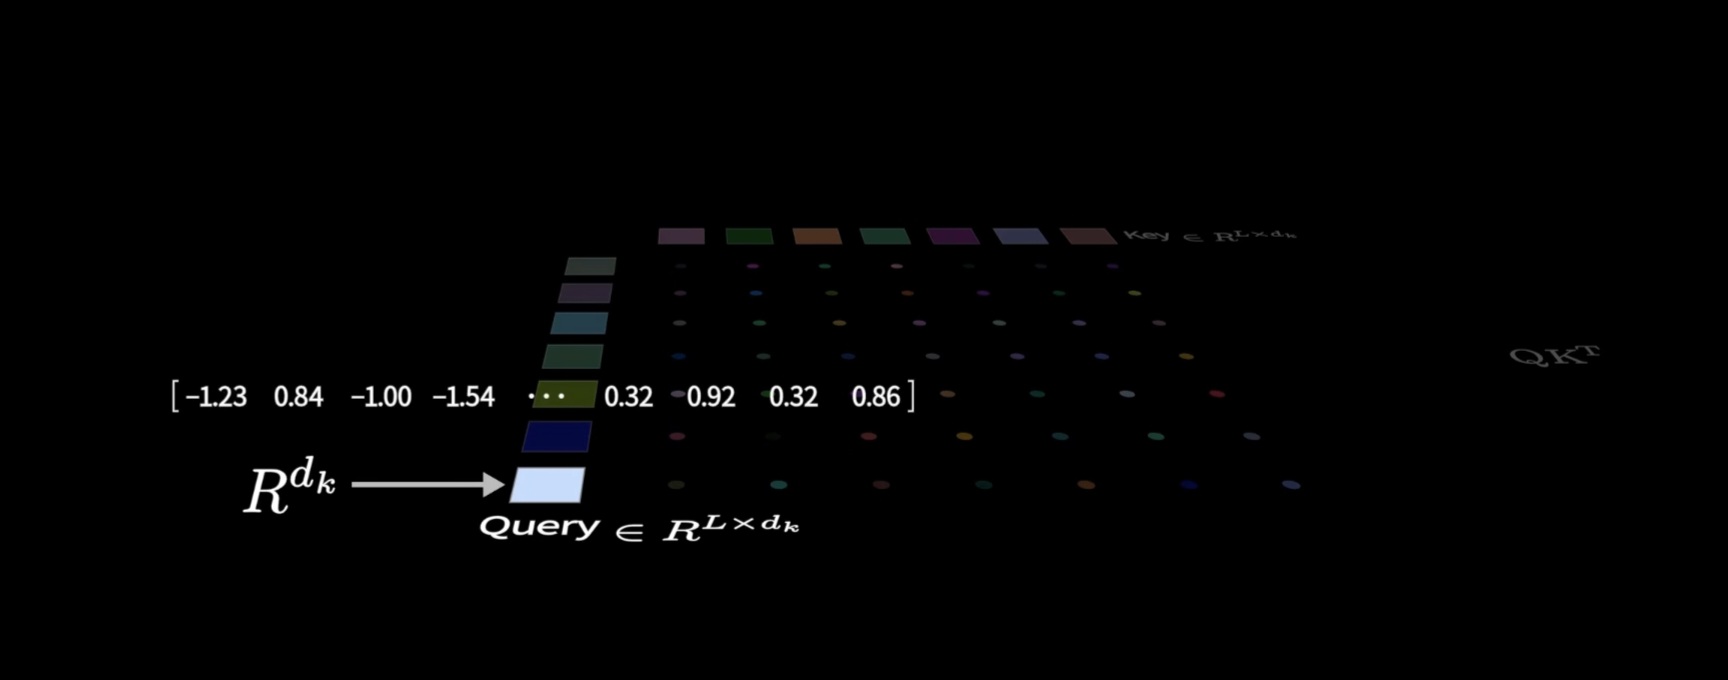
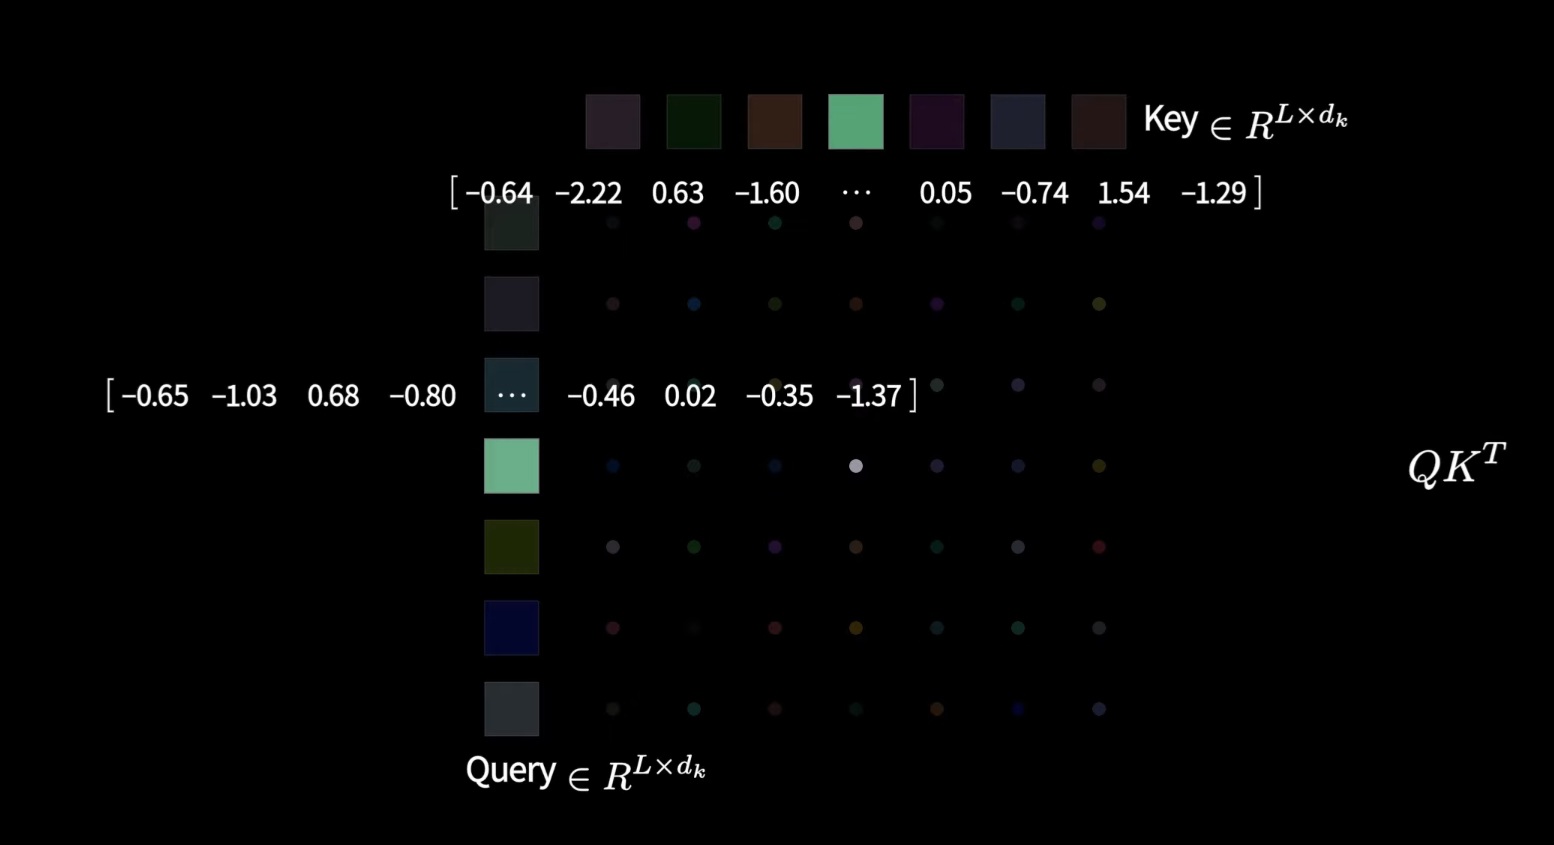
하나의 토큰 관점에서 뜯어보면, \(d_k\) 차원의 Query 행 벡터 하나가 Key 행렬의 각 열 벡터들과 순차적으로 내적(Dot-Product)을 수행합니다. 두 벡터가 같은 방향을 가리킬수록 내적값은 커지며, 이는 곧 “두 단어의 연관성이 수학적으로 대단히 높다”는 뜻이 됩니다.
1.3 왜 하필 \(\sqrt{d_k}\)로 나누어야 할까? (Softmax 포화 방지)
트랜스포머 원 논문(Attention Is All You Need)의 수식을 보면 내적 결과를 그대로 쓰지 않고 반드시 \(\sqrt{d_k}\)로 나눕니다.
\[\text{Attention}(Q, K, V) = \text{softmax}\left( \frac{QK^T}{\sqrt{d_k}} \right)V\]
왜 굳이 제곱근 차원으로 나누는 걸까요? 여기에는 엄밀한 통계학적 이유가 숨어 있습니다.
Query와 Key 벡터의 각 원소들이 평균 0, 분산 1을 따르는 독립 확률변수라고 가정해 보겠습니다. \(d_k\)개의 원소를 곱해서 더하는 내적 연산(\(\sum_{i=1}^{d_k} q_i k_i\))을 거치면, 독립 확률변수의 가산성에 의해 결과값의 분산은 정확히 \(d_k\)가 됩니다.
분산이 \(d_k\)라는 말은 표준편차가 \(\sqrt{d_k}\)라는 뜻입니다. 만약 최신 LLM처럼 \(d_k = 128\)이라면 표준편차가 무려 약 \(11.3\)에 달합니다. 이렇게 되면 내적 점수 행렬 안에 \(+30\), \(-25\) 같은 극단적인 값들이 마구 튀어나옵니다.
이 상태에서 지수 함수(\(e^x\))를 기반으로 작동하는 Softmax를 씌우면 어떻게 될까요? 가장 큰 단 하나의 값만 1.0(100%)에 가깝게 치솟고 나머지는 전부 0으로 죽어버리는 소프트맥스 포화(Softmax Saturation) 현상이 터집니다.
스케일링 생략 시 점수 : [  0.5,   2.1,  32.4,  -8.2 ]
                             │
                             ▼ Softmax 적용
극단적 원-핫 확률     : [  0.0,   0.0,   1.0,   0.0 ] ──▶ 그래디언트(미분값) = 0! (학습 중단)
소프트맥스 출력이 1에 수렴하는 영역에서는 함수의 기울기(미분값)가 거의 0이 되기 때문에, 역전파 시 그래디언트가 소실(Vanishing Gradient)되어 모델이 제대로 학습하지 못합니다.
따라서 내적값을 분산의 크기인 \(\sqrt{d_k}\)로 나누어 분산을 다시 깔끔하게 1로 정규화해 주는 것입니다. 단순한 나눗셈 하나에 이런 정교한 수학적 안전장치가 들어가 있습니다.
1.4 Softmax 확률과 Value의 가중합
스케일링을 거친 점수 행렬에 Softmax를 적용하면, 각 행(Row)의 합이 정확히 \(1.0(100\%)\)인 확률 분포로 전환됩니다.
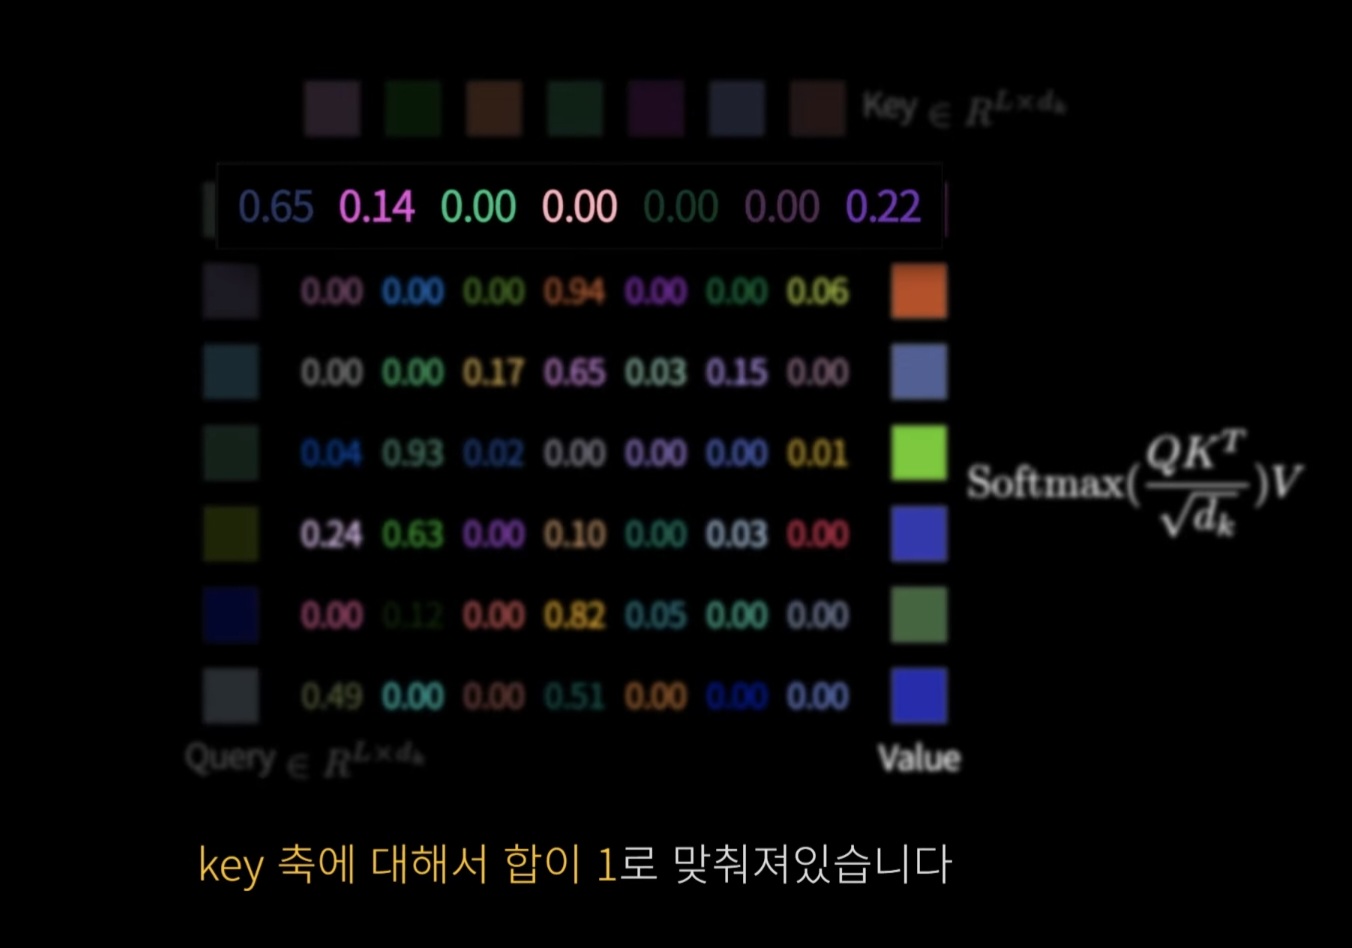
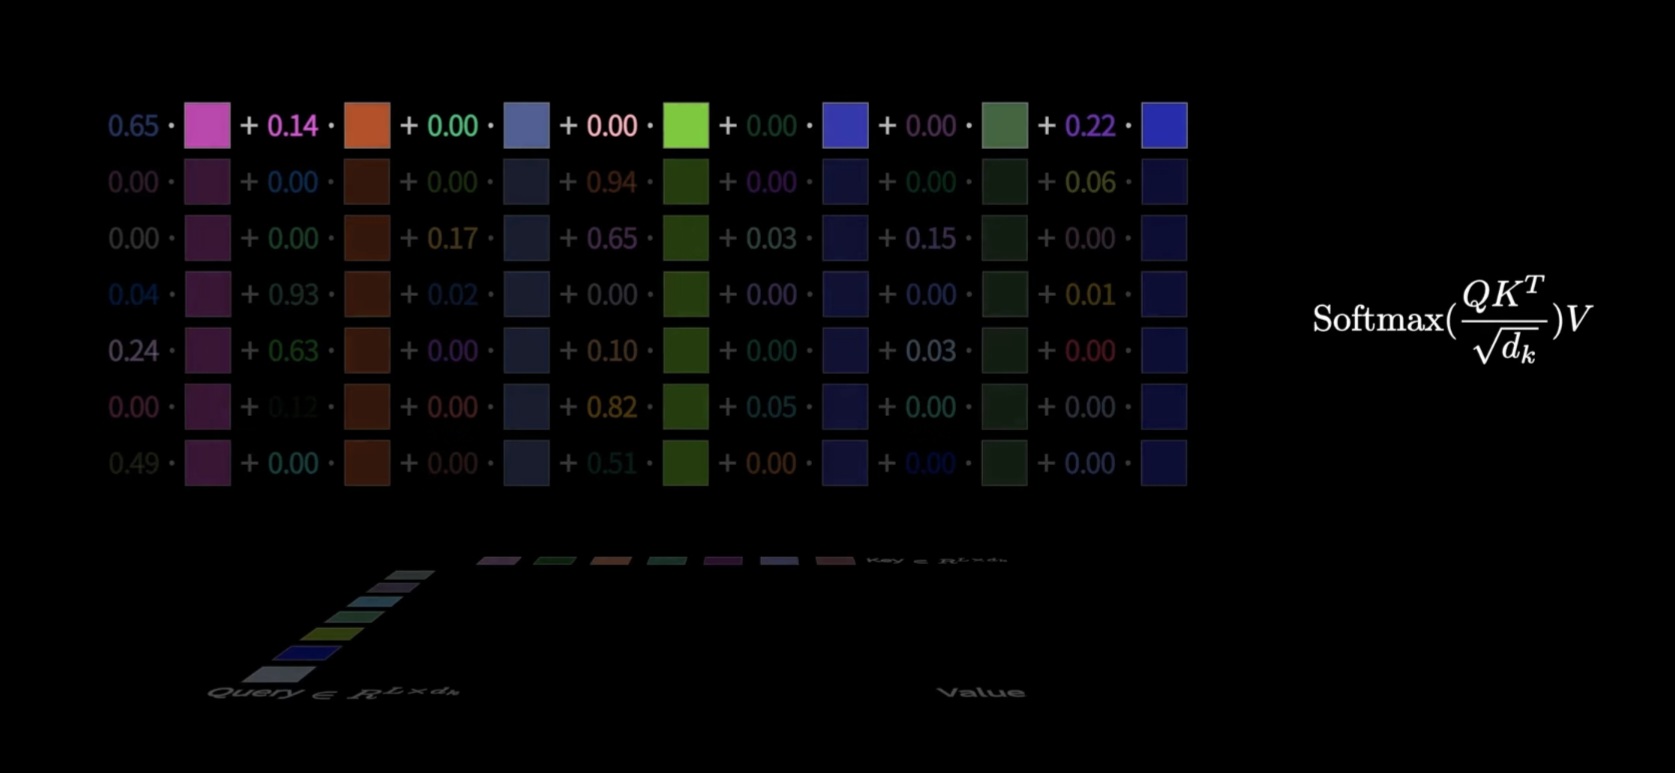
이제 이 확률값들을 실제 정보를 쥐고 있는 Value 벡터들에 곱해 줍니다.
예를 들어 “What is the meaning of piui ?”라는 문장이 입력되었을 때 모델이 연산하는 과정을 직접 눈으로 따라가 보겠습니다.
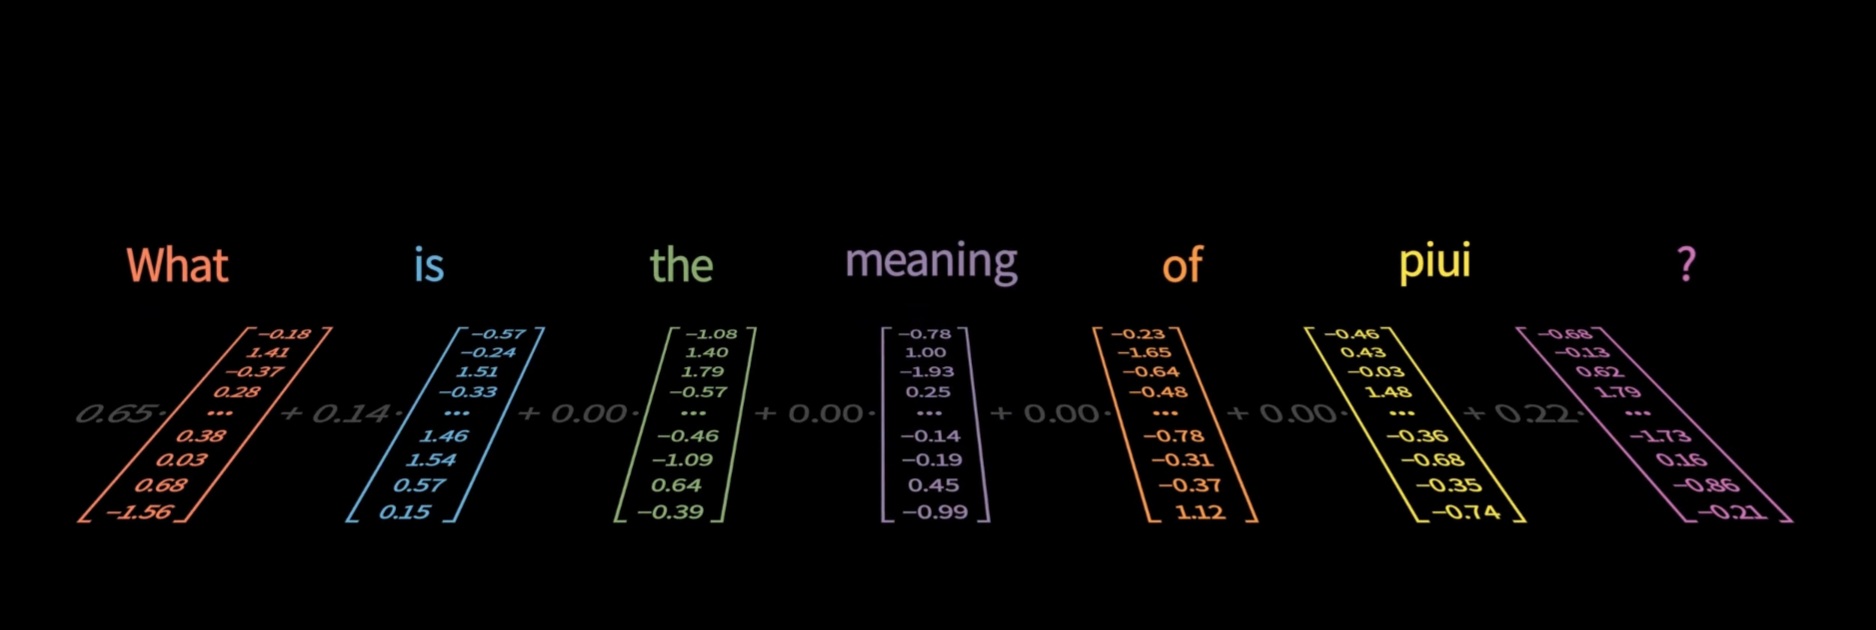
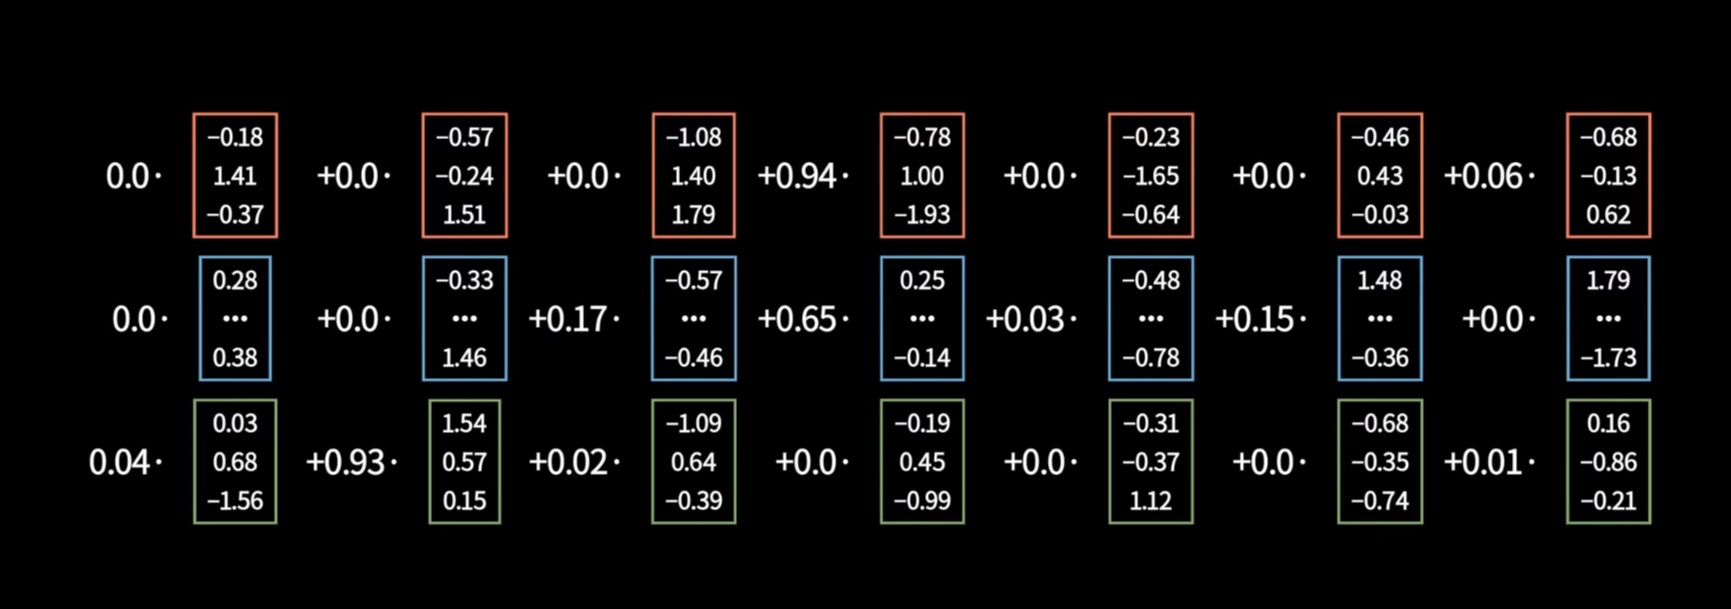
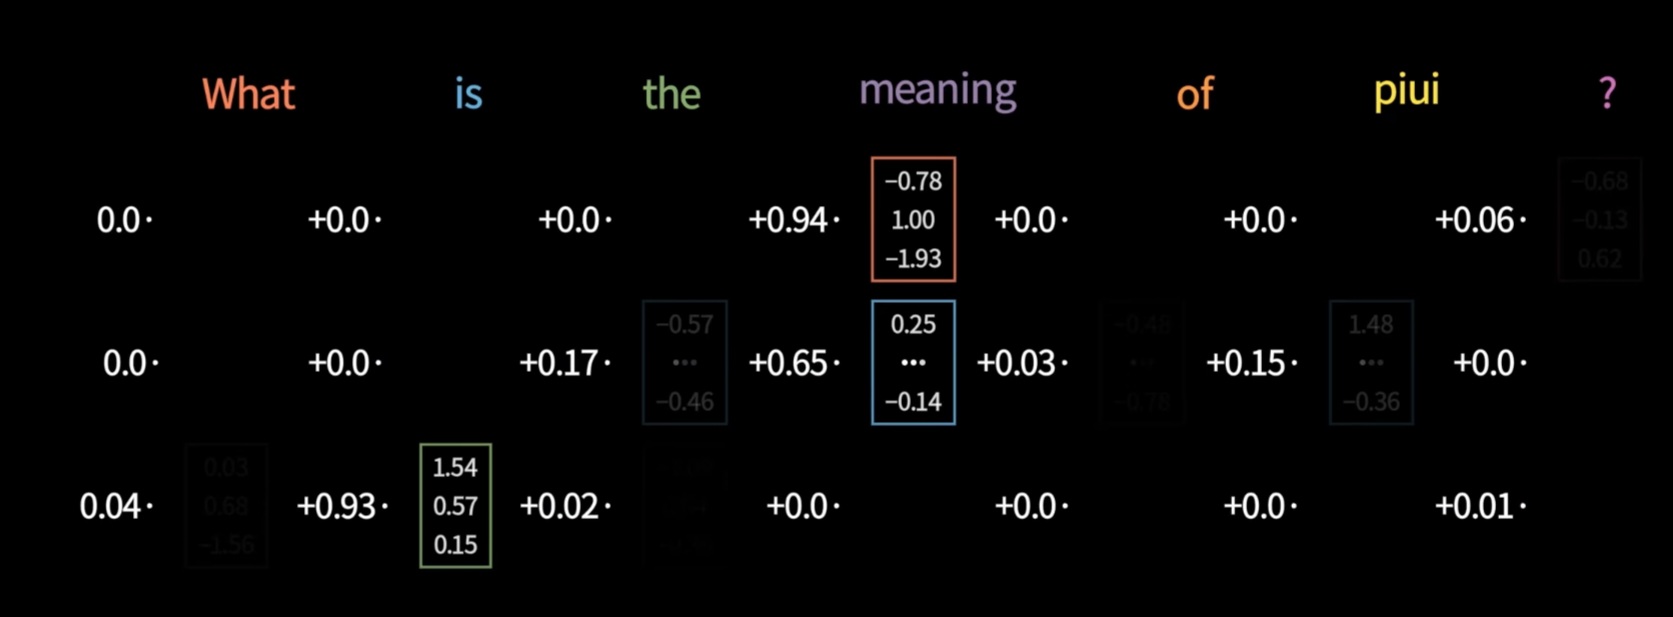
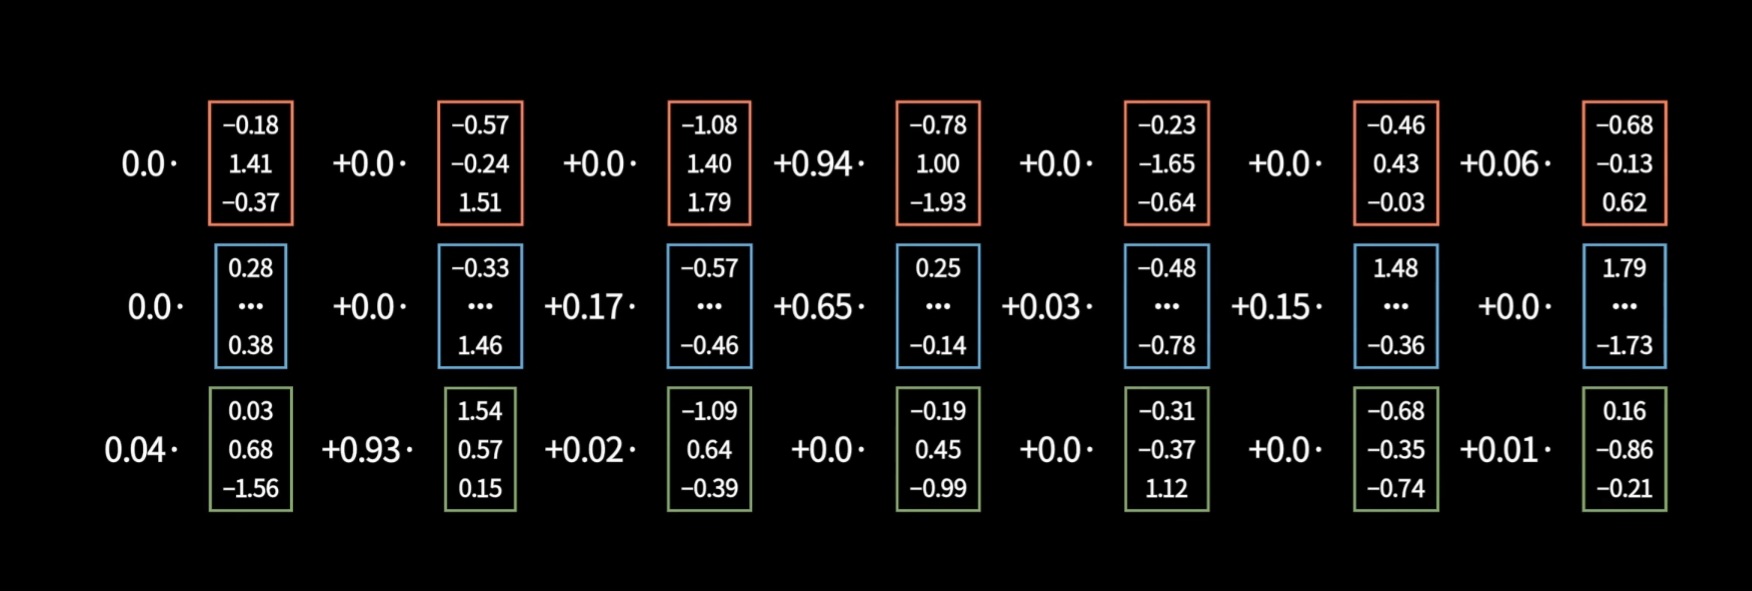
위 시각화에서 볼 수 있듯, 각 토큰은 문맥상 관련이 깊은 단어들의 Value 벡터를 자신의 확률 비중만큼 가중 평균(Weighted Sum)하여 흡수합니다. 그 결과 평면적이었던 단어 임베딩이 문맥을 온전히 머금은 문맥화된 표현(Contextualized Representation)으로 탈바꿈합니다.
2. 단일 시선의 한계를 깬 Multi-Head Attention (MHA)
단일 Attention(Single-Head)은 문맥을 조망하는 창문이 딱 하나뿐입니다.
하지만 인간의 언어는 복합적입니다. “The animal didn’t cross the street because it was too tired.”라는 한 문장 안에서도: 1. it과 animal의 대명사 지시 관계 2. didn't와 cross의 부정 문법 관계 3. cross와 street의 행동-목적어 관계
이 세 가지 관계를 단 하나의 가중치 분포로 동시에 포착하기는 불가능에 가깝습니다. Softmax는 가장 강한 유사도를 가진 곳 하나로 쏠리는 특성이 있기 때문입니다.
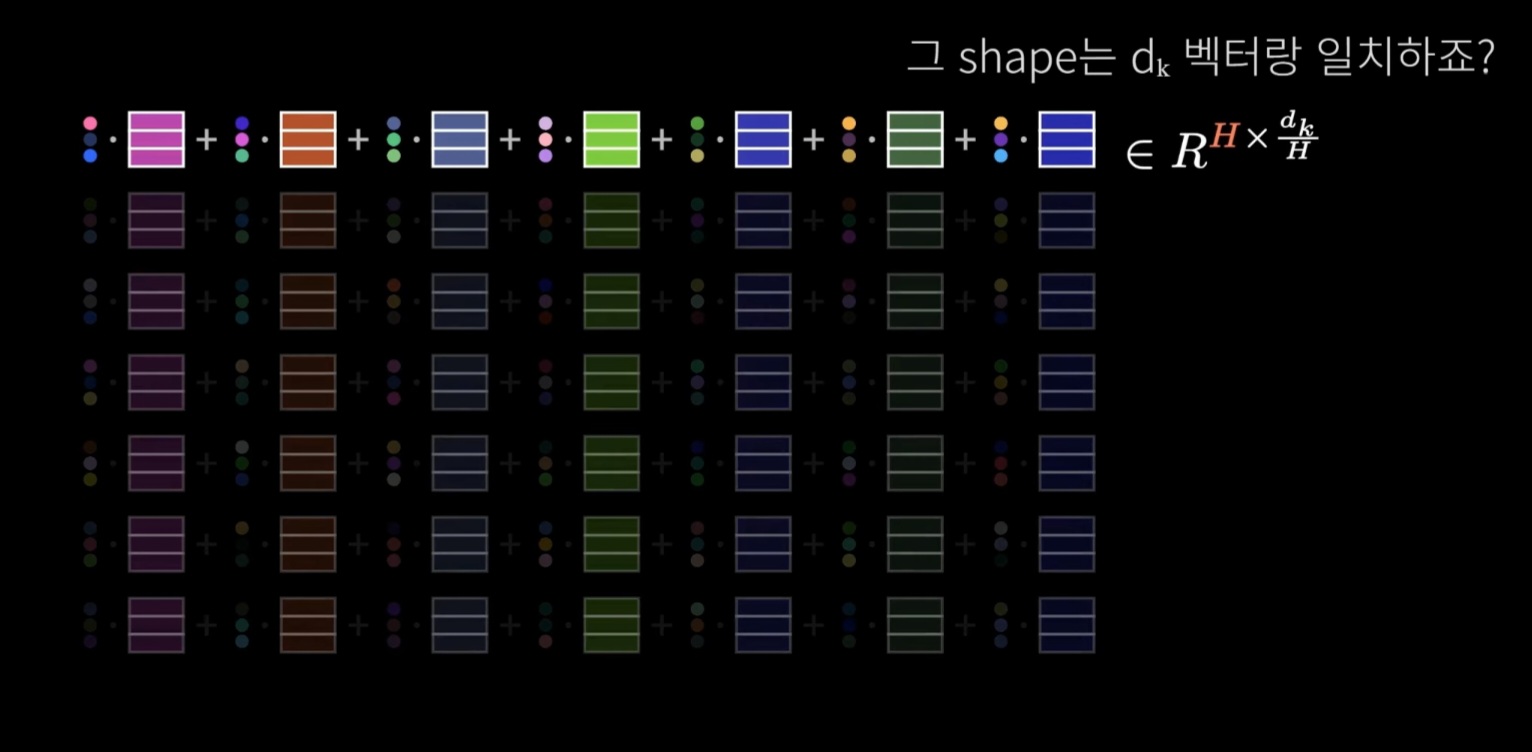
트랜스포머는 이 문제를 해결하기 위해 입력을 여러 개의 독립된 부분 공간(Subspace)으로 쪼개어 병렬로 처리하는 Multi-Head Attention (MHA)을 도입했습니다.
전체 차원 \(d_{\text{model}}\)을 Head의 개수 \(H\)로 균등하게 나눕니다 (\(d_h = d_{\text{model}} / H\)).
예를 들어 LLaMA-7B의 경우 은닉 차원이 4,096이고 Head 수가 32개라면, 각 Head는 128차원의 아담한 공간 안에서 서로 다른 관점(문법, 의미, 인과관계 등)을 자유롭게 학습합니다.
그리고 각 Head가 뽑아낸 결과들을 가로로 쭉 이어 붙인(Concatenate) 뒤 최종 출력 행렬 \(W^O\)를 곱해 원래 차원으로 복원합니다. 연산량(FLOPs)은 단일 거대 Head와 동일하게 유지하면서도 모델의 표현력을 비약적으로 끌어올린 혁신이었습니다.
3. 생성형 AI가 맞닥뜨린 거대한 벽: KV Cache와 메모리 대역폭
MHA는 완벽해 보였습니다. 하지만 2023년 이후 수천억 파라미터의 초거대 언어 모델이 상용화되고, 사용자가 긴 프롬프트(Long-context)를 밀어 넣으면서 예상치 못한 물리적 하드웨어의 벽에 부딪히게 됩니다.
3.1 토큰을 하나씩 뽑는 디코딩(Decoding)의 비효율
LLM의 생성 과정은 이전 토큰들을 보고 다음 단어 1개를 순차적으로 예측하는 자기회귀(Autoregressive) 방식입니다.
Step 1: "인공지능"                ──▶ "모델은"
Step 2: "인공지능 모델은"         ──▶ "문맥을"
Step 3: "인공지능 모델은 문맥을"  ──▶ "이해한다"
Step 3에서 “이해한다”라는 토큰을 만들 때, 과거 1~2단계에서 나왔던 토큰들의 Key와 Value를 다시 행렬 곱셈하여 계산한다면 연산량이 \(O(L^2)\)으로 폭증합니다. 문장이 2,000토큰만 넘어가도 응답 속도가 멈추는 수준에 이릅니다.
따라서 이미 계산이 끝난 과거 토큰들의 Key와 Value 벡터를 GPU 고속 메모리(VRAM)에 차곡차곡 모셔두는 KV Cache 기법이 필수가 되었습니다.
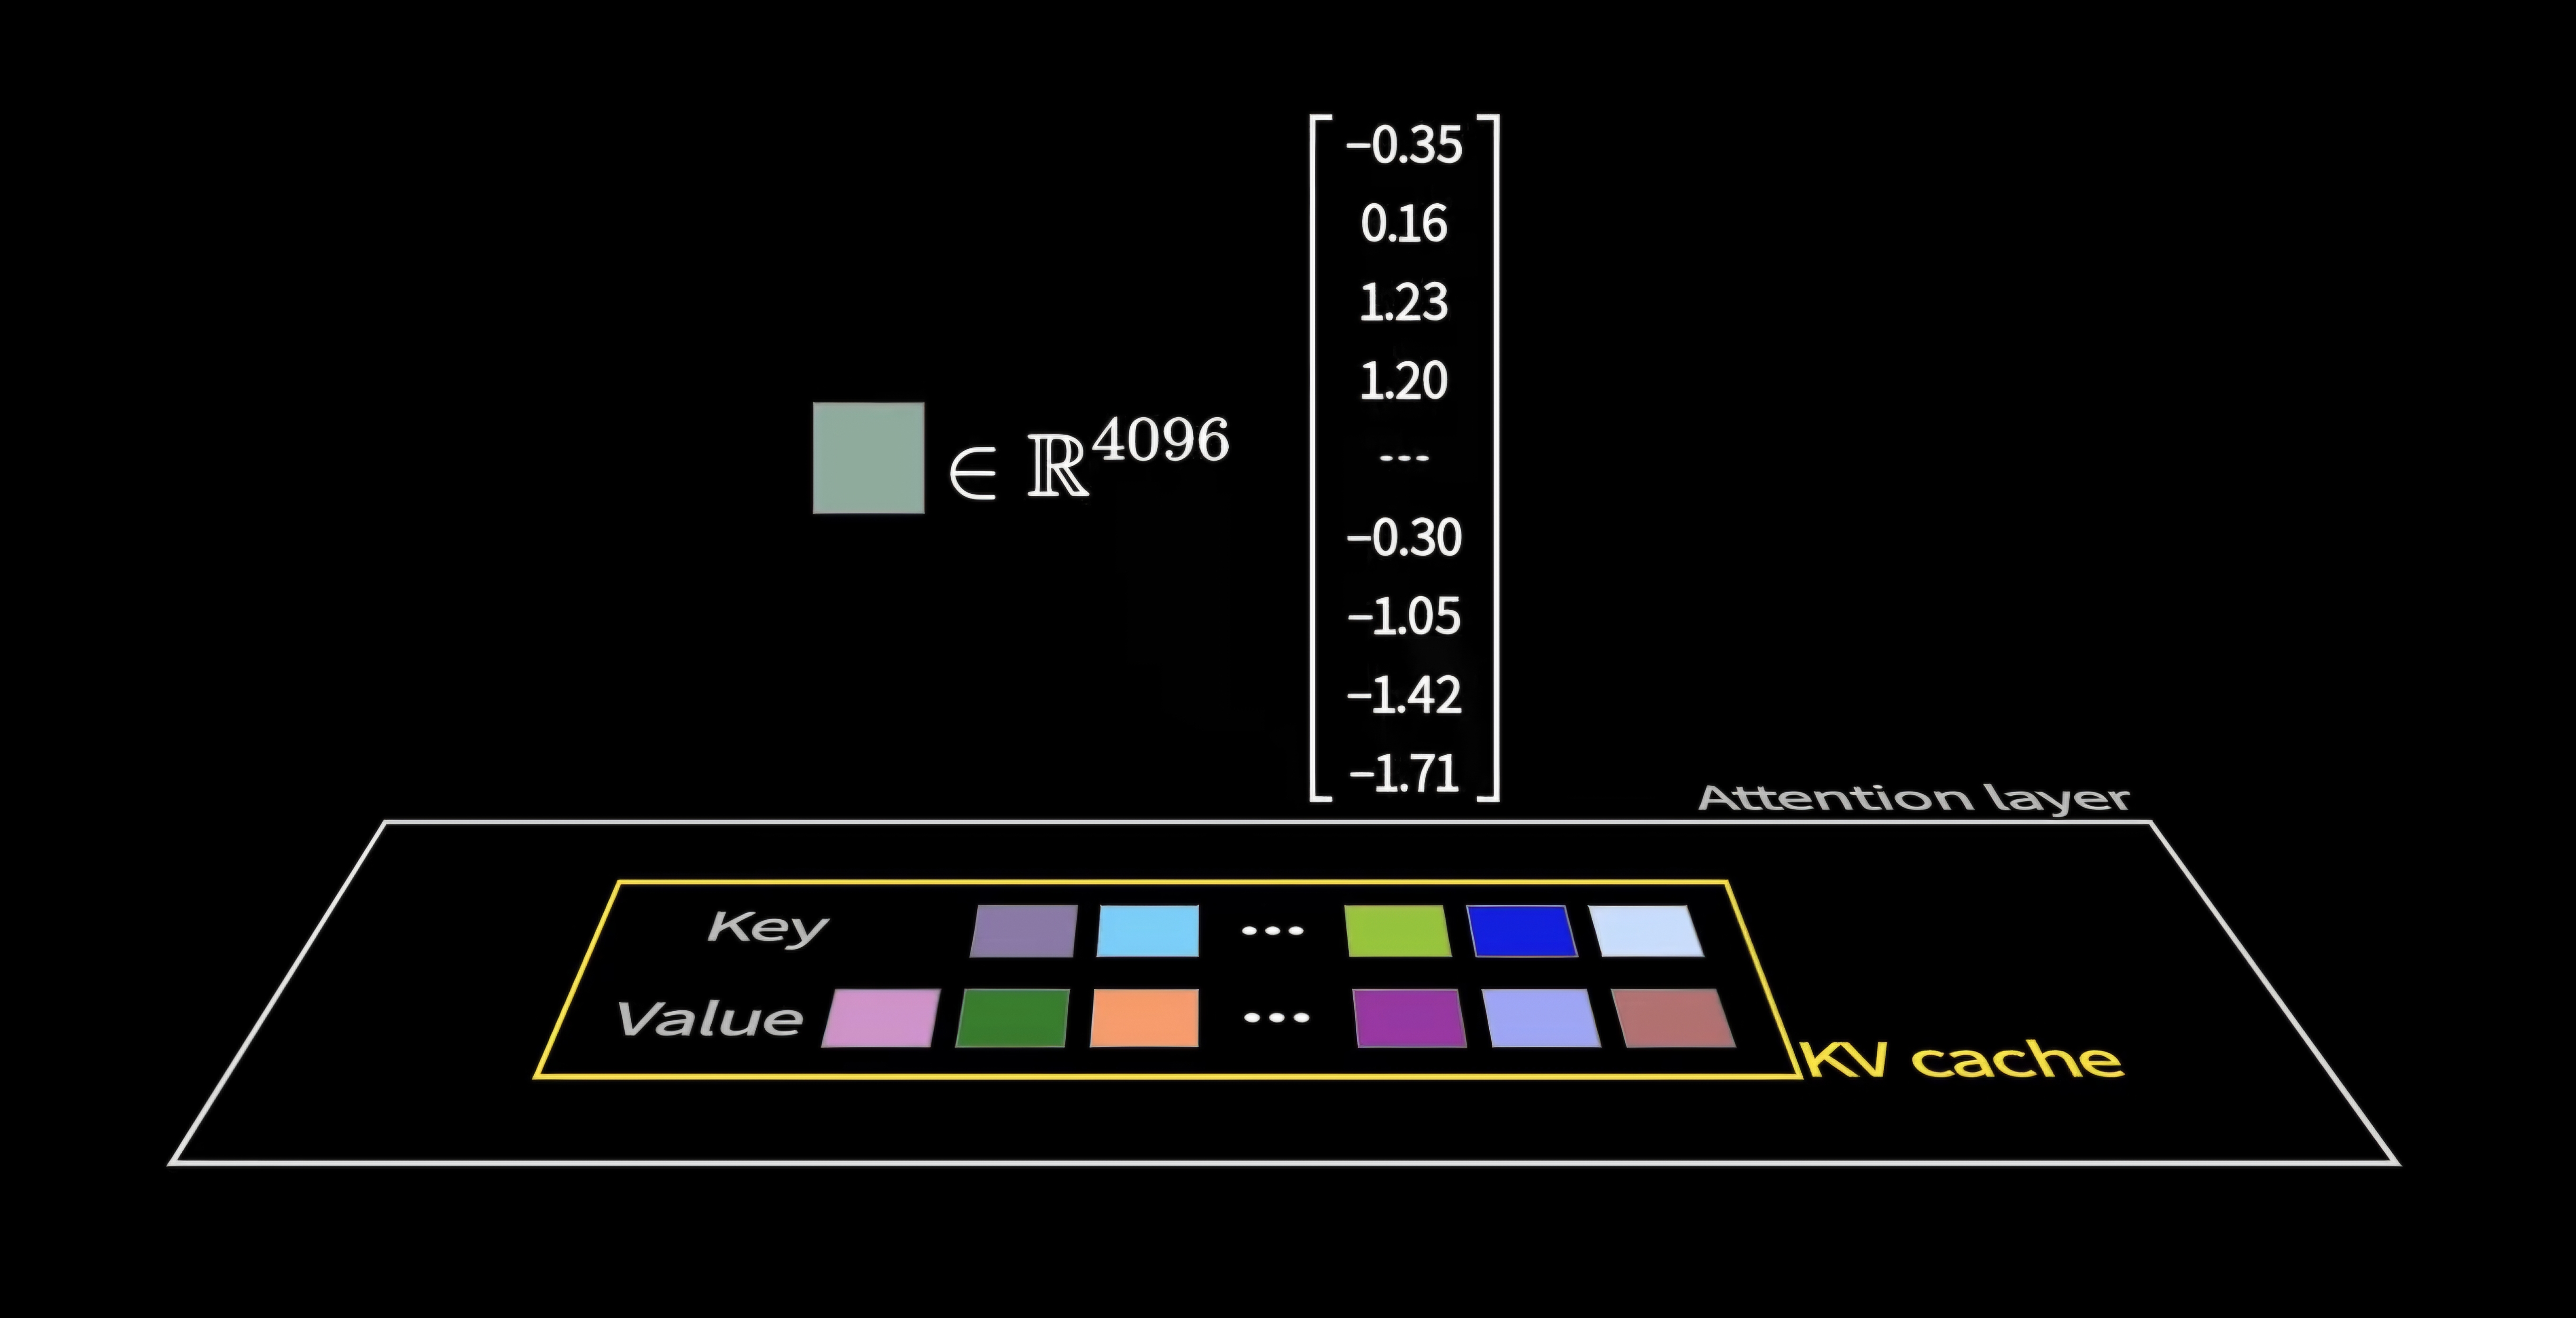
새로운 토큰 1개가 들어오면 그 토큰의 \(Q, K, V\)만 계산하고, 새로운 \(K, V\)를 캐시에 덧붙인 뒤 이전 캐시들과 곱하기만 하면 되므로 연산량이 \(O(L)\)로 줄어듭니다.
3.2 그런데 왜 VRAM이 터져나갈까? (KV Cache 메모리 계산)
연산 속도는 건졌지만, 대신 GPU 메모리를 무자비하게 집어삼키는 하마가 등장했습니다.
단 1개 토큰, 1개 레이어에서 MHA가 저장해야 하는 요소(Element) 수는 다음과 같습니다.
\[\text{Cache Elements per Token per Layer} = 2 \times n_h \times d_h\]
앞에 곱해진 숫자 2는 Key와 Value 두 세트를 각각 따로 보관해야 하기 때문입니다.
실제 모델인 LLaMA-2 70B를 기준으로 VRAM 사용량을 직접 손으로 계산해 보면 경악할 수치에 도달합니다. - 레이어 수 \(N = 80\)개 - Head 개수 \(n_h = 64\)개 - Head 차원 \(d_h = 128\) - 16비트 정밀도 (BF16, 토큰당 2바이트) - 문맥 길이 \(L = 4,096\) 토큰
\[\text{단 1명의 요청(Batch=1) KV 캐시} = 2 \times 4096 \times 80 \times 64 \times 128 \times 2 \text{ Bytes} \approx \mathbf{10.74 \text{ GB}}\]
동시 접속자 단 1명이 4K 토큰짜리 대화를 나누는데 순수 KV Cache로만 10GB가 넘는 VRAM이 증발합니다. 동시 요청이 8개로 늘어나면 캐시만으로 80GB가 꽉 차서 1억 원짜리 H100 GPU조차 OOM(Out of Memory)으로 서버가 뻗어버립니다.
3.3 메모리 대역폭(Memory Bandwidth)의 장벽: Roofline 모델의 비극
더 큰 비극은 연산 속도에서 터집니다.
토큰 생성(Decoding) 단계에서는 매 스텝마다 딱 1개의 토큰만 만듭니다. 행렬곱 연산 자체는 찰나의 순간에 끝납니다.
하지만 그 1개 토큰을 처리하기 위해 수십 기가바이트에 달하는 전체 KV Cache를 GPU VRAM(HBM)에서 연산 코어(SRAM)로 실어 날라야 합니다.
데이터 전송 통로(메모리 버스)가 좁아 데이터를 퍼 올리느라 시간이 다 가고, 정작 GPU의 막강한 텐서 코어는 80% 이상의 시간 동안 놀면서 멍때리는 극단적인 메모리 대역폭 제한(Memory-Bandwidth Bound)에 빠지게 됩니다.
결국 LLM 서비스의 동시 처리량(Throughput)을 늘리고 비용을 낮추려면, “저장하고 퍼 올려야 하는 KV Cache의 물리적 용량을 획기적으로 줄이는 것” 외에는 탈출구가 없었습니다.
4. Head를 줄여서 타협하다: MQA와 GQA의 등장과 한계
연구진들이 가장 먼저 떠올린 아이디어는 단순했습니다.
“Query는 여러 관점을 봐야 하니 Head를 유지하되, Key와 Value는 여러 Head가 함께 나눠 쓰면(공유하면) 되지 않을까?”
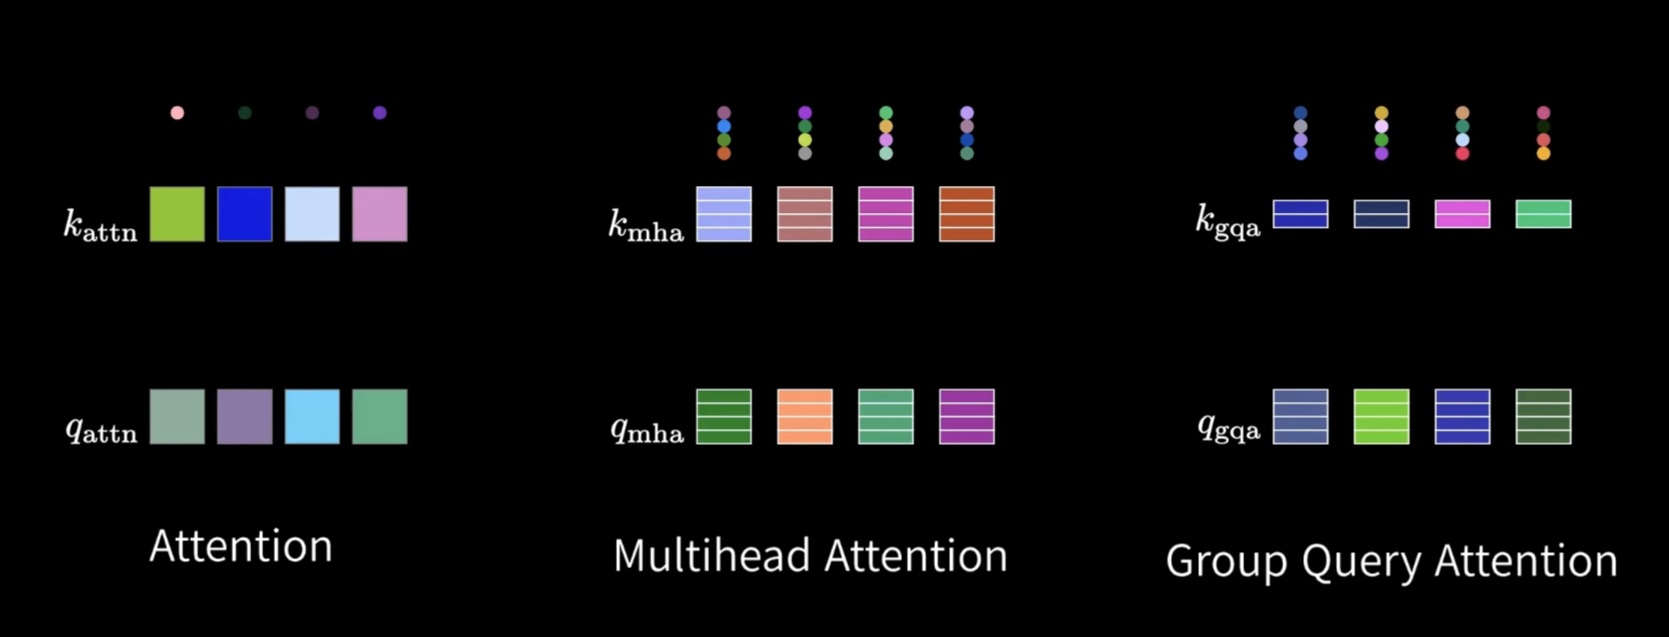
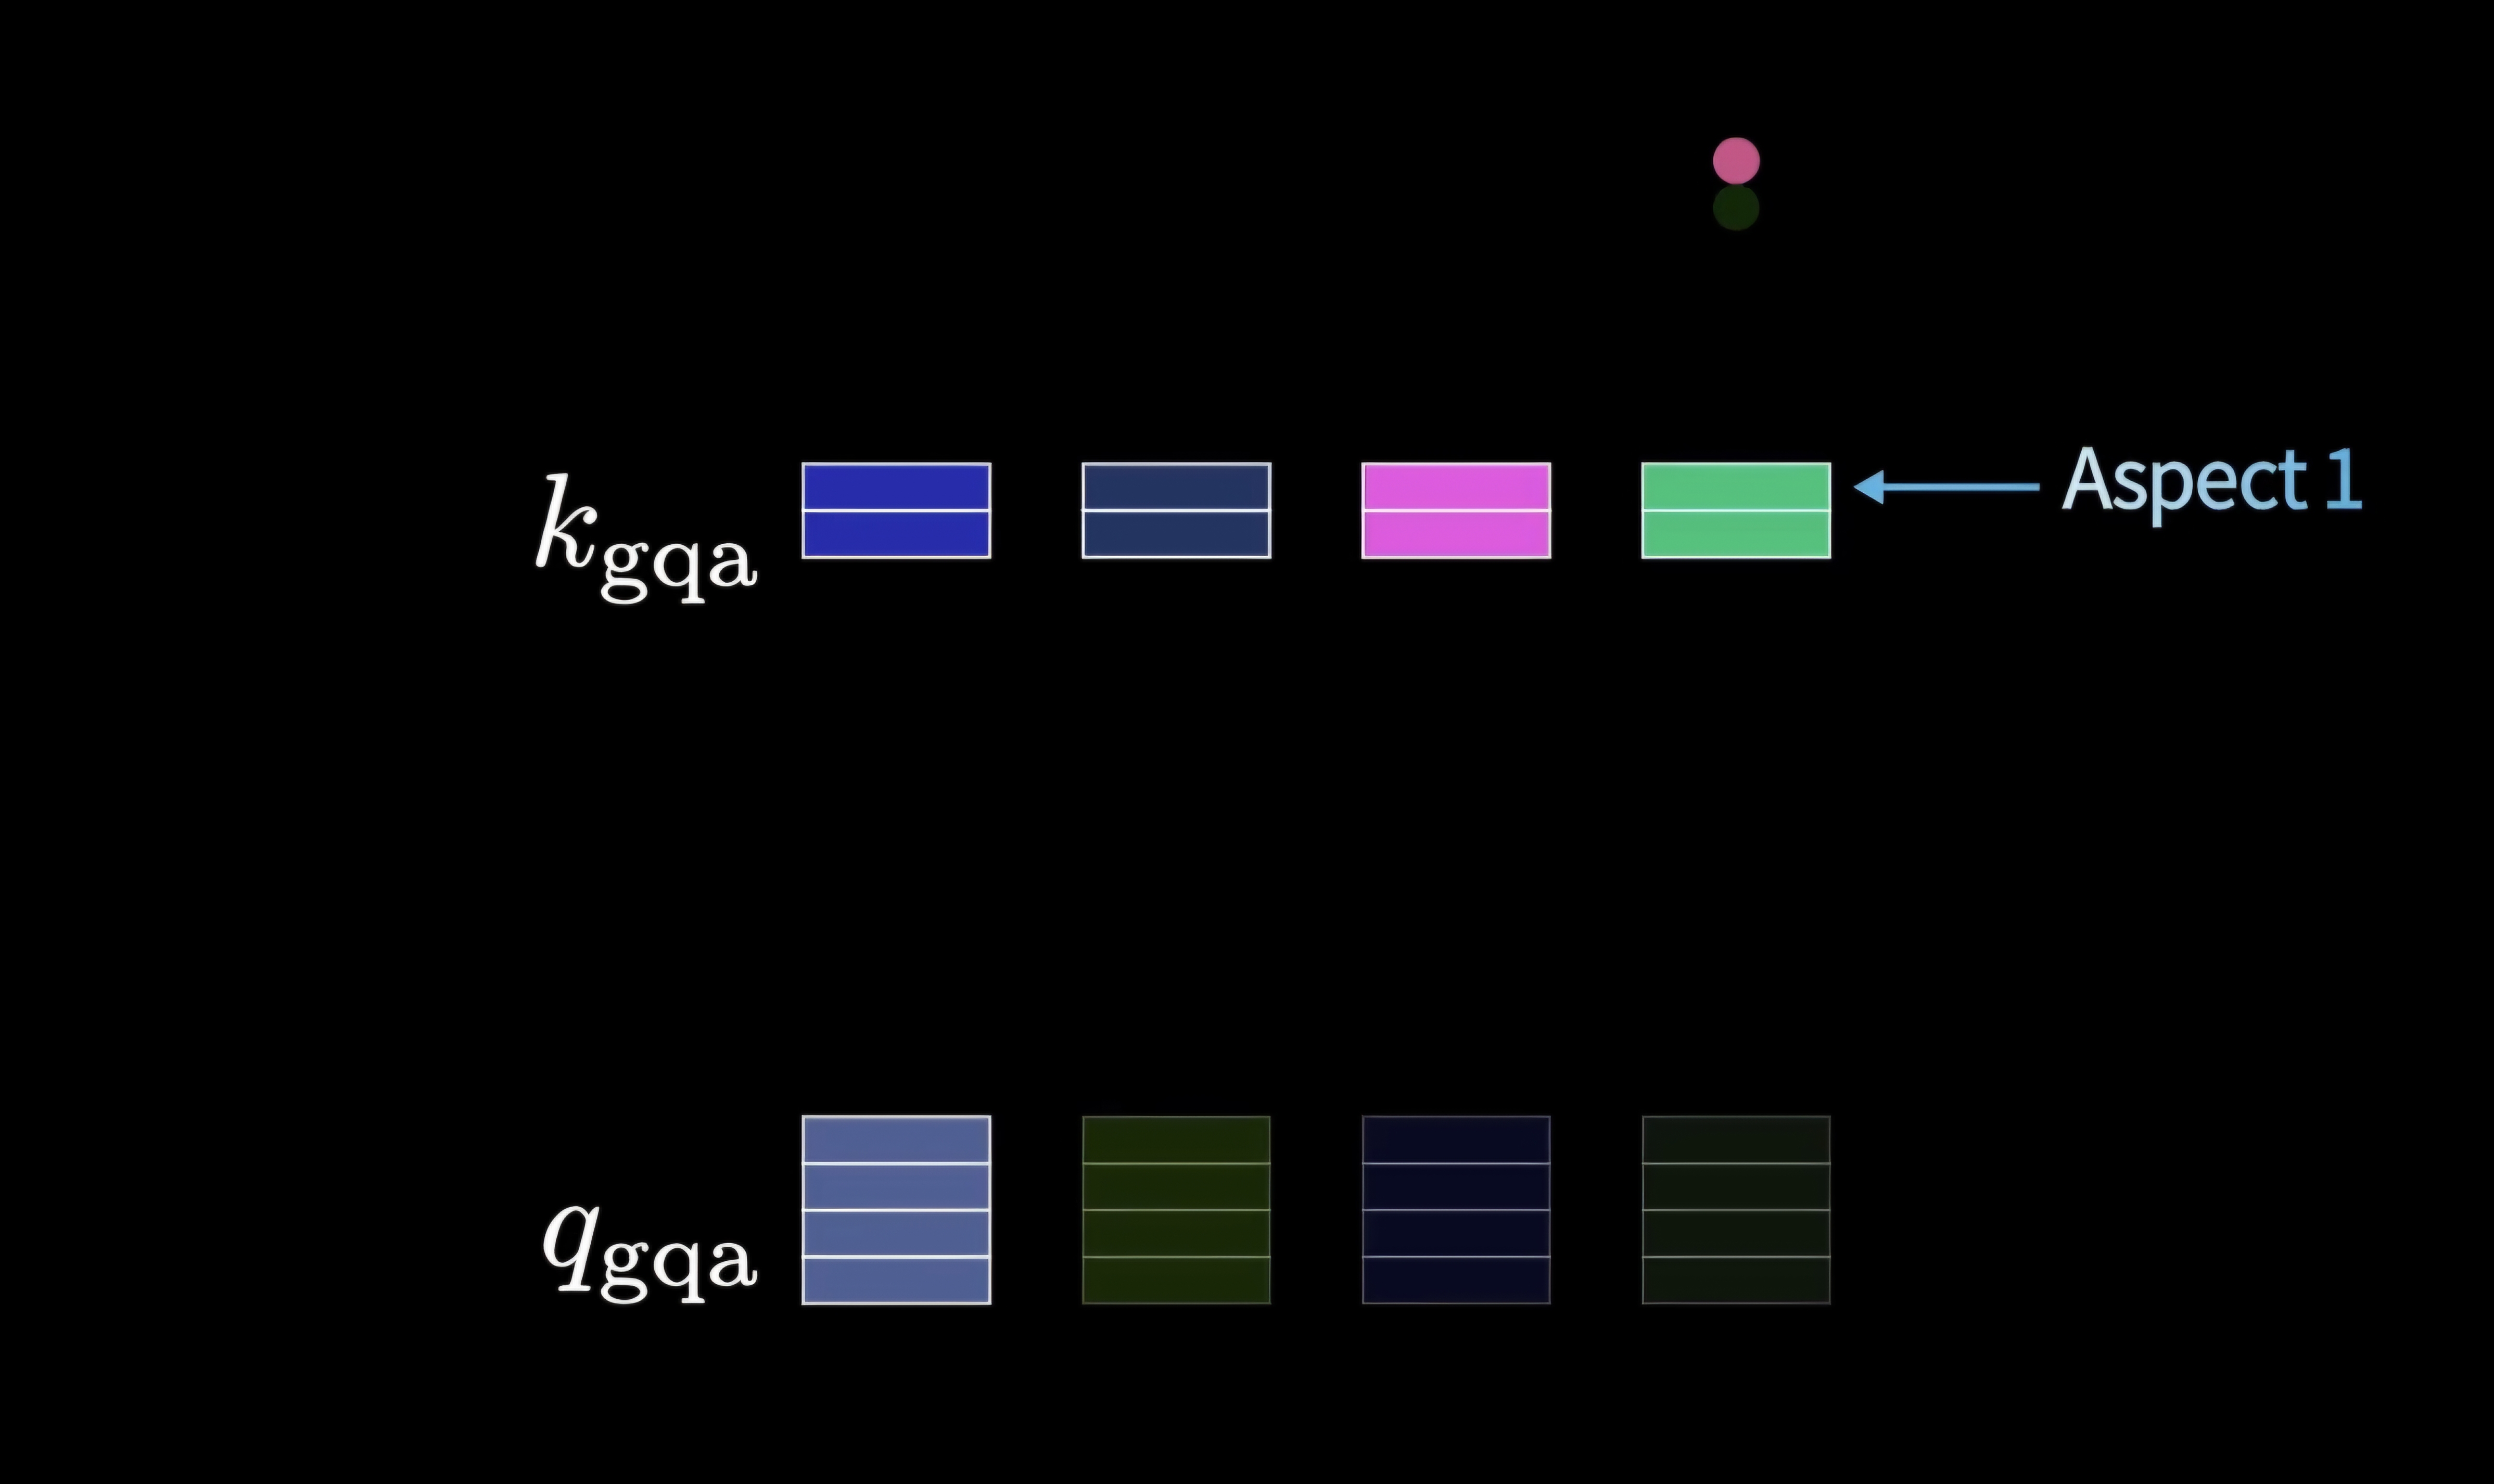
MQA (Multi-Query Attention)의 극단적 처방
2019년 제안된 MQA는 모델 전체에서 Key와 Value Head를 딱 1개만 두고 모든 Query가 이를 공유하도록 만들었습니다. - 캐시 크기가 \(\frac{1}{H}\) (약 96~98%) 수준으로 줄어들어 속도는 엄청나게 빨라졌습니다. - 하지만 모든 관점이 단 하나의 획일적인 K/V 표현 공간에 갇히다 보니, 복잡한 추론이나 코딩 태스크에서 심각한 모델 성능 저하가 발생했습니다.
GQA (Grouped-Query Attention)의 절충
2023년 등장한 GQA는 Query Head들을 몇 개의 그룹(예: 8개)으로 묶고, 각 그룹 안에서만 K/V Head를 공유하도록 타협점을 찾았습니다. - LLaMA-2/3, Mistral 등 현대 오픈소스 모델들의 사실상 표준이 되었습니다. - MHA 대비 캐시를 75~87% 줄이면서도 준수한 정확도를 유지했습니다.
🛑 풀리지 않은 딜레마
하지만 GQA 역시 근본적으로는 “Head의 개수를 물리적으로 줄이는 공유(Sharing) 전략”에 불과했습니다. Head 수를 줄인다는 것은 모델이 언어를 다각도로 탐색할 수 있는 자유도(Degrees of Freedom)를 강제로 거세하는 것과 같습니다.
여기서 DeepSeek 팀은 완전히 발상의 전환을 시도합니다.
“왜 Head 개수를 줄여가며 표현력을 깎아 먹어야 하는가?
Head는 128개처럼 아주 풍부하게 유지하면서,
K와 V의 알맹이 정보만 수학적으로 압축(Compression)해서 보관하면 안 될까?“
이 파격적인 아이디어에서 탄생한 것이 바로 MLA(Multi-Head Latent Attention)입니다.
5. DeepSeek의 혁명: Multi-Head Latent Attention (MLA)
MLA는 DeepSeek-V2 논문에서 처음 공개된 차세대 Attention 아키텍처입니다. 핵심 철학은 “공유(Sharing)에서 결합 압축(Joint Compression)으로의 패러다임 전환”입니다.
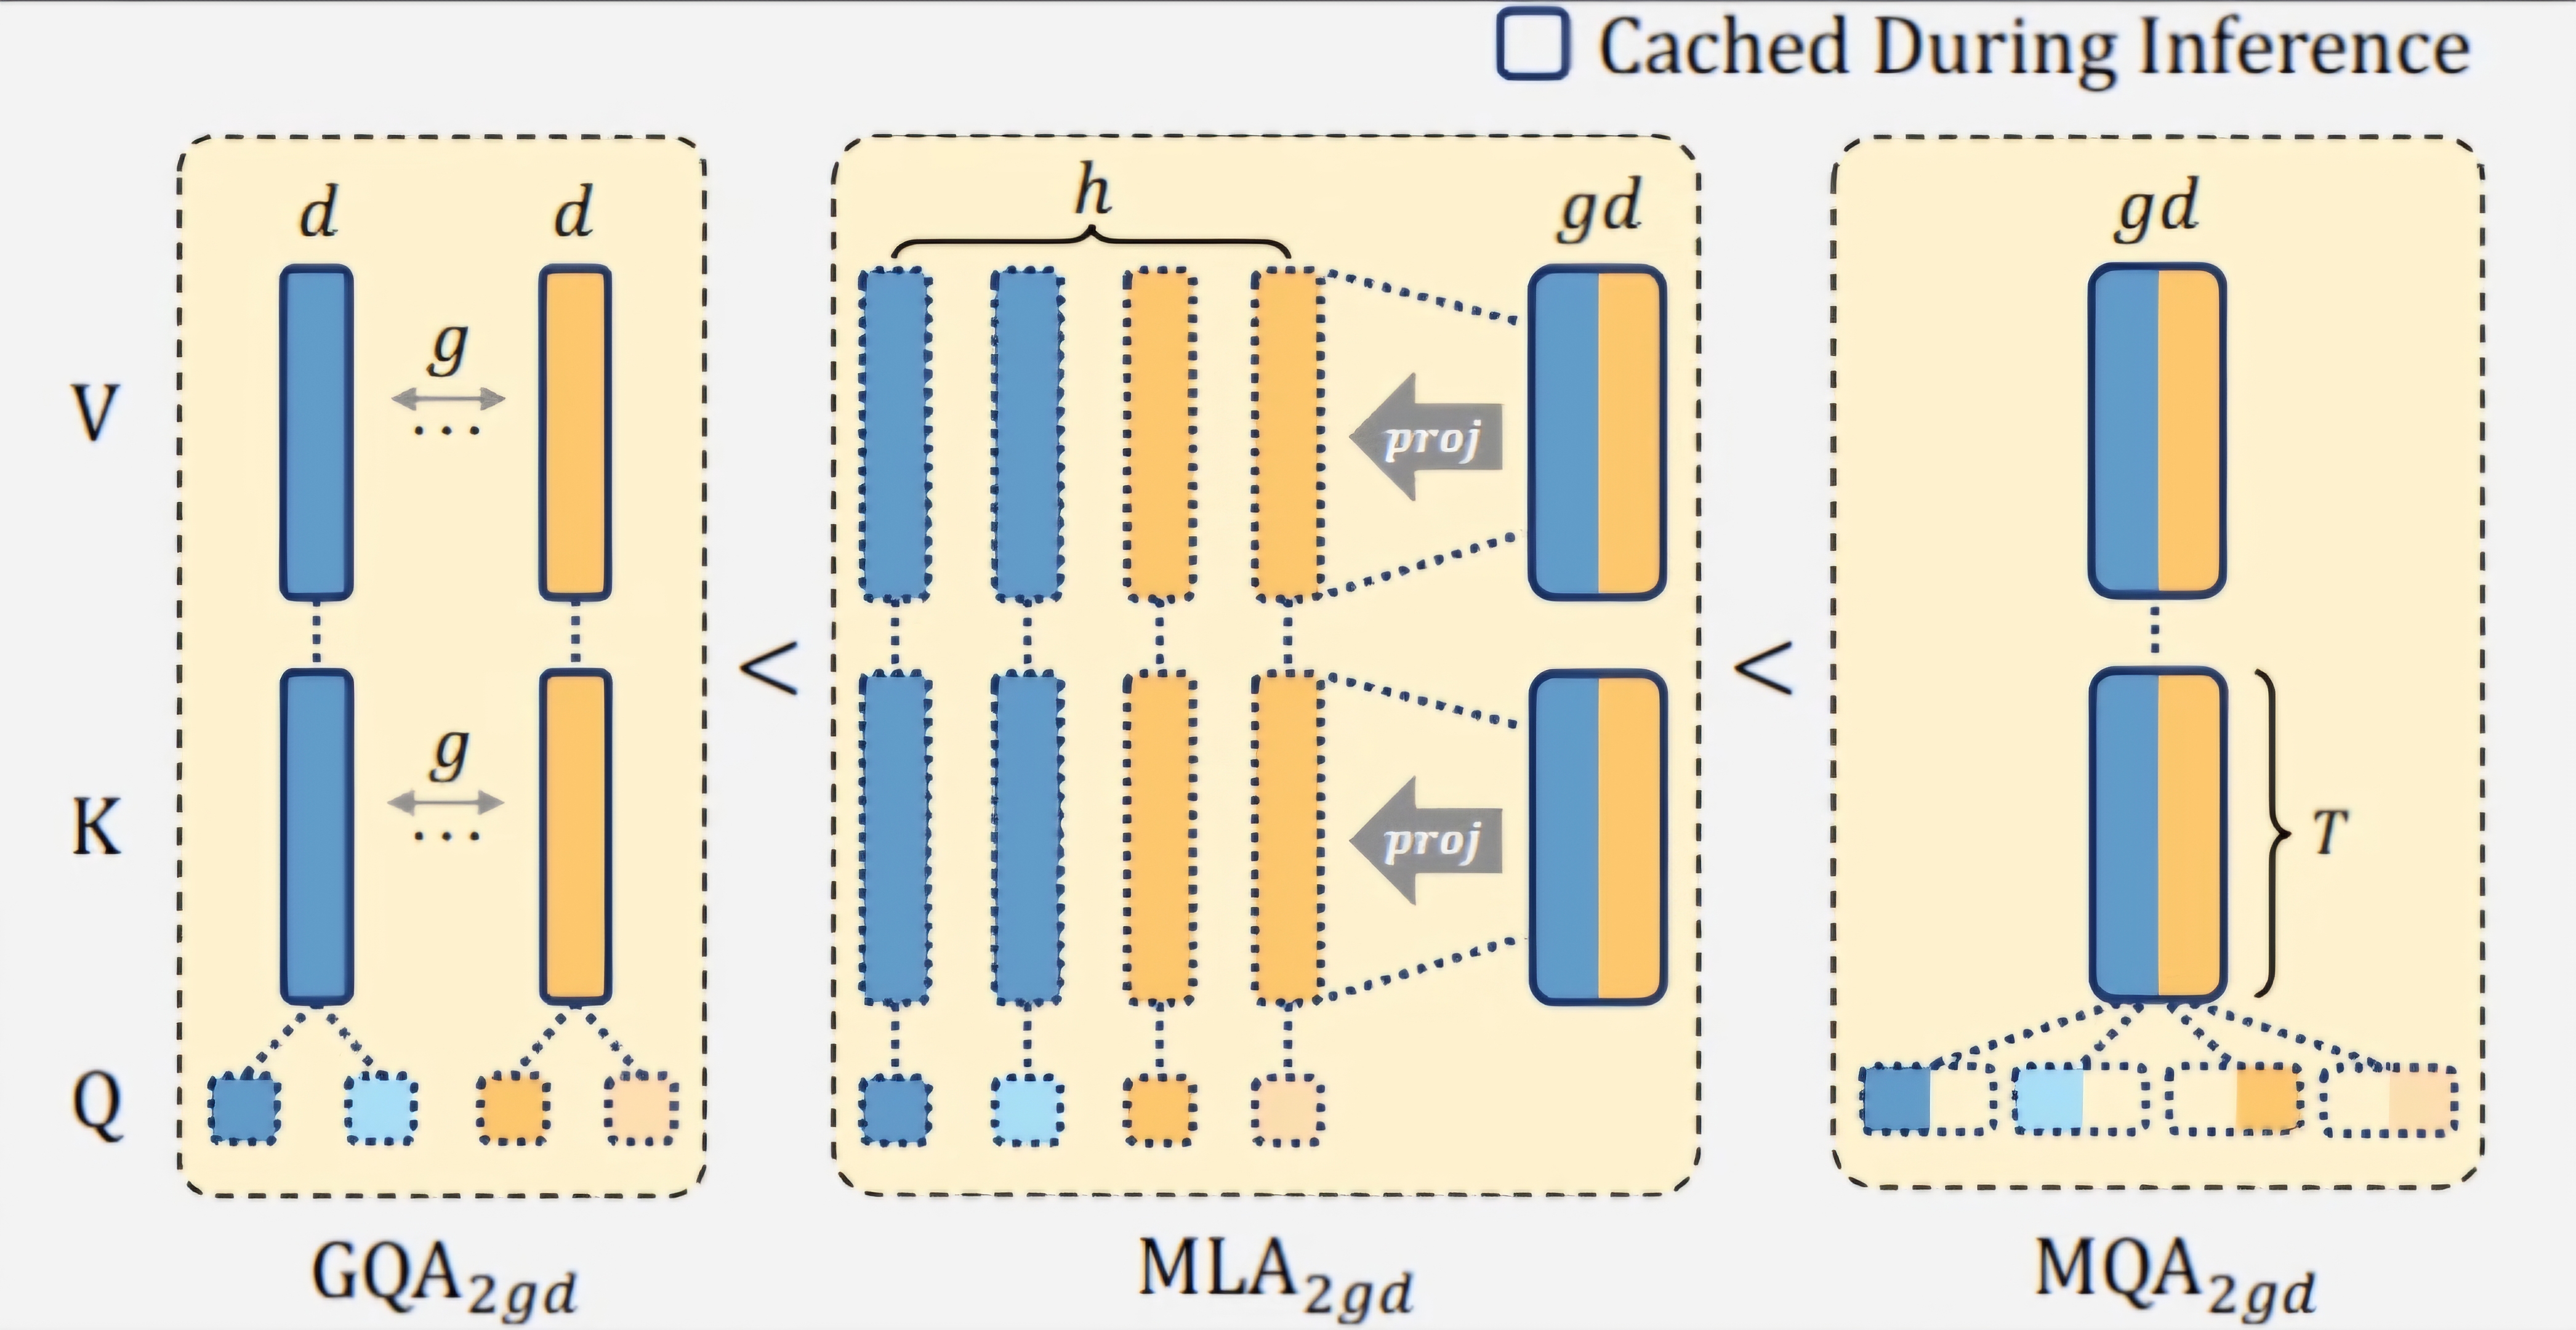
위 논문 원본 다이어그램을 보면 차이가 명확합니다. GQA와 MQA는 Head를 물리적으로 줄여서 캐시를 아끼지만, MLA는 Head의 폭(\(h\))을 넓게 유지한 채 저차원 잠재 공간(\(gd\))으로 프로젝션(proj)하여 캐시합니다.
5.1 Low-Rank Key-Value Joint Compression 수식
DeepSeek-V2는 무려 \(n_h = 128\)개라는 방대한 Attention Head를 사용합니다. 일반적인 MHA라면 VRAM 폭발로 절대 감당할 수 없는 스펙입니다.
이를 가능하게 만든 비결은 5,120차원의 입력 은닉 벡터 \(h_t\)를 먼저 단 512차원의 잠재 벡터 \(c_t^{KV}\)로 압축(Down-projection)하는 데 있습니다.
\[c_t^{KV} = W^{DKV} h_t\]
- \(W^{DKV} \in \mathbb{R}^{512 \times 5120}\) : 저차원 압축 가중치 행렬
- \(c_t^{KV} \in \mathbb{R}^{512}\) : 압축된 KV 결합 잠재 벡터(Latent Vector)
이 작은 512차원 벡터 하나 안에 Key와 Value를 복원할 수 있는 핵심 유전자가 모두 농축되어 있습니다.
필요할 때 상향 투영(Up-projection) 행렬을 곱하면 128개 Head 전체 분량의 Key(\(k_t^C\))와 Value(\(v_t^C\))를 언제든 뽑아낼 수 있습니다.
\[k_t^C = W^{UK} c_t^{KV}, \quad v_t^C = W^{UV} c_t^{KV}\]
여기서 \(W^{UK}, W^{UV} \in \mathbb{R}^{(128 \times 128) \times 512} = \mathbb{R}^{16384 \times 512}\)입니다.
5.2 98.24% 캐시 절감 (1.76%의 기적)
추론할 때 VRAM 캐시 테이블에 저장되는 것은 16,384차원의 거대한 Key/Value가 아닙니다. 오직 512차원의 압축 잠재 벡터 \(c_t^{KV}\)와 64차원의 위치 벡터 \(k_t^R\) 단 두 가지뿐입니다.
\[\text{MLA 토큰당 캐시 요소} = 512 + 64 = \mathbf{576 \text{ elements}}\]
동일한 128개 Head 사양의 MHA와 비교해 보면 그 차이가 실감 납니다: - 동일 사양 MHA 캐시: \(2 \times 128 \times 128 = \mathbf{32,768 \text{ elements}}\) - DeepSeek MLA 캐시: \(512 + 64 = \mathbf{576 \text{ elements}}\) - 압축 비율: \(\frac{576}{32768} \approx \mathbf{1.76\%}\) (원본 대비 무려 98.24% 절감!)
동일한 GPU에서 동시 처리할 수 있는 사용자 수(Batch Size)를 수십 배 늘릴 수 있고, 128K(13만 토큰)에 달하는 초장문도 단일 노드 안에서 부드럽게 구동할 수 있게 된 비결이 바로 여기에 있습니다.
6. 신의 한 수 1: 가중치 흡수(Weight Absorption)로 복원 연산 무력화
여기서 예리한 엔지니어라면 반드시 머릿속에 경고등이 켜져야 합니다.
“잠재 벡터를 512차원으로 작게 캐시한 것까지는 좋다.
그런데 실제로 Attention Score를 계산하려면 \(Q\)와 내적을 해야 하지 않는가?
그렇다면 매 토큰을 생성할 때마다 캐시해 둔 수천 개의 \(c_j^{KV}\) 벡터들을 상향 투영(\(W^{UK}\))을 통해 16,384차원의 Key로 일일이 복원(Decompress)해야 하는 것 아닌가?
그렇다면 메모리는 아꼈을지 몰라도 매 스텝마다 거대한 행렬곱 연산(FLOPs)이 폭발해서 생성 속도가 거북이처럼 느려지지 않겠는가?“
실제로 이 복원 연산 문제를 풀지 못했다면 MLA는 실전에서 써먹을 수 없는 ’이론상만의 기술’로 끝났을 것입니다.
DeepSeek 연구진은 이 딜레마를 선형대수학의 가장 기본적인 원리, 행렬곱의 결합 법칙을 이용한 가중치 흡수(Weight Absorption)로 완벽하게 해결했습니다.
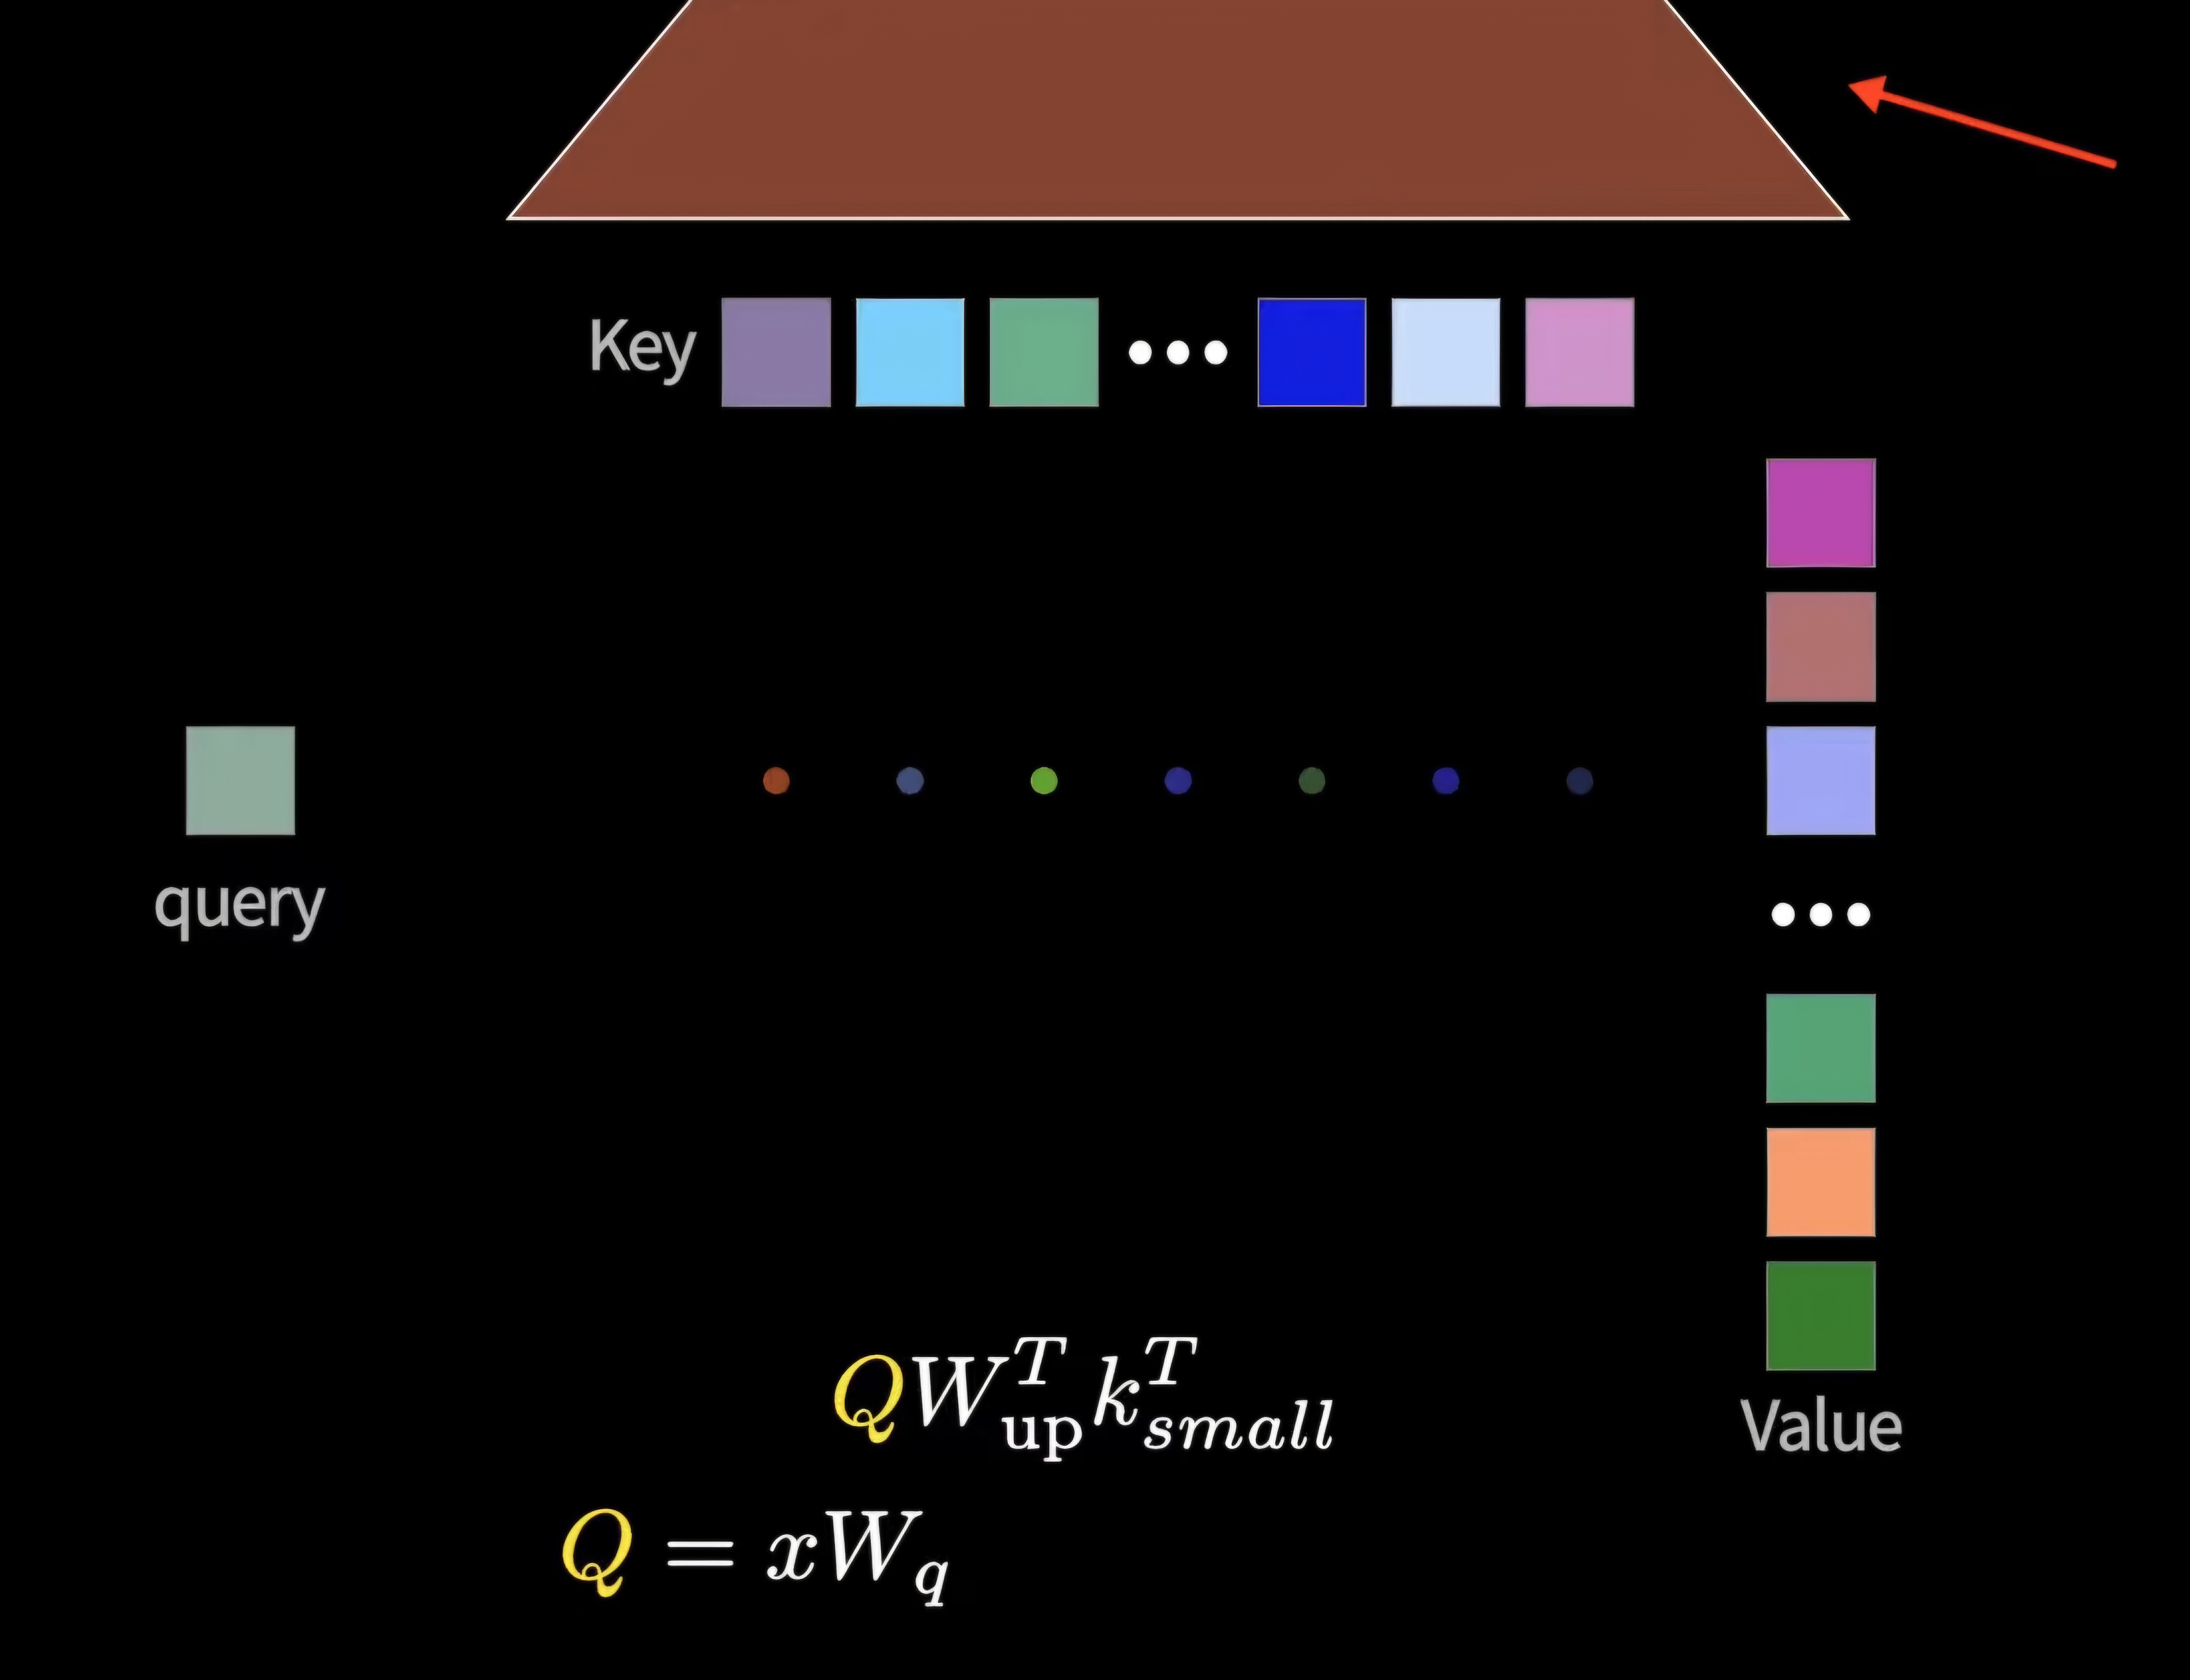
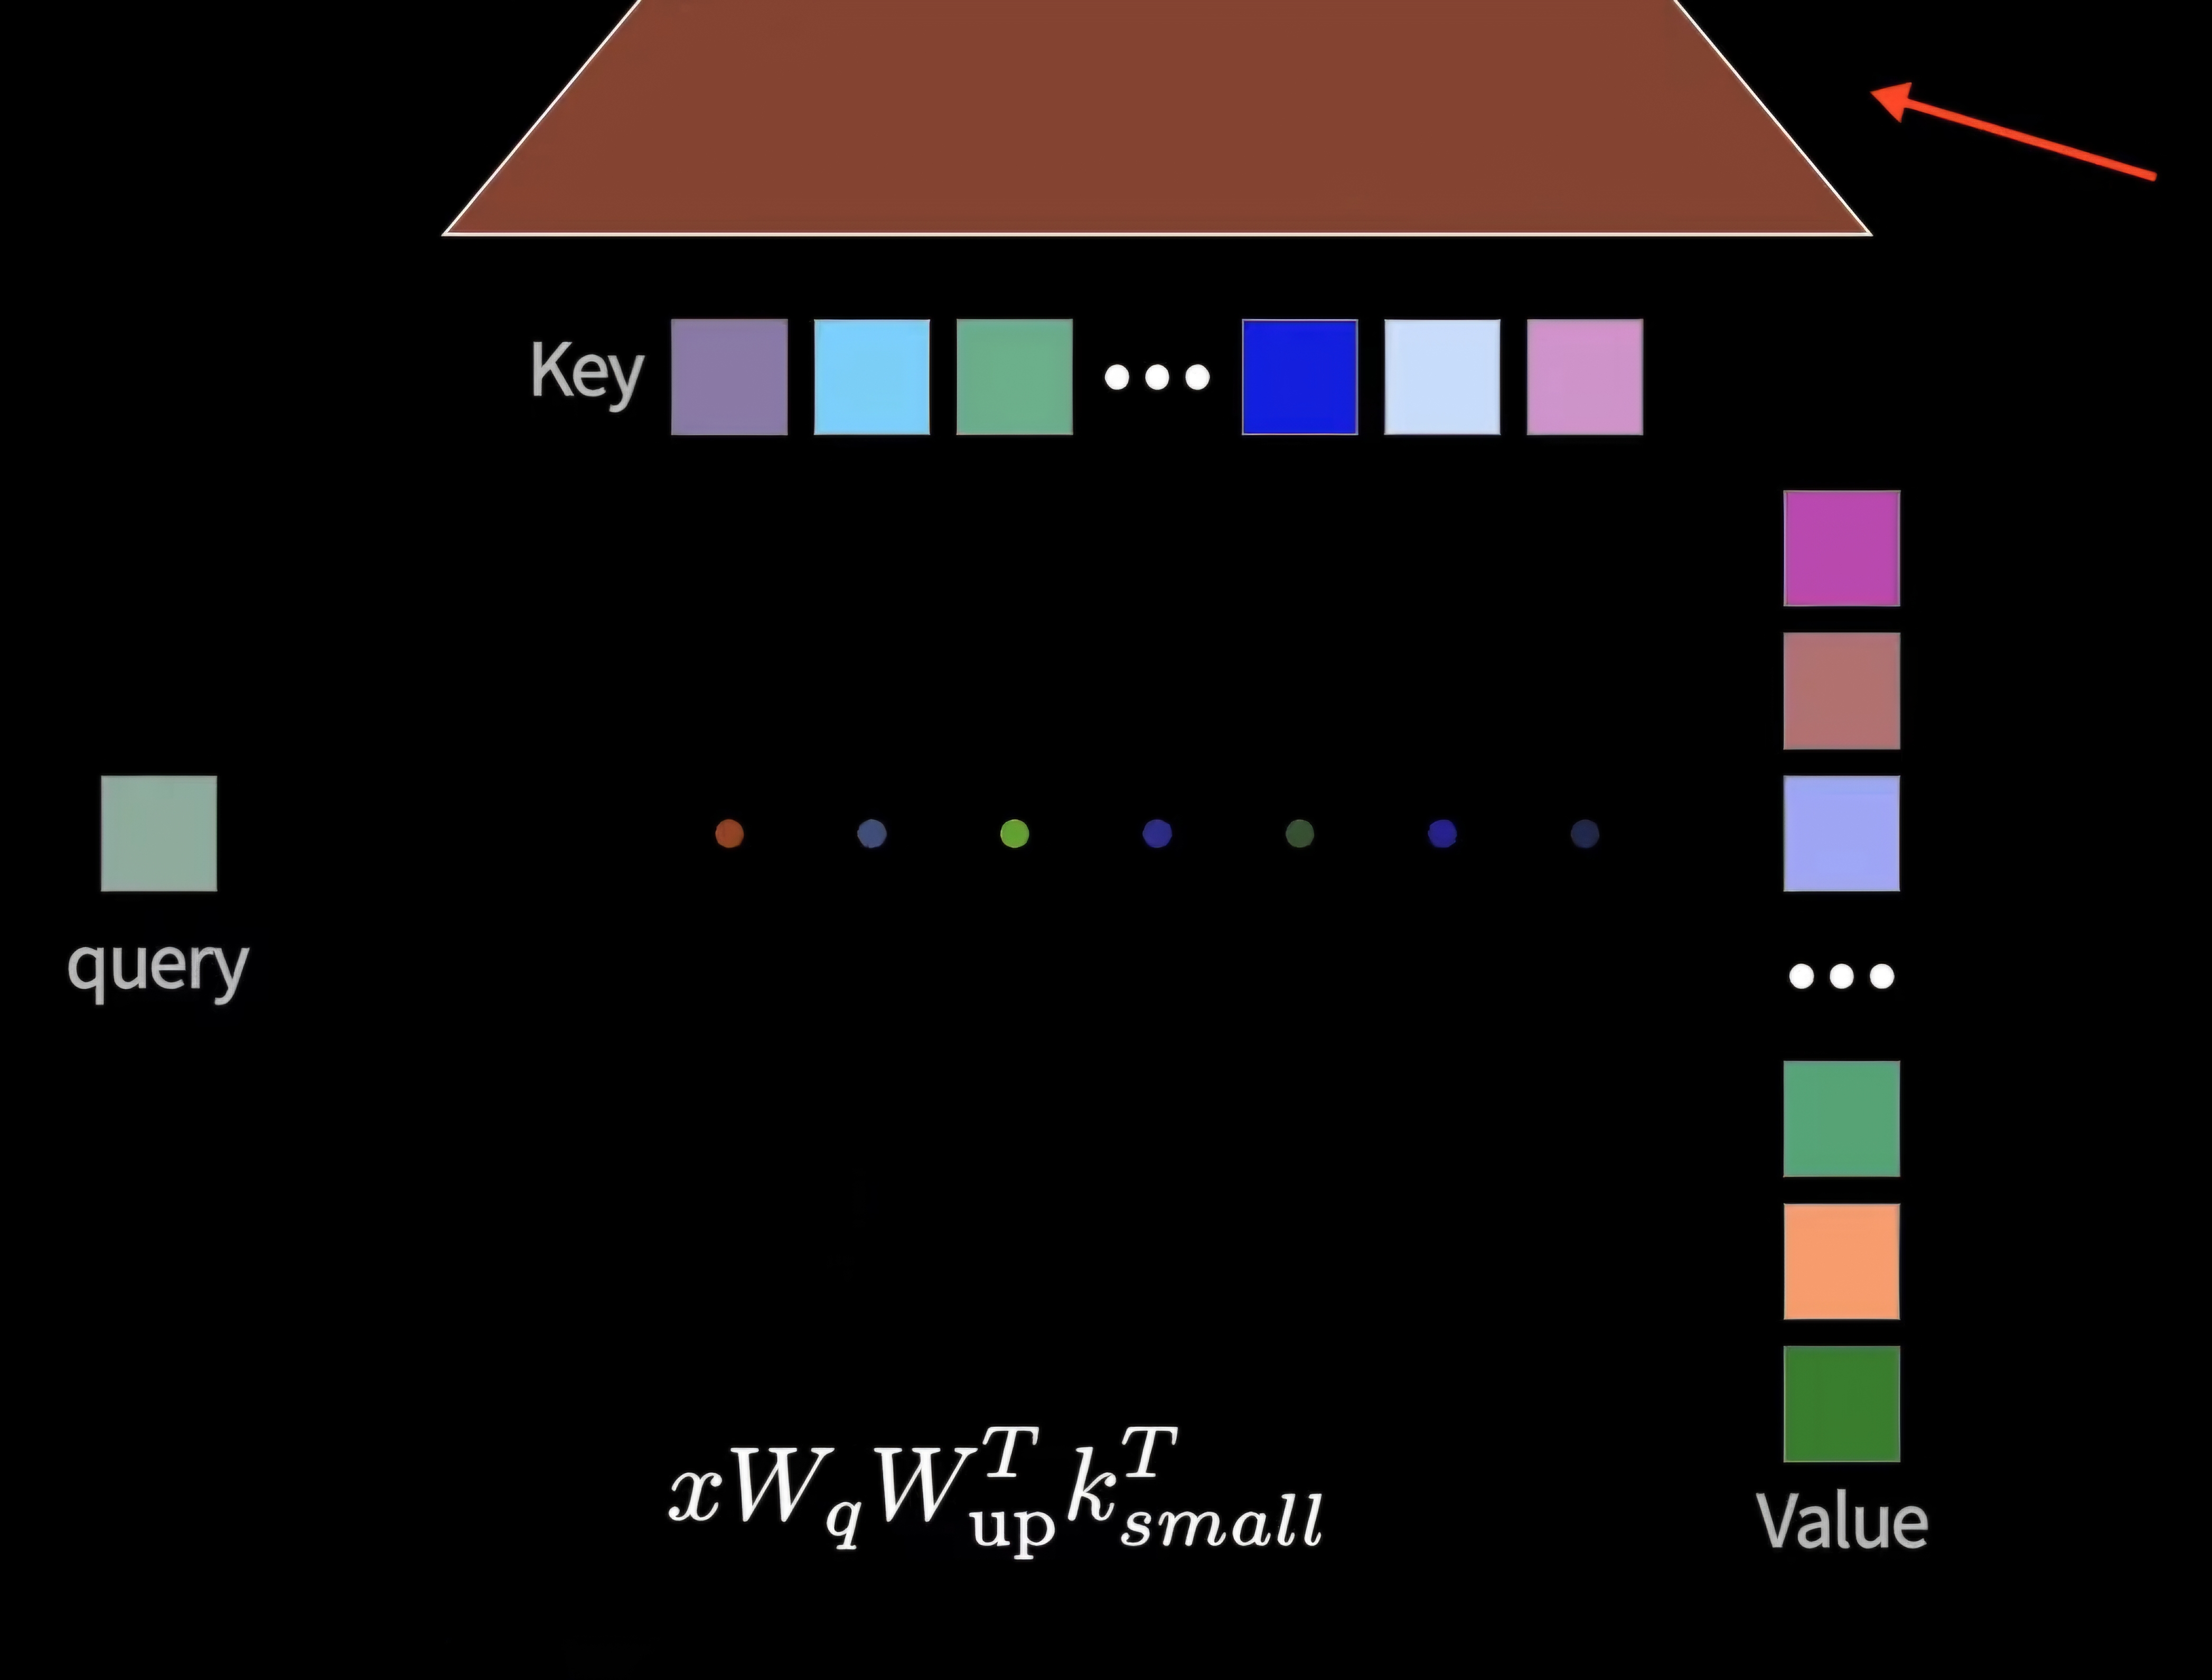
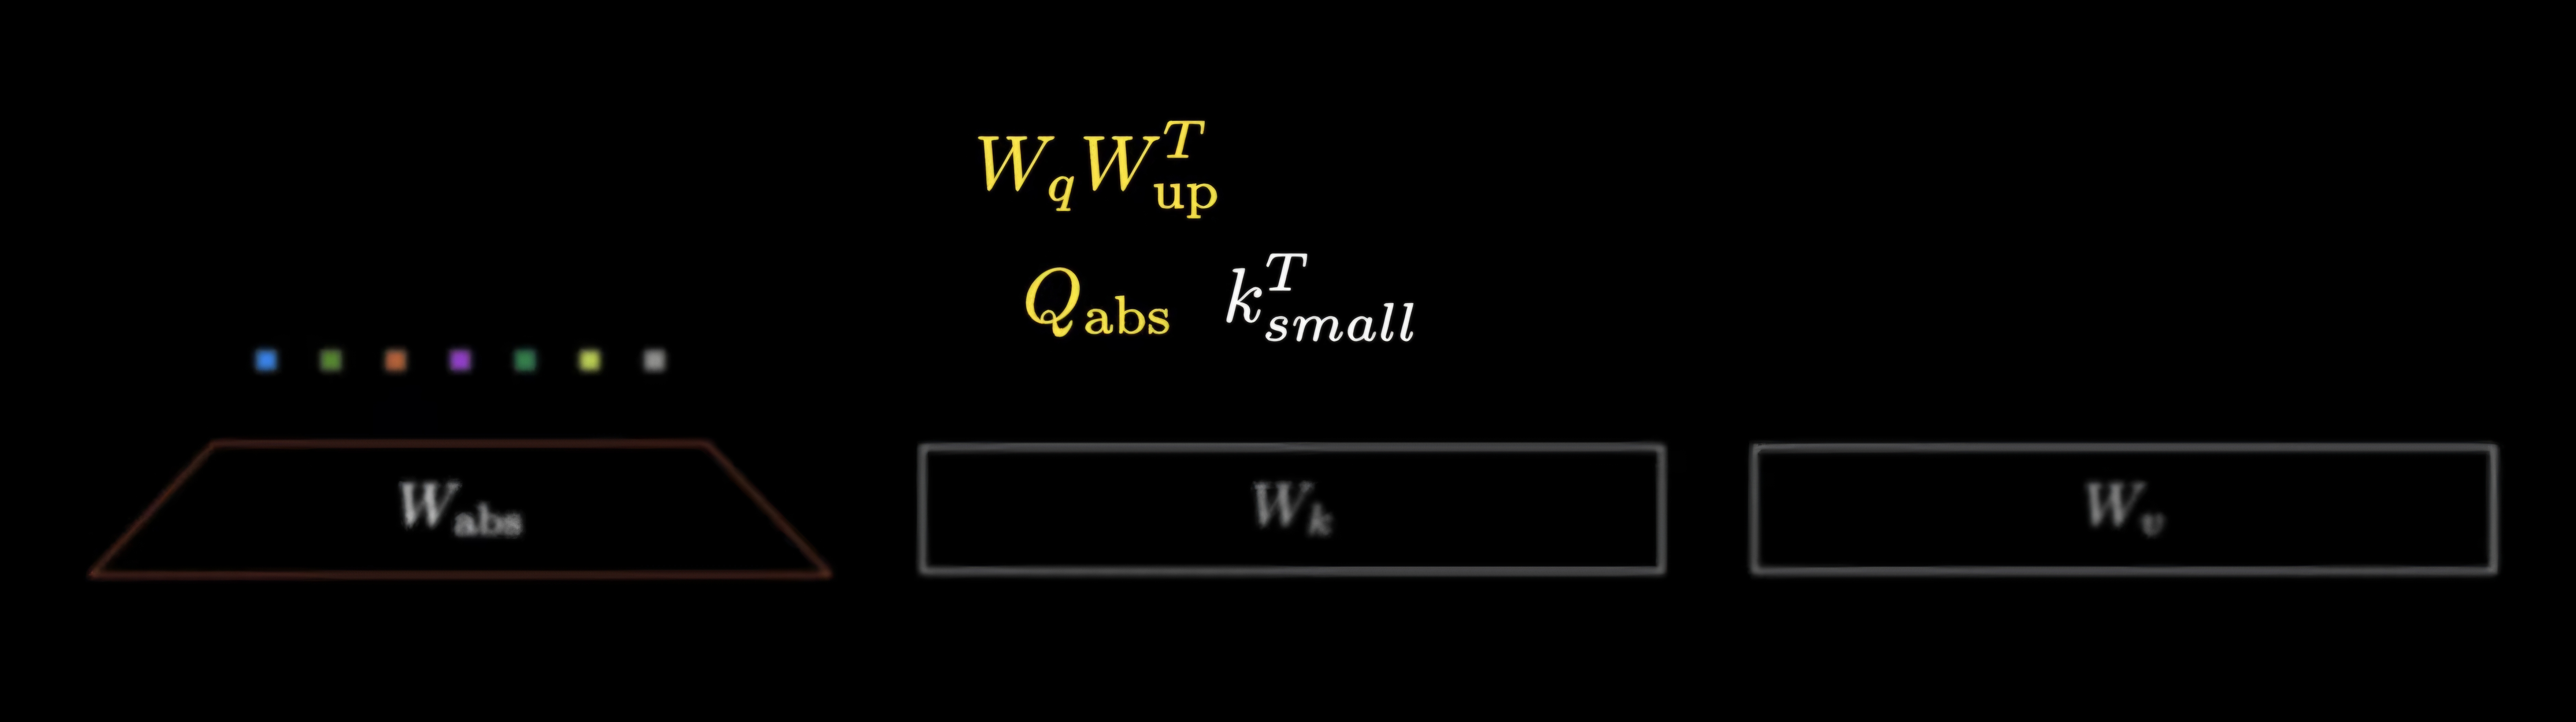
수식으로 보는 가중치 흡수의 마법
과거 시점 \(j\)에 캐시된 토큰의 Key 벡터와 현재 토큰 \(t\)의 Query 벡터의 내적 식을 전개해 보겠습니다.
\[\text{Score}_{t, j} = (q_t^C)^T k_j^C = (q_t^C)^T \left( W^{UK} c_j^{KV} \right)\]
괄호 안을 먼저 계산하면 과거의 모든 캐시 벡터 \(c_j^{KV}\)에 대해 무거운 \(W^{UK}\) 곱셈을 반복해야 합니다.
하지만 행렬의 곱셈은 결합 법칙 \((AB)C = A(BC)\)이 성립합니다! 괄호의 묶음을 바꾸어 보겠습니다.
\[\text{Score}_{t, j} = \left( (q_t^C)^T W^{UK} \right) c_j^{KV} = \left( (W^{UK})^T q_t^C \right)^T c_j^{KV}\]
이 작은 위치 변경이 시스템 전체를 바꿉니다.
\[\tilde{q}_t^C = (W^{UK})^T q_t^C\]
복원 행렬 \(W^{UK}\)를 과거의 수천 개 캐시 벡터들에 일일이 곱하는 대신, 현재 생성 중인 단 1개의 Query 벡터에 미리 곱해서 흡수(Absorbed)시켜 버리는 것입니다!
새롭게 변환된 Query \(\tilde{q}_t^C\)는 512차원이 됩니다. 이제 이 512차원 Query를 가지고 VRAM에 캐시되어 있던 512차원의 잠재 벡터 \(c_j^{KV}\)들과 복원 과정 없이 그 자리에서 바로 내적을 수행합니다.
Value 방향도 완전히 똑같습니다. 512차원 잠재 공간에서 가중합을 먼저 끝마친 뒤, 출력 행렬 \(W^O\)와 합쳐진 단 하나의 흡수 행렬 \(\tilde{W}^O = W^{UV} W^O\)를 맨 마지막에 딱 한 번만 곱해줍니다.
결과적으로 추론 과정 전체를 통틀어 16,384차원의 거대한 Key와 Value 텐서는 메모리에 단 0.001초도 실체로서 존재하지 않습니다! 메모리 용량도 줄이고, 복원 연산 오버헤드도 0으로 지워버린 천재적인 설계입니다.
7. 신의 한 수 2: RoPE와의 치명적 충돌과 Decoupled RoPE
하지만 이 완벽한 수학적 아름다움 앞에 거대한 암초가 나타납니다. 바로 현대 LLM의 표준 상대 위치 인코딩 기법인 RoPE (Rotary Position Embedding)와의 충돌입니다.
7.1 RoPE가 끼어들면 왜 가중치 흡수가 박살 날까?
RoPE는 토큰의 위치 인덱스 \(j\)에 따라 벡터를 특정 각도만큼 회전시키는 직교 행렬 \(R_j\)를 곱합니다.
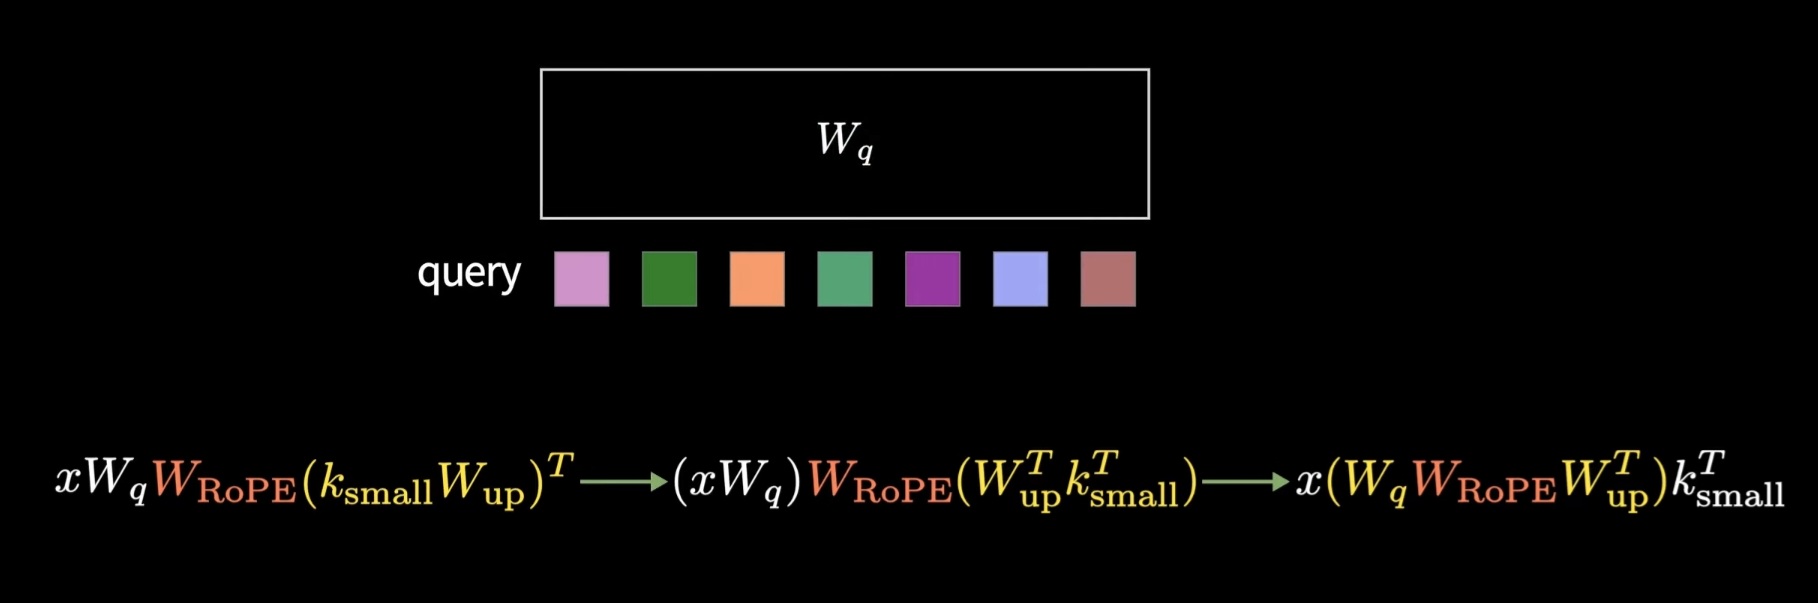
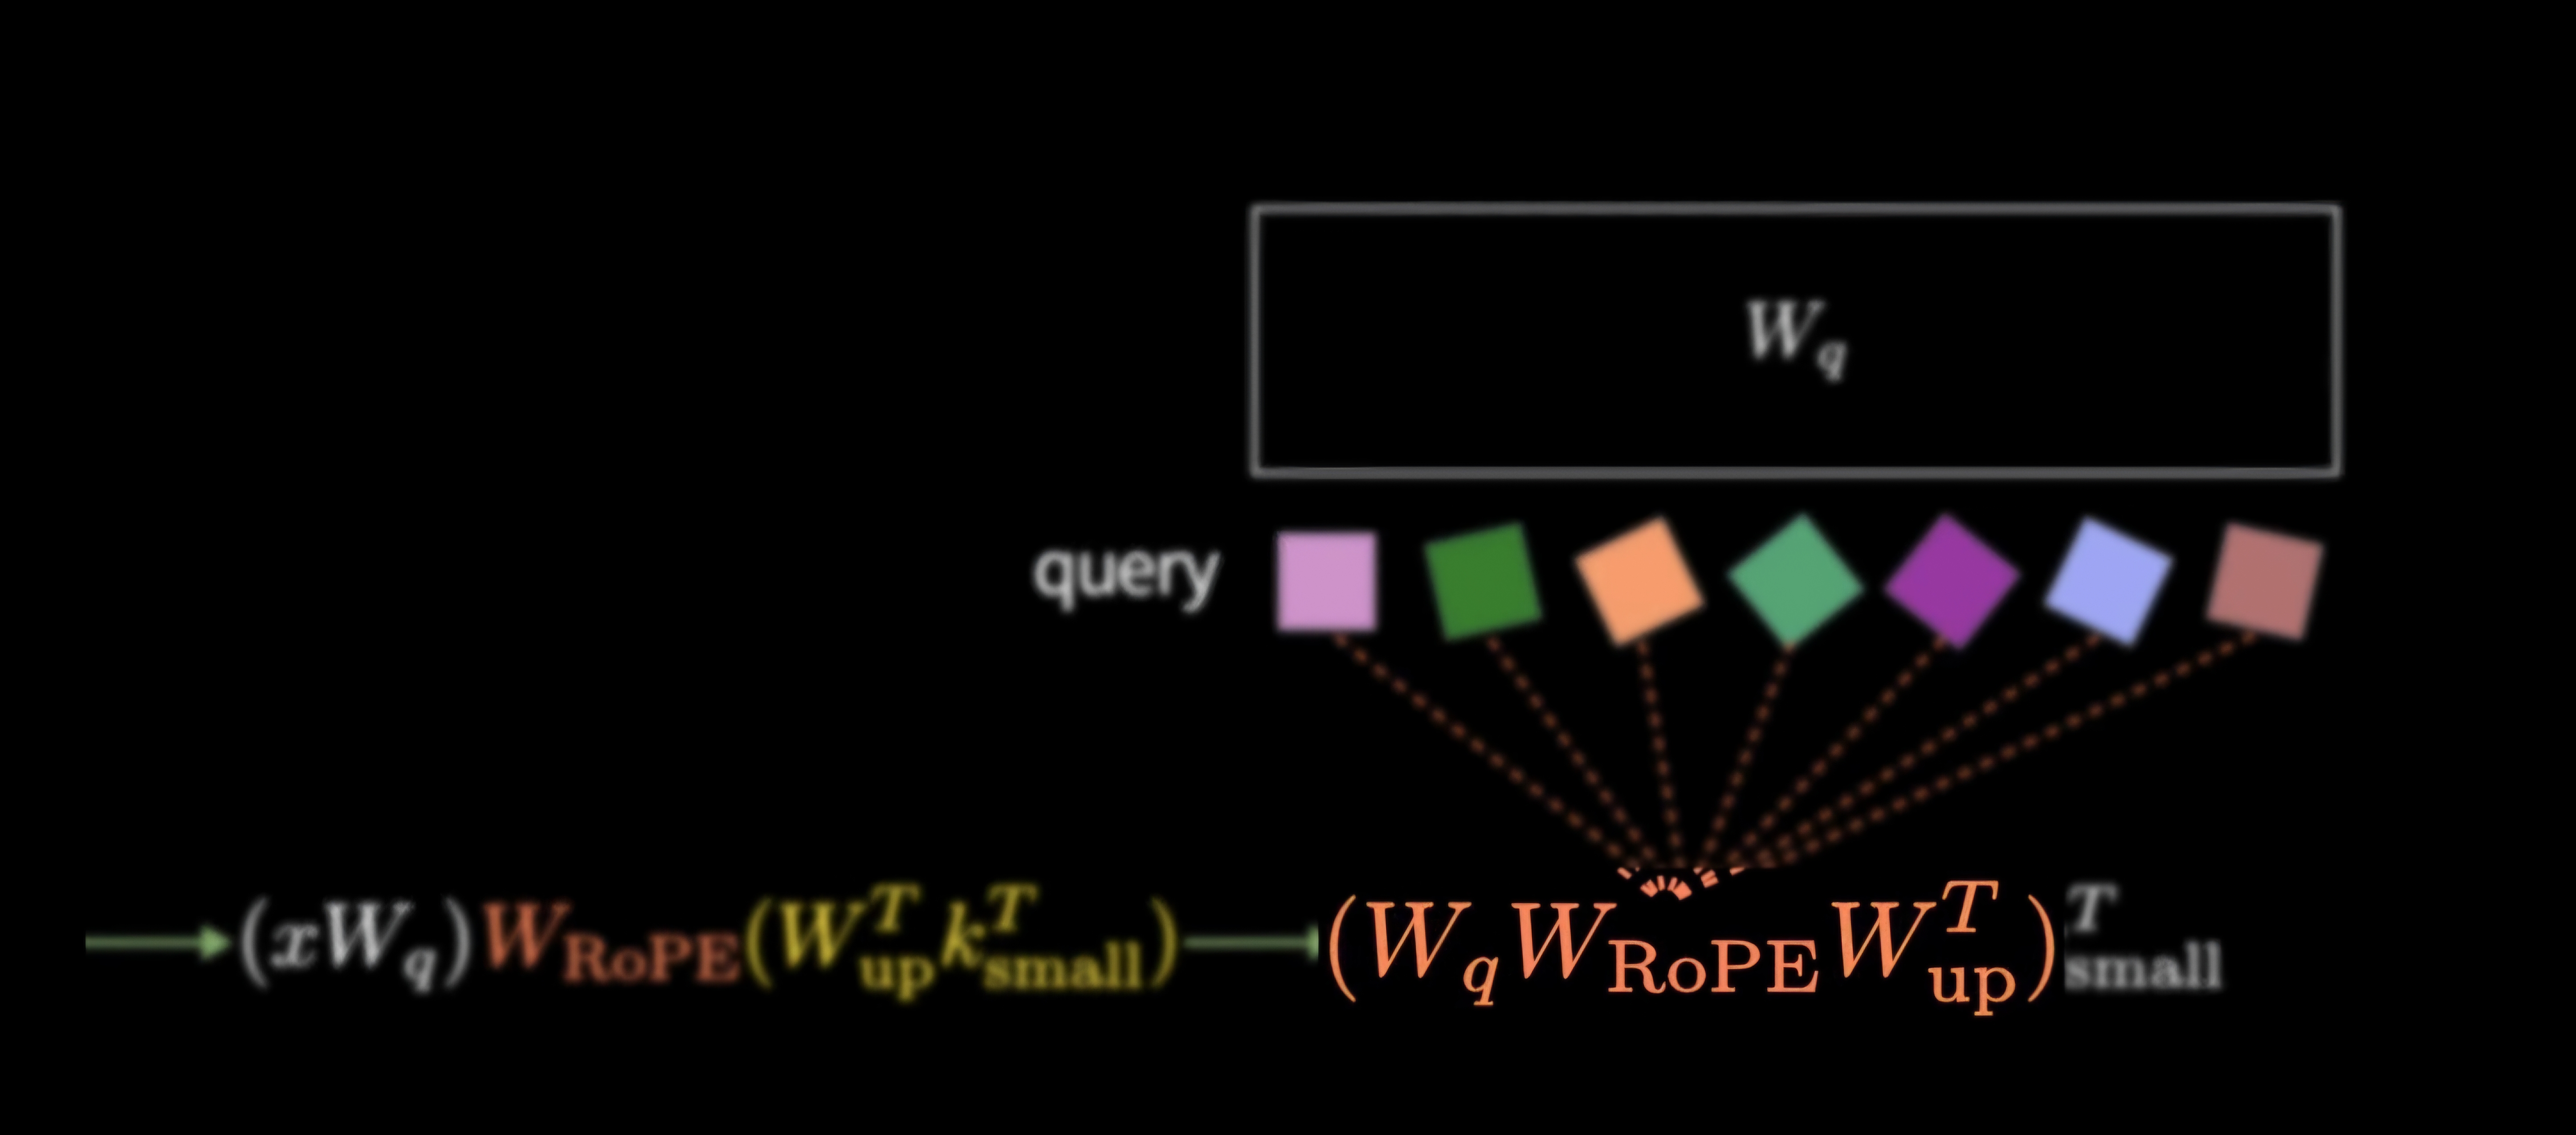
Key 벡터에 RoPE가 적용되면 수식이 다음과 같이 바뀝니다.
\[k_j = R_j (W^{UK} c_j^{KV})\]
Query와의 내적 점수를 계산하면:
\[\text{Score} = q_t^T \cdot \left[ R_j W^{UK} c_j^{KV} \right]\]
여기서 가중치 흡수를 적용하려면 가운데 끼어 있는 \(W^{UK}\)를 \(R_j\) 바깥으로 빼내야 합니다. 하지만 두 가지 치명적인 문제가 가로막습니다: 1. 행렬곱은 교환 법칙이 성립하지 않습니다 (\(R_j W^{UK} \neq W^{UK} R_j\)). 2. 결정적으로 회전 행렬 \(R_j\)는 상수가 아니라 토큰의 위치 \(j\)마다 숫자가 계속 달라지는 동적 행렬입니다! 1번 토큰, 2번 토큰, 100번 토큰마다 행렬값이 제각각입니다.
토큰마다 값이 바뀌므로 단 하나의 고정된 행렬로 Query 쪽에 사전 흡수시키는 것이 수학적으로 원천 불가능해집니다. RoPE를 순진하게 적용하는 순간, 기껏 만든 Weight Absorption이 산산조각 나면서 매 스텝마다 고차원 복원 지옥으로 되돌아가야 하는 위기에 봉착한 것입니다.
7.2 Decoupled RoPE: 내용과 위치의 완전한 분리
DeepSeek 연구진의 해결책은 단호하고 명쾌했습니다.
“의미 내용(Content)과 위치(Position)를 굳이 하나의 벡터 안에 억지로 뒤섞어둘 필요가 있는가?
아예 두 경로를 물리적으로 완전히 쪼개버리자(Decouple)!“
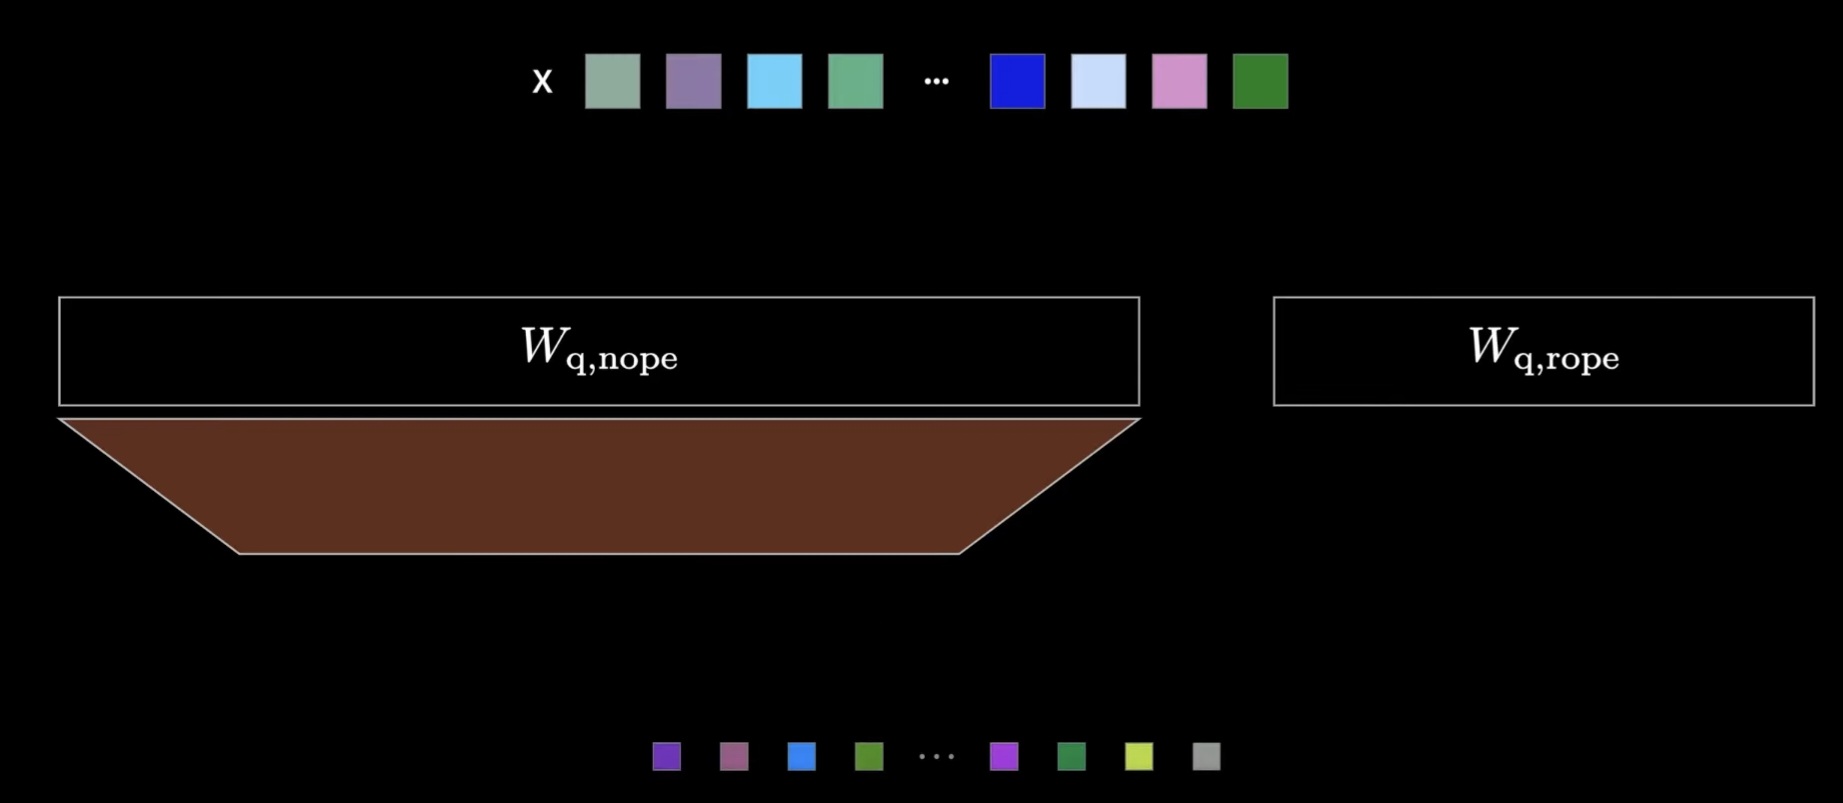
위 다이어그램처럼 은닉 상태에서 두 갈래의 독립된 고속도로를 엽니다:
- Content Path (의미 전담 경로, NoPE):
- RoPE 회전을 일절 적용하지 않습니다.
- 순수한 의미 정보만 512차원 잠재 공간에 압축합니다.
- 위치 행렬이 끼어들지 않으므로 Weight Absorption이 100% 온전하게 작동합니다!
- Position Path (위치 전담 경로, RoPE):
- 오직 “토큰 간의 거리가 얼마나 떨어져 있는가”만을 측정하기 위한 64차원의 아주 작은 전용 벡터(\(k_t^R\))를 따로 뽑아 여기에만 RoPE 회전을 적용합니다.
- 128개의 모든 Head가 이 작은 64차원 Position Key를 공동으로 공유(Share)하여 캐시 낭비를 극소화합니다.
최종 Attention Score = Content Score (가중치 흡수 적용) + Position Score (RoPE 상대 위치)선형대수학적으로 두 벡터를 Concat하여 내적한 결과는 각 부분 공간 내적의 합과 정확히 일치합니다.
이로써 DeepSeek은 RoPE의 탁월한 장거리 위치 파악 능력과 Weight Absorption의 초고속 무복원 연산이라는 두 마리 토끼를 완벽한 수학적 무결성으로 동시에 잡아냈습니다.
8. Attention 아키텍처 한눈에 보는 종합 비교
지금까지 살펴본 4대 Attention 아키텍처의 핵심 차이점을 정량적으로 정리해 보았습니다.
| 비교 항목 | MHA (기본) | GQA (절충) | MQA (단일) | MLA (DeepSeek) |
|---|---|---|---|---|
| 핵심 설계 전략 | 다중 표현 공간 극대화 | 그룹 단위 Head 공유 | 전체 단일 Head 공유 | 저차원 잠재 결합 압축 + 분리 |
| Query Head 수 | \(H\) | \(H\) | \(H\) | \(H\) (128개 거대 Head 유지) |
| Key/Value Head 수 | \(H\) (전부 독립) | \(G\) (그룹 공유) | 1 (전체 공유) | 압축 잠재 표현에서 동적 복원 |
| 토큰·레이어당 Cache 크기 | \(2 n_h d_h\) (\(32,768\)) | \(2 n_g d_h\) (\(2,048 \sim 4,096\)) | \(2 d_h\) (\(256\)) | \(d_c + d_h^R\) (\(512 + 64 = \mathbf{576}\)) |
| 상대적 Cache 점유율 | \(100\%\) (기준) | 약 \(6.25\% \sim 12.5\%\) | \(0.78\%\) | \(1.76\%\) (초저용량) |
| 추론 계산 복원 트릭 | 없음 | 없음 | 없음 | Weight Absorption (복원 연산 0) |
| 위치 인코딩 방식 | 일반 RoPE | 일반 RoPE | 일반 RoPE | Decoupled RoPE (경로 분리) |
| 모델 표현력 및 품질 | 최상 (기준) | 우수 | 다소 저하 | 최상 (MHA급 대등/능가) |
| 대표 채택 모델 | 초기 GPT-3, Transformer | LLaMA-2/3, Mistral | Falcon 초기형 | DeepSeek-V2, DeepSeek-V3, R1 |
순수 캐시 수치만 보면 MQA(256)가 MLA(576)보다 더 작아 보일 수 있습니다. 하지만 MQA는 모든 Head가 하나의 시선에 갇혀 지능이 떨어지는 치명적인 대가를 치렀습니다.
반면 MLA는 128개의 거대한 Multi-Head 표현 공간을 단 0.1%도 손상하지 않으면서 달성한 기적적인 압축률입니다. 실제로 DeepSeek-V2 논문의 학술 벤치마크(MMLU, GSM8K, MATH 등)에서 MLA는 동일 연산량의 MHA 모델을 모든 영역에서 대등하거나 능가하는 성능을 입증했습니다.
9. 마치며: 수학과 시스템 엔지니어링이 빚어낸 예술
트랜스포머의 발전사를 되돌아보면 정말 가슴이 뜁니다. 1. 표현력의 시대: 문맥을 다각도로 포착하기 위해 Head를 무한정 늘렸던 Multi-Head Attention. 2. 타협의 시대: GPU VRAM이 터져나가자 Head를 묶고 공유하며 표현력을 깎았던 MQA와 GQA. 3. 압축과 대수적 재배치의 시대: Head의 풍부함을 온전히 지키면서, 선형대수학의 결합 법칙으로 메모리와 연산량을 동시에 정복한 DeepSeek의 MLA.
DeepSeek의 성공은 단순히 “비싼 엔비디아 GPU를 몇만 장 쏟아부었는가”의 승리가 아닙니다. 선형대수학의 아름다운 대수적 성질을 하드웨어(SRAM, HBM 대역폭)의 물리적 한계와 가장 우아하게 맞물리게 설계한 공학적 승리였습니다.
머릿속에 안개처럼 흩어져 있던 Q·K·V 차원들과 Weight Absorption의 행렬 변환 수식들이 퍼즐 맞추듯 명쾌하게 연결되는 과정은 엔지니어로서 지적인 전율을 느끼게 해 준 탐구였습니다.
본문 내용 중 수식 전개나 특정 차원 변환 과정에서 궁금한 점이 있으시다면 언제든 편하게 댓글로 남겨주세요. 제가 확인하는 대로 꼼꼼히 함께 고민하고 답변드리겠습니다!
※ 본 포스트는 임커밋 님의 유튜브 영상(Attention부터 MLA까지)을 시청하고 학습 및 복습하는 과정에서 개인적인 이해와 통찰을 덧붙여 정리한 기술 노트입니다.