오늘날 생성형 AI와 대규모 언어 모델(LLM), 비전 트랜스포머 같은 첨단 딥러닝 기술이 세상을 뒤흔들고 있지만, 그 거대한 아키텍처의 심장부를 열어보면 수십 년 전 정립된 인공신경망(Artificial Neural Networks, ANN)의 수학적 기본 원리가 그대로 숨 쉬고 있습니다.
하지만 많은 입문자들이 파이토치(PyTorch)나 텐서플로우(TensorFlow) 같은 고수준 라이브러리의 자동 미분(Autograd) 기능에만 의존하다 보니, 신경망 내부에서 오차가 어떻게 역방향으로 흐르는지, 왜 가중치 감쇠(Weight Decay)가 모델의 과적합을 막아주는지, 활성화 함수가 왜 비선형이어야만 하는지를 제대로 이해하지 못한 채 모델을 블랙박스(Black-box)로 다루곤 합니다.
신경망의 원리를 가장 직관적이고 투명하게 학습할 수 있는 환경 중 하나가 바로 R 통계 생태계입니다. R의 nnet 패키지는 단일 은닉층과 가중치 감쇠를 통한 초고속 실무 튜닝을 제공하며, neuralnet 패키지는 네트워크의 각 뉴런 간 연결 강도(가중치)와 편향을 다이어그램으로 완벽하게 시각화해 줍니다.
이번 글에서는 생물학적 뉴런의 모방에서 시작된 단층 퍼셉트론의 XOR 한계부터, 다층 퍼셉트론(MLP)의 공간 변환 원리, 연쇄 법칙(Chain Rule)에 기반한 오차 역전파(Backpropagation)의 수학적 단계별 유도, 그리고 R 환경에서의 완벽한 실무 모델링 파이프라인을 다루어 보겠습니다.
1. 퍼셉트론에서 다층 퍼셉트론(MLP)으로의 도약
인공신경망의 역사는 1957년 프랭크 로젠블랫(Frank Rosenblatt)이 제안한 퍼셉트론(Perceptron)에서 출발합니다. 퍼셉트론은 여러 입력 신호를 받아 각각의 가중치를 곱한 뒤 합산하고, 그 값이 임계치(Threshold)를 넘으면 1, 그렇지 않으면 0을 출력하는 가장 단순한 선형 분류기입니다.
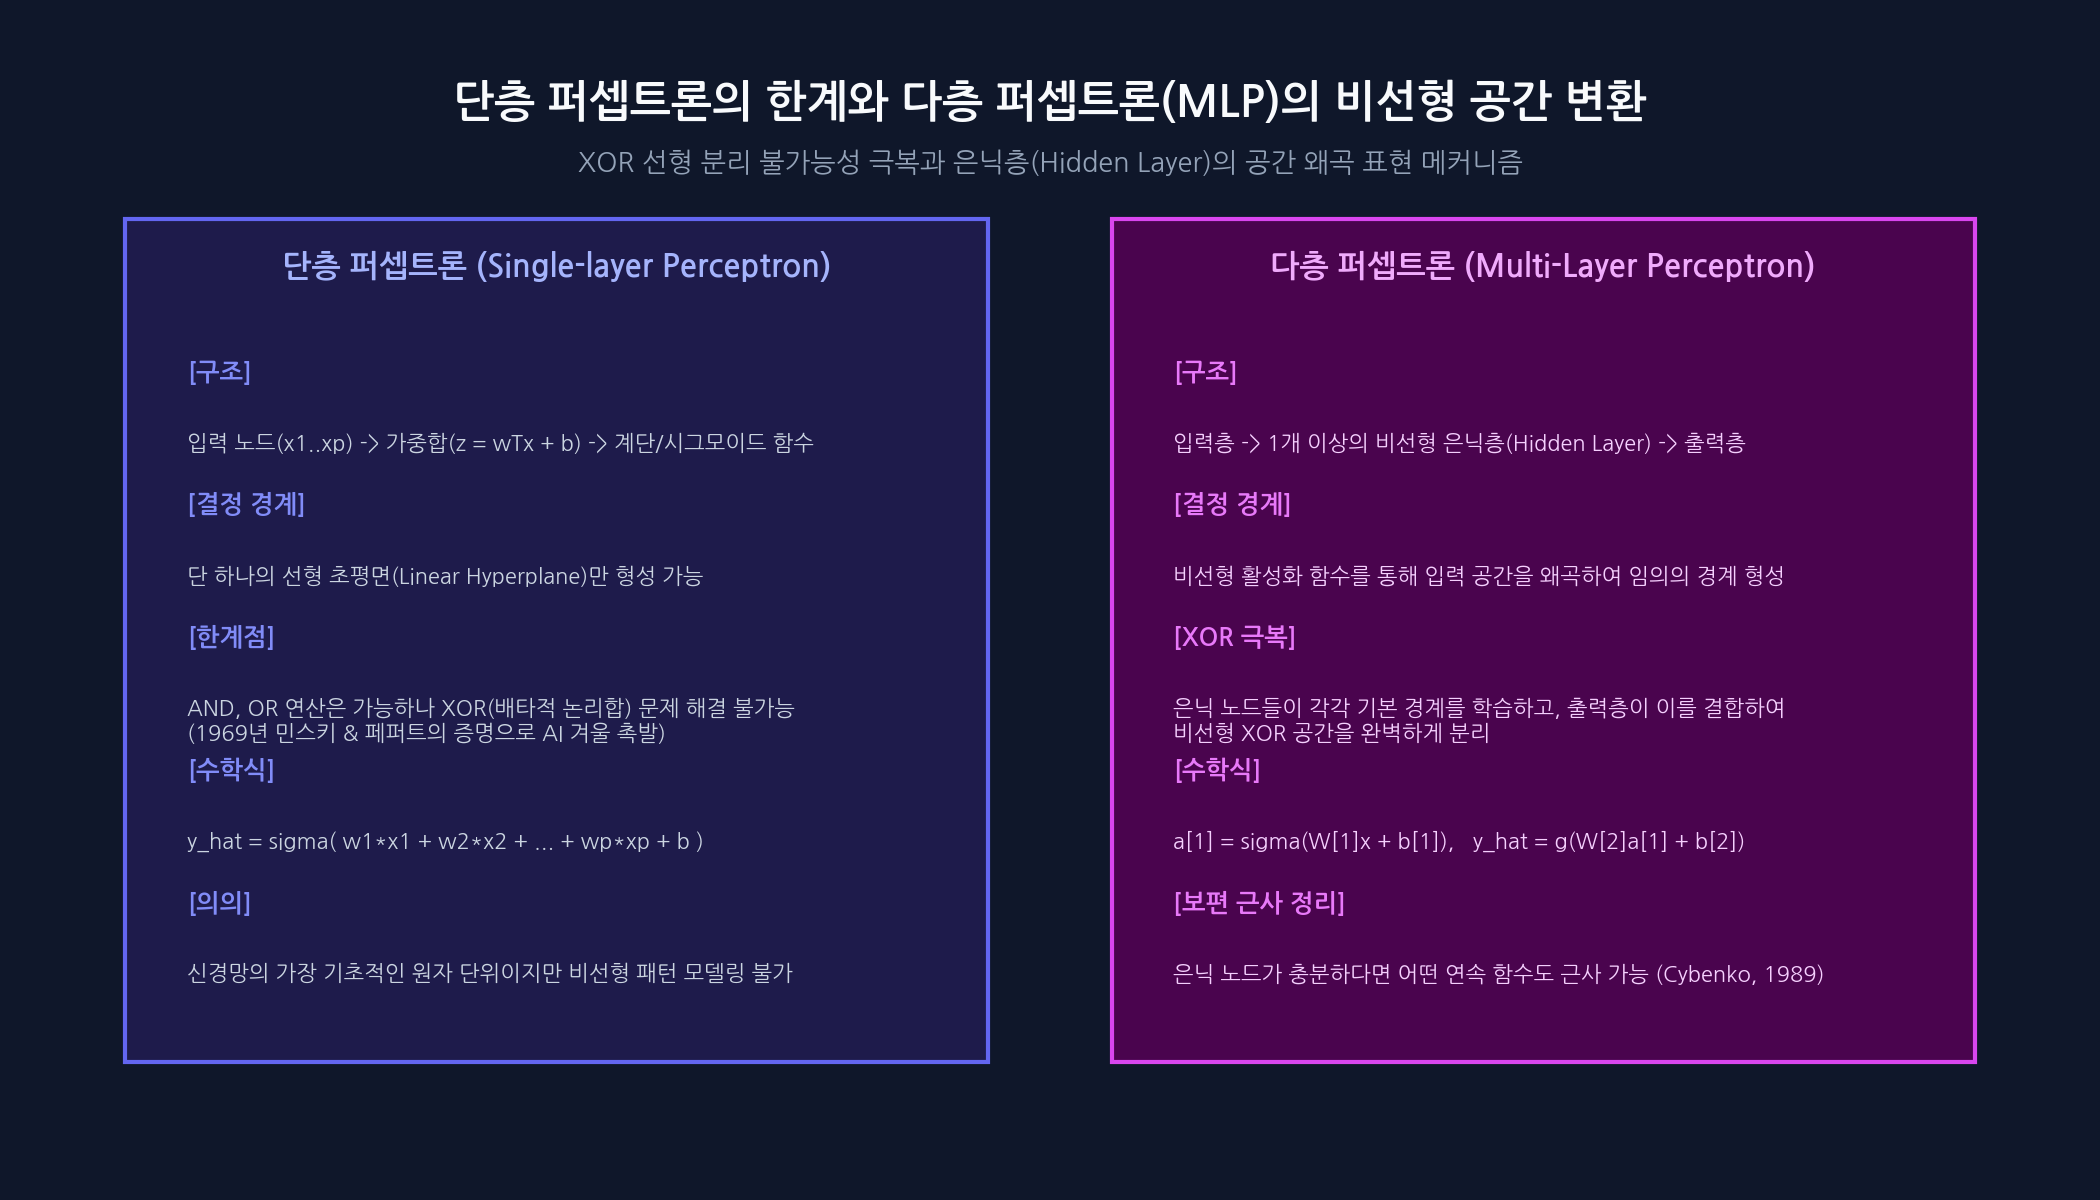
1.1 단층 퍼셉트론과 1969년 AI의 첫 번째 겨울
단층 퍼셉트론은 논리 연산의 AND와 OR 문제를 손쉽게 풀어내며 인공지능의 장밋빛 미래를 여는 듯했습니다. 그러나 1969년, MIT의 마빈 민스키(Marvin Minsky)와 시모어 페퍼트(Seymour Papert)는 그들의 저서 《Perceptrons》에서 치명적인 수학적 한계를 증명했습니다:
“단층 퍼셉트론은 선형 결정 경계(Linear Hyperplane)만 그릴 수 있으므로, XOR(배타적 논리합) 문제를 결코 해결할 수 없다.”
XOR 문제는 입력이 서로 다를 때만 1을 출력하고 같을 때는 0을 출력하는 연산입니다. 2차원 평면에 (0,0)=0, (1,1)=0, (0,1)=1, (1,0)=1을 찍어보면, 단 하나의 직선으로는 두 클래스를 결코 분리할 수 없습니다. 이 증명으로 인해 인공지능 연구 투자가 전면 중단되는 이른바 ‘첫 번째 AI 겨울(AI Winter)’이 찾아왔습니다.
1.2 다층 퍼셉트론(MLP)과 비선형 공간 왜곡
이 암흑기를 깨뜨린 열쇠가 바로 은닉층(Hidden Layer)을 도입한 다층 퍼셉트론(Multi-Layer Perceptron, MLP)입니다.
MLP의 작동 원리는 기하학적으로 매우 아름답습니다: 1. 입력 공간의 데이터가 은닉층으로 들어가면서 각 은닉 뉴런의 선형 결합(\(z = Wx + b\))과 비선형 활성화 함수(\(a = \sigma(z)\))를 통과합니다. 2. 이 비선형 변환 과정에서 원래 꼬여 있던 2차원 XOR 입력 공간이 3차원 이상의 잠재 공간(Latent Space)으로 사상되면서 구부러지고 왜곡됩니다. 3. 왜곡된 잠재 공간에서는 서로 다른 클래스들이 선형으로 분리 가능한(Linearly Separable) 상태로 재배치됩니다. 4. 마지막 출력층 뉴런은 이 왜곡된 공간 위에 단 하나의 선형 분리 초평면을 긋기만 하면 됩니다.
[보편 근사 정리 (Universal Approximation Theorem)]
조지 시벤코(George Cybenko, 1989)와 쿠르트 호닉(Kurt Hornik, 1991)은 유한한 개수의 뉴런을 가진 단 하나의 은닉층만으로도 임의의 연속 함수를 원하는 정밀도로 완벽하게 근사할 수 있음을 수학적으로 증명했습니다. 즉, MLP는 본질적으로 강력한 비선형 범용 함수 근사기(Universal Function Approximator)입니다.
2. 오차 역전파(Backpropagation)의 수학적 유도
다층 신경망이 비선형 문제를 풀 수 있다는 것은 알았지만, 수백~수천 개의 가중치를 어떻게 훈련시킬 것인가가 거대한 장벽이었습니다. 1986년 데이비드 루멜하트(David Rumelhart), 제프리 힌튼(Geoffrey Hinton), 로널드 윌리엄스(Ronald Williams)는 미적분의 연쇄 법칙(Chain Rule)을 이용한 오차 역전파(Backpropagation) 알고리즘을 대중화하며 신경망의 르네상스를 이끌었습니다.
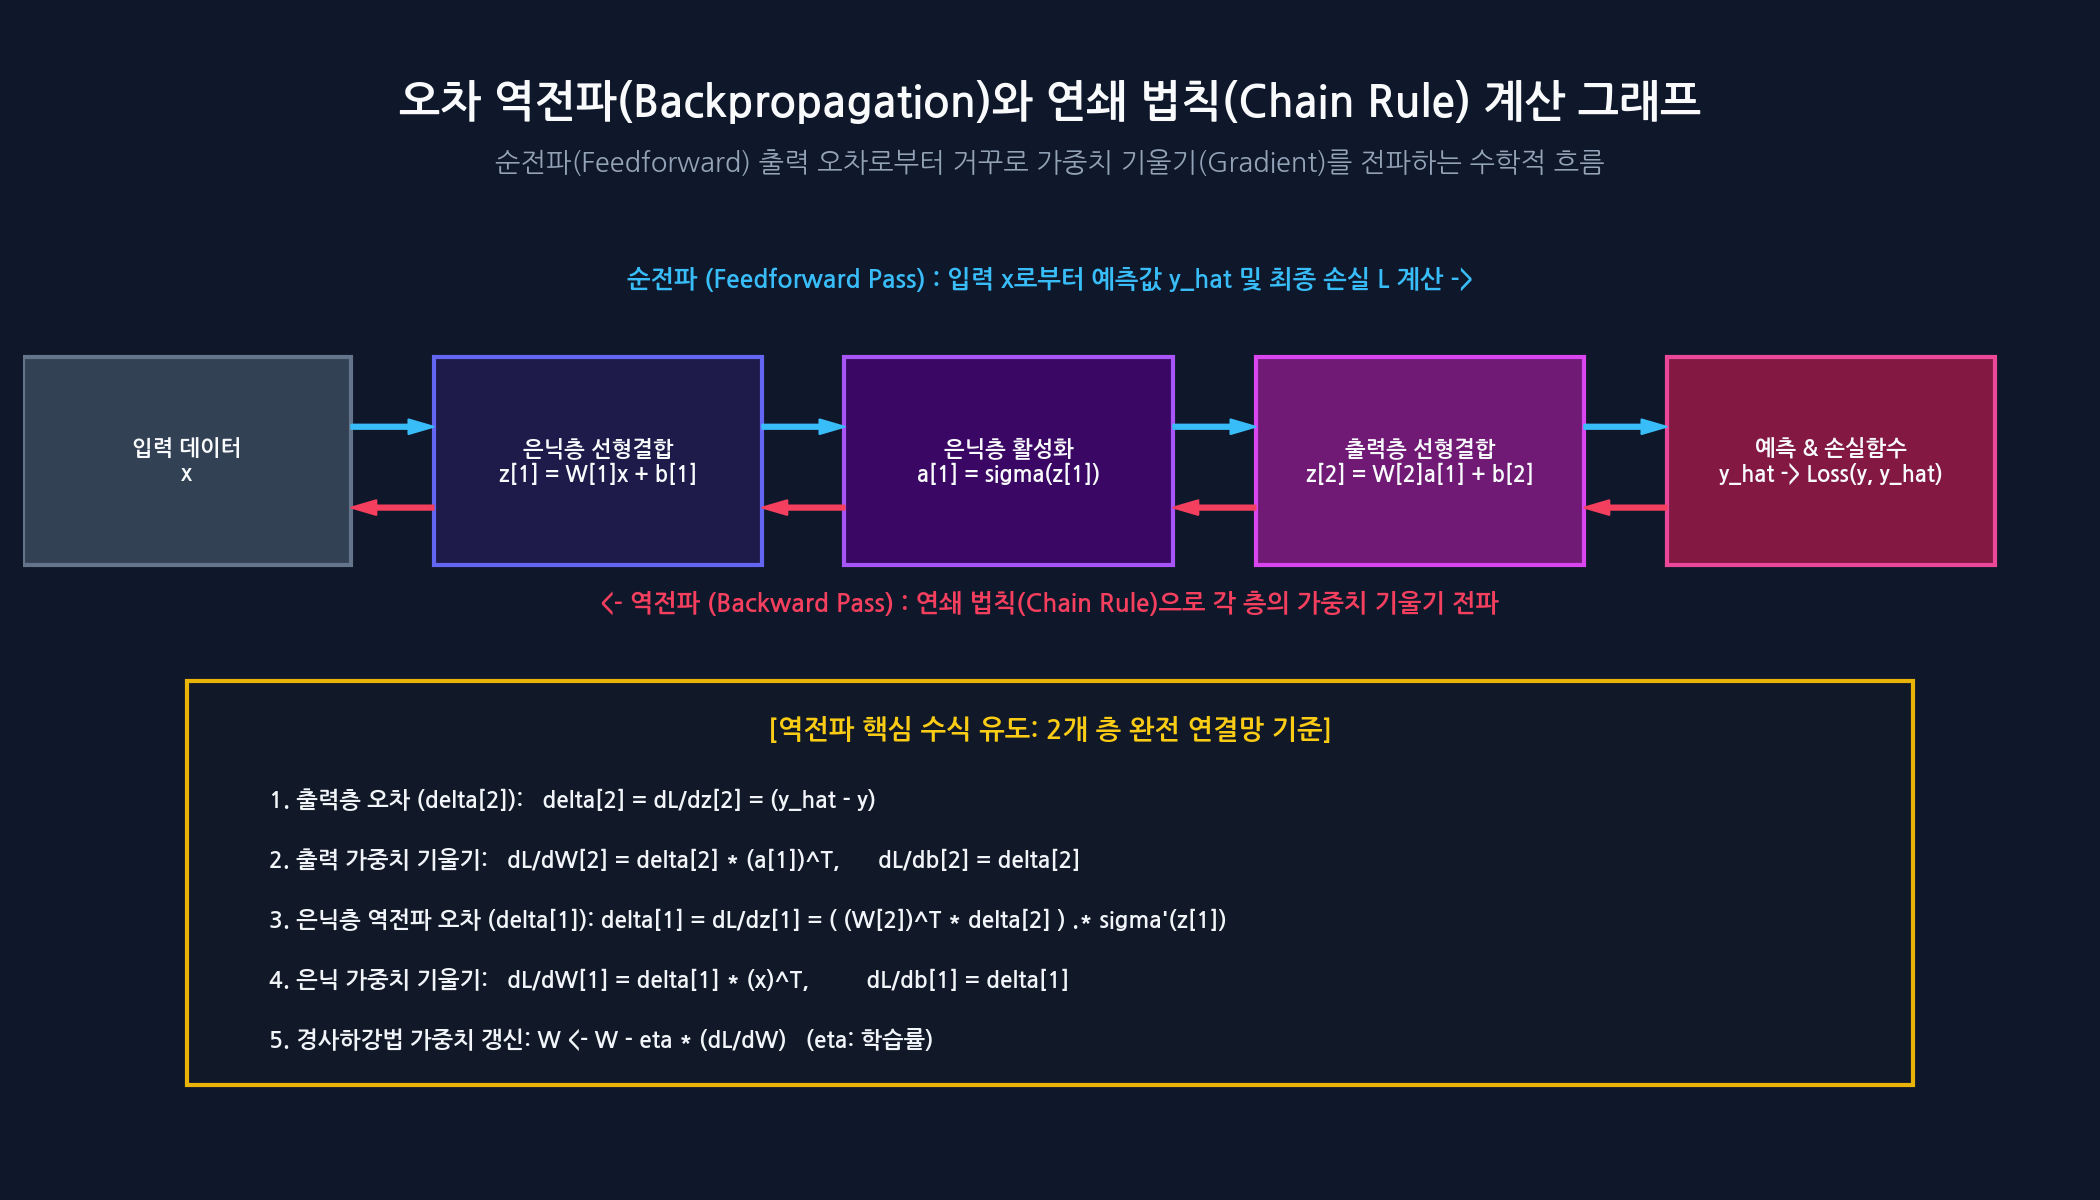
가장 표준적인 2개 층 완전 연결망(입력층 \(\to\) 은닉층 \(\to\) 출력층)을 기준으로 역전파의 미분 과정을 직접 유도해 보겠습니다.
2.1 순전파(Feedforward Pass) 수식
하나의 관측치 \(x \in \mathbb{R}^p\)에 대해 순전파는 다음과 같이 진행됩니다:
- 은닉층 선형 결합: \[z^{[1]} = W^{[1]} x + b^{[1]}\]
- 은닉층 활성화 (예: 시그모이드): \[a^{[1]} = \sigma(z^{[1]})\]
- 출력층 선형 결합: \[z^{[2]} = W^{[2]} a^{[1]} + b^{[2]}\]
- 최종 출력 예측값: \[\hat{y} = \sigma(z^{[2]})\]
이진 분류 문제에서 타겟 \(y \in \{0, 1\}\)에 대한 이진 교차 엔트로피(Binary Cross-Entropy) 손실함수는 다음과 같습니다:
\[\mathcal{L}(y, \hat{y}) = - \left[ y \ln \hat{y} + (1 - y) \ln(1 - \hat{y}) \right]\]
2.2 출력층 가중치 기울기 유도
우리의 목표는 손실 \(\mathcal{L}\)을 출력층 가중치 \(W^{[2]}\)로 편미분한 \(\frac{\partial \mathcal{L}}{\partial W^{[2]}}\)를 구하는 것입니다. 연쇄 법칙을 적용합니다:
\[\frac{\partial \mathcal{L}}{\partial W^{[2]}} = \frac{\partial \mathcal{L}}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial z^{[2]}} \cdot \frac{\partial z^{[2]}}{\partial W^{[2]}}\]
각 구성 요소를 미분해 보겠습니다:
- \(\frac{\partial \mathcal{L}}{\partial \hat{y}} = - \frac{y}{\hat{y}} + \frac{1 - y}{1 - \hat{y}} = \frac{\hat{y} - y}{\hat{y}(1 - \hat{y})}\)
- \(\hat{y} = \sigma(z^{[2]})\)의 도함수는 \(\sigma'(z) = \sigma(z)(1 - \sigma(z)) = \hat{y}(1 - \hat{y})\)
- 따라서 출력층 오차 \(\delta^{[2]} = \frac{\partial \mathcal{L}}{\partial z^{[2]}}\)는 놀랍도록 단순해집니다: \[\delta^{[2]} = \frac{\partial \mathcal{L}}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial z^{[2]}} = \frac{\hat{y} - y}{\hat{y}(1 - \hat{y})} \cdot \hat{y}(1 - \hat{y}) = \hat{y} - y\]
- \(z^{[2]} = W^{[2]} a^{[1]} + b^{[2]}\)이므로 \(\frac{\partial z^{[2]}}{\partial W^{[2]}} = (a^{[1]})^T\)
최종적으로 출력층 가중치와 편향에 대한 기울기는 다음과 같습니다:
\[\frac{\partial \mathcal{L}}{\partial W^{[2]}} = \delta^{[2]} (a^{[1]})^T, \quad \frac{\partial \mathcal{L}}{\partial b^{[2]}} = \delta^{[2]}\]
2.3 은닉층 가중치 기울기 유도 (오차의 역전파)
이제 출력층에서 계산된 오차 \(\delta^{[2]}\)를 이전 층인 은닉층으로 역전파합니다:
\[\delta^{[1]} = \frac{\partial \mathcal{L}}{\partial z^{[1]}} = \frac{\partial \mathcal{L}}{\partial z^{[2]}} \cdot \frac{\partial z^{[2]}}{\partial a^{[1]}} \cdot \frac{\partial a^{[1]}}{\partial z^{[1]}}\]
- \(\frac{\partial \mathcal{L}}{\partial z^{[2]}} = \delta^{[2]}\)
- \(z^{[2]} = W^{[2]} a^{[1]} + b^{[2]}\)이므로 \(\frac{\partial z^{[2]}}{\partial a^{[1]}} = (W^{[2]})^T\)
- \(a^{[1]} = \sigma(z^{[1]})\)이므로 \(\frac{\partial a^{[1]}}{\partial z^{[1]}} = \sigma'(z^{[1]})\)
따라서 은닉층의 오차 항 \(\delta^{[1]}\)은 다음과 같이 계산됩니다 (여기서 \(\odot\)는 원소별 곱인 아다마르 곱):
\[\delta^{[1]} = \left( (W^{[2]})^T \delta^{[2]} \right) \odot \sigma'(z^{[1]})\]
이를 바탕으로 은닉층 가중치 \(W^{[1]}\)과 편향 \(b^{[1]}\)의 기울기가 도출됩니다:
\[\frac{\partial \mathcal{L}}{\partial W^{[1]}} = \delta^{[1]} x^T, \quad \frac{\partial \mathcal{L}}{\partial b^{[1]}} = \delta^{[1]}\]
2.4 경사하강법(Gradient Descent) 가중치 갱신
계산된 기울기(Gradient)에 학습률(Learning Rate, \(\eta\))을 곱하여 손실이 감소하는 반대 방향으로 가중치를 갱신합니다:
\[W^{[l]} \leftarrow W^{[l]} - \eta \frac{\partial \mathcal{L}}{\partial W^{[l]}}, \quad b^{[l]} \leftarrow b^{[l]} - \eta \frac{\partial \mathcal{L}}{\partial b^{[l]}}\]
이것이 바로 컴퓨터가 수천만 개의 파라미터를 가진 신경망을 오차로부터 거꾸로 학습시키는 오차 역전파의 본질입니다.
3. 활성화 함수와 가중치 감쇠(Weight Decay) 규제
인공신경망은 표현력이 너무 뛰어나기 때문에 훈련 데이터의 사소한 노이즈까지 완벽하게 외워버리는 과적합(Overfitting)에 극도로 취약합니다. 이를 제어하는 두 가지 핵심 메커니즘이 바로 적절한 활성화 함수 선택과 가중치 감쇠(Weight Decay)입니다.
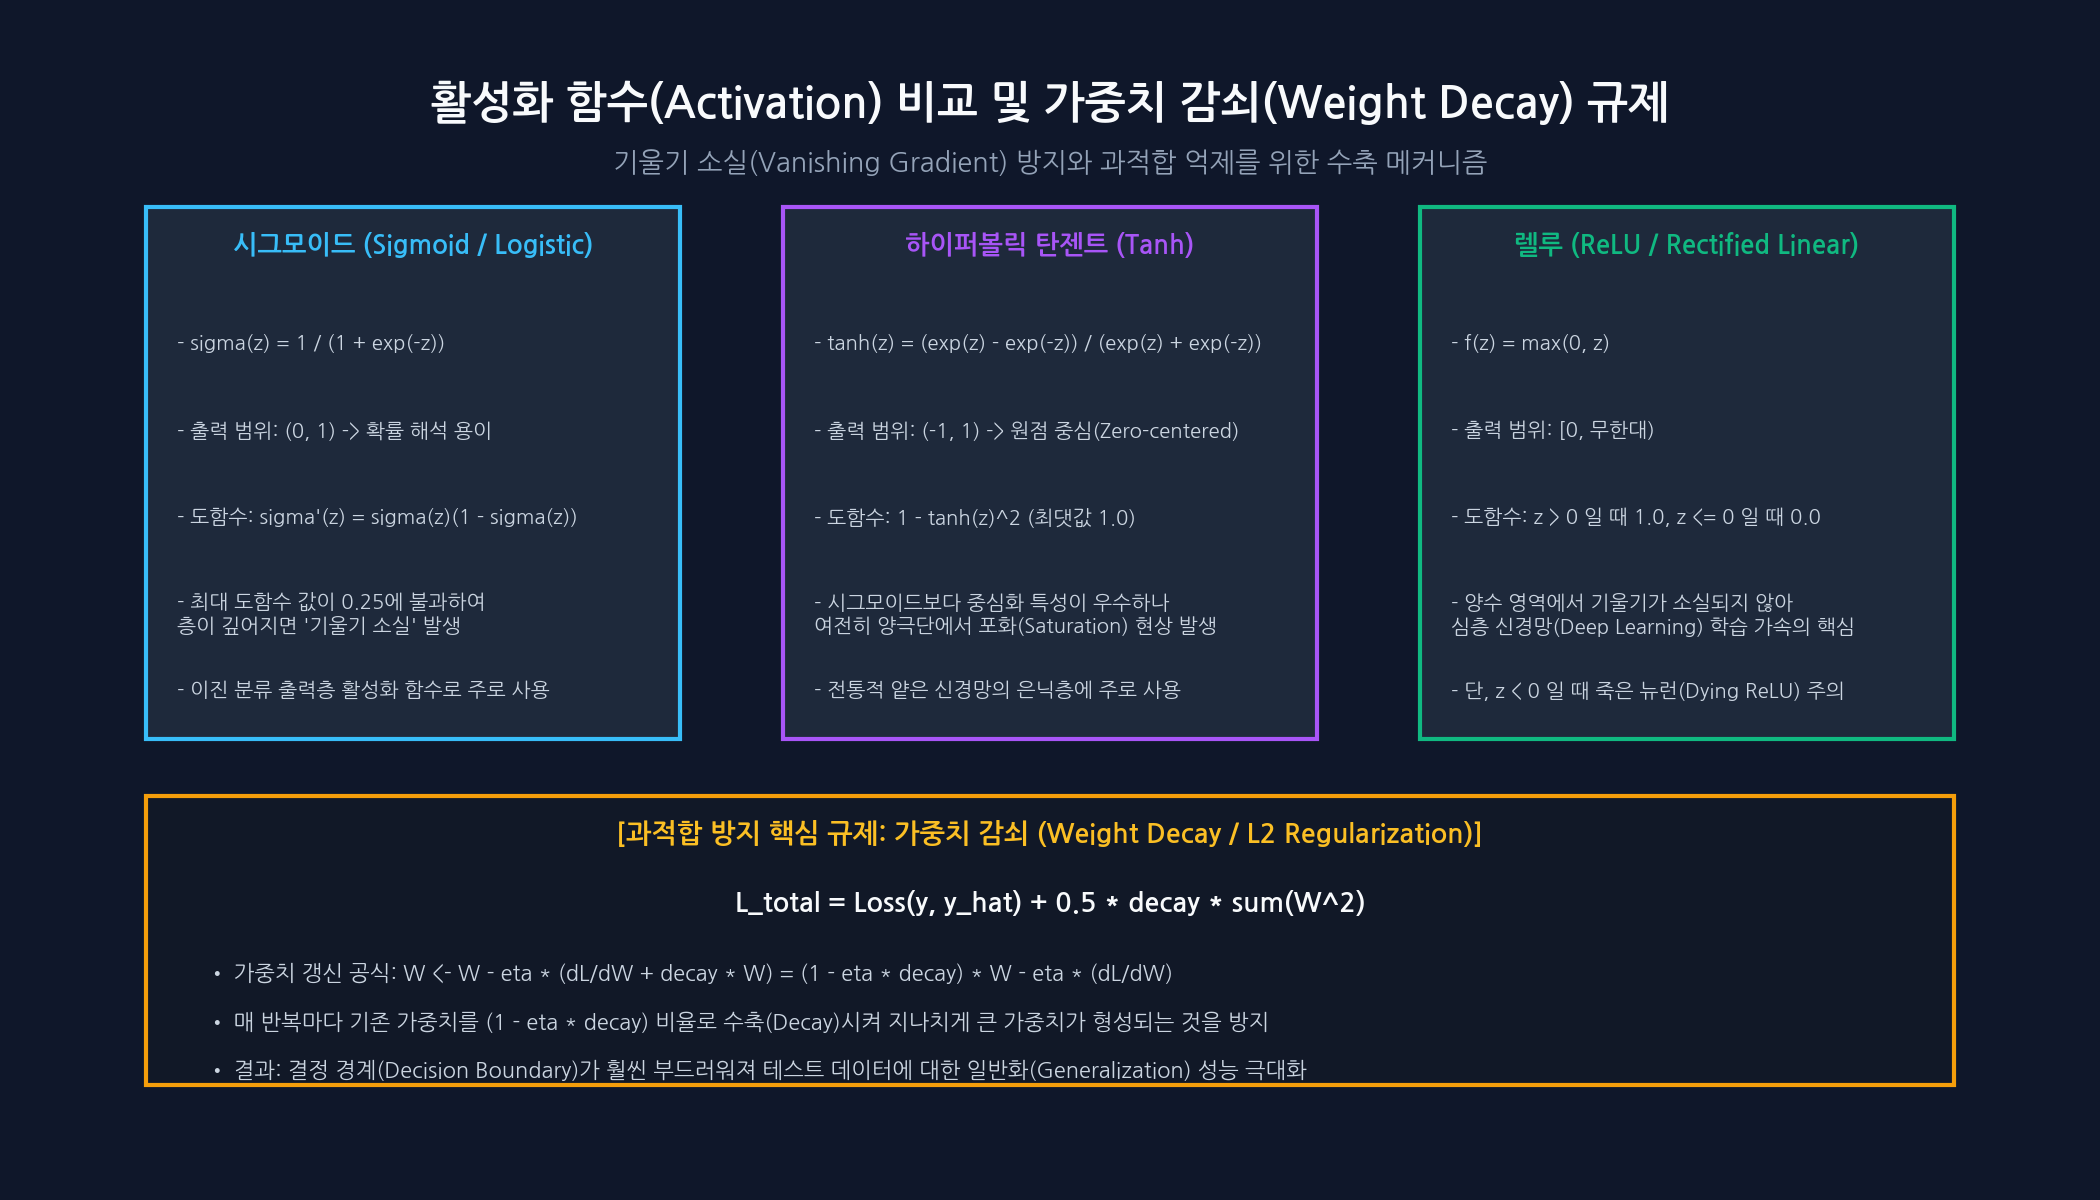
3.1 대표적 활성화 함수의 특성과 기울기 소실
| 활성화 함수 | 수학적 정의 | 출력 범위 | 도함수 최댓값 | 주요 특성 및 실무 고려사항 |
|---|---|---|---|---|
| 시그모이드 (Sigmoid) | \(\sigma(z) = \frac{1}{1 + e^{-z}}\) | \((0, 1)\) | 0.25 | 출력이 항상 양수이며, 도함수 최댓값이 0.25에 불과해 은닉층이 3개 이상 깊어지면 기울기 소실(Vanishing Gradient) 발생 |
| 하이퍼볼릭 탄젠트 (Tanh) | \(\tanh(z) = \frac{e^z - e^{-z}}{e^z + e^{-z}}\) | \((-1, 1)\) | 1.0 | 원점 중심(Zero-centered)이라 시그모이드보다 학습 수렴이 빠름. 얕은 신경망 은닉층에 우수 |
| 렐루 (ReLU) | \(f(z) = \max(0, z)\) | \([0, \infty)\) | 1.0 (\(z > 0\)) | 양수 구간에서 도함수가 1이므로 깊은 층에서도 기울기 소실 완전 해소. 단, \(z < 0\)에서 죽은 뉴런(Dying ReLU) 주의 |
3.2 가중치 감쇠 (Weight Decay / L2 정규화)
가중치 감쇠는 손실함수에 가중치 제곱합 패널티를 부여하는 L2 정규화 기법입니다:
\[\mathcal{L}_{\text{total}} = \mathcal{L} + \frac{1}{2} \lambda \sum_{l} \|W^{[l]}\|_F^2\]
이 목적함수를 \(W\)에 대해 미분하여 가중치 갱신 식에 대입하면 다음과 같은 형태가 됩니다:
\[W \leftarrow W - \eta \left( \frac{\partial \mathcal{L}}{\partial W} + \lambda W \right) = (1 - \eta \lambda) W - \eta \frac{\partial \mathcal{L}}{\partial W}\]
[수학적 직관]
매 학습 단계마다 기존 가중치에 \((1 - \eta \lambda)\)라는 1보다 작은 감쇠 계수를 곱해줍니다. 즉, 오차를 줄이는 데 결정적으로 기여하지 못하는 불필요한 가중치는 매 에포크마다 0 쪽으로 서서히 수축(Decay)되어 소멸합니다. 결과적으로 신경망의 결정 경계가 울퉁불퉁해지지 않고 완만하고 매끄러운 곡선으로 형성되어 테스트 세트 일반화 성능이 비약적으로 향상됩니다.
4. R 실무 파이프라인: nnet vs neuralnet
R 환경에서 인공신경망을 구축할 때는 프로젝트의 목적에 따라 적절한 패키지를 선택해야 합니다.
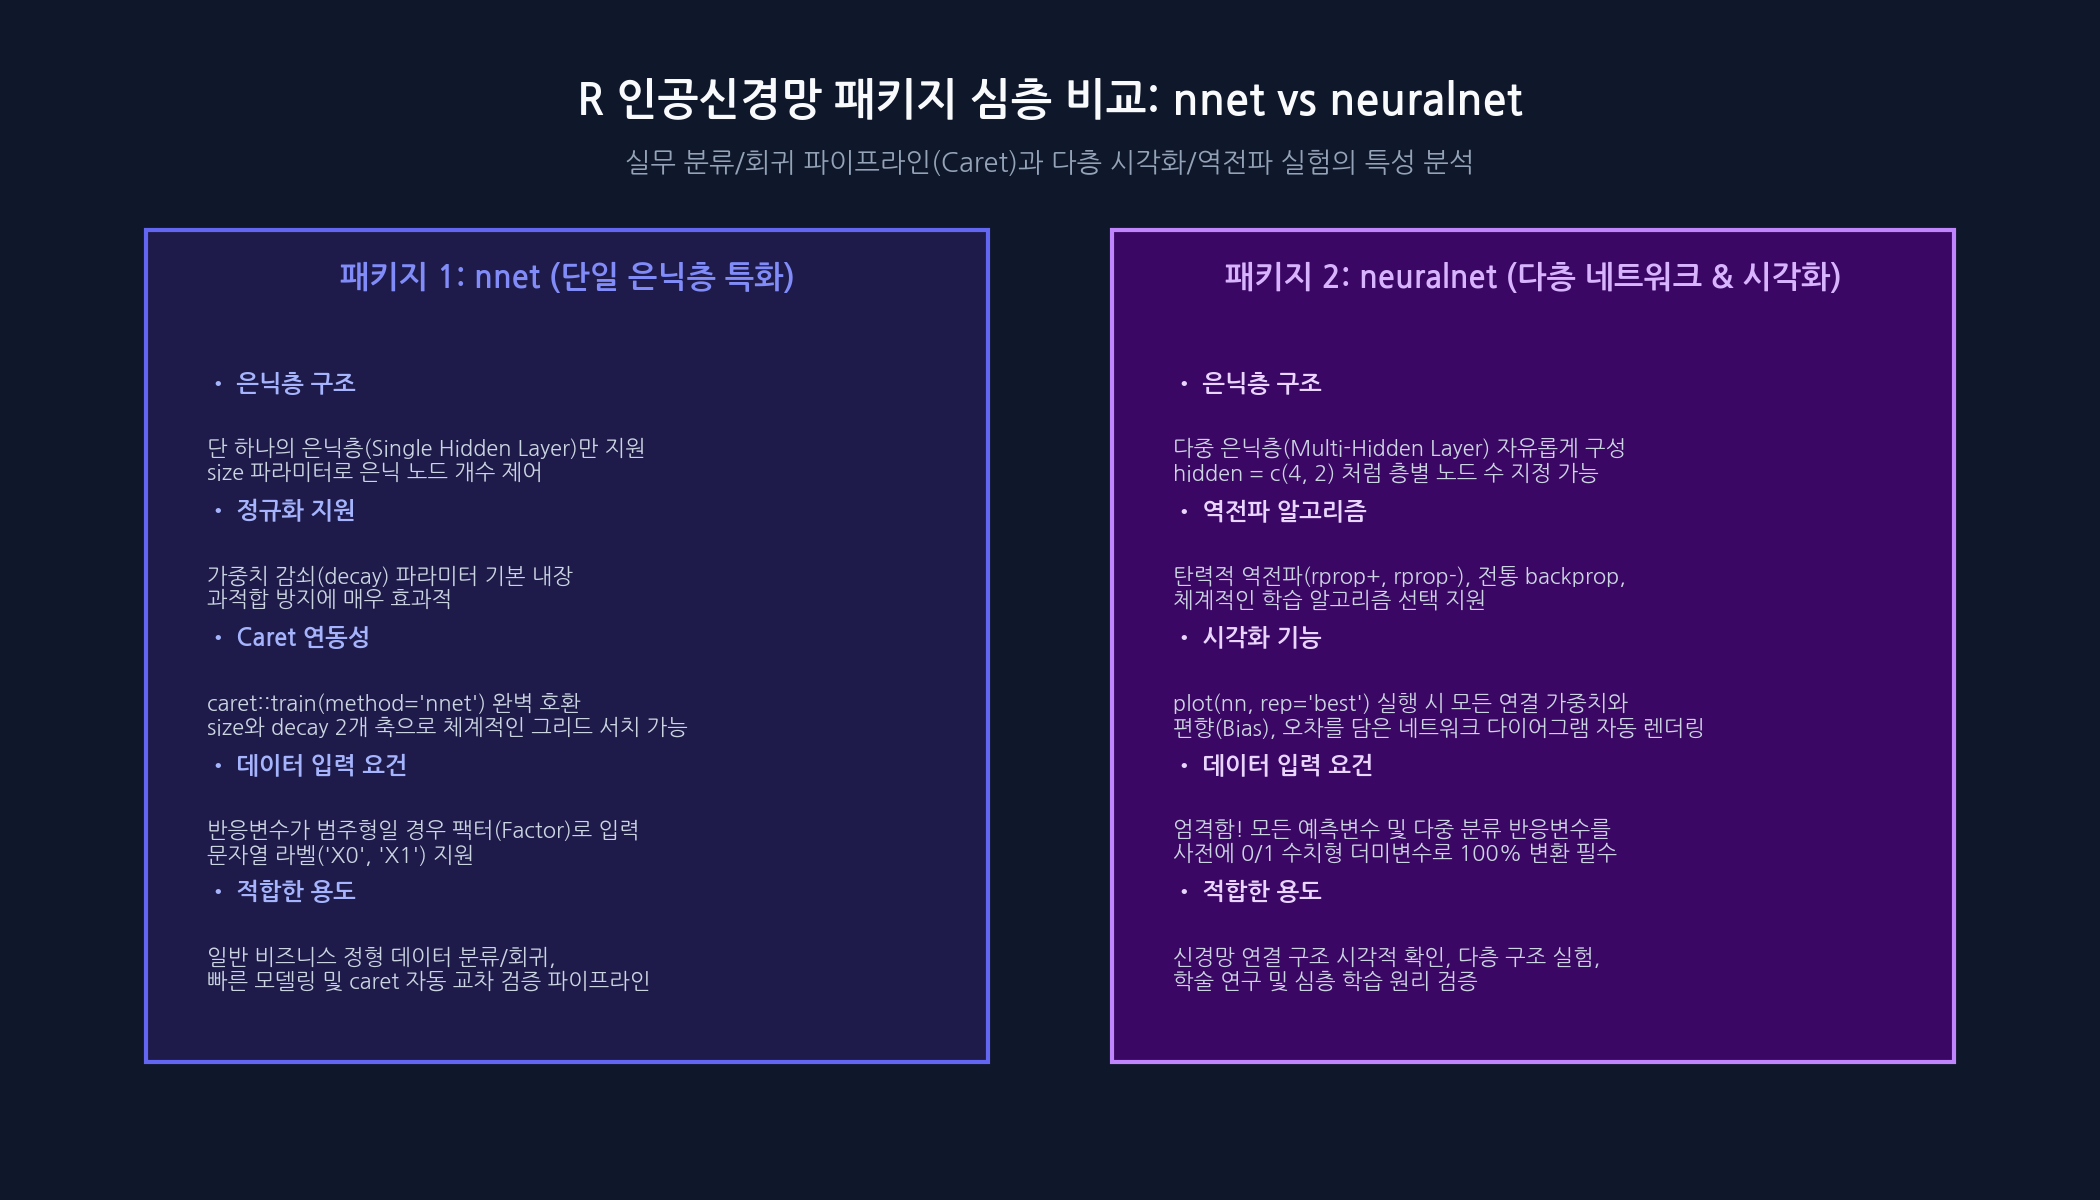
nnet: 단일 은닉층(Single Hidden Layer)에 특화되어 있으며 연산 속도가 매우 빠릅니다.caret패키지와 완벽하게 통합되어 은닉 노드 수(size)와 가중치 감쇠(decay)를 2차원 격자로 자동 튜닝할 때 최적입니다.neuralnet: 다중 은닉층(hidden = c(4, 2)) 구성이 가능하고 탄력적 역전파(rprop+)를 지원합니다. 특히 학습된 모델의 연결 가중치와 편향을 다이어그램으로 완벽하게 시각화(plot)할 수 있어 모델의 내부를 분석할 때 최적입니다.
4.1 Caret & nnet을 활용한 하이퍼파라미터 그리드 튜닝
미국 교통사고 데이터셋(accidentsnn.csv)을 모사하여 사고 심각도(가벼움 X0, 보통 X1, 치명적 X2)를 예측하는 다중 분류 모델을 구현해 보겠습니다.
# 필수 패키지 로드
library(tidyverse)
library(caret)
library(nnet)
library(rsample)
library(recipes)

# 1. 재현 가능한 가상 데이터 생성 (교통사고 심각도 예측)
set.seed(42)
n <- 600
accidents_df <- tibble(
  ALCHL_I    = rbinom(n, 1, 0.2),                     # 음주 여부 (0, 1)
  PROFIL_I_R = sample(c("Level", "Slope", "Curved"), n, replace = TRUE), # 도로 형태
  VEH_INVL   = rpois(n, lambda = 2) + 1,              # 연루 차량 수
  MAX_SEV_IR = factor(sample(c("X0", "X1", "X2"), n, replace = TRUE, prob = c(0.5, 0.3, 0.2))) # 사고 심각도
)

# 2. 훈련용/테스트용 계층화 분할 (7:3)
splits <- initial_split(accidents_df, prop = 0.7, strata = MAX_SEV_IR)
train_raw <- training(splits)
test_raw  <- testing(splits)

# 3. 전처리 레시피 (신경망 필수: 표준화 및 원핫 더미 인코딩)
# ※ 신경망은 입력 스케일에 극도로 민감하므로 모든 연속형 변수를 평균 0, 표준편차 1로 정규화합니다.
nn_rec <- recipe(MAX_SEV_IR ~ ., data = train_raw) %>%
  step_normalize(all_numeric_predictors()) %>% # 수치형 변수 스케일링
  step_dummy(all_nominal_predictors()) %>%     # 범주형 변수 더미화
  prep()

train_df <- juice(nn_rec)
test_df  <- bake(nn_rec, new_data = test_raw)

# 4. Caret 교차 검증 제어 설정
control <- trainControl(
  method          = "cv",
  number          = 5,
  classProbs      = TRUE,                  # 클래스별 소속 확률 산출
  summaryFunction = multiClassSummary,     # LogLoss, Accuracy 등 다중 지표 산출
  savePredictions = "final",
  verboseIter     = FALSE
)

# 5. nnet 2대 핵심 하이퍼파라미터 그리드 정의
# - size: 은닉 뉴런 개수 (모델 용량 결정)
# - decay: 가중치 감쇠 계수 (과적합 억제)
nnet_grid <- expand.grid(
  size  = c(2, 5, 10),
  decay = c(0.001, 0.01, 0.1, 0.5)
)

# 6. 모델 훈련 (최적화 메트릭: logLoss)
set.seed(123)
mlp_fit <- train(
  MAX_SEV_IR ~ .,
  data      = train_df,
  method    = "nnet",
  metric    = "logLoss",
  trControl = control,
  tuneGrid  = nnet_grid,
  trace     = FALSE,     # 반복 출력 로그 숨김
  maxit     = 300        # 최대 에포크 수
)

# 최적 파라미터 확인
print(mlp_fit$bestTune)
테스트 데이터셋에서 최종 일반화 성능과 혼동 행렬을 확인합니다:
# 7. 독립 테스트 데이터 평가
test_preds <- predict(mlp_fit, newdata = test_df)
cm <- confusionMatrix(test_preds, test_df$MAX_SEV_IR)
print(cm$overall["Accuracy"])
print(cm$byClass[, c("Precision", "Recall", "F1")])
4.2 neuralnet을 활용한 다층 구조 구성 및 네트워크 시각화
neuralnet은 모든 범주형 변수와 타겟 변수까지 완벽한 수치형 더미(0/1) 형태로 요구합니다. 다층 은닉층(hidden = c(4, 2))을 구성하고 시각화 다이어그램을 출력하는 코드를 작성해 보겠습니다.
library(neuralnet)

# 1. neuralnet 전용 데이터 포맷 준비 (타겟 원핫 더미 인코딩)
train_nn <- train_df %>%
  mutate(
    SEV_X0 = as.numeric(MAX_SEV_IR == "X0"),
    SEV_X1 = as.numeric(MAX_SEV_IR == "X1"),
    SEV_X2 = as.numeric(MAX_SEV_IR == "X2")
  ) %>%
  select(-MAX_SEV_IR)

test_nn <- test_df %>%
  mutate(
    SEV_X0 = as.numeric(MAX_SEV_IR == "X0"),
    SEV_X1 = as.numeric(MAX_SEV_IR == "X1"),
    SEV_X2 = as.numeric(MAX_SEV_IR == "X2")
  ) %>%
  select(-MAX_SEV_IR)

# 2. 포뮬러 자동 생성 (더미 타겟 3개 ~ 모든 설명변수)
pred_vars <- names(train_nn)[!names(train_nn) %in% c("SEV_X0", "SEV_X1", "SEV_X2")]
fml <- as.formula(paste("SEV_X0 + SEV_X1 + SEV_X2 ~", paste(pred_vars, collapse = " + ")))

# 3. 다층 신경망(4-2 은닉 구조) 학습
set.seed(42)
nn_model <- neuralnet(
  formula       = fml,
  data          = train_nn,
  hidden        = c(4, 2),        # 은닉층 1: 4개 뉴런, 은닉층 2: 2개 뉴런
  algorithm     = "rprop+",       # 탄력적 역전파 알고리즘
  err.fct       = "ce",           # 교차 엔트로피 손실 (이진/다중 분류)
  act.fct       = "logistic",     # 로지스틱 활성화 함수
  linear.output = FALSE,          # 출력 노드에 비선형 활성화 적용
  likelihood    = TRUE            # AIC, BIC 정보 기준 산출
)

# 4. 신경망 연결 구조 및 학습된 가중치 시각화
# ※ plot() 호출 시 입력-은닉-출력 노드 간의 가중치 선 두께와 편향(Bias)이 시각화됩니다.
plot(nn_model, rep = "best")

# 5. 테스트 데이터 예측 및 평가 (compute 함수 활용)
test_inputs <- test_nn %>% select(all_of(pred_vars))
nn_pred <- compute(nn_model, test_inputs)

# 예측 확률 행렬에서 가장 높은 확률의 인덱스 추출
predicted_class <- apply(nn_pred$net.result, 1, which.max) - 1
actual_class    <- apply(test_nn %>% select(SEV_X0, SEV_X1, SEV_X2), 1, which.max) - 1

# 혼동 행렬 확인
table(Predicted = predicted_class, Actual = actual_class)plot(nn_model)을 실행하면 R 그래픽 창에 각 입력 피처가 은닉층의 뉴런들과 어떻게 연결되는지, 어떤 경로의 가중치(파란색 선/검은색 선)가 강하게 활성화되었는지가 한눈에 드러납니다. 이는 딥러닝 모델의 가중치 연결 구조를 교육하거나 설명할 때 매우 강력한 도구가 됩니다.
5. 인공신경망 실무 적용 시 4대 핵심 엔지니어링 팁
인공신경망을 실무 데이터에 적용할 때 반드시 준수해야 하는 엔지니어링 수칙들입니다:
- 입력 변수의 스케일링(Scaling)은 선택이 아닌 필수다
트리 기반 모델(랜덤 포레스트, XGBoost)과 달리, 신경망은 경사하강법 기반으로 가중치를 갱신합니다. 특정 변수의 단위가 크면 그 변수의 기울기가 전체 손실을 지배하여 가중치 갱신이 불안정해지고 수렴 속도가 극도로 느려집니다. 모든 수치형 변수는 Z-score 표준화(step_normalize) 또는 Min-Max 정규화(step_range)를 거쳐야 합니다. - 국소 최적해(Local Minima) 방지를 위한 다중 시작(Multi-start)
신경망의 손실 표면은 수많은 국소 최적점(Local Minima)과 안장점(Saddle Point)으로 가득 차 있습니다. 초기 가중치 시드(set.seed)에 따라 전혀 다른 성능의 모델이 나올 수 있으므로, 교차 검증을 통해 여러 번 초기화하여 안정적인 해를 찾아야 합니다. - 은닉 노드 수(
size)와 가중치 감쇠(decay)의 균형 유지
은닉 노드가 너무 많으면 과적합되고, 너무 적으면 표현력이 부족(과소적합)해집니다. 일반적으로 은닉 노드 수를 넉넉하게 잡되,decay파라미터를 0.01~0.1 수준으로 주어 모델 복잡도를 수학적으로 규제하는 전략이 가장 안정적입니다. - 조기 종료(Early Stopping)와 학습 곡선 모니터링
에포크(Epoch) 수가 무한정 늘어나면 훈련 오차는 0에 수렴하지만 검증 오차는 치솟게 됩니다. 검증 손실이 더 이상 개선되지 않는 지점을 모니터링하여 학습을 중단하는 조기 종료 장치를 반드시 마련해야 합니다.
6. 마치며: 기초가 단단해야 딥러닝이 보인다
인공신경망은 단순한 수학적 수식의 나열이 아닙니다. 생물학적 뉴런에서 영감을 받아 시작된 퍼셉트론이 XOR의 한계를 딛고, 은닉층의 공간 왜곡과 역전파의 연쇄 법칙을 통해 스스로 오차를 교정해 나가는 과정은 현대 인공지능이 이룩한 가장 위대한 지적 성취 중 하나입니다.
R의 nnet과 neuralnet을 통해 얕은 신경망(Shallow Neural Network)의 수학적 유도와 가중치 갱신 과정을 직접 손으로 검증해 보십시오. 이 원리를 명확하게 꿰뚫고 있다면, 향후 파이토치나 텐서플로우를 활용한 심층 합성곱 신경망(CNN), 순환 신경망(RNN), 트랜스포머(Transformer) 모델을 다룰 때도 아키텍처의 작동 원리를 막힘없이 해석할 수 있을 것입니다.
💡 연관 포스트 안내
- 서포트 벡터 머신(SVM) 완전 정복: 마진 최대화부터 커널 트릭, SVR & R 실습
- XGBoost 알고리즘 완벽 해부: 2차 테일러 전개부터 7대 하이퍼파라미터 튜닝까지
- 앙상블 학습 완벽 가이드: 배깅, 부스팅, 랜덤 포레스트부터 보팅까지