flowchart TD
    Q[분석 목적이 무엇인가?] --> D1[1. 분포 및 형태 탐색]
    Q --> D2[2. 두 변수 간 관계/상관]
    Q --> D3[3. 집단 간 크기/순위 비교]
    Q --> D4[4. 전체 대비 구성비]
    Q --> D5[5. 시간 추세 및 증감]
    Q --> D6[6. 경로 및 전환 흐름]
    Q --> D7[7. 지리·공간 분포]

    D1 --> D1_A[단일 연속형] --> H[히스토그램 / 밀도곡선 KDE]
    D1 --> D1_B[범주별 분포 요약] --> BX[박스 플롯 / 바이올린 플롯]

    D2 --> D2_A[두 연속형 변수] --> SC[산점도 Scatter + 추세선]
    D2 --> D2_B[데이터 밀집/대용량] --> HX[2D 헥스빈 / 컨투어 플롯]

    D3 --> D3_A[단일 시점 다항목] --> BR[정렬된 가로 막대 / 롤리팝]
    D3 --> D3_B[두 시점/집단 격차] --> DB[덤벨 차트 / 슬로프그래프]
    D3 --> D3_C[순위 변동 추적] --> BM[범프 차트 Bump]

    D4 --> D4_A[단일 계층 단순 비율] --> WF[100% 누적 막대 / 와플 차트]
    D4 --> D4_B[다계층 복합 구조] --> TM[트리맵 Treemap / 마리메코]

    D5 --> D5_A[연속 추세] --> LN[선 그래프 Line / 계단식 Step]
    D5 --> D5_B[손익/변동 기여도] --> WF2[폭포수 차트 Waterfall]

    D6 --> SK[샹키 다이어그램 / 퍼널 차트]
    D7 --> CH[단계구분도 Choropleth / 버블 맵]

    style Q fill:#1e293b,stroke:#0f172a,stroke-width:2px,color:#fff
    style D1 fill:#eff6ff,stroke:#3b82f6,stroke-width:1.5px,color:#1e3a8a
    style D2 fill:#eff6ff,stroke:#3b82f6,stroke-width:1.5px,color:#1e3a8a
    style D3 fill:#eff6ff,stroke:#3b82f6,stroke-width:1.5px,color:#1e3a8a
    style D4 fill:#eff6ff,stroke:#3b82f6,stroke-width:1.5px,color:#1e3a8a
    style D5 fill:#eff6ff,stroke:#3b82f6,stroke-width:1.5px,color:#1e3a8a
    style D6 fill:#eff6ff,stroke:#3b82f6,stroke-width:1.5px,color:#1e3a8a
    style D7 fill:#eff6ff,stroke:#3b82f6,stroke-width:1.5px,color:#1e3a8a
노트📊 [시각화 마스터 3부작] 제1편: 수치 데이터 차트 선택 사전
본 글은 비즈니스 데이터 시각화의 체계적인 마스터를 위한 3부작 시리즈 중 제1편입니다. - 제1편 (현재 글): 수치 데이터 형태별 최적 차트 선택 가이드 (분포, 상관, 비교, 시계열 등) - 제2편: 보고서와 PPT를 위한 다이어그램 10대 분류와 선택법 (구조, 위계, 프로세스 등 도식화) - 제3편: 데이터 스토리텔링 10대 원칙과 차트 리디자인 (클러터 제거, 인지 부하 감소, 설득 기술)
데이터 분석가로 일하면서 가장 자주 받는 질문 중 하나가 바로 이겁니다.
“데이터는 다 뽑았는데, 보고서에 어떤 차트로 넣어야 임원진이나 실무진이 한눈에 이해할까요?”
많은 입문자와 실무자들이 차트를 고를 때 저지르는 가장 흔한 실수는 “내가 그릴 줄 아는 차트”나 “화려해 보이는 차트”를 먼저 고르고 거기에 데이터를 억지로 끼워 맞추는 것입니다. 하지만 파이 차트에 카테고리 15개를 욱여넣거나, 시간에 따른 연속 추세를 보여줘야 하는데 정렬 없는 막대그래프로 그리면 아무리 뛰어난 머신러닝 모델링이나 통계 분석도 신뢰를 잃고 맙니다.
차트 선택의 대원칙은 단순합니다.
“도형의 이름이 아니라, 지금 내가 데이터로 해결하려는 분석 질문(Analytical Question)과 데이터의 형태(변수 속성)가 무엇인가?”에서 출발해야 합니다.
이번 글에서는 현업 실무에서 매일 마주치는 8대 분석 영역별 차트 선택 사전, 실제 시각화 결과물 12종 비교, 그리고 자주 헷갈리는 차트들의 결정적 차이와 R ggplot2 구현 팁까지 아낌없이 정리해 드립니다.
1. 차트 선택 의사결정 로드맵 (Decision Flowchart)
차트를 선택하기 전, 반드시 스스로에게 다음 3가지 질문을 던져보세요.
- 내 분석 질문의 핵심은 무엇인가? (분포 확인, 두 변수 간 상관관계, 집단 간 크기 비교, 시간 추세, 구성 비율, 증감 원인 추적, 흐름 전환, 공간 위치)
- 투입할 변수의 형태는 무엇인가? (연속형 수치 데이터인가, 이산형/범주형 명목 데이터인가?)
- 비교할 범주의 개수는 몇 개인가? (2~3개인가, 10개 이상인가?)
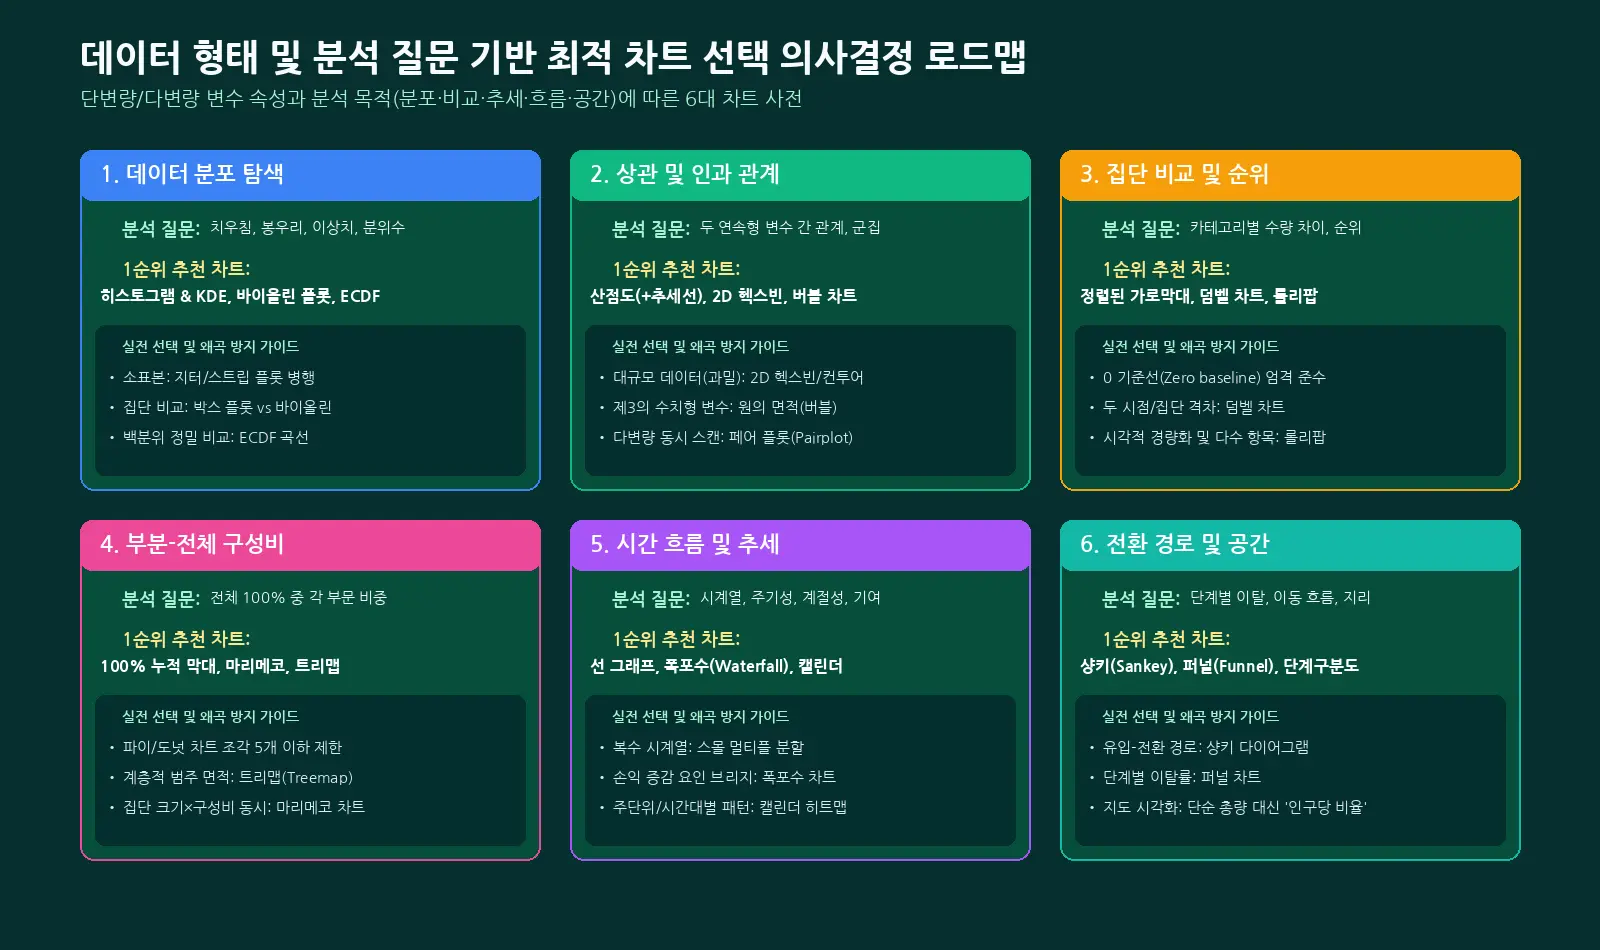
2. 실무 8대 분석 목적별 핵심 차트 완벽 해부
2.1 관계와 분포: “데이터가 어디에 어떻게 뭉쳐 있는가?”
단일 변수의 퍼짐(Spread), 왜도(Skewness), 이상치(Outlier)를 검토하거나 두 연속형 변수 간의 통계적 상관관계를 규명할 때 사용합니다.
| 차트 종류 | 최적 활용 시나리오 | 피해야 할 상황 / 흔한 실수 |
|---|---|---|
| 히스토그램 (Histogram) | 연속형 변수의 전반적 형상, 최빈값 구간, 치우침 확인 | 구간 너비(Bin width)를 너무 좁거나 넓게 잡아 분포가 왜곡되는 경우 |
| 밀도곡선 (KDE) | 히스토그램의 불연속성을 매끄러운 곡선으로 보정, 집단 간 분포 중첩 비교 | 대역폭(Bandwidth) 과적합 또는 음수가 나올 수 없는 변수에서 0 이하 영역 확장 |
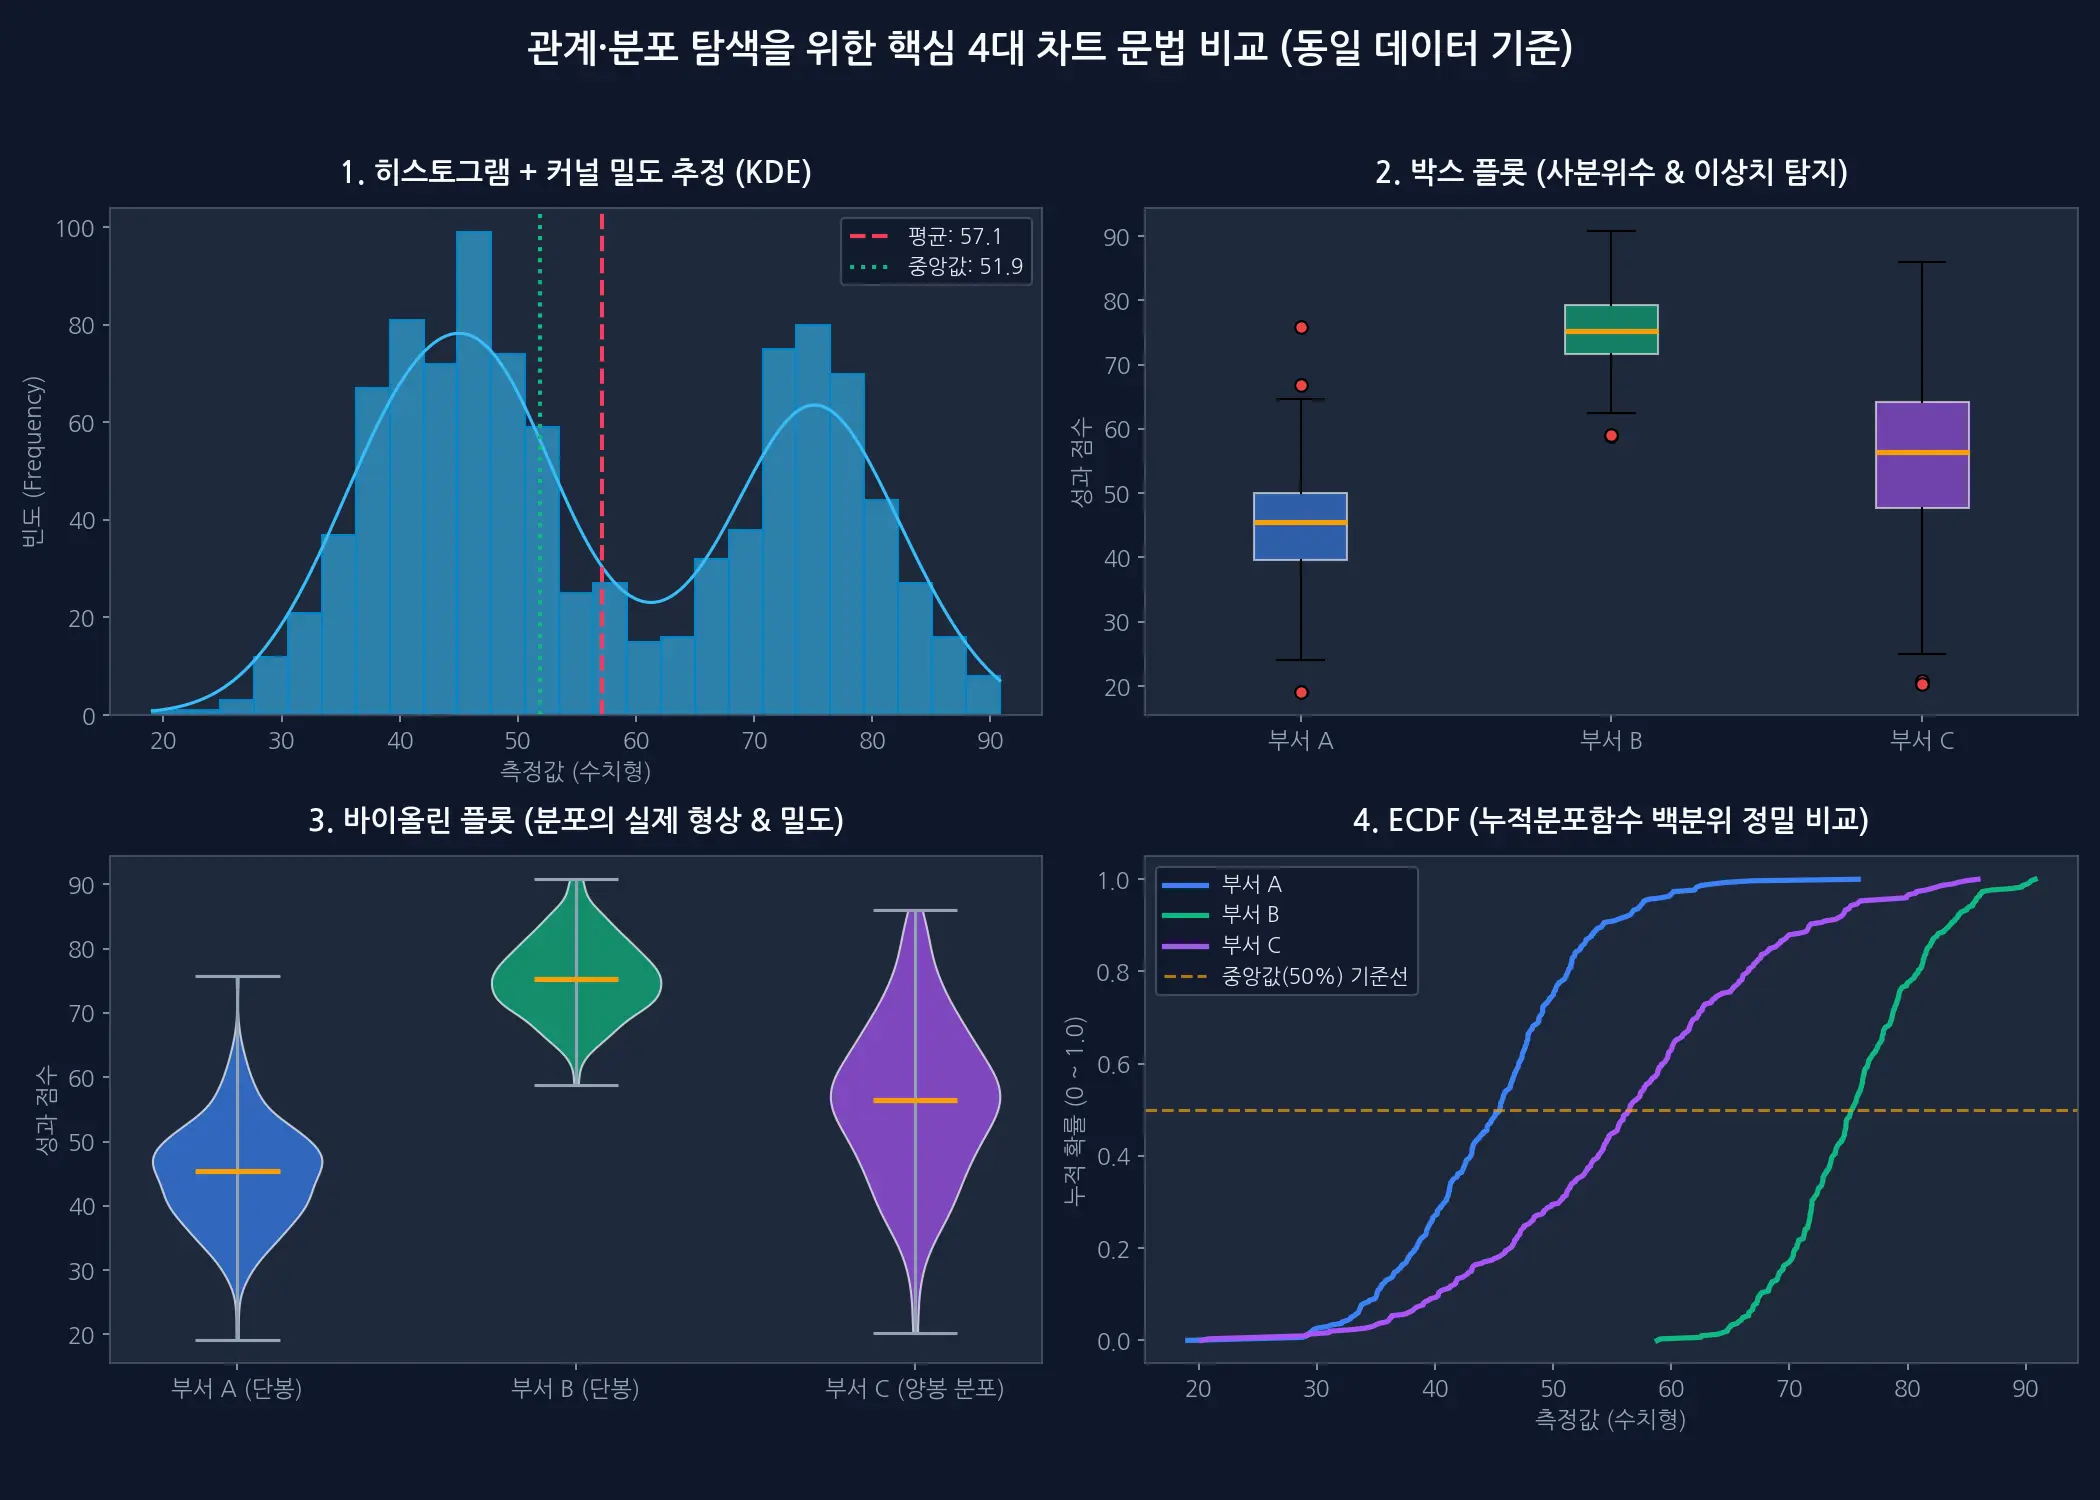
| 박스 플롯 (Box Plot) | 사분위수(Q1, Median, Q3)와 IQR 1.5배 기준 이상치 요약 탐색 | 쌍봉(Bimodal) 분포처럼 가운데가 비어 있는 형태를 전혀 포착하지 못함 |
| 바이올린 플롯 (Violin Plot) | 박스 플롯 요약 통계량과 밀도 분포 곡선을 동시에 결합하여 탐색 | 표본 크기(N)가 너무 작을 때(30건 미만) 그리면 거짓 밀도 곡선 생성 |
| 산점도 (Scatter Plot) | 두 연속형 변수 간의 양/음의 선형·비선형 관계 탐색 | 수만 건의 데이터가 겹쳐 점들이 새까맣게 떡지는 오버플로팅(Overplotting) |
| 2D 헥스빈 (Hexbin) | 수십만~수백만 건의 대규모 점 데이터를 육각 격자로 요약하여 밀도 파악 | 데이터 수가 적을 때는 일반 산점도가 훨씬 명확함 |
[!TIP] 실무 분석 팁:
분포를 탐색할 때 박스 플롯 하나만 믿는 것은 위험합니다. 데이터가 중간에 텅 비어 있는 쌍봉 분포(예: 20대와 50대에 집중된 연령 분포)도 박스 플롯은 정상적인 정규분포처럼 중앙값을 그립니다. 탐색 단계에서는 바이올린 플롯이나 원시 데이터 포인트를 흩뿌려주는 지터 플롯(Jitter Plot), 혹은 누적분포함수인 ECDF를 함께 검토하는 습관이 필수적입니다.
2.2 비교와 순위: “누가 더 크고 높은가? 격차는 얼마인가?”
실무 보고서에서 가장 빈번하게 작성되는 차트입니다. 범주 간 크기를 비교하고 순위를 정렬할 때 막대 차트만을 고집할 필요가 없습니다.
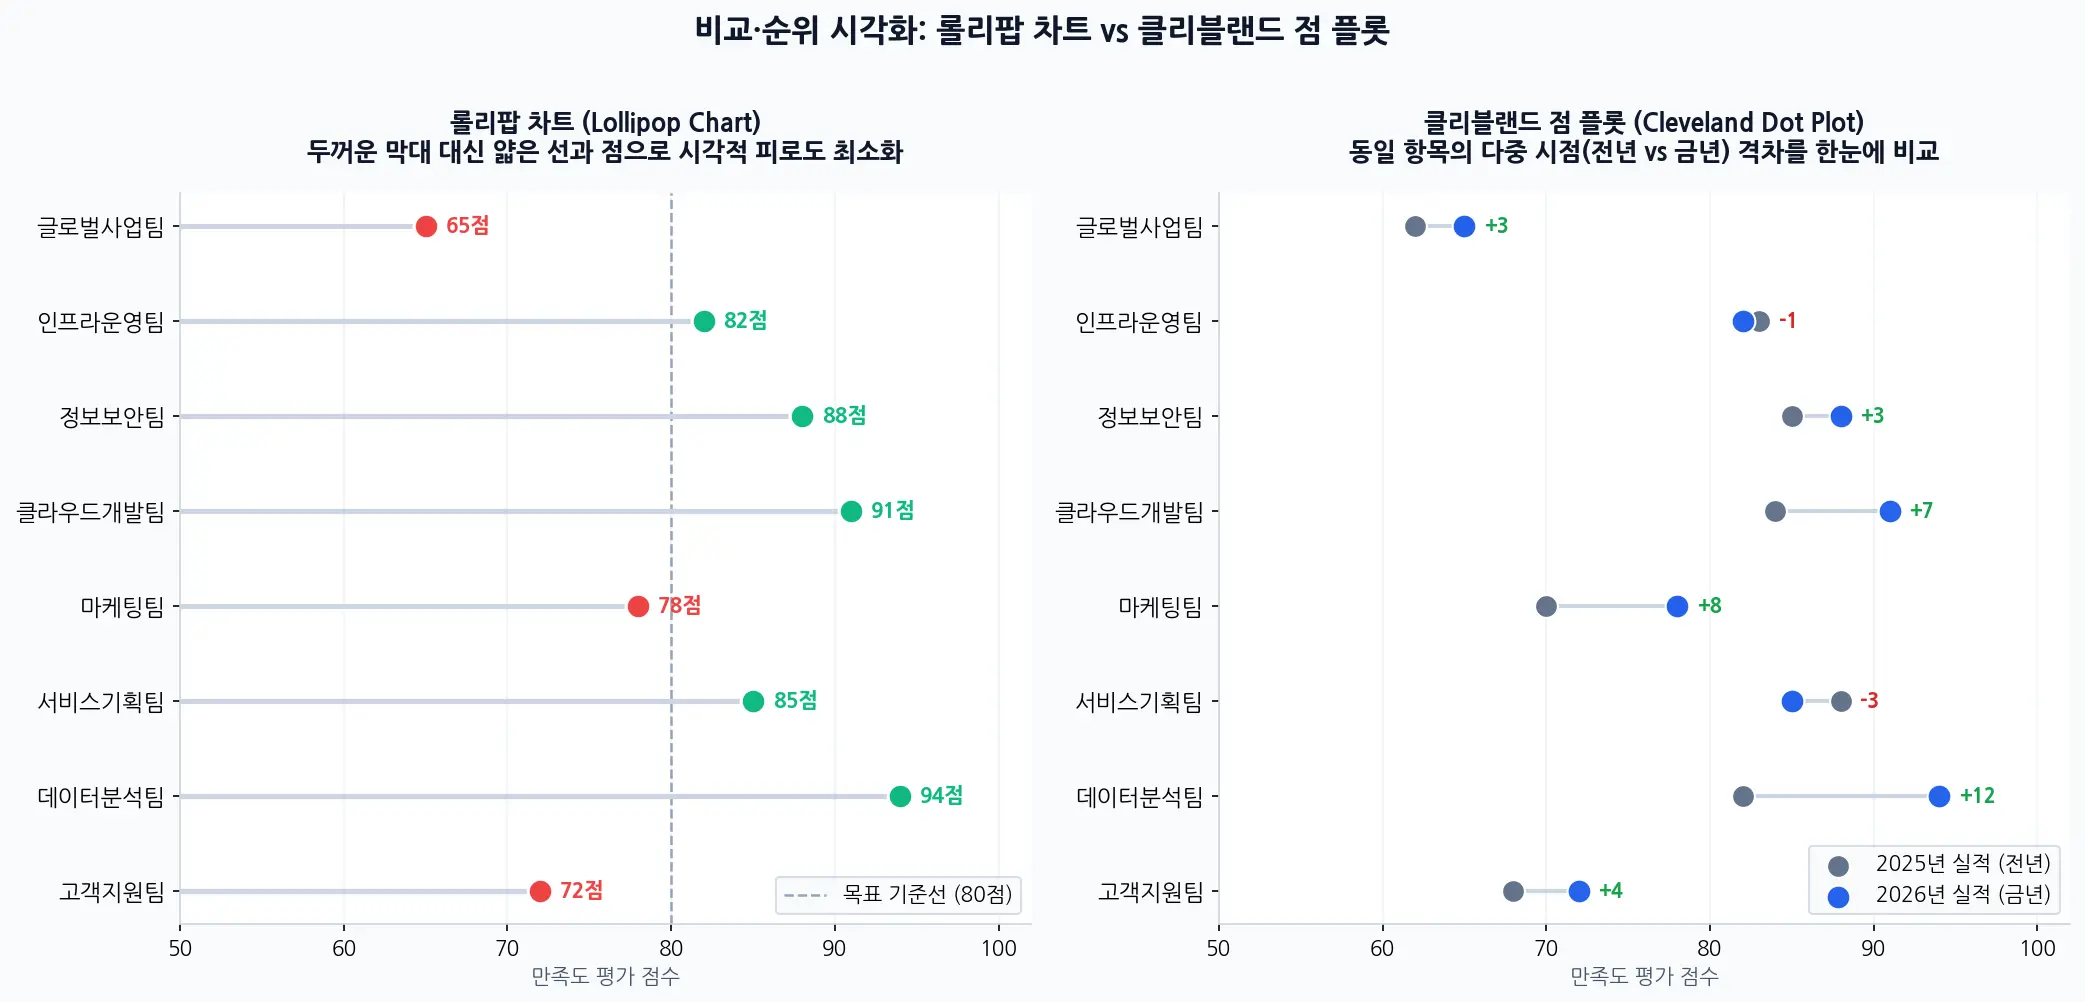
- 롤리팝 차트(Lollipop Chart):
막대 차트의 굵은 직사각형 면적을 얇은 기준선과 끝점 원형 마커로 대체한 형태입니다. 막대의 두꺼운 면적이 주는 시각적 피로감(Heavy visual ink)을 획기적으로 줄여주며, 범주가 10개 이상으로 많을 때 좁은 공간에 세련되게 정보를 압축할 수 있습니다. 특정 목표 기준선(예: 80점)을 넘겼는지 여부를 점 색상으로 분기하면 가독성이 극대화됩니다. - 클리블랜드 점 플롯(Cleveland Dot Plot):
하나의 범주에 대해 두 개 이상의 관측값(예: 2025년 실적 vs 2026년 실적, 목표치 vs 실제 달성치)을 하나의 수평 선상에 나란히 점으로 찍어 격차를 비교합니다. 묶은 막대그래프(Grouped Bar)보다 시선 이동이 훨씬 자연스럽습니다. - 덤벨 차트(Dumbbell Chart):
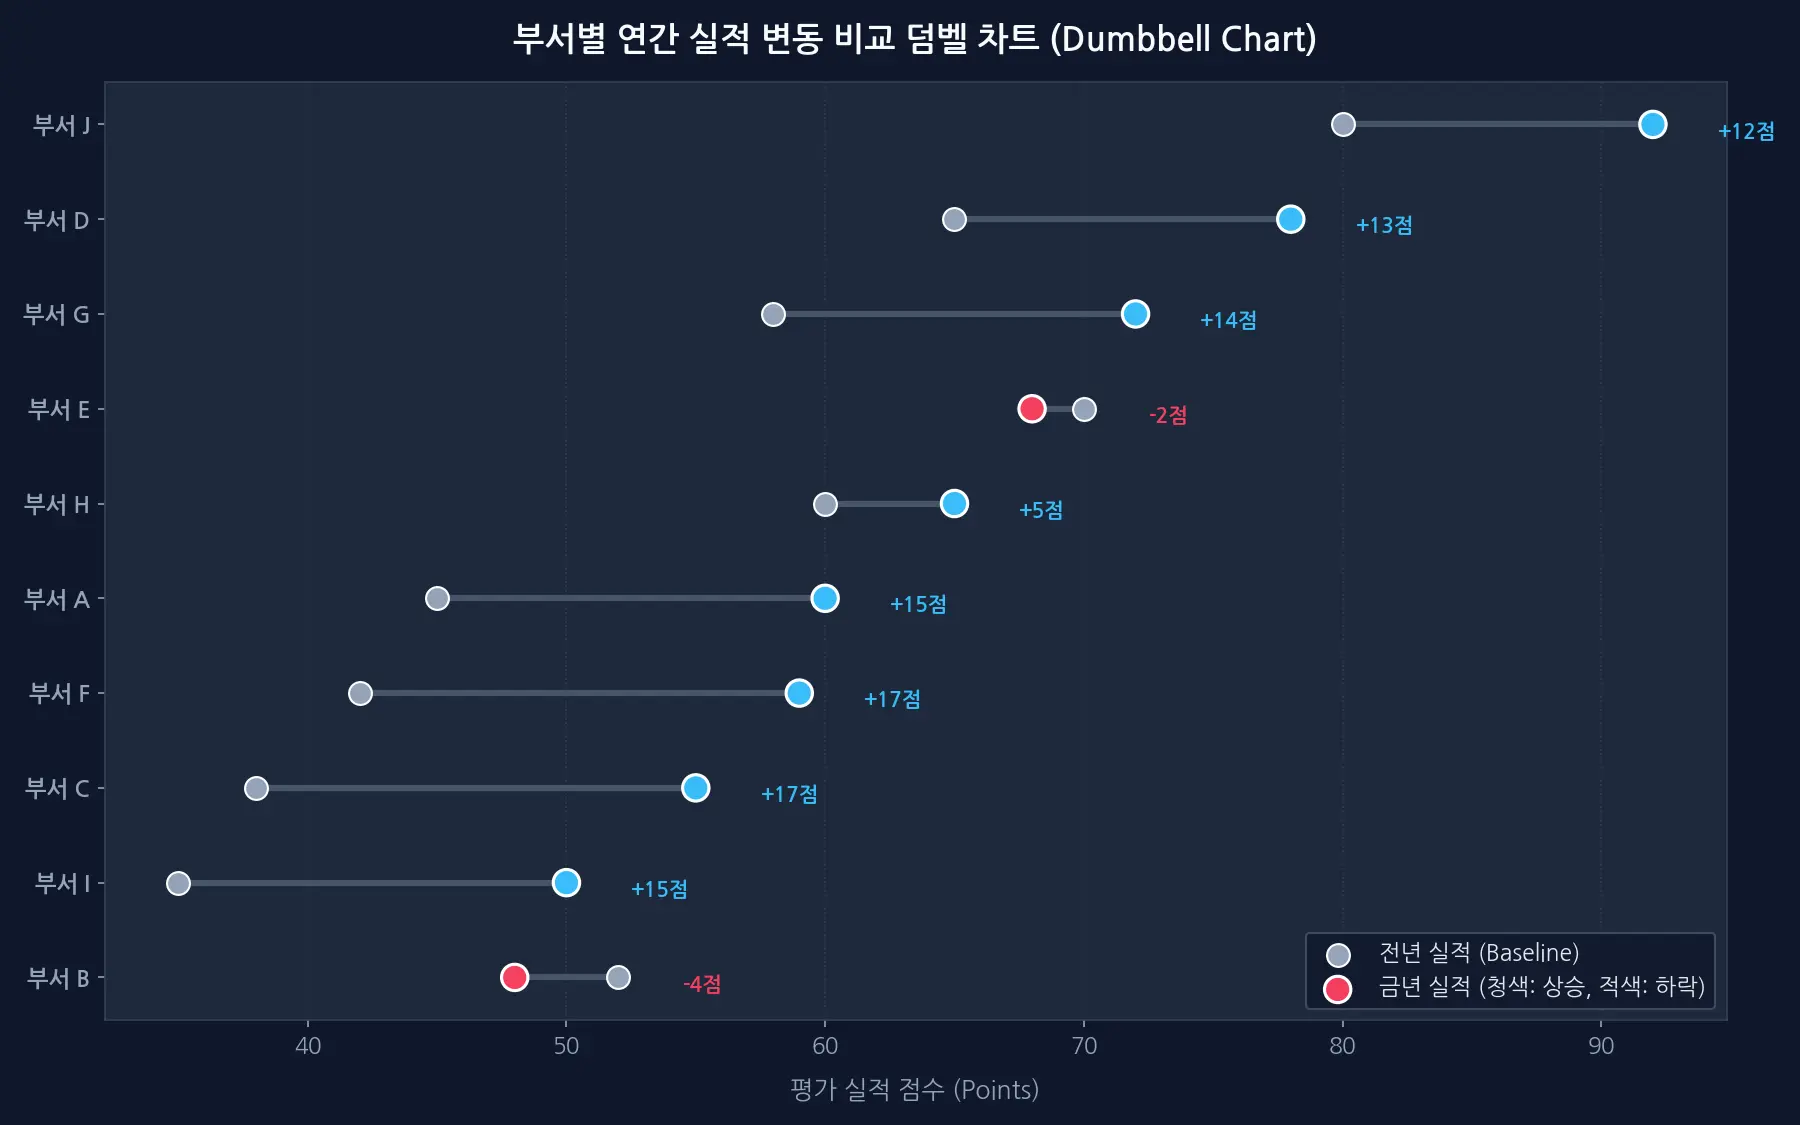
클리블랜드 점 플롯의 두 점 사이를 두꺼운 선분으로 이어 ‘아령’ 모양으로 만든 차트입니다. 두 시점 간의 간극(Gap)과 증감 방향(증가 시 파란색, 감소 시 붉은색)을 직관적으로 드러내는 데 현존하는 차트 중 가장 강력한 전달력을 발휘합니다.
2.3 변화율과 순위 역전: “이전과 비교해 무엇이 뒤집혔는가?”
전략 보고서나 정책 평가에서 “개편 전후로 지표가 어떻게 달라졌는가?”, 혹은 “경쟁사 간 순위 싸움이 어떻게 흘러갔는가?”를 설명해야 할 때가 있습니다.
- 슬로프그래프(Slopegraph):
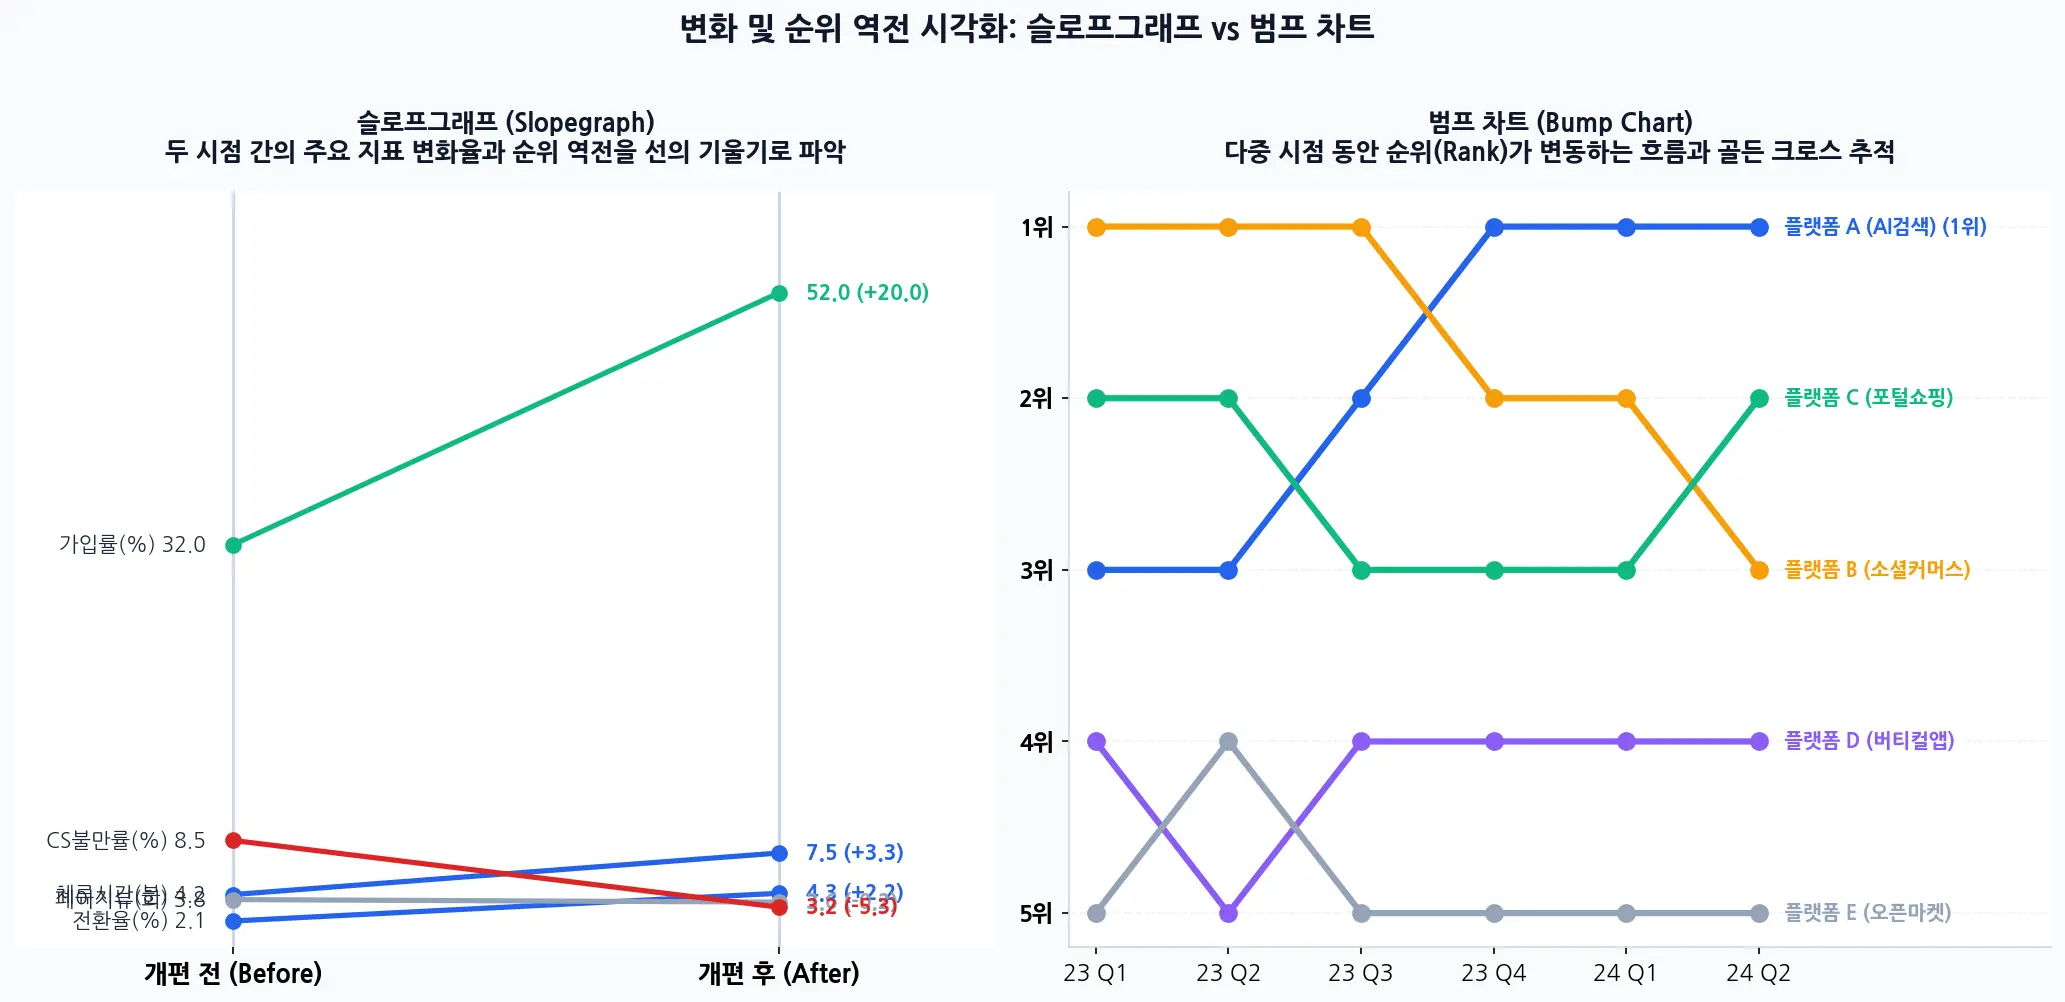
두 시점(Before vs After) 사이의 지표 변화를 좌우 두 축 사이를 잇는 직선의 ’기울기’로 표현합니다.- 선의 기울기가 가파를수록 변화율이 크다는 것을 즉각 체감할 수 있습니다.
- 선이 교차하는 지점은 순위가 역전(Rank Inversion)되었음을 한눈에 보여줍니다.
- UI 개편 전후 체류시간·전환율 비교, 신규 정책 도입 전후 부서별 성과 변화에 최적입니다.
- 범프 차트(Bump Chart):
시간 경과(예: 분기별, 연도별)에 따른 각 항목의 ‘순위(Rank)’ 변동 경로를 부드러운 곡선으로 추적합니다. 수치의 절대적 크기가 아니라 오직 순위에만 집중하므로, 시장점유율 순위 다툼이나 검색어 순위 변동을 스토리텔링할 때 뛰어난 흡입력을 자랑합니다.
2.4 핵심 요인 집중과 우선순위: “어디에 리소스를 집중할 것인가?”
비즈니스 문제 해결에서 모든 원인을 똑같이 다룰 수는 없습니다. 품질 관리와 프로세스 개선에서 필수적으로 쓰이는 차트가 바로 파레토 차트입니다.
- 파레토 차트 (Pareto Chart):
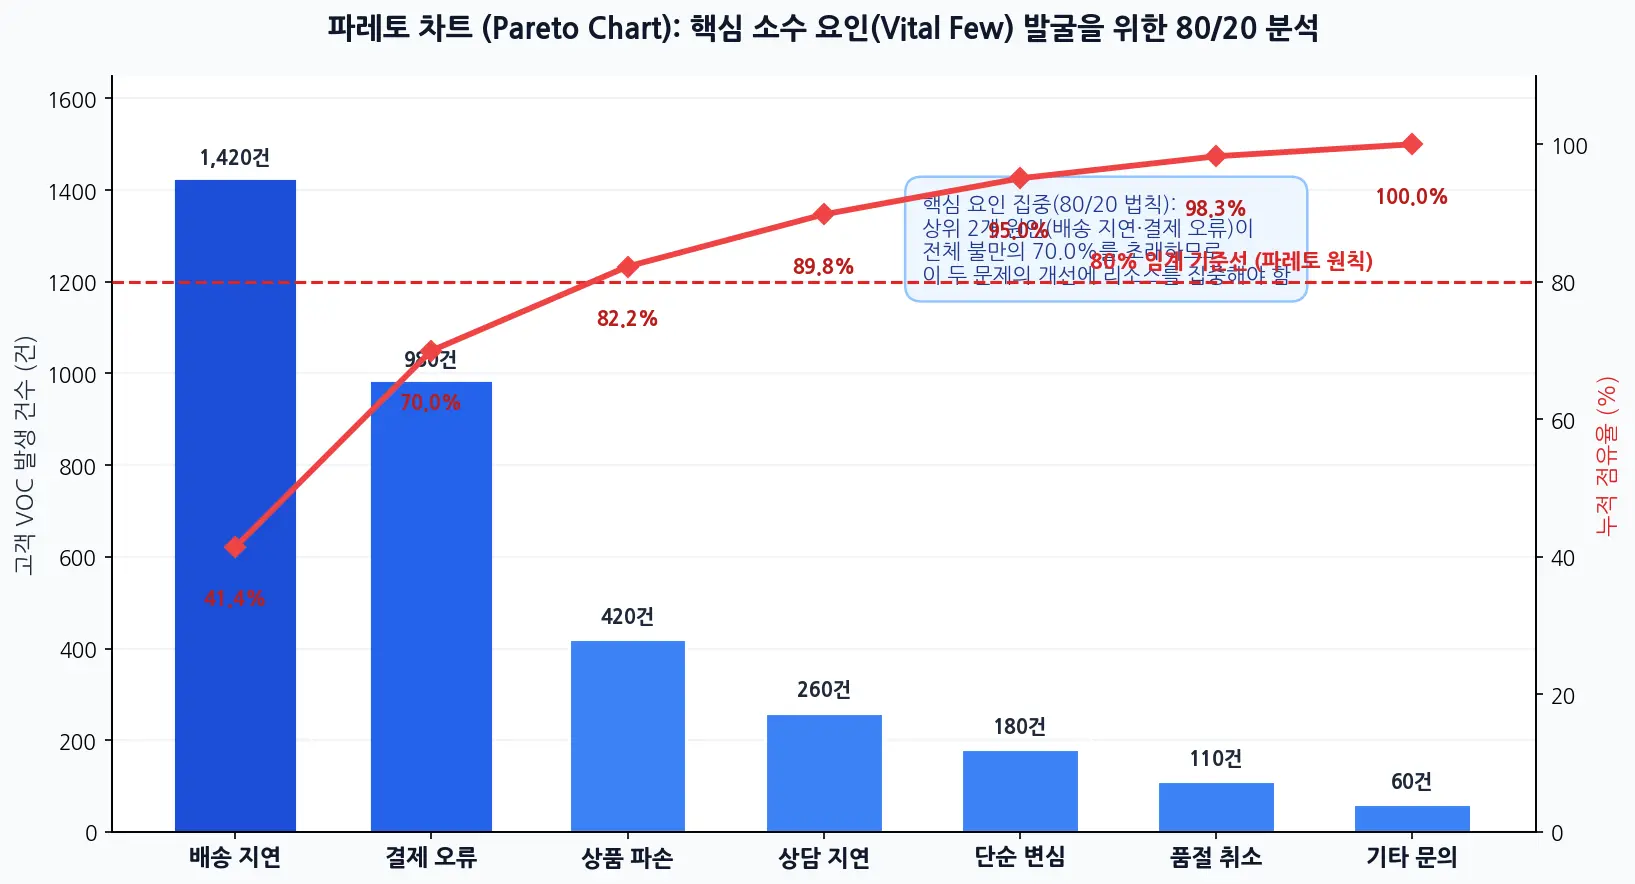
- 왼쪽 축: 원인별 발생 빈도를 내림차순으로 정렬한 막대그래프
- 오른쪽 보조 축: 누적 점유율을 나타내는 꺾은선 그래프
- 핵심 통찰: “상위 20%의 원인이 전체 문제의 80%를 일으킨다”는 파레토 법칙에 기반하여, 80% 누적 점유율 선 아래에 위치한 핵심 소수 요인(Vital Few)을 빠르게 식별할 수 있습니다.
- 위 예시에서는 수많은 고객 VOC 중 ‘배송 지연’과 ’결제 오류’ 단 2가지 항목이 전체 불만의 70%를 차지하므로, 전사 리소스를 어디에 최우선 투입해야 하는지가 명백해집니다.
2.5 구성비와 계층 구조: “전체 중 무엇이 얼마나 차지하는가?”
원형 파이 차트는 3개 이상의 범주를 비교할 때 사람의 눈이 면적과 각도를 정확히 인지하지 못해 심각한 인지 왜곡을 초래합니다. 파이 차트 대신 사용할 수 있는 세련된 대안들을 살펴보겠습니다.
- 트리맵(Treemap):
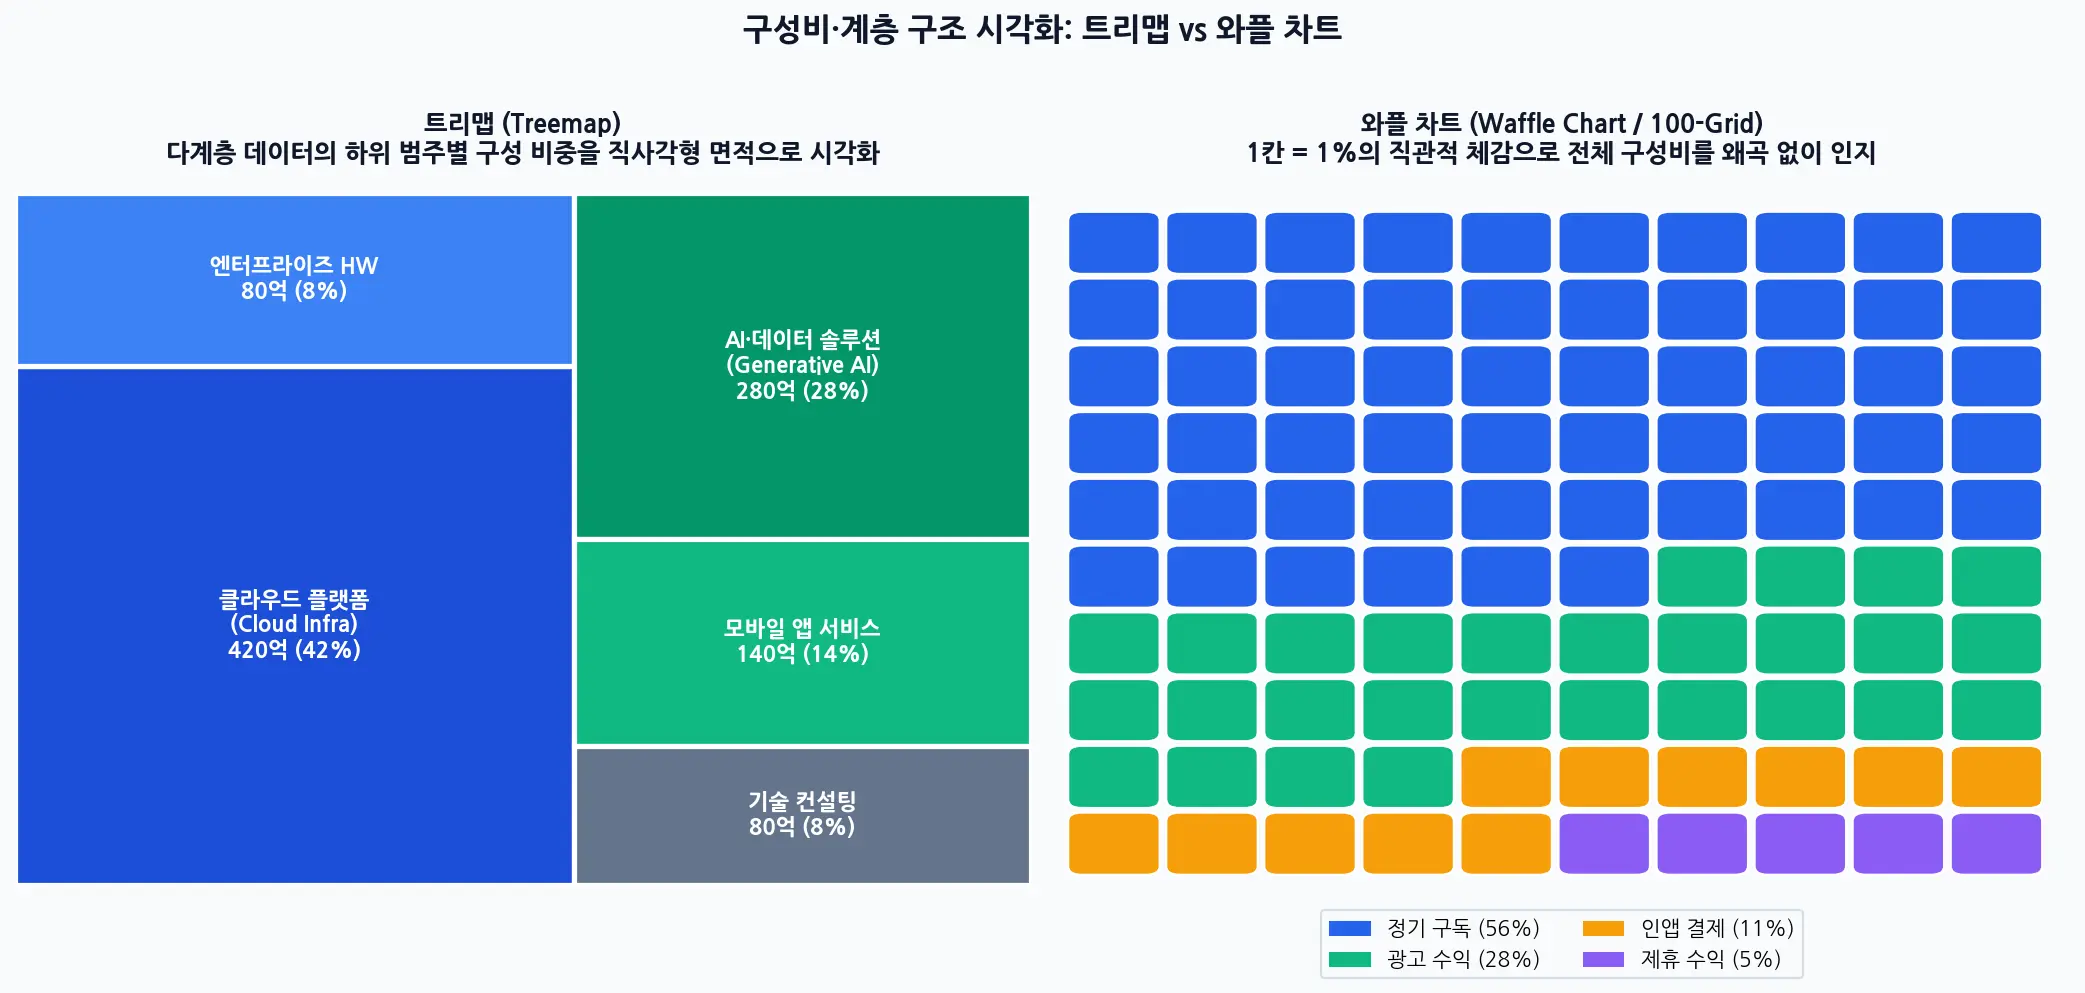
중첩된 직사각형의 면적으로 데이터의 계층적 비중을 인코딩합니다. 수십 개의 하위 제품군이나 예산 항목을 제한된 공간 안에서 일목요연하게 계층별로 조망할 수 있습니다. - 와플 차트(Waffle Chart / 100-Grid):
10x10 총 100개의 작은 사각 그리드로 100%를 표현합니다. ’1칸 = 1%’라는 직관적인 공식이 성립하기 때문에, 숫자를 읽지 않아도 청중이 직관적으로 비율을 체감합니다. 사업 목표 달성률(예: 85% 달성)이나 단순 3~4개 채널별 점유율 보고에 최고의 효과를 냅니다. - 마리메코 차트 (Marimekko / Mekko):
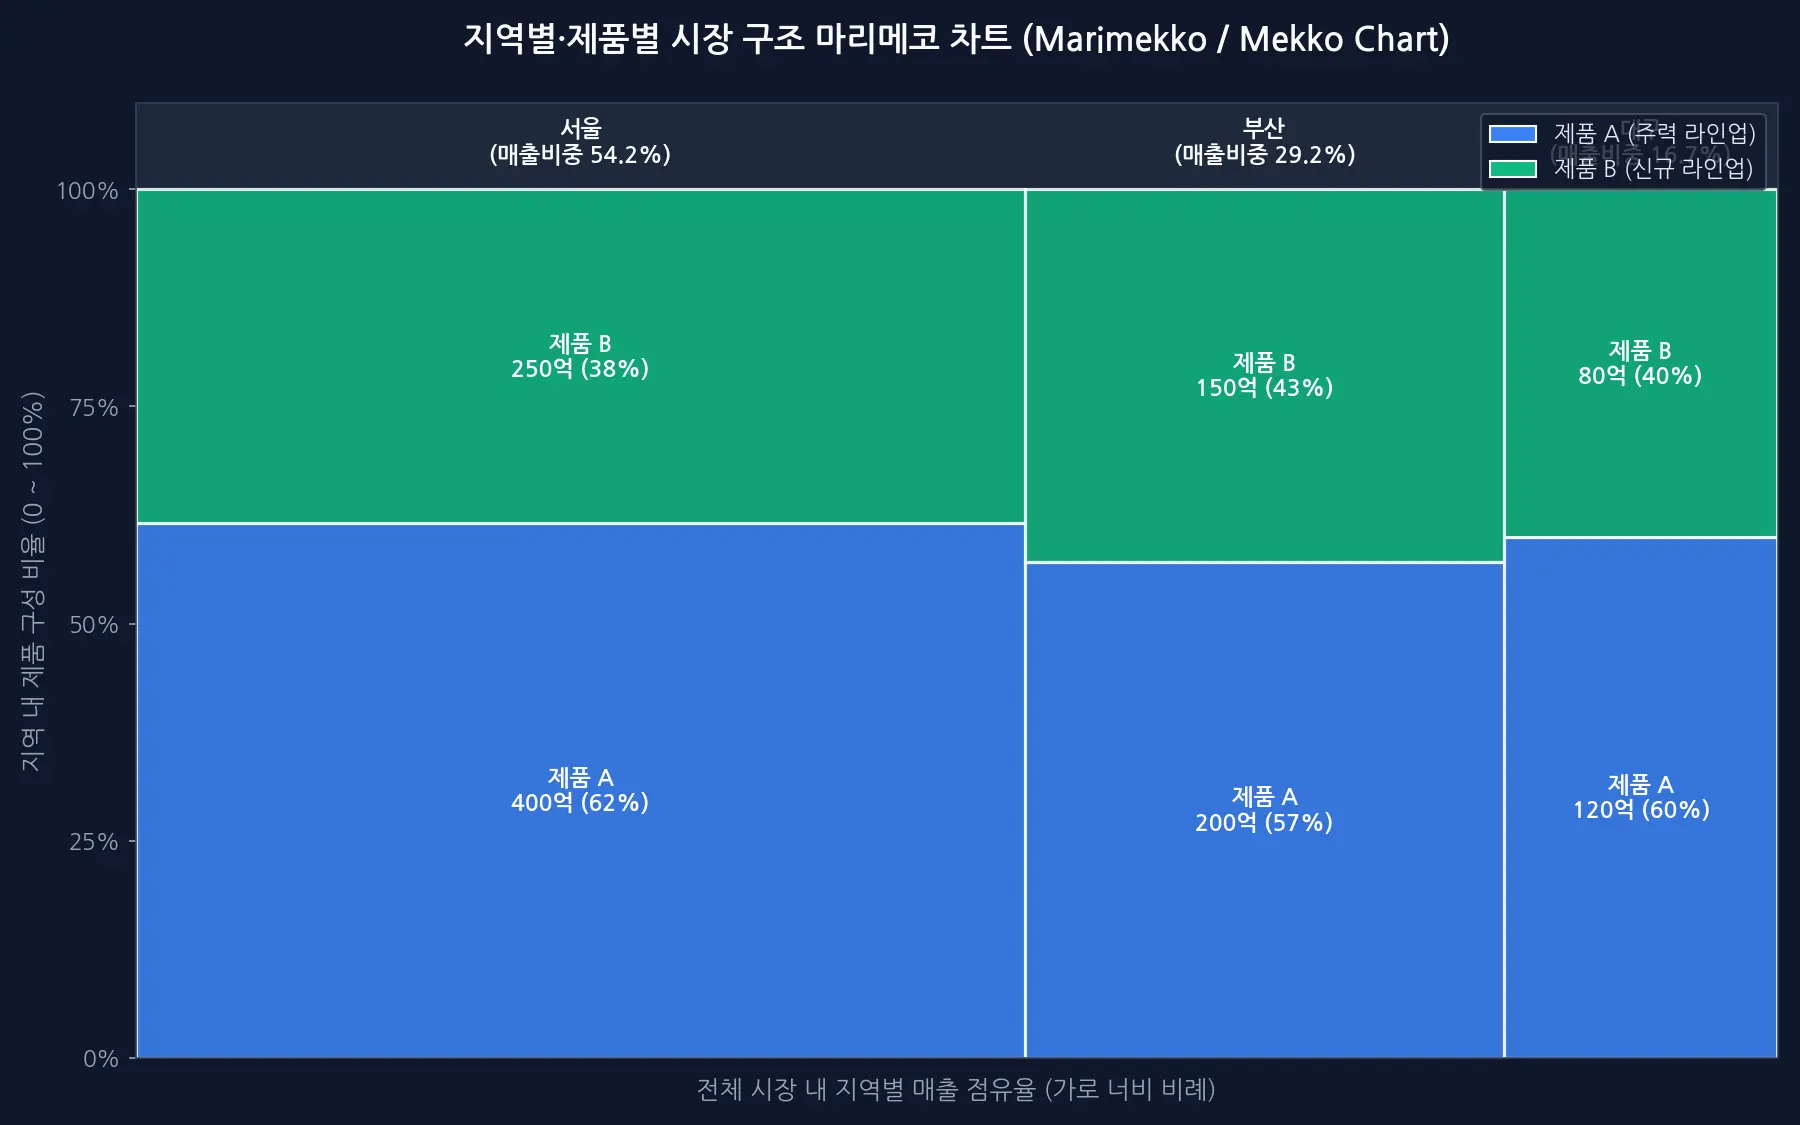
X축의 너비(시장/지역 규모)와 Y축의 높이(제품별 비중)가 모두 가변적인 2차원 구성비 차트입니다. 각 타일의 전체 면적이 실제 매출액 규모를 대변하므로 비즈니스 포트폴리오 분석의 최강자입니다.
2.6 시간 흐름과 증감 기여: “언제 어떻게 변했고, 원인은 무엇인가?”
시계열 데이터를 시각화할 때 일반 꺾은선 외에도 데이터의 성격에 맞는 특수 차트가 필요합니다.
- 폭포수 차트(Waterfall Chart / 손익 브리지):
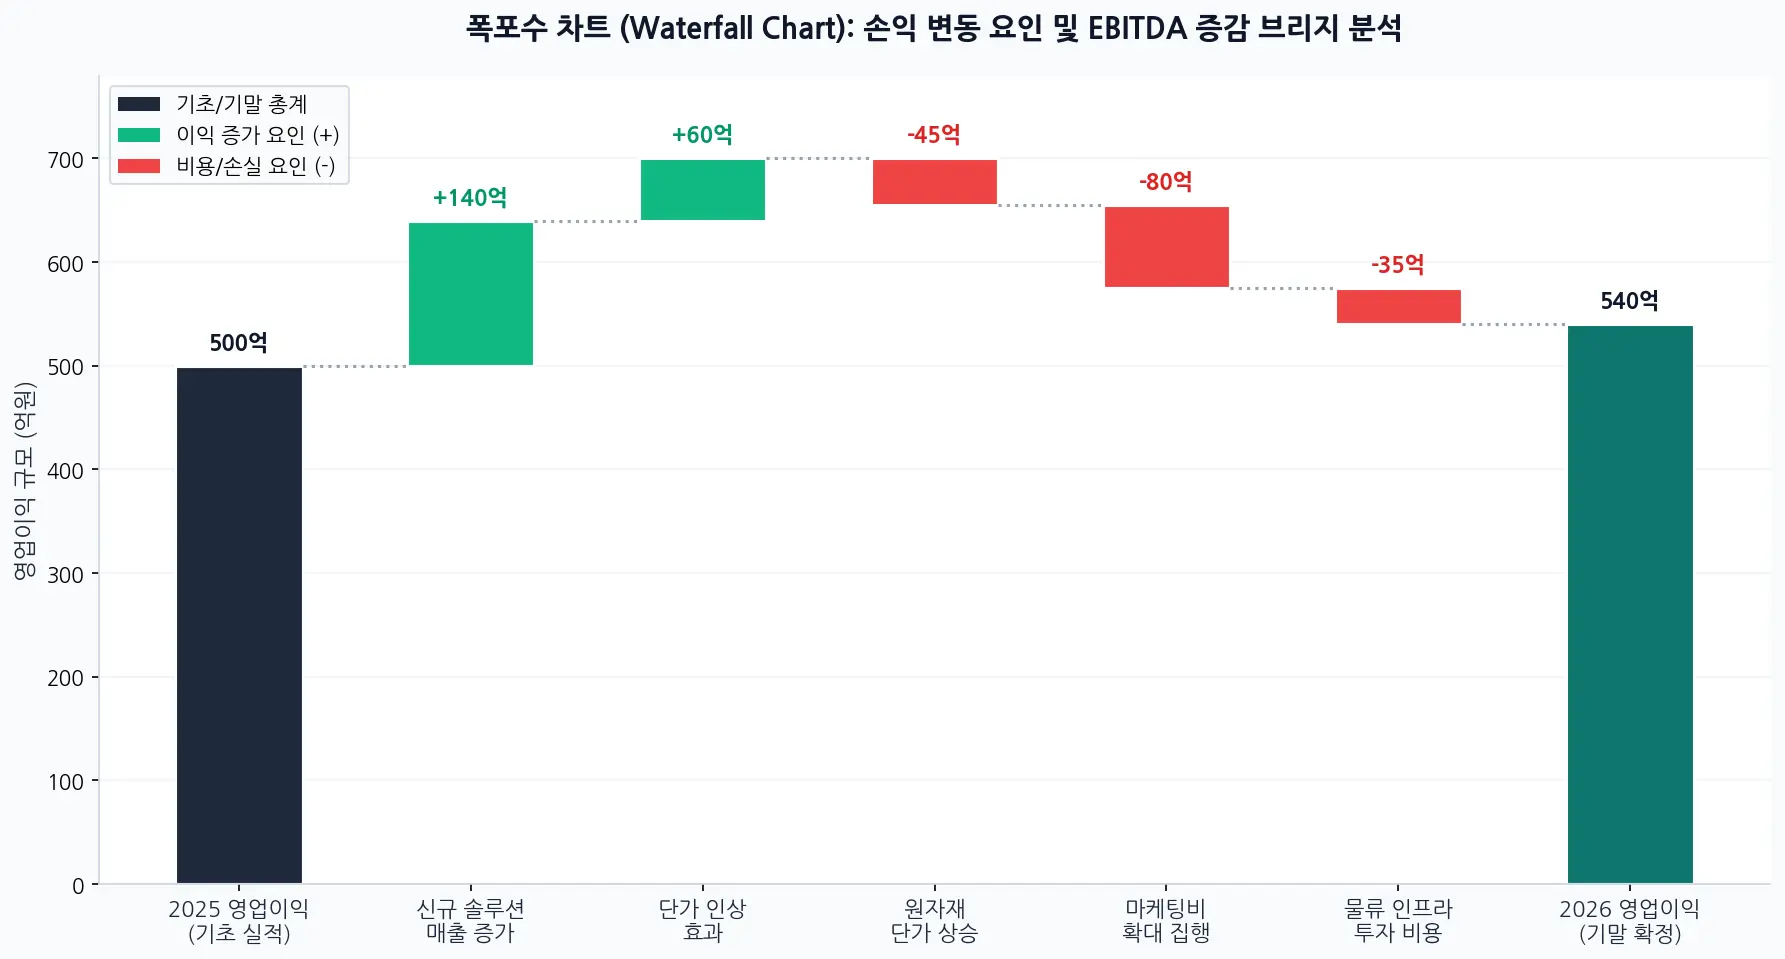
기초 금액(예: 전년도 영업이익 500억)에서 출발하여, 각 요인별 증가분(매출 증가, 단가 인상: 녹색)과 감소분(원자재가 상승, 마케팅비 확대: 붉은색)이 누적되어 최종 기말 금액(570억)으로 귀결되는 과정을 공중에 뜬 기둥 형태로 이어 보여줍니다. 재무 결산 보고의 사실상 표준 차트입니다. - 캘린더 히트맵(Calendar Heatmap):
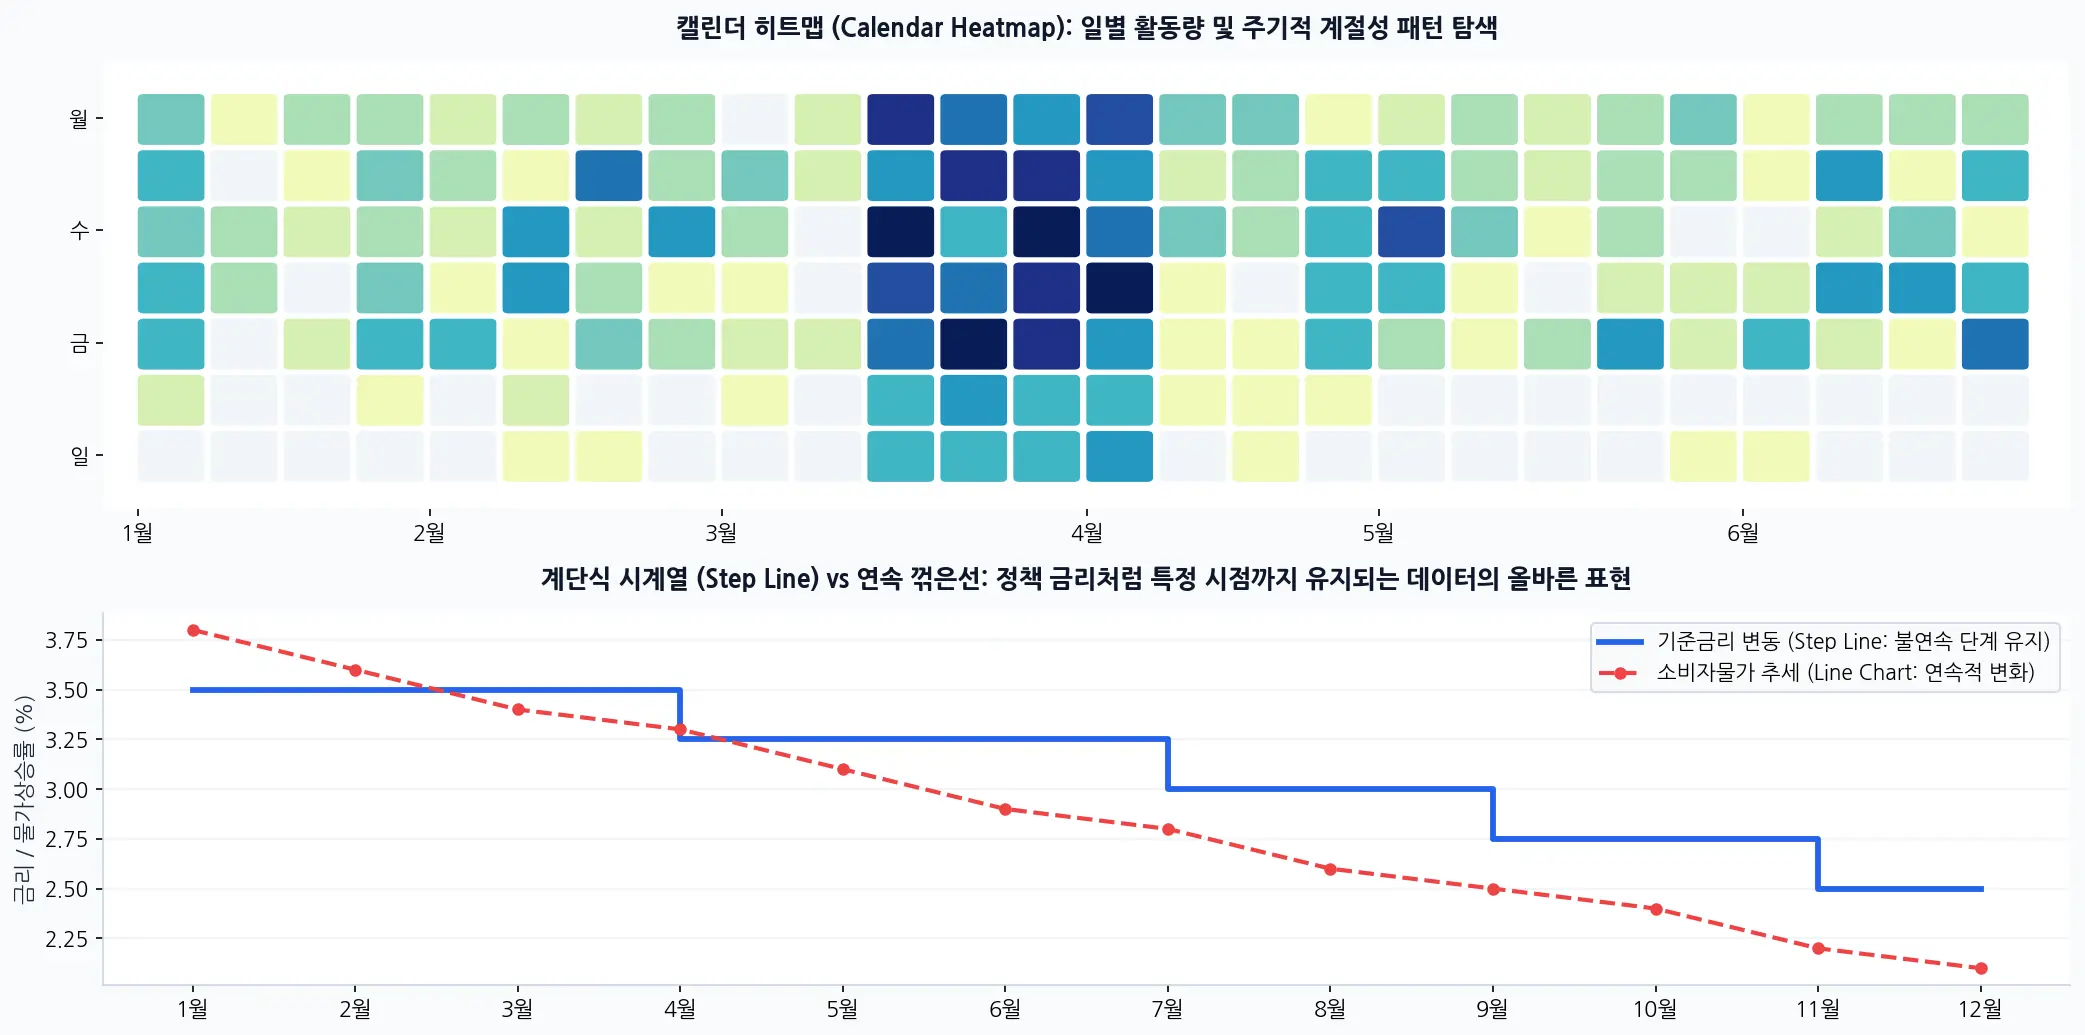
깃허브의 ’잔디 심기’처럼 1년 365일을 요일 x 주차 격자로 배열하여 날짜별 활동량이나 트래픽 밀도를 색상 농도로 표현합니다. 특정 요일이나 특정 계절에 발생하는 주기적 패턴(Seasonality)을 단번에 찾아낼 수 있습니다. - 계단식 시계열(Step Line):
한국은행 기준금리, 제품 가격 책정, 규제 정책 시행처럼 “다음 변동 시점까지 이전 수치가 일정하게 유지되는 불연속적 데이터”를 표현할 때 사용합니다. 일반 선 그래프로 그리면 중간에 서서히 변한 것처럼 심각한 왜곡이 발생하므로 반드시 계단식(Step) 선을 써야 합니다.
2.7 경로 흐름과 전환: “어디서 와서 어디로 빠져나가는가?”
고객의 행동 로그나 웹사이트 유입 경로, 복잡한 에너지 흐름을 추적할 때는 노드 간의 연결성이 중심이 되어야 합니다.
- 샹키 다이어그램(Sankey Diagram):
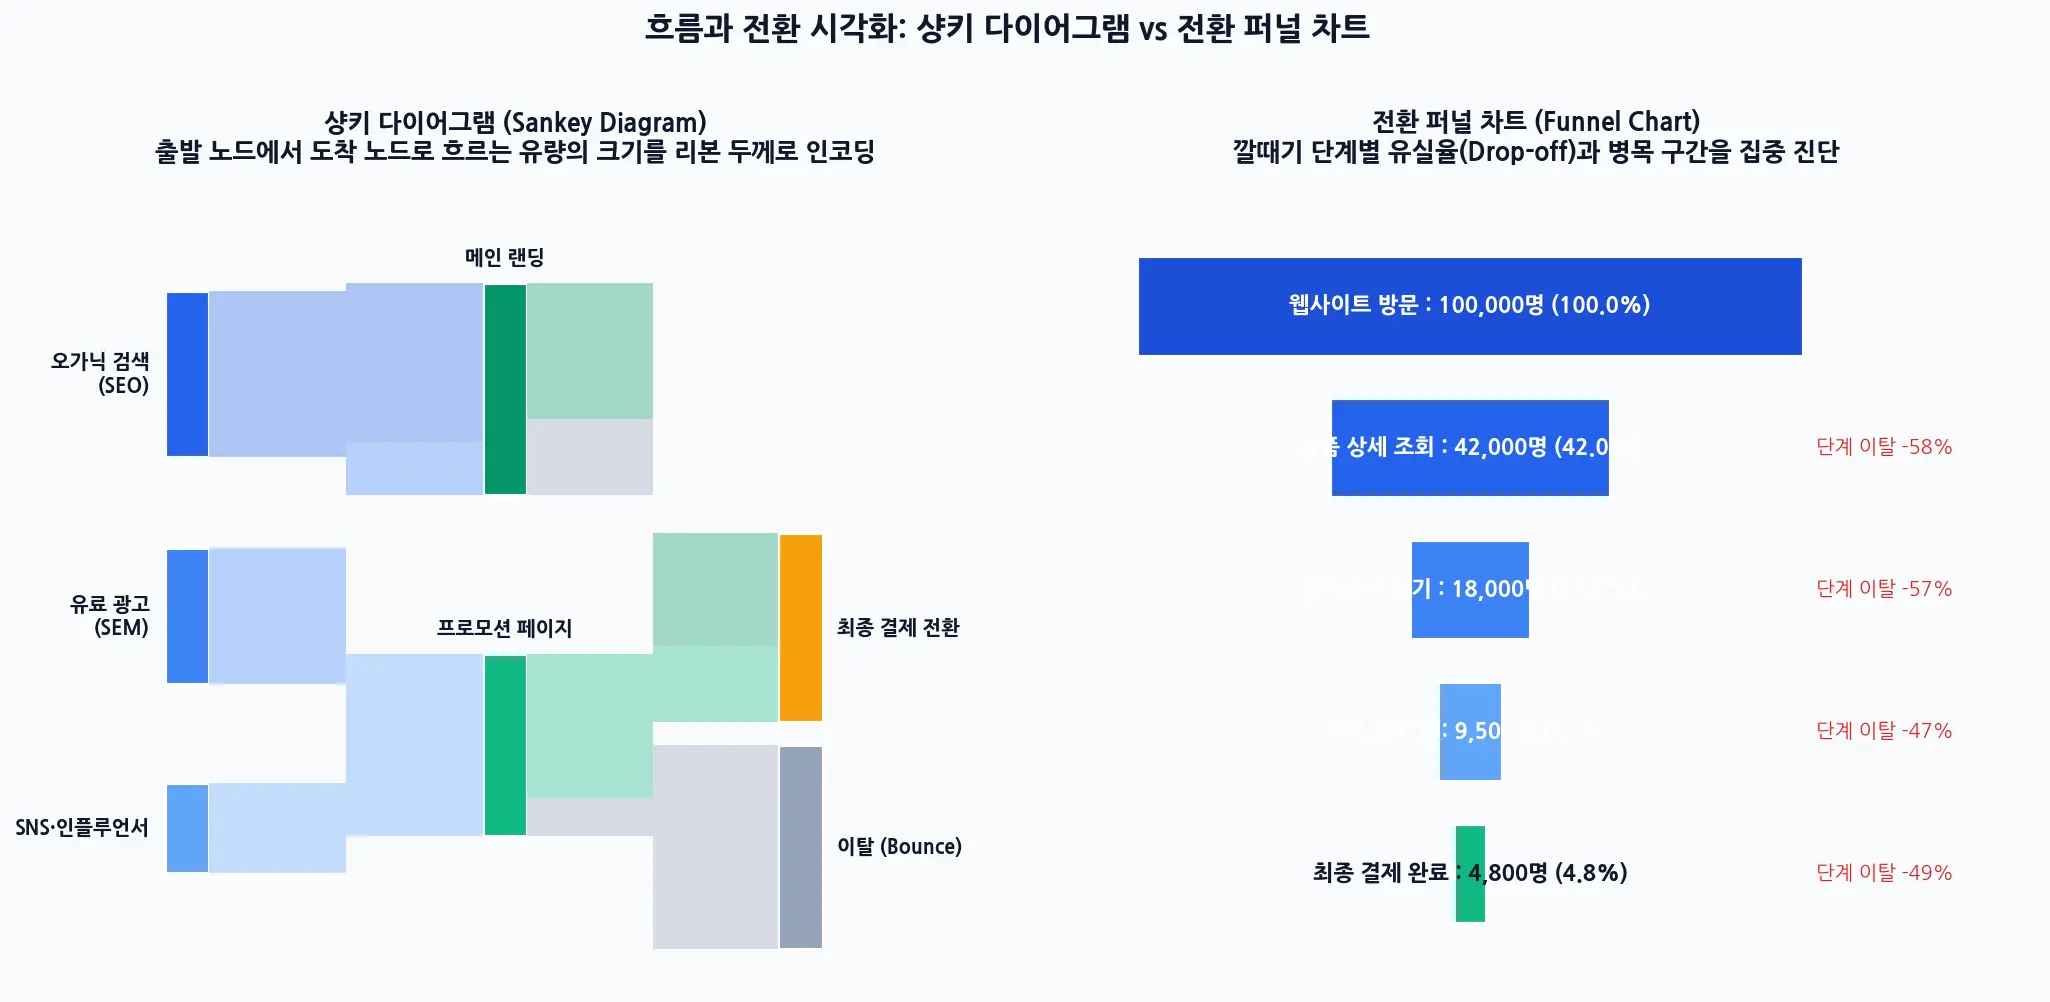
출발 노드(Source)에서 도착 노드(Target)로 이동하는 유량(Volume)의 크기를 연결선(리본)의 두께로 표현합니다.- 마케팅 채널(검색, 광고, SNS)에서 유입된 트래픽이 어떤 랜딩 페이지를 거쳐 최종 결제까지 도달하는지, 혹은 어디서 대규모 이탈이 일어나는지 전체 파이프라인을 조망할 수 있습니다.
- 전환 퍼널 차트(Funnel Chart):
선형적인 단계(방문 → 상세페이지 조회 → 장바구니 → 주문서 작성 → 결제 완료)를 거치며 사용자가 단계별로 얼마나 떨어져 나가는지(Drop-off)를 깔때기 형태로 보여줍니다. 어느 단계가 가장 큰 병목(Bottleneck)인지 즉시 진단할 수 있습니다.
2.8 공간 데이터: “어느 지역에 위험과 기회가 집중되어 있는가?”
지도 위에 데이터를 얹을 때 가장 저지르기 쉬운 치명적인 실수가 바로 단순 절대 건수로 색을 칠하는 것입니다.
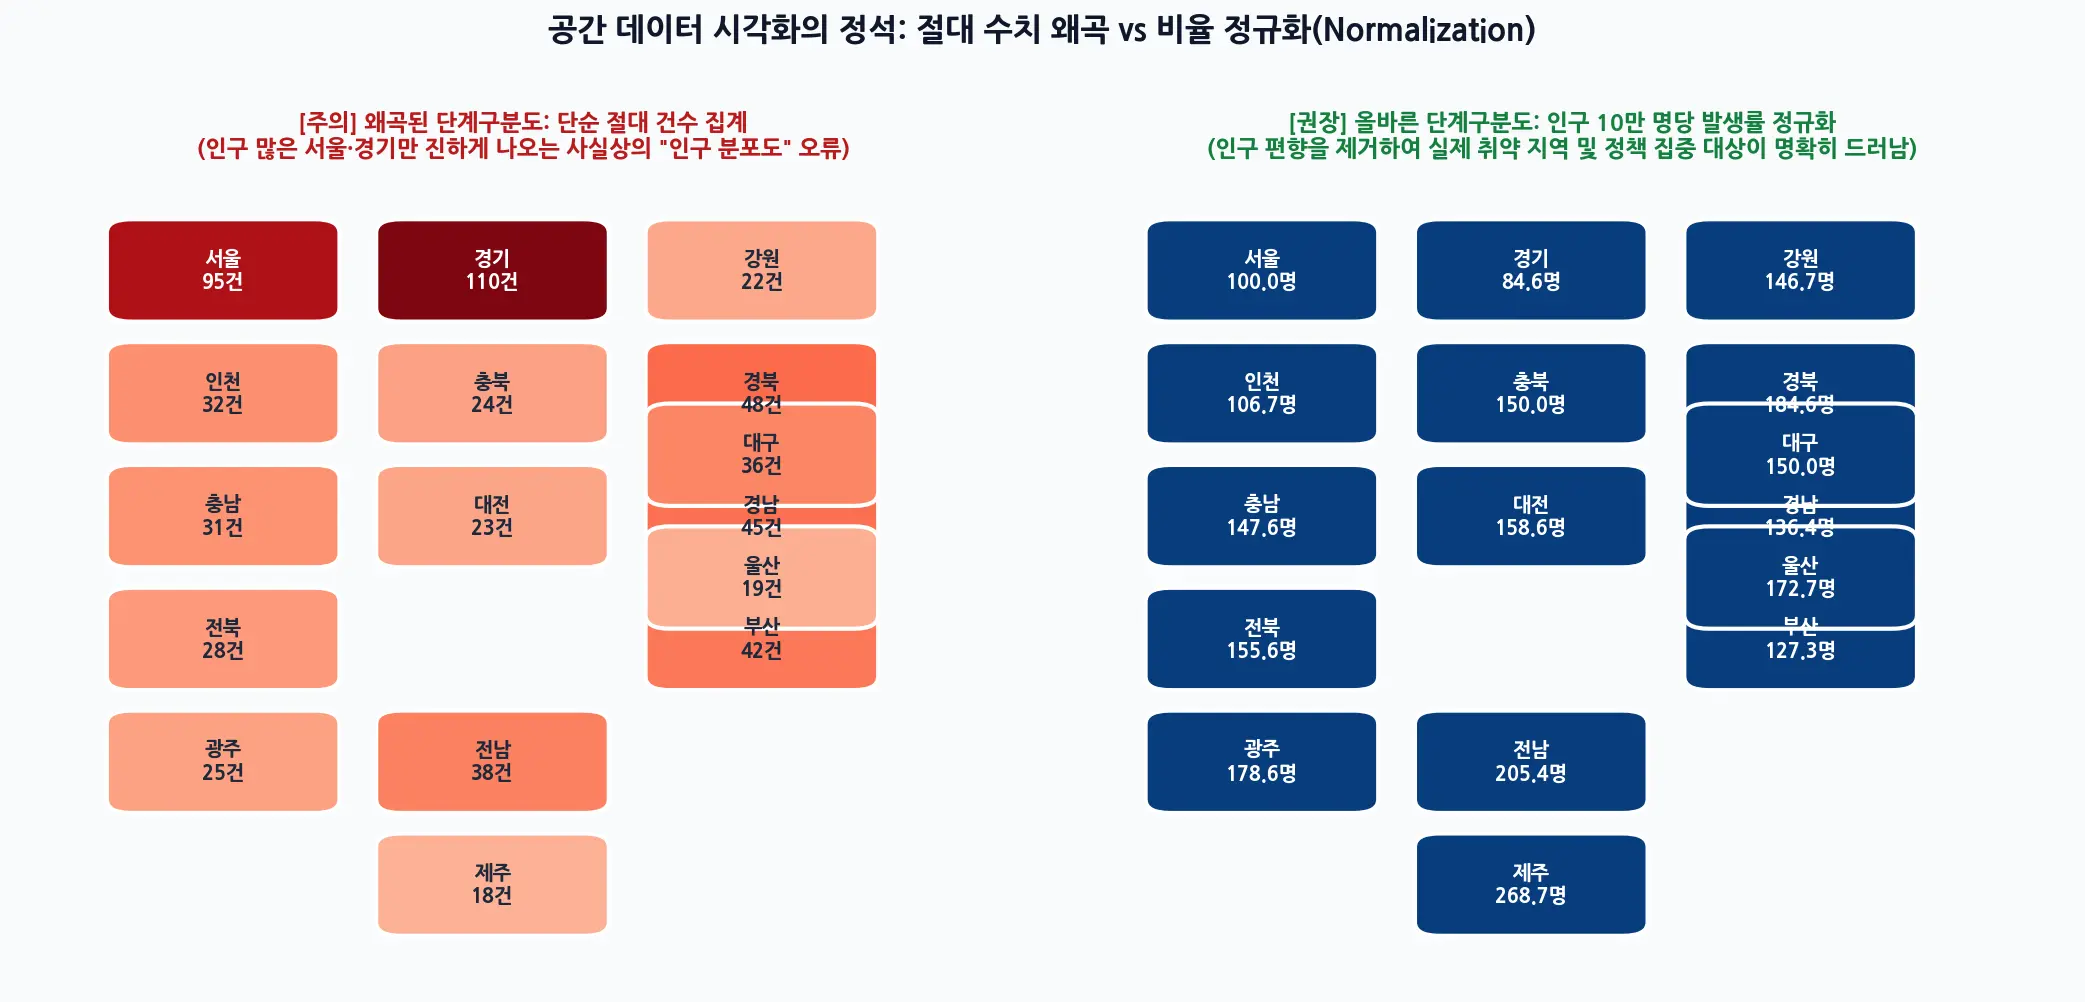
[!WARNING] 지도 시각화의 치명적 함정: 인구 지도(Population Map)의 오류
- 왼쪽 주의 사례: 코로나 확진자 수나 범죄 발생 건수를 단순 총량으로 단계구분도에 칠하면, 사건 발생 위험도와 상관없이 단순히 사람이 많이 사는 서울·경기만 새까맣게 칠해집니다. 이는 사건 지도가 아니라 ’한국 인구 밀집 지도’를 다시 그린 것에 불과합니다. - 오른쪽 권장 사례: 반드시 분모에 인구를 반영하여 ‘인구 10만 명당 발생률’, 혹은 ‘면적당 밀도’로 정규화(Normalization)해야만 행정구역 크기나 인구수에 얽매이지 않고 실제 위험 지역을 객관적으로 판별할 수 있습니다.
3. 실무 심층 비교: 모자이크 vs 마리메코 vs 히트맵의 결정적 차이
실무 데이터 분석가들이 가장 많이 헷갈려하는 3가지 다차원 범주 차트의 차이점을 표와 원리로 명쾌하게 정리합니다.
| 비교 기준 | 히트맵 (Heatmap) | 모자이크 플롯 (Mosaic Plot) | 마리메코 차트 (Marimekko) |
|---|---|---|---|
| X축 너비 | 동일 고정 (모든 열 너비 같음) | 비례 가변 (X 범주 전체 빈도에 비례) | 비례 가변 (사업부/시장 전체 규모에 비례) |
| Y축 높이 | 동일 고정 (모든 행 높이 같음) | 비례 가변 (X 범주 내 조건부 상대빈도) | 비례 가변 (그룹 내 세부 제품별 구성비) |
| 값의 인코딩 | 색상의 진하기 (Color Intensity) | 타일의 면적 (Tile Area) | 타일의 면적 (Tile Area) |
| 최적 활용 목적 | 시간대x요일 트래픽 패턴, 상관행렬 탐색 | 두 범주형 변수의 통계적 독립성 검정 | 사업부별 매출액 규모 및 포트폴리오 비중 |
- 히트맵: 행과 열의 그리드 규격은 완전히 균일하며, 셀 안의 숫자가 얼마나 큰지를 오직 ’색상의 명도·채도’로 전달합니다.
- 모자이크 플롯: 통계학적 관점에서 두 범주형 변수 간의 결합 분포(Joint Distribution)를 나타내며, 만약 두 변수가 완전히 독립이라면 모든 열의 가로선 높이가 평행을 이룹니다.
- 마리메코 차트: 모자이크 플롯의 비즈니스 응용형으로, 가로축은 시장/부서 규모를 나타내고 세로축은 마진율이나 제품 비중을 나타내어 면적 전체가 절대 금액을 상징합니다.
4. R ggplot2 실전 시각화 구현 코드
4.1 실전 덤벨 차트 (Dumbbell Chart) 구현
library(ggplot2)
library(dplyr)

# 가상 데이터 생성: 부서별 전년 대비 금년 성과
df_dumbbell <- data.frame(
  dept = paste("부서", LETTERS[1:10]),
  last_year = c(45, 52, 38, 65, 70, 42, 58, 60, 35, 80),
  this_year = c(60, 48, 55, 78, 68, 59, 72, 65, 50, 92)
) %>%
  mutate(diff = this_year - last_year) %>%
  arrange(this_year) %>%
  mutate(dept = factor(dept, levels = dept))

# 덤벨 차트 렌더링
ggplot(df_dumbbell) +
  # 1. 두 점을 잇는 베이스 연결선
  geom_segment(aes(x = last_year, xend = this_year, y = dept, yend = dept),
               color = "#cbd5e1", linewidth = 1.2) +
  # 2. 전년도 실적 점 (회색)
  geom_point(aes(x = last_year, y = dept), color = "#94a3b8", size = 4) +
  # 3. 금년도 실적 점 (상승/하락 조건부 색상 적용)
  geom_point(aes(x = this_year, y = dept, color = diff > 0), size = 4.5) +
  scale_color_manual(values = c("TRUE" = "#2563eb", "FALSE" = "#ef4444"),
                     labels = c("하락", "상승"), name = "변동 추세") +
  labs(
    title = "부서별 연간 실적 변동 비교 (Dumbbell Chart)",
    subtitle = "회색: 전년 실적 | 청색/적색: 금년 실적 및 증감 방향",
    x = "달성 실적 (점)", y = ""
  ) +
  theme_minimal(base_family = "NanumGothic") +
  theme(
    legend.position = "top",
    panel.grid.minor = element_blank(),
    axis.text = element_text(size = 11, face = "bold")
  )
4.2 실전 마리메코 차트 (Marimekko Chart) 구현
library(ggplot2)
library(dplyr)

df_mekko <- data.frame(
  region  = c("서울", "서울", "부산", "부산", "대구", "대구"),
  product = c("제품 A", "제품 B", "제품 A", "제품 B", "제품 A", "제품 B"),
  sales   = c(400, 250, 200, 150, 120, 80)
)

# 1. 지역별 전체 매출 비중에 따른 X축 너비 계산
region_summary <- df_mekko %>%
  group_by(region) %>%
  summarise(region_total = sum(sales)) %>%
  mutate(
    x_end = cumsum(region_total) / sum(region_total),
    x_start = lag(x_end, default = 0)
  )

# 2. 지역 내 제품별 비율(Y축 높이) 계산 및 좌표 병합
df_plot <- df_mekko %>%
  group_by(region) %>%
  mutate(
    reg_sum = sum(sales),
    y_end = cumsum(sales) / reg_sum,
    y_start = lag(y_end, default = 0)
  ) %>%
  left_join(region_summary, by = "region")

# 3. geom_rect를 이용한 마리메코 차트 출력
ggplot(df_plot, aes(xmin = x_start, xmax = x_end, ymin = y_start, ymax = y_end, fill = product)) +
  geom_rect(color = "white", linewidth = 0.8) +
  geom_text(aes(x = (x_start + x_end)/2, y = (y_start + y_end)/2,
                label = paste0(product, "\n", sales, "억")),
            size = 3.5, fontface = "bold", color = "white") +
  scale_x_continuous(
    breaks = (region_summary$x_start + region_summary$x_end) / 2,
    labels = region_summary$region
  ) +
  scale_y_continuous(labels = scales::percent_format()) +
  scale_fill_manual(values = c("제품 A" = "#3b82f6", "제품 B" = "#10b981")) +
  labs(
    title = "지역별·제품별 시장 매출 구조 (Marimekko Chart)",
    subtitle = "가로 너비 = 지역별 매출 점유율 | 세로 높이 = 제품별 판매 비중",
    x = "지역 (너비 비례)", y = "제품 비중"
  ) +
  theme_minimal(base_family = "NanumGothic")
5. 데이터 시각화 왜곡 방지 실무 체크리스트 5선
배포 직전, 내 대시보드와 차트가 독자에게 거짓말을 하고 있지 않은지 다음 5가지를 점검하세요.
[!TIP] 1. 막대 차트의 기준선이 반드시 0(Zero baseline)에서 시작하는가?
막대의 본질은 ’길이와 면적’입니다. Y축 밑동을 잘라내어 90~100 구간만 확대하면 1%의 미세한 차이가 마치 10배 격차인 것처럼 악의적인 왜곡을 낳습니다. (단, 변동폭 자체를 관찰하는 선 그래프는 예외적으로 유효 범위를 설정할 수 있습니다.) 2. 비교 패널(Facet) 간의 축 스케일(Scale)이 동일하게 고정되었는가?
스몰 멀티플로 여러 하위 그룹을 나열할 때 축 범위가 제각각이면 시각적 높낮이 비교가 완전히 무력화됩니다. 3. 지도 시각화에서 총량이 아닌 ’비율’로 정규화했는가?
인구 가중치를 고려하지 않은 단계구분도는 단순한 인구 밀집도 복사본에 불과합니다. 4. 색각 이상(Color Vision Deficiency)을 배려한 안전 팔레트인가?
적록 색맹 청중을 위해 순수 빨강-초록의 대비를 피하고,Viridis,ColorBrewer, 청색-주황색 계열의 안전한 대비를 채택하세요. 5. 데이터 잉크 비율(Data-Ink Ratio)이 최적화되었는가?
불필요하게 짙은 배경 눈금선, 3D 입체 효과, 의미 없는 무지개색 채색을 걷어내고 데이터 포인트 자체에 시선이 꽂히게 만드세요.
6. 데이터 시각화 FAQ: 실무에서 가장 많이 묻는 질문
Q1. 파이 차트(원형 그래프)는 실무에서 아예 쓰면 안 되나요?
A: 완전히 금지된 것은 아니지만 “범주가 2~3개 이하이고, 한 범주가 50% 이상을 차지하는 극단적으로 단순한 구성”일 때만 제한적으로 허용됩니다. 범주가 5개만 넘어가도 사람이 각도와 부채꼴 면적을 비교하지 못해 라벨 없이는 대소 비교가 불가능해집니다. 대부분의 경우 100% 누적 가로 막대나 와플 차트가 훨씬 우수한 대안입니다.
Q2. 한 차트에 축이 2개인 이중 축(Dual Axis) 그래프는 왜 권장하지 않나요?
A: 좌측 축(예: 매출액 억원)과 우측 축(예: 이익률 %)의 스케일 비율을 작성자가 어떻게 조정하느냐에 따라 두 선의 교차점과 기울기가 완전히 임의로 조작될 수 있기 때문입니다. 청중은 두 선이 교차할 때 “매출과 이익률이 역전되었다”는 식의 인지적 착각에 빠지기 쉽습니다. 상하 2개의 분할 패널(Facet)로 분리하거나 산점도를 사용하는 것이 정석입니다.
Q3. 범주형 항목이 20개가 넘을 때 가장 좋은 차트는 무엇인가요?
A: 세로 막대그래프는 항목 이름이 대각선으로 꺾여 목을 기울여 읽어야 하므로 가독성이 급락합니다. 항목명을 가로로 똑바로 읽을 수 있는 ‘정렬된 수평 가로 막대(Horizontal Bar)’ 또는 ‘롤리팝 차트’를 사용하고, 값의 크기순으로 내림차순 정렬해야 합니다.
Q4. 데이터가 너무 많아서 산점도가 온통 까맣게 뭉개집니다. 해결책은?
A: 오버플로팅(Overplotting) 현상입니다. 1단계로 점의 크기를 줄이고 투명도(alpha=0.1~0.3)를 적용합니다. 그래도 뭉개진다면 육각 격자로 빈도를 집계하는 2D 헥스빈(Hexbin)이나 2D 밀도 등고선(Contour Plot)으로 전환해야 합니다.
Q5. 차트에 어떤 색상을 써야 전문적으로 보이나요?
A: 색상을 ’장식’이 아니라 ’데이터 인코딩 도구’로 대해야 합니다. 기본 배경과 덜 중요한 데이터는 채도가 낮은 회색조(Slate/Gray)로 깔고, 강조하고 싶은 핵심 집단이나 이상치 1~2개에만 선명한 브랜드 컬러(블루, 틸, 오렌지)를 포인트로 부여하는 것이 실무 데이터 스토리텔링의 핵심 원칙입니다.
7. 마치며
데이터 시각화의 궁극적인 목적은 차트를 아름답게 꾸미는 예술이 아닙니다.
“복잡한 숫자의 이면에 숨겨진 통계적 진실을 청중의 뇌리에 가장 왜곡 없이, 가장 빠르게 전달하는 것”입니다.
지금 마주하고 있는 데이터를 들여다보세요.
그리고 “내가 무엇을 증명하려 하는가?”라는 질문에서 출발하여 본 가이드의 8대 의사결정 체계와 실전 차트들을 적용해 보시기 바랍니다. 데이터가 전달하는 메시지의 힘이 완전히 달라질 것입니다.
참고문헌 및 권위 출처
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3-28. https://doi.org/10.1198/jcgs.2009.07098
- Schwabish, J. (2021). Better Presentations: A Guide for Scholars, Researchers, and Wonks. Columbia University Press. https://policyviz.com/better-presentations/