flowchart LR
    A["원시 시계열 데이터<br/>(추세, 계절성, 분산 변동)"] --> B{"정상성(Stationarity) 평가<br/>ADF & KPSS 단위근 검정"}
    B -- "비정상 (단위근 존재)" --> C["정상화 변환<br/>1. 로그/Box-Cox (분산 안정화)<br/>2. 차분 diff() (추세/계절 제거)"]
    C --> B
    B -- "정상 시계열 달성" --> D["ACF / PACF 패턴 분석<br/>(절단 vs 감쇄 지문 식별)"]
    D --> E["ARIMA / SARIMA 적합<br/>auto.arima() & Arima()"]
    E --> F{"잔차 백색잡음 진단<br/>Ljung-Box Test (p > 0.05)"}
    F -- "잔차에 패턴 잔존" --> D
    F -- "백색잡음 통과" --> G["최종 미래 예측 & 신뢰대 산출<br/>forecast() & ETS 비교"]

    style A fill:#F1F5F9,stroke:#64748B,stroke-width:1.5px
    style B fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style C fill:#FEE2E2,stroke:#DC2626,stroke-width:1.5px
    style D fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style E fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style F fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style G fill:#DCFCE7,stroke:#16A34A,stroke-width:2px
💡 핵심 요약 (Executive Summary):
- 시계열의 대전제, 정상성(Stationarity): 시계열 예측 모델(ARIMA 등)은 데이터의 통계적 특성이 시간에 따라 변하지 않는다는 약정상성(평균 불변, 분산 불변, 자기공분산 시차 종속)을 전제로 합니다. 현실의 데이터는 대부분 비정상이므로, 차분(Differencing)으로 추세를 제거하고 로그/박스콕스 변환으로 분산을 안정화해야 합니다.
- 단위근 검정의 교차 검증: ADF 검정(\(H_0\): 비정상/단위근 존재)과 KPSS 검정(\(H_0\): 정상 시계열)을 반드시 병행하여 두 검정 결과가 교차 일치할 때까지 차수 \(d\)를 탐색해야 과대차분(Over-differencing)을 예방할 수 있습니다.
- Box-Jenkins 4단계 파이프라인: (1) 정상화 및 ACF/PACF를 통한 모형 차수 식별(Identification) \(\to\) (2) 최대우도법 기반 모수 추정(Estimation) \(\to\) (3) Ljung-Box 검정을 통한 잔차 백색잡음 진단(Diagnostics) \(\to\) (4) 사후 검증 및 미래 점·구간 예측(Forecasting)의 순환 루프를 엄격히 준수해야 합니다.
- ACF & PACF 지문(Fingerprint) 해독: 자기상관함수(ACF)가 \(q\) 시차 후 절단되면 \(\mathrm{MA}(q)\), 편자기상관함수(PACF)가 \(p\) 시차 후 절단되면 \(\mathrm{AR}(p)\), 둘 다 점진적으로 감쇄하면 \(\mathrm{ARMA}(p, q)\)로 식별합니다.
- ARIMA vs 지수평활법(ETS): 복잡한 자기상관 동역학을 모델링하고 원인을 규명할 때는 ARIMA, 직관적인 추세와 계절성을 빠르게 반영하여 단기 예측력을 극대화할 때는 지수평활법(ETS: Simple, Holt, Holt-Winters)이 실무적 최선의 선택입니다.
0. “왜 시계열 데이터에 일반 머신러닝을 무작정 돌리면 망하는가?”
데이터 분석 실무에서 가장 흔하게 발생하는 참극 중 하나는, 날짜와 시간 순서가 있는 데이터를 일반 회귀분석이나 랜덤 포레스트, XGBoost에 무작정 밀어 넣고 \(R^2 = 0.98\)이라는 가짜 성능에 환호하는 것입니다.
두 개의 무관한 시계열(예: 한국의 1인당 GDP와 대서양의 고래 개체수)을 단순 OLS 회귀분석하면 \(R^2\)가 0.9를 넘고 \(p < .0001\)로 매우 유의하게 나오는 경우가 허다합니다. 이를 계량경제학에서는 가짜 회귀(Spurious Regression)라고 부릅니다.
시계열 데이터는 일반적인 독립 항등 분포(i.i.d.) 가정을 근본적으로 위배합니다. 오늘의 관측치는 어제의 관측치에 강하게 얽혀 있으며(시간적 자기상관), 과거의 패턴이 미래로 전이됩니다. 시계열 모델링이란 바로 이 ’자기상관(Autocorrelation)의 시간 구조’를 과학적으로 분해하고 수식화하는 과정입니다.
1. 시계열의 대전제: 정상성(Stationarity)의 3대 조건
시계열을 예측하기 위한 모든 고전적 통계 기법(ARMA, ARIMA)은 대상 시계열이 정상성(Stationarity)을 만족한다는 가설 위에서만 작동합니다.
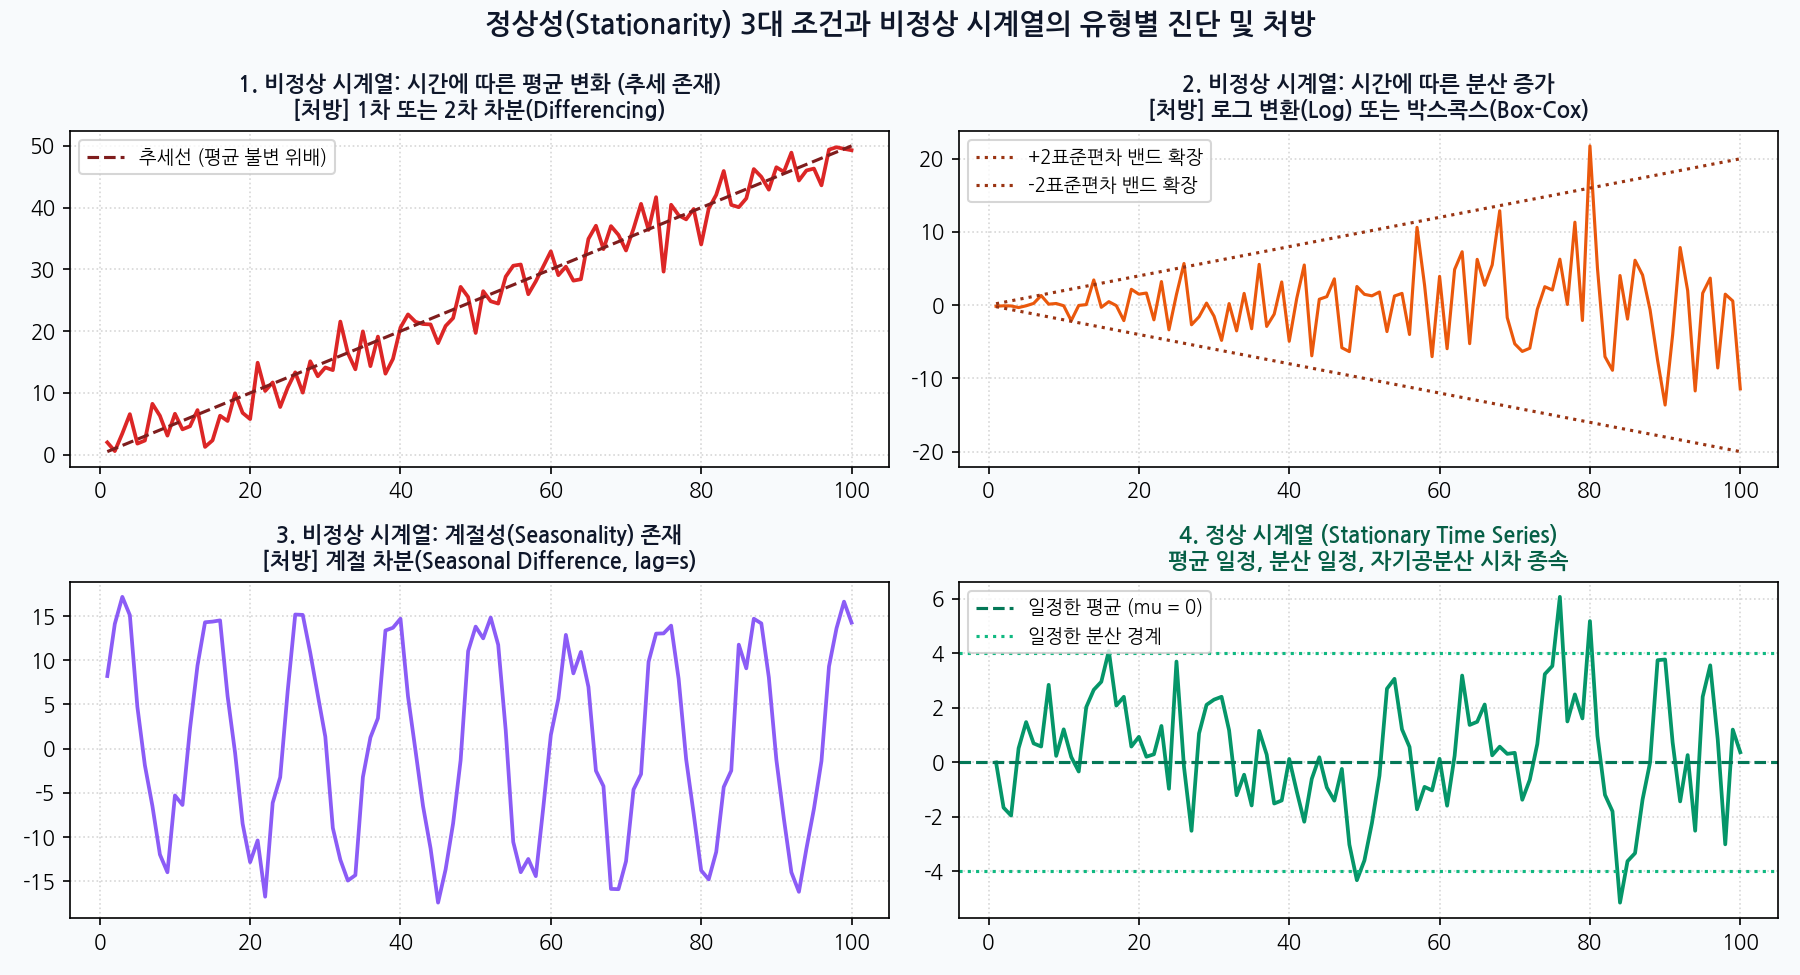
1-1. 약정상성(Weak Stationarity)의 수학적 조건
엄격한 의미의 강정상성(모든 결합분포가 시간 불변)은 현실에서 불가능하므로, 통계학에서는 다음 세 가지 조건을 만족하는 약정상성(Covariance Stationarity)을 기본으로 채택합니다.
- 평균의 시간 불변: \(\mathbb{E}(y_t) = \mu \quad (\forall t)\)
시간이 흘러도 시계열의 중심값(평균)은 변하지 않고 일정한 수평선을 유지해야 합니다. (추세가 없어야 함) - 분산의 시간 불변: \(\mathrm{Var}(y_t) = \sigma^2 < \infty \quad (\forall t)\)
시간의 흐름에 따라 시계열의 진폭(변동폭)이 커지거나 작아지지 않아야 합니다. - 자기공분산의 시차 종속: \(\mathrm{Cov}(y_t, y_{t+k}) = \gamma_k \quad (\forall t, k)\)
임의의 두 시점 사이의 공분산은 절대적인 관측 시점 \(t\)가 아니라, 오직 두 관측치 사이의 시간 간격(시차, \(k\))에 의해서만 결정되어야 합니다.
1-2. 비정상 시계열을 정상화하는 2대 무기
현실의 주가, 매출, 전력 소비량 데이터는 99% 비정상 시계열입니다. 따라서 모델링 전 반드시 정상화(Stationarization) 변환을 거쳐야 합니다.
[비정상 증상]                               [처방 및 변환 기법]
시간에 따라 변동폭(분산)이 커짐  ──▶  로그 변환(Log) 또는 박스콕스(Box-Cox) 변환
시간에 따라 우상향/우하향 추세 존재 ──▶  1차 일반 차분: ∇y_t = y_t - y_{t-1}
주기적 계절 패턴(월별/분기별) 존재 ──▶  계절 차분: ∇_s y_t = y_t - y_{t-s} (s=12, 4)
1-3. 단위근 검정 쌍두마차: ADF vs KPSS
시계열이 정상인지 비정상인지 눈대중으로만 판단하면 큰 코를 다칩니다. 객관적인 수치 가설검정을 수행해야 합니다.
| 구분 | ADF 검정 (Augmented Dickey-Fuller) | KPSS 검정 (Kwiatkowski-Phillips-Schmidt-Shin) |
|---|---|---|
| 귀무가설 (\(H_0\)) | 단위근이 존재한다 (비정상 시계열) | 단위근이 없다 (정상 시계열) |
| 대립가설 (\(H_1\)) | 단위근이 없다 (정상 시계열) | 단위근이 존재한다 (비정상 시계열) |
| 정상 판정 조건 | \(p\)-value \(< 0.05\) (귀무가설 기각) | \(p\)-value \(\ge 0.05\) (귀무가설 채택) |
| 실무 역할 | 가장 널리 쓰이는 표준 단위근 검정 | ADF의 2종 오류(검정력 부족)를 보완하는 교차 검증 도구 |
library(tseries)
library(forecast)

# 1. ADF 검정 수행
adf.test(AirPassengers)
# p-value > 0.05 이면 비정상 시계열 -> 차분 필요!

# 2. 최적 차분 차수 자동 추천 함수
d_opt <- ndiffs(AirPassengers, test = "adf")      # 일반차분 횟수 (보통 1 또는 2)
D_opt <- nsdiffs(AirPassengers)                   # 계절차분 횟수 (보통 0 또는 1)
cat("추천 일반차분 차수 d =", d_opt, ", 계절차분 차수 D =", D_opt, "\n")
2. Box-Jenkins 4단계 ARIMA 모델링 프레임워크
통계학자 조지 박스(George Box)와 귈림 젠킨스(Gwilym Jenkins)가 정립한 Box-Jenkins 방법론은 시계열 예측의 바이블입니다.
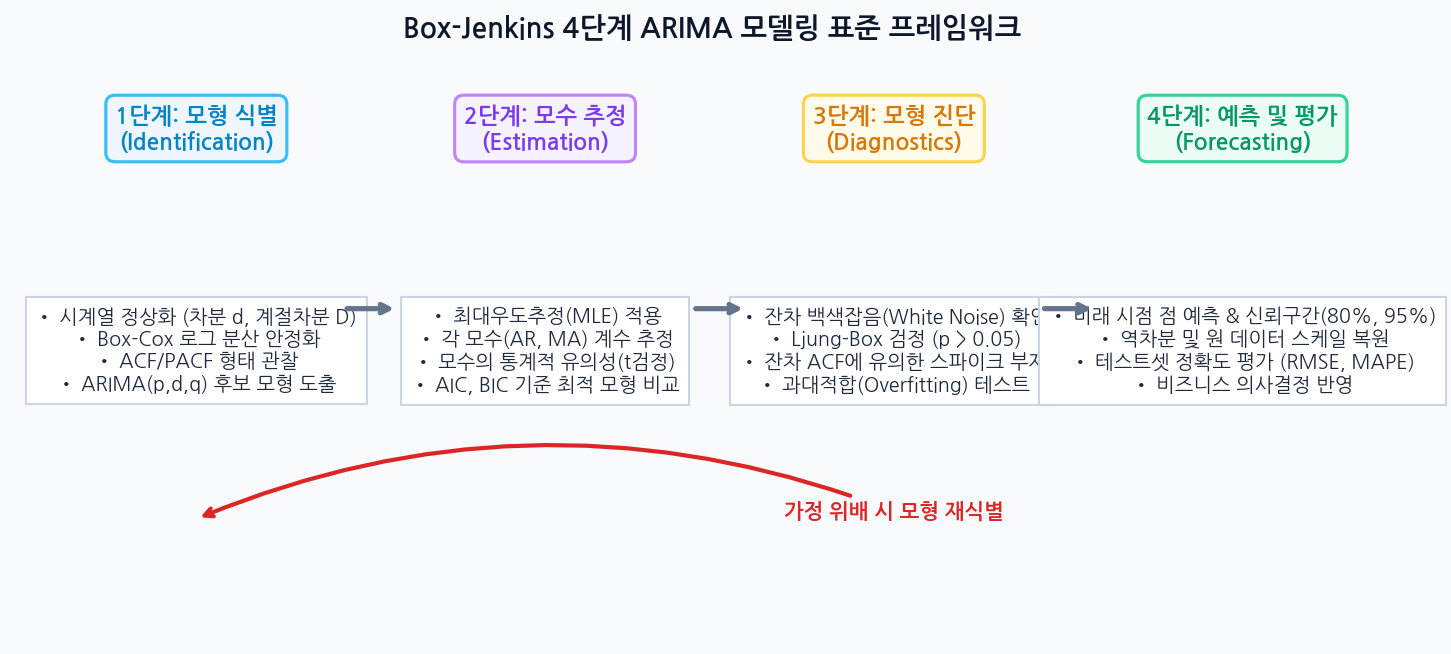
2-1. ARIMA(p, d, q)의 수학적 분해
ARIMA는 세 가지 기본 블록이 결합된 결정체입니다.
- AR(p) (자기회귀, Autoregressive): 현재 관측값을 과거 \(p\)개 시점 관측값들의 선형 결합으로 설명합니다. \[y_t = c + \phi_1 y_{t-1} + \phi_2 y_{t-2} + \dots + \phi_p y_{t-p} + \epsilon_t\]
- I(d) (적분/차분, Integrated): 비정상 시계열을 정상 시계열로 만들기 위해 적용한 차분(Differencing) 횟수 \(d\)입니다.
- MA(q) (이동평균, Moving Average): 현재 관측값을 과거 \(q\)개 시점 예측 오차(백색잡음 충격)들의 선형 결합으로 설명합니다. \[y_t = c + \epsilon_t + \theta_1 \epsilon_{t-1} + \theta_2 \epsilon_{t-2} + \dots + \theta_q \epsilon_{t-q}\]
이 셋을 통합한 \(\mathrm{ARIMA}(p, d, q)\) 모형은 다음과 같이 표현됩니다.
\[(1 - \sum_{i=1}^p \phi_i B^i) (1 - B)^d y_t = c + (1 + \sum_{j=1}^q \theta_j B^j) \epsilon_t\]
(여기서 \(B\)는 후방 시차 연산자(Backshift Operator): \(B y_t = y_{t-1}\))
2-2. 모형 차수 식별의 지문: ACF와 PACF 판정표
차분을 거쳐 정상성을 확보한 시계열의 자기상관함수(ACF)와 편자기상관함수(PACF)를 그리면, 마치 사람의 지문처럼 모형의 차수 \((p, q)\)를 알려주는 결정적 패턴이 나타납니다.
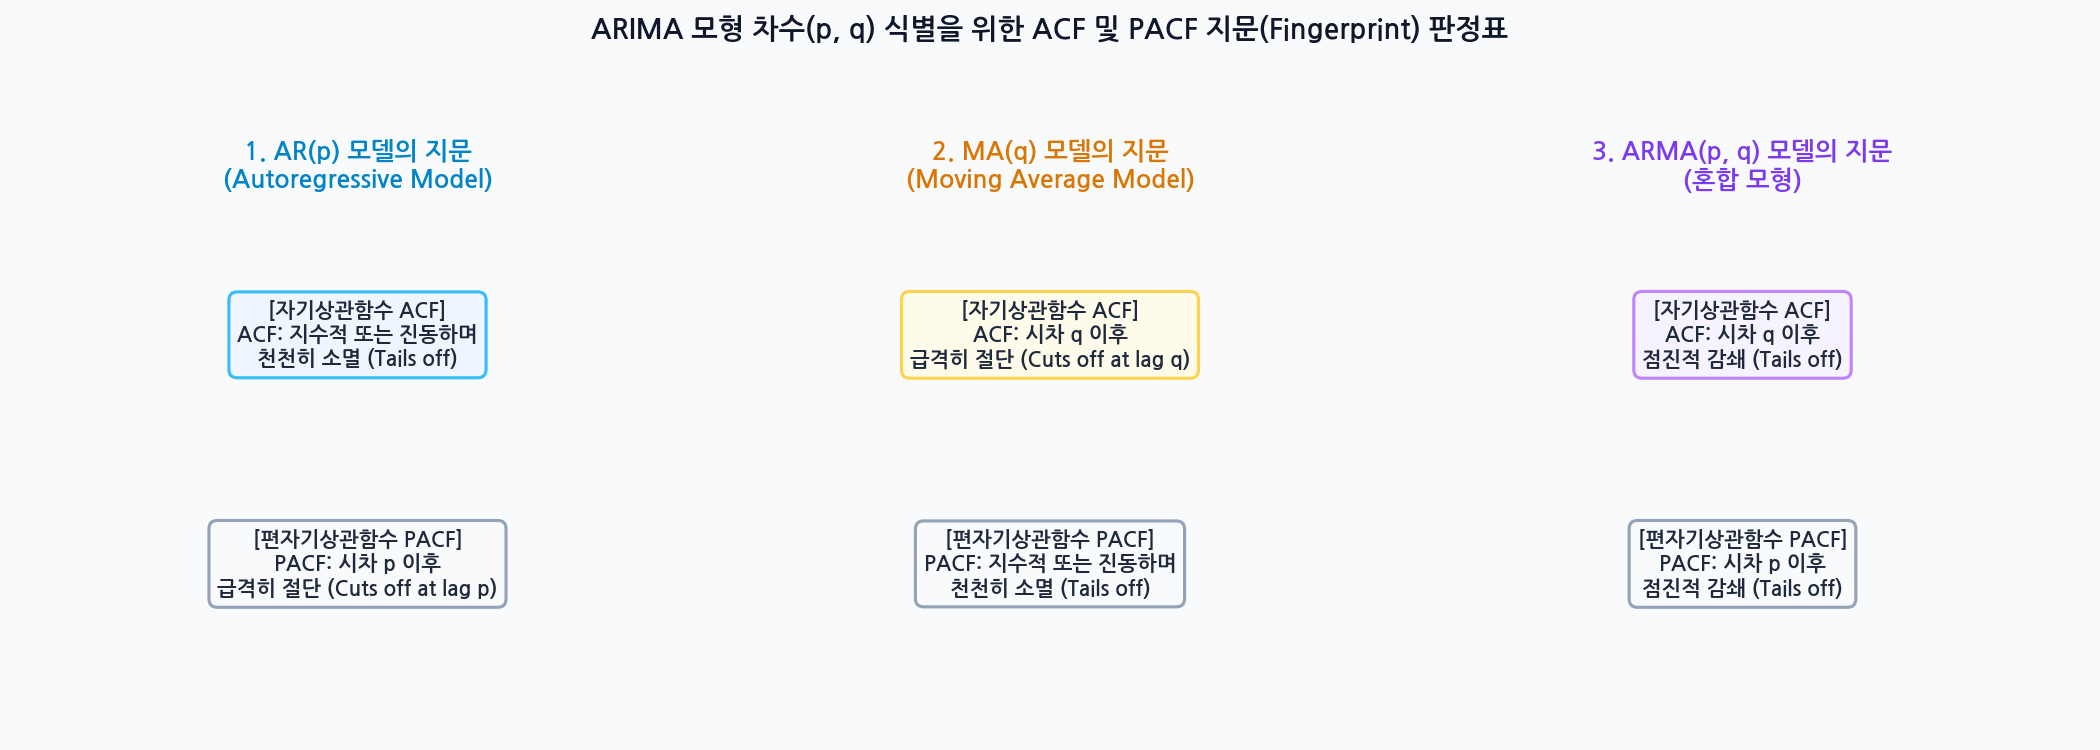
| 모형 유형 | 자기상관함수 (ACF) 형태 | 편자기상관함수 (PACF) 형태 |
|---|---|---|
| \(\mathrm{AR}(p)\) | 시차가 증가함에 따라 점진적 감쇄 (Tails off) (지수적 감소 또는 사인파 진동) |
시차 \(p\) 이후 급격히 절단 (Cuts off at lag \(p\)) \(p\) 이후의 막대들이 신뢰한계선 안으로 급락 |
| \(\mathrm{MA}(q)\) | 시차 \(q\) 이후 급격히 절단 (Cuts off at lag \(q\)) \(q\) 이후의 막대들이 신뢰한계선 안으로 급락 |
시차가 증가함에 따라 점진적 감쇄 (Tails off) (지수적 감소 또는 진동) |
| \(\mathrm{ARMA}(p, q)\) | 시차 \(q\) 이후 점진적 감쇄 (Tails off) | 시차 \(p\) 이후 점진적 감쇄 (Tails off) |
💡 직관적 팁: 왜 PACF가 AR(p)의 차수를 알려줄까?
ACF(\(k\))는 \(y_t\)와 \(y_{t-k}\) 사이의 상관계수인데, 둘 사이의 중간 시점들(\(y_{t-1}, \dots, y_{t-k+1}\))의 간접 영향이 누적되어 천천히 줄어듭니다. 반면 편자기상관(PACF)은 중간 시점들의 효과를 통계적으로 완전히 통제(제거)한 순수한 \(y_t\)와 \(y_{t-k}\)만의 직접 상관성을 잽니다. 따라서 과거 \(p\)번째 날까지만 직접 영향을 주는 \(\mathrm{AR}(p)\) 모형에서는 \(p+1\) 시차부터 직접 상관성이 정확히 \(0\)으로 떨어지는(절단되는) 것입니다!
2-3. 절편(Intercept) 포함 여부 결정: include.drift vs include.mean
R의 forecast::Arima() 함수를 사용할 때 가장 헷갈리는 옵션입니다. * \(d = 0\) (원자료가 이미 정상인 경우): include.mean = TRUE (기본값). 평균이 0이 아닌 상수값 주위를 맴돕니다. * \(d = 1\) (1차 차분한 경우): include.drift = TRUE. 1차 차분한 데이터에 상수가 포함되면, 원자료 스케일에서는 결정론적 선형 추세(Deterministic Trend, 지속적인 우상향/우하향)를 모델링하게 됩니다.
3. 모형 진단: 잔차는 진짜 백색잡음(White Noise)인가?
후보 ARIMA 모델을 추정했다면, 모델이 데이터의 패턴을 남김없이 흡수했는지 검증해야 합니다. 모형이 훌륭하다면 모델이 뱉어낸 잔차(Residuals)에는 그 어떤 규칙이나 자기상관도 남아 있지 않은 순수한 무작위 소음, 즉 백색잡음(White Noise)이어야 합니다.
# 후보 모델 적합
fit <- Arima(AirPassengers, order = c(0, 1, 1),
             seasonal = list(order = c(0, 1, 1), period = 12),
             lambda = 0) # Box-Cox 로그 변환 적용

# 종합 잔차 진단 함수 실행
checkresiduals(fit)checkresiduals()를 실행하면 세 가지를 한 화면에서 검증합니다: 1. 잔차 시계열 플롯: 0을 중심으로 위아래로 무작위하게 진동하며 분산이 일정한가? 2. 잔차 ACF 플롯: 파란색 점선(95% 신뢰구간)을 뚫고 솟구친 유의한 스파이크가 없는가? 3. Ljung-Box 검정 통계량: * 귀무가설 (\(H_0\)): 잔차들 사이에 자기상관이 없다. (즉, 백색잡음이다) * 판정: \(p\)-value \(> 0.05\) 이어야 잔차가 백색잡음임을 인정받아 모형이 최종 합격합니다!
4. auto.arima() 실무 튜닝과 함정 탈출
R forecast 패키지의 auto.arima()는 수많은 \((p, d, q)\) 조합을 자동으로 탐색하여 AICc나 BIC를 최소화하는 최적 모형을 찾아주는 마법 같은 함수입니다. 하지만 기본 설정으로만 돌리면 계산 속도를 위해 근사치(approximation = TRUE)를 쓰고 성급한 탐색(stepwise = TRUE)을 하여 국소 최적점(Local Minima)에 갇힐 수 있습니다.
실무 보고서나 고성능 예측을 위해서는 반드시 다음과 같이 완전 탐색(Exhaustive Search) 옵션을 켜야 합니다.
best_model <- auto.arima(
  AirPassengers,
  d = 1,                 # 일반차분 차수 고정 또는 NA
  D = 1,                 # 계절차분 차수 고정
  max.p = 5, max.q = 5,
  max.P = 2, max.Q = 2,
  seasonal = TRUE,       # 계절 모형 탐색
  stepwise = FALSE,      # 성급한 단계적 탐색 해제 (모든 조합 완전 탐색)
  approximation = FALSE, # 근사 우도 계산 해제 (정확한 최대우도 계산)
  lambda = "auto",       # 최적 Box-Cox lambda 자동 추정
  ic = "aicc"            # 표본 크기를 보정한 AICc 기준
)

summary(best_model)
5. 시계열 예측의 또 다른 거인: 지수평활법 (ETS)
모든 시계열을 복잡한 ARIMA로 풀 필요는 없습니다. 특히 비즈니스 실무에서 단기 매출 예측이나 재고 관리를 할 때는 계산이 번개처럼 빠르고 직관적인 지수평활법(Exponential Smoothing, ETS)이 ARIMA보다 훨씬 안정적인 성능을 발휘합니다.
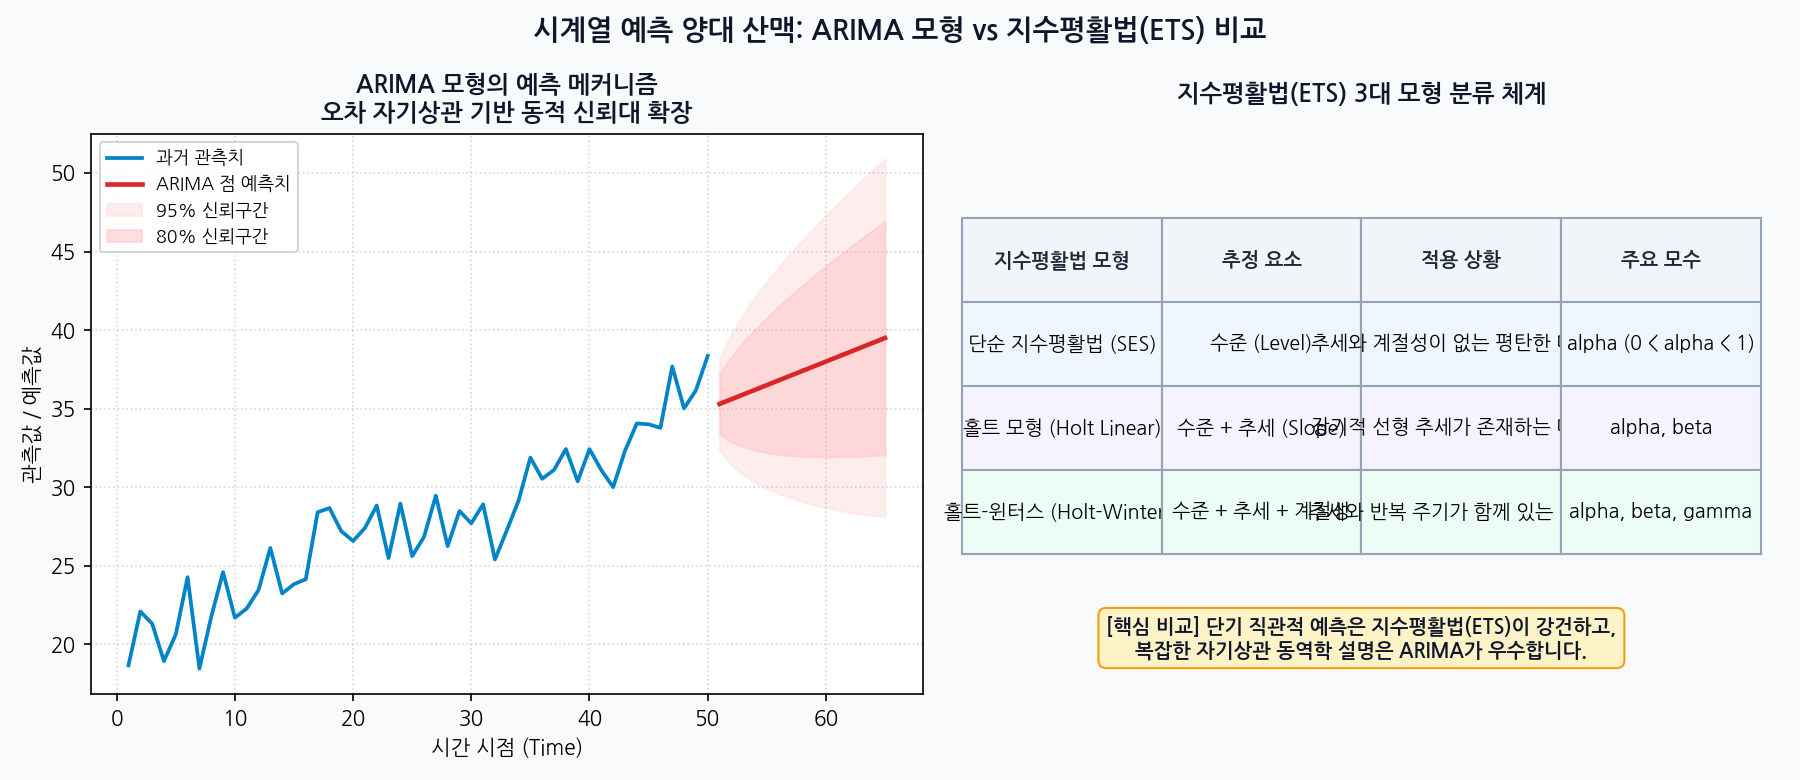
5-1. 지수평활법 3단계 진화
- 단순 지수평활법 (Simple Exponential Smoothing, SES):
- 추세와 계절성이 없는 수평적인 시계열에 적용.
- 최근 관측치일수록 지수적으로 더 큰 가중치를 부여: \(\hat{y}_{t+1} = \alpha y_t + \alpha(1-\alpha) y_{t-1} + \dots\)
- 추정 모수: \(\alpha \in [0, 1]\) (수준 평활 계수)
- 홀트 선형 추세 모형 (Holt’s Linear Trend):
- 지속적인 상승 또는 하강 추세가 있는 데이터에 적용.
- 수준(Level, \(\ell_t\))과 기울기/추세(Trend/Slope, \(b_t\))를 동시에 지수 평활.
- 추정 모수: \(\alpha\) (수준), \(\beta\) (기울기)
- 홀트-윈터스 모형 (Holt-Winters Seasonal):
- 추세와 반복되는 계절 주기(월별, 분기별)가 모두 있는 데이터에 적용.
- 수준(\(\alpha\)), 추세(\(\beta\)), 계절성(\(\gamma\))의 3대 모수를 동시 추정.
- 계절 진폭이 일정하면 가법 모형(Additive, ‘AAA’), 진폭이 매출 규모에 비례해 커지면 승법 모형(Multiplicative, ‘MAM’) 선택.
library(forecast)

# 홀트-윈터스 모델 자동 적합 (ETS: Error, Trend, Seasonal)
ets_fit <- ets(AirPassengers, model = "ZZZ") # ZZZ는 가법/승법 최적 자동 탐색
summary(ets_fit)

# 12개월 미래 예측 및 플롯
plot(forecast(ets_fit, h = 12), col = "royalblue", lwd = 2)
6. 고급 주제: 시계열 비유사도와 군집분석 (DTW & ACF Distance)
현업에서는 수백 개 매장의 매출 시계열이나 수십 개 국가의 감염병 시계열을 비슷한 패턴끼리 묶는 시계열 군집분석(Time Series Clustering)을 요구받습니다. 이때 일반적인 유클리디안 거리(Euclidean Distance)를 쓰면 시계열의 시차 지연(Lag)이나 속도 차이를 반영하지 못해 엉뚱한 군집이 형성됩니다.
- ACF Distance: 두 시계열의 자기상관 구조(ACF 벡터) 사이의 거리를 측정 (
TSclust::diss(x, "ACF")). - DTW (Dynamic Time Warping): 한 시계열이 다른 시계열보다 며칠 늦게 반응하는 시간 왜곡을 탄력적으로 늘이고 줄여서 최적 경로 거리를 측정 (
TSclust::diss(x, "DTWARP")).
library(TSclust)
library(factoextra)

# 다변량 시계열 데이터 차분 후 ACF 비유사도 행렬 계산
dat_diff <- diff(multi_ts_data, 1)
d_matrix <- diss(dat_diff, "ACF")

# 계층적 군집분석 수행
hclust_res <- hcut(as.matrix(d_matrix), k = 3, stand = TRUE)
fviz_dend(hclust_res, rect = TRUE, main = "시계열 패턴 기반 계층적 덴드로그램")
7. 실전 R 실습 풀코드: AirPassengers 항공 승객 예측 A to Z 파이프라인
데이터 분할(Train/Test), 시계열 분해(STL), 정상성 진단, 차분, auto.arima 최적화, 잔차 백색잡음 검정, 예측 및 정확도 평가(RMSE/MAPE)까지 완벽하게 동작하는 엔드투엔드 R 템플릿입니다.
#######################################################
# 시계열 분석 및 ARIMA 예측 실전 완전 정복 파이프라인
#######################################################

suppressPackageStartupMessages({
  library(forecast)
  library(tseries)
  library(tidyverse)
})

# 1. 데이터 로드 및 탐색 (AirPassengers: 1949~1960 월별 국제선 승객 수)
data("AirPassengers")
raw_ts <- AirPassengers
cat("=== 시계열 기본 정보 ===\n")
cat("시작 시점:", start(raw_ts), "| 종료 시점:", end(raw_ts),
    "| 관측 주기 (Frequency):", frequency(raw_ts), "\n")

# 2. 훈련 데이터와 테스트 데이터 분할 (마지막 12개월을 Test로 설정)
train_ts <- window(raw_ts, end = c(1959, 12))
test_ts  <- window(raw_ts, start = c(1960, 1))

# 3. 시계열 분해 (STL: Seasonal and Trend decomposition using Loess)
stl_decomp <- stl(train_ts, s.window = "periodic")
png("ts_decomposition.png", width = 800, height = 600, res = 120)
plot(stl_decomp, main = "AirPassengers STL 시계열 성분 분해")
dev.off()

# 4. 정상성 평가 및 최적 차분 차수 산출
cat("\n=== 정상성 단위근 검정 (원자료) ===\n")
adf_raw <- adf.test(train_ts)
cat("원자료 ADF p-value:", adf_raw$p.value, "(0.05 이상이므로 비정상 시계열)\n")

opt_d <- ndiffs(train_ts, test = "adf")
opt_D <- nsdiffs(train_ts)
cat("권장 일반 차분 d =", opt_d, "| 권장 계절 차분 D =", opt_D, "\n")

# 5. Box-Cox 최적 분산 안정화 계수(lambda) 탐색
best_lambda <- BoxCox.lambda(train_ts)
cat("최적 Box-Cox Lambda:", round(best_lambda, 3),
    "(0에 가까우므로 로그 변환 적용 타당)\n")

# 6. auto.arima를 통한 최적 모델 식별 및 추정 (완전 탐색 모드)
cat("\n=== 최적 SARIMA 모델 피팅 중... ===\n")
best_fit <- auto.arima(
  train_ts,
  d = opt_d,
  D = opt_D,
  lambda = best_lambda,
  stepwise = FALSE,
  approximation = FALSE,
  trace = FALSE
)
cat("선택된 최적 모델:\n")
print(best_fit)

# 7. 모형 잔차 진단 (White Noise 검증)
cat("\n=== 잔차 백색잡음 검증 (Ljung-Box Test) ===\n")
checkresiduals(best_fit)
# p-value > 0.05 인지 확인

# 8. 12개월 미래 예측 수행 (점 예측 및 80%, 95% 신뢰구간)
forecast_res <- forecast(best_fit, h = 12)
cat("\n=== 향후 12개월 예측치 요약 ===\n")
print(summary(forecast_res))

# 9. 테스트 데이터셋과의 예측 정확도(Accuracy) 평가
cat("\n=== 테스트 데이터셋 대비 모델 예측 성능 ===\n")
perf <- accuracy(forecast_res, test_ts)
print(round(perf, 2))
# MAPE (Mean Absolute Percentage Error) 확인

# 10. 최종 예측 결과 시각화
png("ts_forecast_evaluation.png", width = 1000, height = 600, res = 120)
plot(forecast_res, col = "royalblue", lwd = 2,
     xlab = "연도 (Year)", ylab = "승객 수 (천 명)",
     main = "SARIMA 최적 모델 미래 12개월 예측 및 실제값 검증")
lines(test_ts, col = "red", lwd = 2.5) # 실제 관측치 빨간 실선 추가
legend("topleft", legend = c("과거 훈련치", "SARIMA 예측치", "실제 관측치(Test)"),
       col = c("royalblue", "blue", "red"), lty = 1, lwd = 2)
dev.off()
cat("\n최종 시각화 플롯 저장 완료: ts_forecast_evaluation.png\n")
8. 실무 체크리스트 및 결론
시계열 분석은 과거의 궤적을 딛고 보이지 않는 미래의 안개를 걷어내는 가장 매혹적인 통계적 예술이자 과학입니다.
┌─────────────────────────────────────────────────────────────┐
│              [ 실무 시계열 분석 6대 핵심 체크리스트 ]          │
├─────────────────────────────────────────────────────────────┤
│ [ ] 1. 원자료의 분산 팽창 여부를 확인하고 Box-Cox를 적용했는가?│
│ [ ] 2. ADF와 KPSS 검정을 병행하여 정상성 차분(d, D)을 마쳤는가?│
│ [ ] 3. ACF/PACF 지문 패턴으로 AR과 MA 후보 차수를 좁혔는가?   │
│ [ ] 4. auto.arima에서 stepwise=F로 전역 최적해를 탐색했는가?  │
│ [ ] 5. Ljung-Box 검정(p > 0.05)으로 잔차 백색잡음을 입증했는가?│
│ [ ] 6. 단기 직관적 예측을 위해 지수평활법(ETS)과 성능을 비교했는가?│
└─────────────────────────────────────────────────────────────┘
이 체계적인 체크리스트를 따라 구축된 시계열 모형은 단순한 우연의 일치가 아닌, 데이터 이면의 본질적 시간 동역학을 포착하여 불확실한 미래를 예측하는 가장 든든한 전략적 자산이 되어 줄 것입니다.