flowchart LR
    A["수많은 분리 직선 후보<br/>(어떤 선이 최선인가?)"] --> B["양쪽 데이터와의 여백(Margin) 측정<br/>가장 가까운 점들과의 거리 계산"]
    B --> C["마진 최대화 (Max Margin)<br/>초평면: w^T x + b = 0"]
    C --> D["초평면을 지탱하는 기둥 발견<br/>서포트 벡터 (Support Vectors)"]
    D --> E["새로운 미지의 데이터 유입 시<br/>최대 마진 덕분에 오분류 확률 최소화!"]

    style A fill:#F1F5F9,stroke:#64748B,stroke-width:1.5px
    style B fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style C fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style D fill:#F3E8FF,stroke:#7C3AED,stroke-width:1.5px
    style E fill:#DCFCE7,stroke:#16A34A,stroke-width:2px
💡 핵심 요약 (Executive Summary):
- SVM의 기하학적 본질: 서포트 벡터 머신은 단순히 두 클래스를 나누는 선을 긋는 것이 아니라, 두 클래스 사이의 도로 폭, 즉 마진(Margin, \(\frac{2}{\|\mathbf{w}\|}\))을 최대화하는 최적 분리 초평면(Optimal Separating Hyperplane)을 찾는 2차 계획법(Quadratic Programming) 최적화 기법입니다.
- 서포트 벡터(Support Vector)의 존재론적 위력: 초평면에서 멀리 떨어진 수만 개의 데이터는 모델 결정에 아무런 영향을 주지 못합니다. 오직 마진 경계선 위에 걸쳐 있는 극소수의 관측치(서포트 벡터)만이 모델의 위치와 기울기를 100% 결정하므로 메모리 효율이 탁월하고 고차원 데이터에 매우 강건합니다.
- 소프트 마진과 비용(\(C\)) 트레이드오프: 데이터에 노이즈와 이상치가 존재할 때 약간의 마진 침범과 오분류를 허용하는 슬랙 변수(\(\xi_i\))를 도입합니다. 비용 파라미터 \(C\)가 크면 오분류를 엄격히 처벌하여 마진이 좁아지고(과적합 위험), \(C\)가 작으면 마진이 넓어지며 단순화됩니다(과소적합 위험).
- 커널 트릭(Kernel Trick)의 마법: 저차원에서 비선형으로 꼬여 있는 데이터를 고차원 특징 공간으로 직접 투영하지 않고도, 원래 공간에서의 내적 연산 함수(\(K(\mathbf{x}_i, \mathbf{x}_j)\))만으로 고차원 선형 분리를 수행합니다. 가장 널리 쓰이는 RBF 커널에서는 영향력 반경을 제어하는 \(\gamma\)(gamma)와 \(C\)의 2차원 탐색이 모델 성공의 열쇠입니다.
- 이상치에 저항하는 SVR (\(\epsilon\)-불감대): 회귀 문제(SVR)에서는 잔차 제곱을 최소화하는 OLS와 달리, 오차가 \(\pm \epsilon\) 튜브 안에 있으면 손실을 \(0\)으로 처리하고 튜브를 벗어난 오차에 대해서만 선형 페널티를 부과하여 극단적 이상치에 흔들리지 않는 회귀선을 도출합니다.
0. “무한히 많은 경계선 중 단 하나의 완벽한 선을 찾는 법”
2차원 평면 위에 파란색 점들과 빨간색 점들이 흩어져 있습니다. 두 집단을 분리하는 직선은 수학적으로 무한히 많이 그을 수 있습니다.
그렇다면 어떤 직선이 가장 훌륭한 직선일까요?
어떤 선은 파란색 점에 너무 바짝 붙어 있고, 어떤 선은 빨간색 점에 아슬아슬하게 걸쳐 있습니다. 이런 선들은 훈련 데이터에서는 100% 분류에 성공하더라도, 내일 새로운 테스트 데이터가 조금만 삐져나오면 즉시 오분류를 일으킵니다.
러시아의 통계학자 블라디미르 밥닉(Vladimir Vapnik)은 가장 안전한 경계선이란 “양쪽 집단으로부터 가능한 한 가장 멀리 떨어진, 도로 폭(Margin)이 가장 넓은 중앙분리대”여야 한다는 통찰을 내놓았습니다. 이것이 바로 머신러닝 역사상 가장 아름다운 기하학적 모델로 불리는 서포트 벡터 머신(SVM)의 출발점입니다.
1. 결정 초평면과 마진(Margin) 최대화의 기하학
1-1. 분리 초평면(Hyperplane)의 수학
\(p\)차원 공간에서 두 클래스를 분리하는 초평면(Hyperplane)은 다음과 같은 선형 방정식으로 정의됩니다.
\[\mathbf{w}^T \mathbf{x} + b = 0\]
- \(\mathbf{w} \in \mathbb{R}^p\): 초평면에 수직인 법선 벡터(Normal Vector) (초평면의 기울기/방향 결정)
- \(b \in \mathbb{R}\): 편향(Bias) (원점으로부터의 거리 결정)
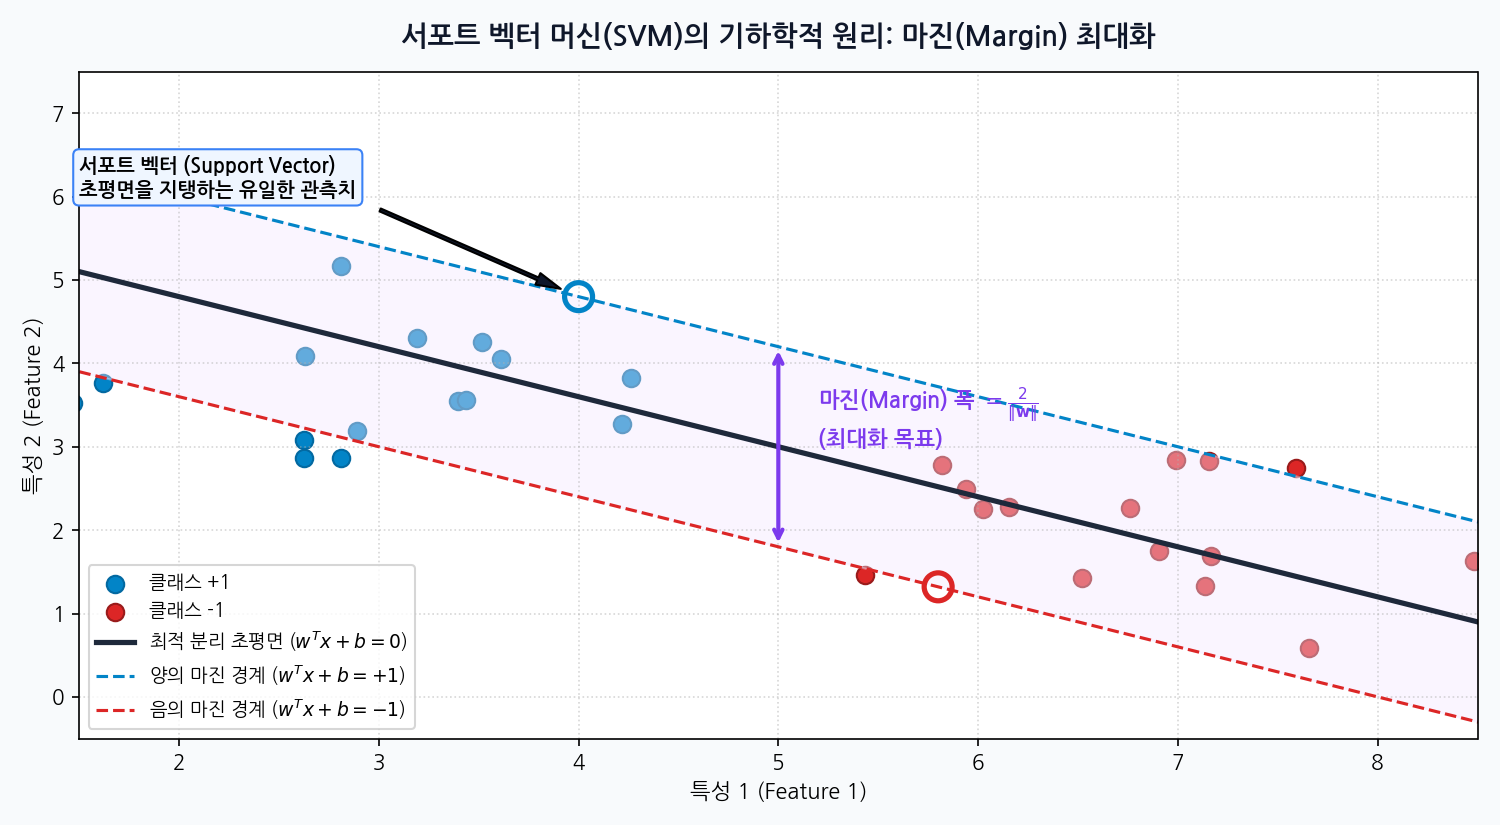
두 클래스를 \(y_i \in \{+1, -1\}\)로 라벨링할 때, 완벽하게 선형 분리가 가능한 데이터셋이라면 모든 훈련 샘플에 대해 다음 부등식이 성립하도록 스케일을 조정할 수 있습니다.
\[y_i (\mathbf{w}^T \mathbf{x}_i + b) \ge 1 \quad (i = 1, \dots, n)\]
- \(\mathbf{w}^T \mathbf{x}_i + b = +1\): 양의 마진 경계선
- \(\mathbf{w}^T \mathbf{x}_i + b = -1\): 음의 마진 경계선
1-2. 마진 폭 \(\frac{2}{\|\mathbf{w}\|}\)의 유도
양의 마진 경계선 위의 점 \(\mathbf{x}_+\)와 음의 마진 경계선 위의 점 \(\mathbf{x}_-\) 사이의 수직 거리(마진, Margin)는 다음과 같이 계산됩니다.
\[\text{Margin} = \frac{\mathbf{w}^T (\mathbf{x}_+ - \mathbf{x}_-)}{\|\mathbf{w}\|} = \frac{(\mathbf{w}^T \mathbf{x}_+ + b) - (\mathbf{w}^T \mathbf{x}_- + b)}{\|\mathbf{w}\|} = \frac{1 - (-1)}{\|\mathbf{w}\|} = \boxed{\frac{2}{\|\mathbf{w}\|}}\]
우리의 목표는 마진 폭 \(\frac{2}{\|\mathbf{w}\|}\)를 최대화(Maximize)하는 것입니다. 분수 형태의 최대화는 수학적으로 다루기 어려우므로, 역수를 취해 제곱한 다음 \(\frac{1}{2}\)을 곱한 값을 최소화(Minimize)하는 동치 문제로 변환합니다.
\[\min_{\mathbf{w}, b} \frac{1}{2} \|\mathbf{w}\|^2 \quad \text{subject to } y_i (\mathbf{w}^T \mathbf{x}_i + b) \ge 1 \quad (\forall i)\]
이것이 바로 볼록 2차 최적화(Convex Quadratic Programming) 문제이며, 국소 최솟값(Local Minimum) 없이 단 하나의 유일한 전역 최적해(Global Optimum)를 수학적으로 보장합니다!
2. 하드 마진(Hard Margin) vs 소프트 마진(Soft Margin)
2-1. 하드 마진의 비현실성과 과적합
위에서 정의한 하드 마진(Hard Margin)은 단 하나의 데이터 포인트도 마진 안쪽으로 침범하거나 반대편으로 넘어가는 것을 절대 불허합니다. 현실 데이터에는 항상 측정 오차와 노이즈가 존재합니다. 극단적인 이상치(Outlier) 단 하나가 반대편 진영에 잘못 찍혀 있으면, 하드 마진 SVM은 아예 해를 찾지 못하거나(선형 분리 불가), 이상치 하나를 피하려고 초평면의 기울기가 기괴하게 틀어지면서 마진이 극단적으로 좁아지는 과적합을 일으킵니다.
2-2. 소프트 마진과 슬랙 변수(\(\xi_i\))의 도입
이를 해결하기 위해 관측치가 마진을 침범하거나 심지어 반대편으로 잘못 넘어가는 실수를 너그럽게 허용하는 슬랙 변수(Slack Variable, \(\xi_i \ge 0\))를 도입합니다.
\[y_i (\mathbf{w}^T \mathbf{x}_i + b) \ge 1 - \xi_i \quad (\xi_i \ge 0)\]
- \(\xi_i = 0\): 마진 경계선 바깥쪽에 안전하게 잘 분류된 정상 관측치
- \(0 < \xi_i < 1\): 올바르게 분류되었으나 마진 경계 안쪽을 침범한 관측치
- \(\xi_i \ge 1\): 경계선을 넘어 반대편으로 잘못 분류된 오분류 관측치
소프트 마진의 최종 목적 함수는 다음과 같습니다.
\[\boxed{\min_{\mathbf{w}, b, \boldsymbol{\xi}} \frac{1}{2} \|\mathbf{w}\|^2 + C \sum_{i=1}^n \xi_i}\]
2-3. 하이퍼파라미터 \(C\) (Cost)의 트레이드오프
\(C\)는 “마진을 넓히는 것(규제)”과 “오분류 오차를 줄이는 것” 사이의 균형추 역할을 합니다.
| 파라미터 \(C\)의 크기 | 마진의 폭 | 오분류 허용 수준 | 모델의 복잡도 및 위험 |
|---|---|---|---|
| 작은 \(C\) (\(C \to 0\)) | 매우 넓은 마진 | 마진 침범 및 오분류를 너그럽게 허용 | 모델이 단순해져 이상치에 강건하나 과소적합(Underfitting) 주의 |
| 큰 \(C\) (\(C \to \infty\)) | 매우 좁은 마진 | 오분류를 엄격하게 처벌 (하드 마진에 근접) | 훈련 데이터를 완벽하게 맞추려다 과적합(Overfitting) 주의 |
3. 비선형의 구원투수: 커널 트릭(Kernel Trick)의 기적
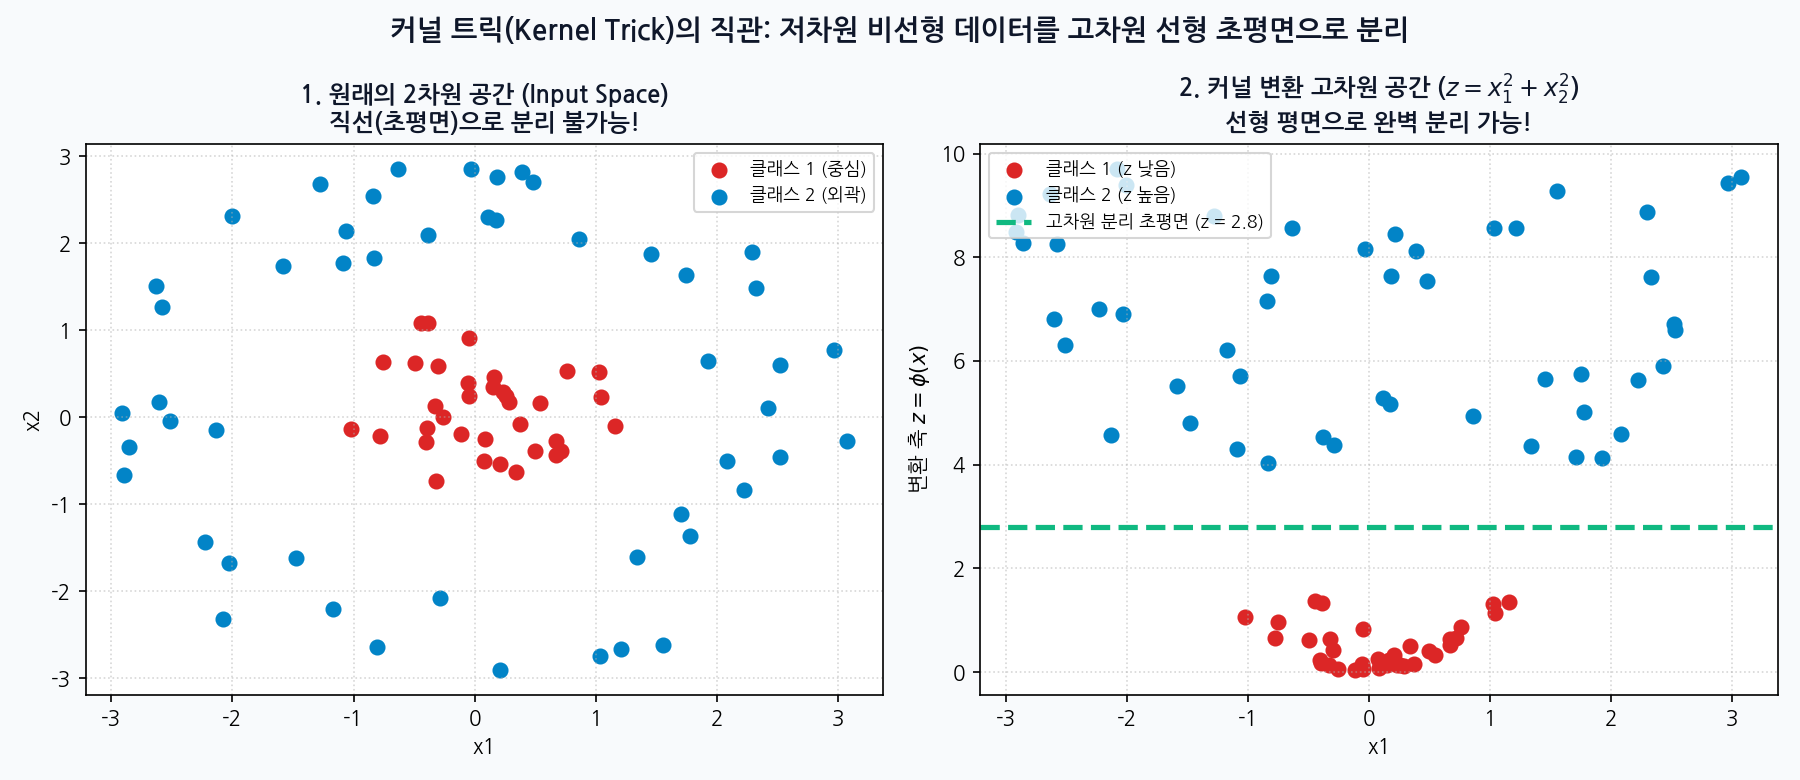
현실의 많은 데이터는 직선이나 평면으로 도저히 가를 수 없는 비선형 구조(예: 동심원 형태)를 띱니다.
3-1. 차원을 높이면 선형 분리가 가능해진다
2차원 평면에서 원점을 중심으로 빨간 점들이 모여 있고, 그 외곽을 파란 점들이 도넛 형태로 둘러싸고 있다면 2차원에서는 어떤 직선을 그어도 둘을 분리할 수 없습니다. 하지만 이 데이터에 \(z = x_1^2 + x_2^2\)라는 새로운 축을 추가하여 3차원 공간으로 들어 올리면(Mapping), 빨간 점들은 바닥에 가라앉고 파란 점들은 높은 공중으로 솟아오릅니다. 이제 두 집단 사이에 \(z = 2.8\)이라는 수평 판자(평면)를 쑥 집어넣으면 두 클래스가 완벽하게 두 동강 납니다!
3-2. 고차원 연산 없이 고차원 효과를 내는 커널 함수
문제가 있습니다. 100차원 데이터를 100만 차원의 초고차원으로 실제로 변환하여 계산하려면 메모리와 CPU가 폭발해 버립니다. 여기서 라그랑주 쌍대(Lagrangian Dual) 문제의 기적이 일어납니다. SVM의 최적화 수식을 전개하면, 데이터 포인트 \(\mathbf{x}_i\)의 개별 좌표는 전혀 필요 없고 오직 두 데이터 간의 내적 \(\mathbf{x}_i^T \mathbf{x}_j\)만 계산하면 된다는 사실이 증명됩니다.
\[\phi(\mathbf{x}_i)^T \phi(\mathbf{x}_j) = K(\mathbf{x}_i, \mathbf{x}_j)\]
데이터를 실제로 고차원으로 매핑하지 않고도, 원래 저차원 공간에서 함수 \(K(\mathbf{x}_i, \mathbf{x}_j)\)를 한 번 계산하는 것만으로 무한 차원 매핑의 내적값을 즉시 얻어낼 수 있습니다. 이를 커널 트릭(Kernel Trick)이라고 부릅니다.
3-3. 4대 주요 커널과 RBF의 \(\gamma\)(gamma) 파라미터
- 선형 커널 (Linear Kernel): \(K(\mathbf{a}, \mathbf{b}) = \mathbf{a}^T \mathbf{b}\)
특성의 수가 샘플 수보다 매우 많은 경우(예: 유전자 데이터, 텍스트 TF-IDF)에 최적. - 다항식 커널 (Polynomial Kernel): \(K(\mathbf{a}, \mathbf{b}) = (\gamma \mathbf{a}^T \mathbf{b} + r)^d\)
차수 \(d\)(degree)를 통해 비선형 다항 곡면 형성. - 가우시안 RBF 커널 (Radial Basis Function): \[K(\mathbf{a}, \mathbf{b}) = \exp\left( -\gamma \|\mathbf{a} - \mathbf{b}\|^2 \right)\] 가장 널리 쓰이는 표준 커널로, 수학적으로 무한 차원(Infinite Dimensions)의 힐베르트 공간으로 데이터를 매핑하는 효과를 냅니다.
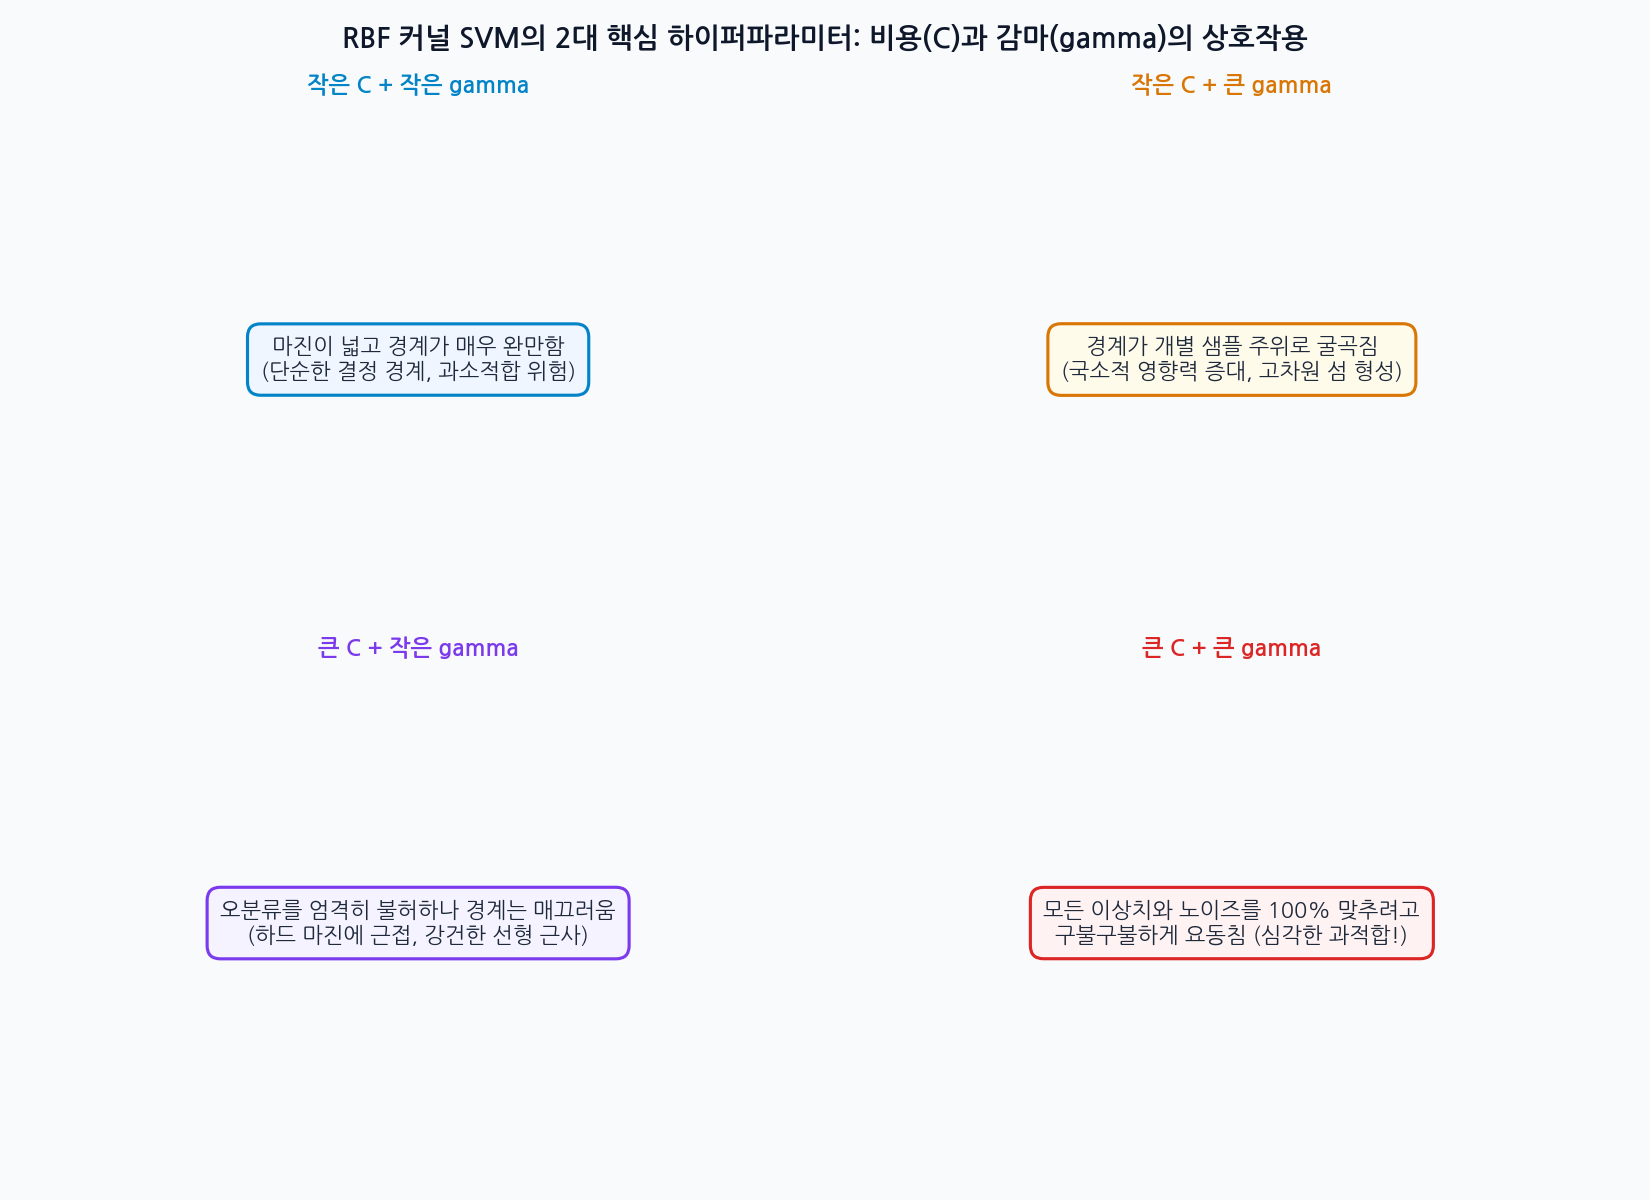
- \(\gamma\) (gamma)의 물리적 직관:
- \(\gamma\)는 개별 데이터 포인트가 미치는 영향력의 반경(Radius)을 결정합니다.
- 작은 \(\gamma\): 영향력 반경이 넓어 결정 경계가 완만하고 부드럽습니다. (과소적합 주의)
- 큰 \(\gamma\): 영향력 반경이 좁아 각 데이터 포인트마다 국소적인 ’작은 섬’을 만들어 결정 경계가 심하게 구불구불해집니다. (심각한 과적합 주의)
4. 서포트 벡터 회귀(SVR): 이상치에 굴복하지 않는 완충 튜브
회귀분석에서도 SVM의 마진 철학이 그대로 적용됩니다. 이를 서포트 벡터 회귀(SVR)라고 부릅니다.
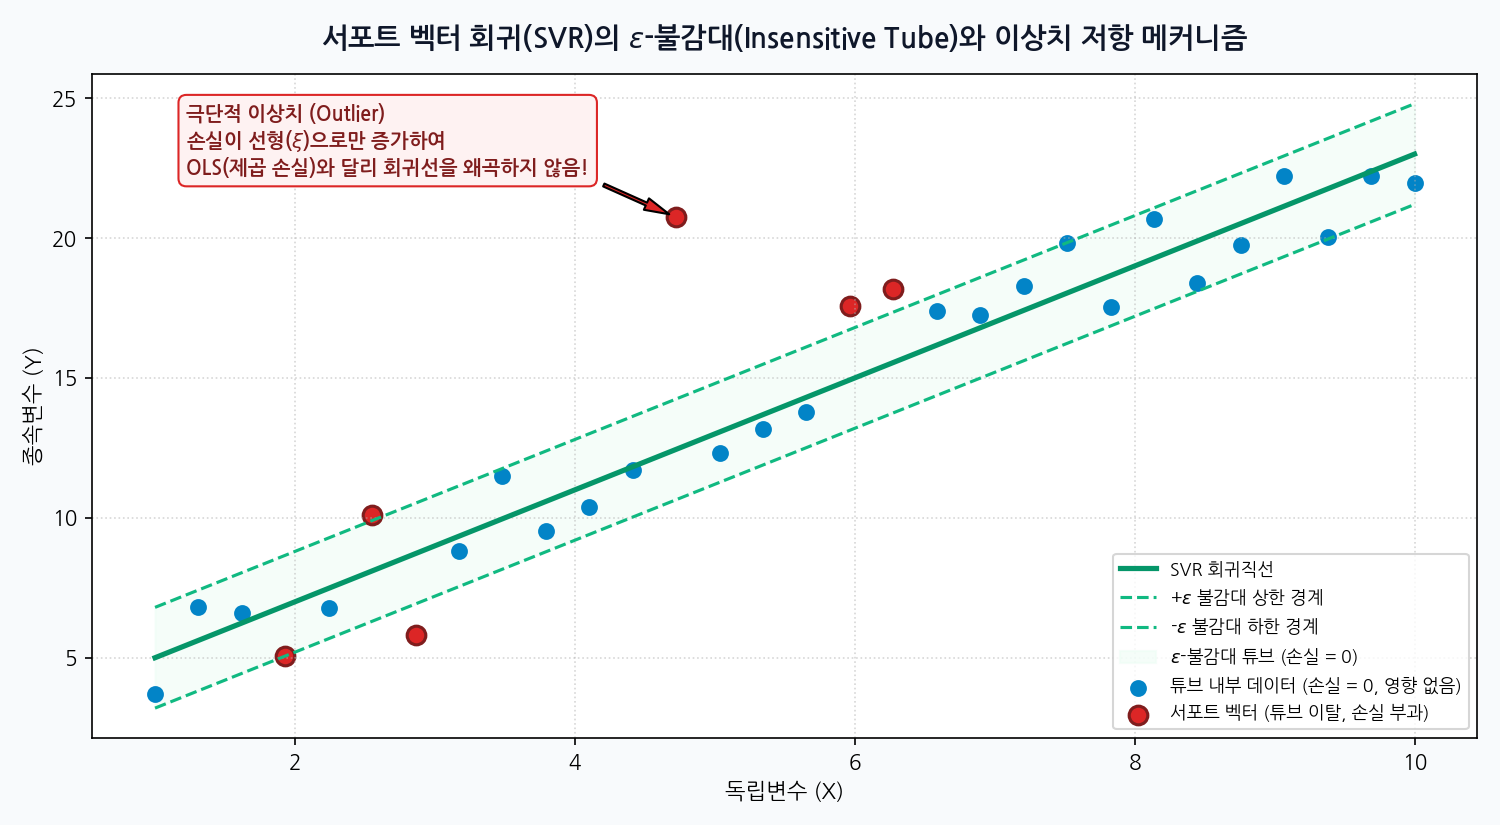
- 일반 OLS 회귀: 오차 제곱(\(e^2\))을 최소화하므로, 멀리 떨어진 이상치 하나가 회귀선을 통째로 끌어당깁니다.
- SVR (\(\epsilon\)-불감대 손실): \[L_\epsilon(y, \hat{y}) = \max(0, |y - \hat{y}| - \epsilon)\]
- 회귀선 주변에 폭 \(2\epsilon\)의 완충 튜브를 만듭니다.
- 튜브 안에 들어오는 정상적인 관측치들은 오차를 \(0\)으로 간주하여 모델 학습에 아무런 영향을 주지 않습니다.
- 튜브를 벗어난 관측치들만이 서포트 벡터가 되어 회귀선을 지탱하며, 오차가 아무리 커도 제곱이 아닌 선형(\(\xi\))으로만 페널티가 증가하므로 극단적인 이상치에 놀라울 정도로 굳건하게 버텨냅니다.
5. 실전 R 실습: 교통사고 심각도 예측 SVM & DALEX 변수 중요도 파이프라인
데이터 스케일링 전처리(recipes), RBF 커널 최적 파라미터 튜닝(tune.svm), 다중분류 혼동행렬, 그리고 블랙박스 모델인 SVM의 의사결정 원인을 규명하는 DALEX 변수 중요도(Explainable AI)까지 완벽하게 구현하는 실전 풀코드입니다.
#######################################################
# 서포트 벡터 머신(SVM) 실전 완전 정복 파이프라인
#######################################################

suppressPackageStartupMessages({
  library(tidyverse)
  library(e1071)
  library(caret)
  library(recipes)
  library(DALEX)
})

# 1. 예제 데이터 생성 (교통사고 심각도 가상 데이터셋)
set.seed(42)
n <- 1000
alchl_i <- sample(c(0, 1), n, replace = TRUE, prob = c(0.8, 0.2))
veh_invl <- rpois(n, lambda = 2) + 1
speed <- rnorm(n, mean = 60, sd = 20)
surface_cond <- sample(c("Dry", "Wet", "Icy"), n, replace = TRUE, prob = c(0.7, 0.2, 0.1))

# 사고 심각도(MAX_SEV_IR: 0=경상, 1=중상, 2=사망) 비선형 생성
latent_score <- -3.0 + 1.2 * alchl_i + 0.04 * speed + 0.5 * veh_invl +
                0.8 * (surface_cond == "Icy") + 0.0005 * (speed^2) + rnorm(n, 0, 1)

severity <- ifelse(latent_score < 0.5, "Minor",
                   ifelse(latent_score < 2.5, "Moderate", "Severe"))

accidents_df <- data.frame(
  ALCHL_I = factor(alchl_i),
  VEH_INVL = veh_invl,
  SPEED = speed,
  SUR_COND = factor(surface_cond),
  MAX_SEV_IR = factor(severity, levels = c("Minor", "Moderate", "Severe"))
)

cat("=== 1. 타겟 변수(사고 심각도) 분포 ===\n")
print(table(accidents_df$MAX_SEV_IR))

# 2. 훈련 및 검증 데이터 분할 (Train 70% : Valid 30%)
train_idx <- createDataPartition(accidents_df$MAX_SEV_IR, p = 0.7, list = FALSE)
train_raw <- accidents_df[train_idx, ]
test_raw  <- accidents_df[-train_idx, ]

# 3. ⚠️ 핵심 전처리: SVM은 거리 기반 모델이므로 표준화(Scaling)가 절대 필수!
svm_recipe <- recipe(MAX_SEV_IR ~ ., data = train_raw) %>%
  step_dummy(all_nominal_predictors()) %>%
  step_normalize(all_numeric_predictors()) %>%
  prep()

train_df <- juice(svm_recipe)
test_df  <- bake(svm_recipe, new_data = test_raw)

# 4. e1071 패키지를 이용한 RBF 커널 하이퍼파라미터 그리드 튜닝 (C, gamma)
cat("\n=== 2. e1071 tune.svm 그리드 서치 수행 중... ===\n")
tune_result <- tune.svm(
  MAX_SEV_IR ~ ., data = train_df,
  kernel = "radial",
  cost = 2^(-1:3),     # C: 0.5, 1, 2, 4, 8
  gamma = 2^(-2:1)     # gamma: 0.25, 0.5, 1, 2
)

cat("최적 파라미터 조합:\n")
print(tune_result$best.parameters)
cat("최적 교차검증 에러율:", round(tune_result$best.performance, 4), "\n")

# 5. 최적 모델 적합 및 서포트 벡터 통계 확인
best_svm <- tune_result$best.model
cat("\n=== 3. 최종 서포트 벡터 머신 요약 ===\n")
summary(best_svm)
cat("전체 학습 데이터", nrow(train_df), "개 중 서포트 벡터 수:", best_svm$tot.nSV, "\n")

# 6. 검증 데이터셋 다중분류 예측 및 성능 평가
pred_test <- predict(best_svm, newdata = test_df)
cm <- confusionMatrix(pred_test, test_df$MAX_SEV_IR)

cat("\n=== 4. 검증셋 혼동 행렬(Confusion Matrix) ===\n")
print(cm$table)
cat("\n전체 정확도 (Accuracy):", round(cm$overall["Accuracy"], 4), "\n")
cat("카파 통계량 (Kappa):", round(cm$overall["Kappa"], 4), "\n")
print(round(cm$byClass[, c("Sensitivity", "Specificity", "F1")], 3))

# ----------------------------------------------------
# 7. 블랙박스 SVM 해석: DALEX 패키지를 활용한 변수 중요도(XAI)
# ----------------------------------------------------
cat("\n=== 5. DALEX 변수 중요도 산출 중... ===\n")
# DALEX explainer 생성 (y는 숫자형 코딩 필요)
y_num <- as.numeric(train_df$MAX_SEV_IR)
predict_dalex <- function(model, newdata) {
  as.numeric(predict(model, newdata))
}

explainer_svm <- DALEX::explain(
  model = best_svm,
  data = train_df %>% select(-MAX_SEV_IR),
  y = y_num,
  predict_function = predict_dalex,
  label = "RBF-SVM",
  verbose = FALSE
)

# 순열 기반 특성 중요도 (Permutation Feature Importance)
vip_svm <- model_parts(explainer_svm, B = 25)
cat("변수 중요도 (Drop-loss):\n")
print(head(vip_svm))

png("svm_feature_importance.png", width = 800, height = 500, res = 120)
plot(vip_svm) + ggtitle("SVM 모델 의사결정에 기여한 핵심 변수 순위")
dev.off()
cat("변수 중요도 플롯 저장 완료: svm_feature_importance.png\n")
6. 실무 체크리스트 및 결론
서포트 벡터 머신은 고차원 특성 공간에서도 과적합에 쉽게 무너지지 않는 가장 우아하고 신뢰할 수 있는 수학적 분류기입니다.
┌─────────────────────────────────────────────────────────────┐
│                 [ 실무 SVM 모델링 6대 핵심 체크리스트 ]        │
├─────────────────────────────────────────────────────────────┤
│ [ ] 1. 모든 연속형 변수를 Z-score로 표준화(Scaling)했는가?    │
│ [ ] 2. 고차원 텍스트는 Linear, 일반 비선형 데이터는 RBF를 택했는가?│
│ [ ] 3. 비용 C와 감마(gamma)를 지수 스케일(2^k)로 그리드 탐색했는가?│
│ [ ] 4. 서포트 벡터 수가 전체 데이터의 70~80%를 넘지 않는가?   │
│       (너무 많으면 과적합 및 메모리 폭발 신호)              │
│ [ ] 5. 회귀 문제(SVR) 적용 시 이상치 완충 튜브(epsilon)를 설정했는가?│
│ [ ] 6. DALEX 등을 활용해 블랙박스 결정 경계의 설명력을 확보했는가?│
└─────────────────────────────────────────────────────────────┘
딥러닝의 복잡성과 트리 모델의 한계를 넘나드는 기하학적 직관, 그리고 서포트 벡터 머신이 보장하는 명쾌한 전역 최적해를 여러분의 머신러닝 분석 파이프라인에 적극 도입해 보시기 바랍니다.