머신러닝 경진대회 플랫폼 캐글(Kaggle)의 우승자 솔루션을 분석해 보면 한 가지 뚜렷한 공통점이 있습니다. 정형(Tabular) 데이터셋 문제에서 딥러닝 모델을 제치고 리더보드 최상단을 장식하는 단골 주인공은 언제나 XGBoost(eXtreme Gradient Boosting)라는 사실입니다.
하지만 실무에서 많은 데이터 분석가들이 XGBoost를 사용할 때 단순히 패키지를 불러와 기본 설정값(Default)으로 피팅하거나, 무작정 넓은 그리드 서치를 돌려 수 시간을 낭비하곤 합니다. XGBoost가 왜 전통적인 Gradient Boosting(GBM)보다 압도적으로 빠르고 강력한지, 그 내부에서 작동하는 2차 테일러 전개(2nd Order Taylor Expansion)와 정규화 목적함수(Regularized Objective)의 원리를 이해하지 못하면 모델이 과적합의 늪에 빠졌을 때 어떤 하이퍼파라미터를 조정해야 할지 감을 잡을 수 없습니다.
이번 글에서는 XGBoost 논문(Chen & Guestrin, 2016)에 담긴 수학적 유도 과정을 단계별로 명쾌하게 증명하고, 노드 분할 이득(Gain) 공식의 원리, 7대 핵심 하이퍼파라미터의 체계적인 튜닝 로드맵, 그리고 R 환경에서 caret::xgbTree와 네이티브 xgboost::xgb.cv를 활용한 조기 종료(Early Stopping) 파이프라인 구축법을 깊이 있게 살펴보겠습니다.
1. GBM vs XGBoost: 무엇이 성능과 속도의 격차를 만들었는가?
XGBoost의 이름에 붙은 ‘eXtreme’은 단순히 마케팅 수식어가 아닙니다. 정밀한 수학적 최적화 기법과 컴퓨터 시스템 차원의 하드웨어 가속 기술을 결합하여, 기존 알고리즘의 한계를 극단적으로 밀어붙였다는 뜻입니다.
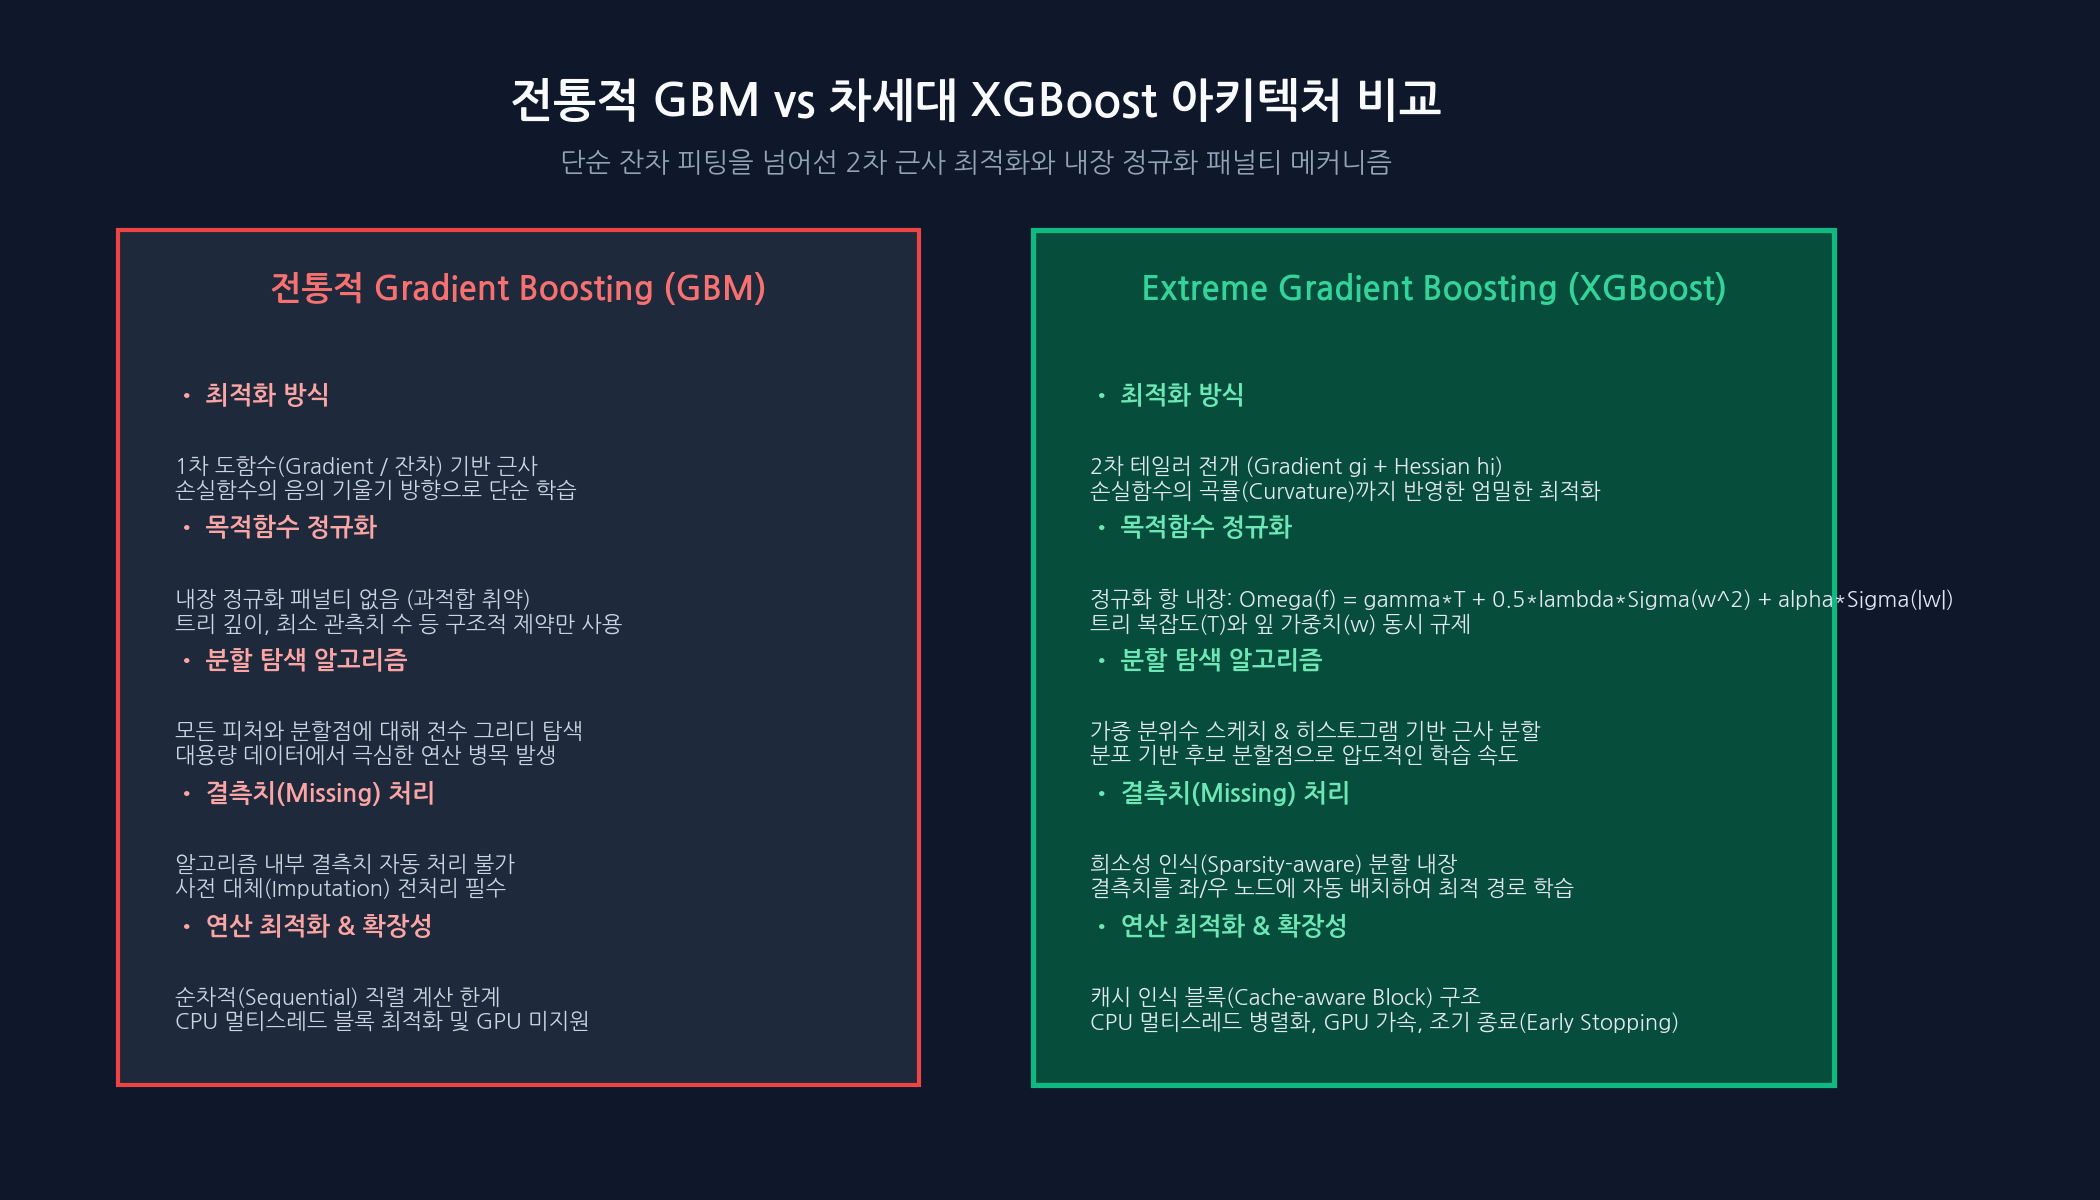
전통적인 GBM과 XGBoost의 결정적 차이는 크게 5가지 영역에서 발생합니다.
| 비교 항목 | 전통적 Gradient Boosting (GBM) | eXtreme Gradient Boosting (XGBoost) |
|---|---|---|
| 최적화 기법 | 1차 도함수(Gradient, 잔차) 기반 근사 | 2차 테일러 전개(Gradient + Hessian) 정밀 최적화 |
| 과적합 규제 | 내장 정규화 항 없음 (트리 깊이만 제한) | \(\Omega(f)\) 내장 (L1/L2 가중치 규제 + 잎 개수 패널티) |
| 분할 탐색 | 전수 그리디 탐색 (Exact Greedy Search) | 가중 분위수 스케치(Weighted Quantile Sketch) 근사 분할 |
| 결측치 처리 | 사전 대체(Imputation) 전처리 필수 | 희소성 인식(Sparsity-aware) 분할 방향 자동 학습 |
| 병렬/시스템 가속 | 순차적 직렬 계산 (CPU 단일 코어 중심) | 캐시 인식 블록(Cache-aware Block) 멀티스레딩 & GPU 가속 |
전통적 GBM은 오차의 1차 기울기(음의 그레이디언트) 방향으로만 트리를 피팅하기 때문에, 손실함수의 곡률(곡면의 가파른 정도)을 알지 못해 적절한 보폭을 결정하기 어렵습니다. 반면 XGBoost는 손실함수를 2차 도함수(Hessian)까지 테일러 전개하여 손실 표면의 2차 곡률 정보를 바탕으로 최적의 잎 노드 가중치를 단 한 번의 수식 계산으로 해석적(Analytic)으로 도출합니다.
2. XGBoost의 수학적 심장: 2차 테일러 급수와 목적함수 유도
XGBoost가 모델을 학습하는 수학적 과정을 직접 유도해 보겠습니다. 이 유도 과정을 한 번 이해하고 나면, 왜 lambda와 gamma가 모델 복잡도를 억제하는지 직관적으로 깨닫게 됩니다.
2.1 정규화된 목적함수 정의
\(n\)개의 관측치와 \(K\)개의 가산 트리(Additive Trees)로 구성된 앙상블 모델의 예측값은 다음과 같습니다:
\[\hat{y}_i = \sum_{k=1}^K f_k(x_i), \quad f_k \in \mathcal{F}\]
\(t\)번째 라운드에서 새로운 트리 \(f_t(x_i)\)를 추가할 때, 최소화해야 하는 목적함수(Objective Function) \(\mathcal{L}^{(t)}\)는 훈련 데이터의 손실과 모델 복잡도 패널티(정규화 항)의 합입니다:
\[\mathcal{L}^{(t)} = \sum_{i=1}^n l\left(y_i, \hat{y}_i^{(t-1)} + f_t(x_i)\right) + \Omega(f_t)\]
여기서 정규화 항 \(\Omega(f_t)\)는 트리의 잎 노드 총개수 \(T\)와 각 잎의 가중치 \(w_j\)의 크기를 제어합니다:
\[\Omega(f_t) = \gamma T + \frac{1}{2}\lambda \sum_{j=1}^T w_j^2 + \alpha \sum_{j=1}^T |w_j|\]
- \(\gamma\): 잎 노드를 하나 추가할 때마다 부과되는 복잡도 비용 (최소 손실 감소량)
- \(\lambda\): 잎 노드 가중치에 대한 L2(Ridge) 정규화 계수 (가중치 폭주 억제)
- \(\alpha\): 잎 노드 가중치에 대한 L1(Lasso) 정규화 계수 (가중치 희소화 유도)
2.2 2차 테일러 급수(2nd-order Taylor Expansion) 근사
임의의 매끄러운 손실함수 \(l(y, \hat{y})\)에 대해, \(x\) 지점 주변에서의 2차 테일러 전개 공식은 다음과 같습니다:
\[f(x + \Delta x) \approx f(x) + f'(x)\Delta x + \frac{1}{2}f''(x)(\Delta x)^2\]
이 공식을 우리의 목적함수에 적용해 보겠습니다. 기준점은 이전 라운드까지의 누적 예측값 \(\hat{y}_i^{(t-1)}\)이고, 증분은 이번에 새로 학습할 트리의 예측값 \(f_t(x_i)\)입니다:
\[\mathcal{L}^{(t)} \approx \sum_{i=1}^n \left[ l\left(y_i, \hat{y}_i^{(t-1)}\right) + g_i f_t(x_i) + \frac{1}{2} h_i f_t^2(x_i) \right] + \Omega(f_t)\]
여기서 \(g_i\)와 \(h_i\)는 각각 손실함수의 1차 도함수(Gradient)와 2차 도함수(Hessian)입니다:
\[g_i = \partial_{\hat{y}^{(t-1)}} l(y_i, \hat{y}^{(t-1)}), \quad h_i = \partial^2_{\hat{y}^{(t-1)}} l(y_i, \hat{y}^{(t-1)})\]
예를 들어 회귀 문제에서 가장 널리 쓰이는 제곱 오차 손실 \(l(y_i, \hat{y}_i) = \frac{1}{2}(y_i - \hat{y}_i)^2\)을 사용한다면: - \(g_i = \hat{y}_i^{(t-1)} - y_i\) (잔차의 반대 부호) - \(h_i = 1\) (상수)
이진 분류 문제에서 로지스틱 손실(Log-loss) \(l(y_i, p_i) = -y_i \ln p_i - (1-y_i)\ln(1-p_i)\)을 사용한다면: - \(g_i = p_i - y_i\) - \(h_i = p_i (1 - p_i)\)
이전 단계의 손실 \(l(y_i, \hat{y}_i^{(t-1)})\)은 이미 결정된 상수이므로 최적화 과정에서 제거할 수 있습니다. 단순화된 \(t\)번째 목적함수 \(\tilde{\mathcal{L}}^{(t)}\)는 다음과 같습니다:
\[\tilde{\mathcal{L}}^{(t)} = \sum_{i=1}^n \left[ g_i f_t(x_i) + \frac{1}{2} h_i f_t^2(x_i) \right] + \gamma T + \frac{1}{2}\lambda \sum_{j=1}^T w_j^2\]
2.3 잎 노드(Leaf Node) 기준 목적함수 재정리
트리 모델에서 모든 데이터 포인트 \(i\)는 반드시 \(T\)개의 잎 노드 중 정확히 하나에 속하게 됩니다. 잎 노드 \(j\)에 도달하는 데이터 인덱스의 집합을 \(I_j = \{i \mid q(x_i) = j\}\)라 하고, 그 잎 노드의 출력값을 \(w_j\)라 하면 \(f_t(x_i) = w_{q(x_i)} = w_j\)로 치환할 수 있습니다.
이제 데이터별 합산(\(\sum_{i=1}^n\))을 잎 노드별 합산(\(\sum_{j=1}^T\))으로 묶어 재정리합니다:
\[\tilde{\mathcal{L}}^{(t)} = \sum_{j=1}^T \left[ \left(\sum_{i \in I_j} g_i\right) w_j + \frac{1}{2} \left(\sum_{i \in I_j} h_i + \lambda\right) w_j^2 \right] + \gamma T\]
표기를 단순화하기 위해 각 잎 노드 \(j\)에 속한 데이터들의 1차 기울기 총합을 \(G_j\), 2차 곡률 총합을 \(H_j\)로 정의합니다:
\[G_j = \sum_{i \in I_j} g_i, \quad H_j = \sum_{i \in I_j} h_i\]
그러면 목적함수는 \(w_j\)에 관한 깔끔한 2차 다항식의 합이 됩니다:
\[\tilde{\mathcal{L}}^{(t)} = \sum_{j=1}^T \left[ G_j w_j + \frac{1}{2} (H_j + \lambda) w_j^2 \right] + \gamma T\]
2.4 최적 가중치 \(w_j^*\)와 최소 목적함수 점수
위 식을 각 잎의 가중치 \(w_j\)에 대해 편미분하여 0이 되는 지점을 구합니다:
\[\frac{\partial \tilde{\mathcal{L}}^{(t)}}{\partial w_j} = G_j + (H_j + \lambda) w_j = 0\]
따라서 최적의 잎 노드 가중치 \(w_j^*\)는 다음과 같이 닫힌 형태(Closed-form)로 바로 도출됩니다:
\[w_j^* = -\frac{G_j}{H_j + \lambda}\]
[수학적 통찰]
분모에 있는 \(\lambda\)를 주목하십시오! 만약 노드에 속한 샘플 수가 적어 \(H_j\)가 작다면 가중치 \(w_j\)가 지나치게 커져 과적합될 수 있습니다. 이때 정규화 계수 \(\lambda > 0\)가 분모를 키워주어 가중치 \(w_j^*\)가 0 쪽으로 수축(Shrinkage)되도록 안전장치 역할을 수행합니다.
이 최적 가중치 \(w_j^*\)를 원래 목적함수에 대입하면, 주어진 트리 구조 \(q\)의 품질을 평가하는 최적 손실 점수(Structure Score)가 완성됩니다:
\[\tilde{\mathcal{L}}^*(q) = -\frac{1}{2} \sum_{j=1}^T \frac{G_j^2}{H_j + \lambda} + \gamma T\]
이 점수는 마치 의사결정나무에서 불순도(Gini 계수나 엔트로피)를 측정하듯, 현재 트리가 데이터를 얼마나 잘 설명하는지 나타내는 척도가 됩니다. 점수가 음수 방향으로 낮을수록 더 우수한 트리 구조입니다.
3. 노드 분할(Split)과 분할 게인(Gain) 공식
현실적으로 가능한 모든 트리 구조를 열거하여 비교하는 것은 NP-Hard 문제입니다. 따라서 XGBoost는 단일 노드에서부터 출발하여 탐욕적(Greedy)으로 분할을 거듭해 나갑니다.
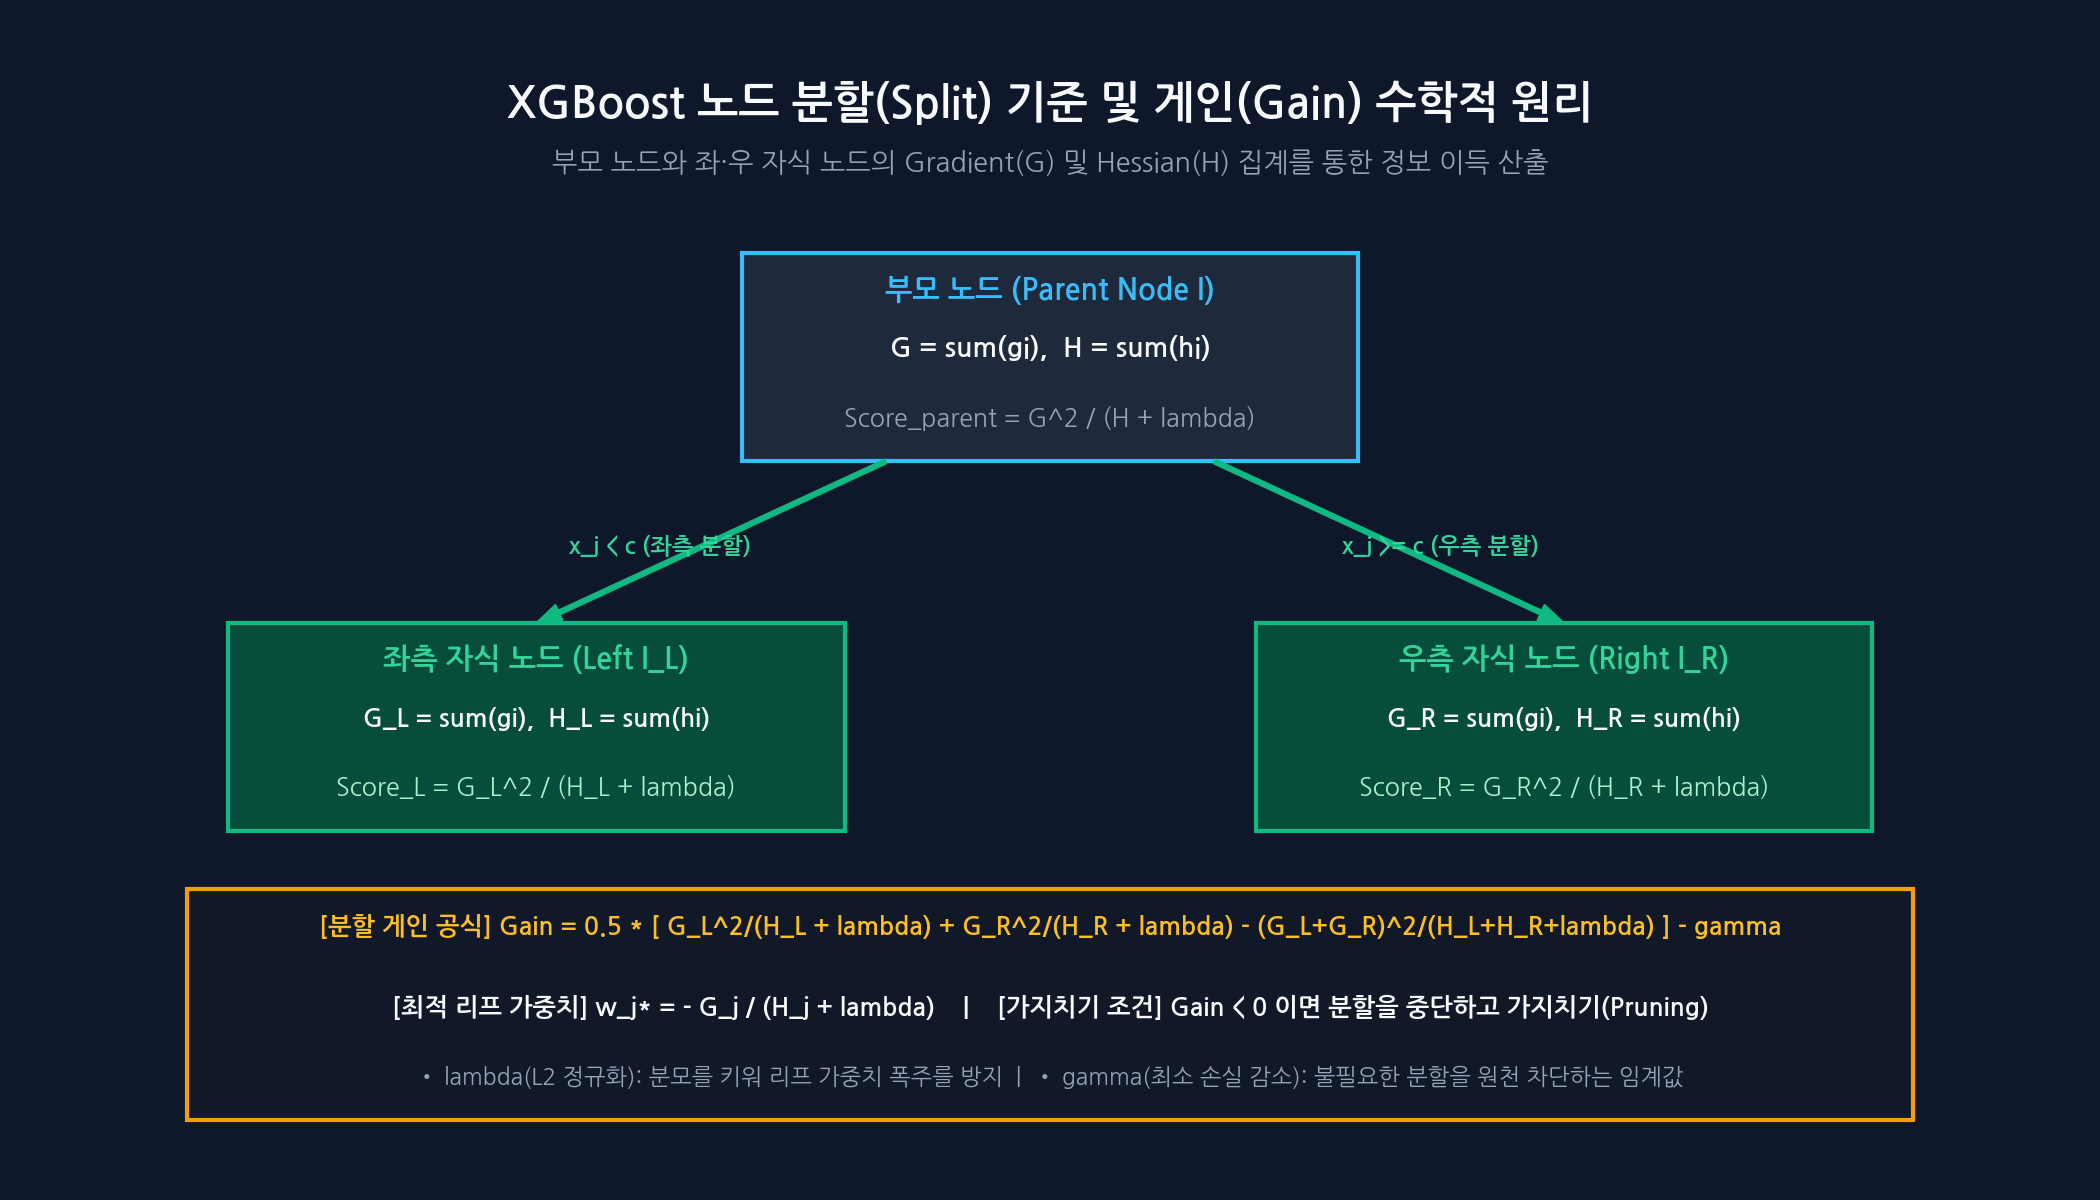
어떤 부모 노드 \(I\)를 특정 피처와 분할점(Threshold)을 기준으로 좌측 자식 노드 \(I_L\)과 우측 자식 노드 \(I_R\)로 나눈다고 가정해 보겠습니다 (\(I = I_L \cup I_R\)).
분할을 수행했을 때 손실함수가 얼마나 감소하는지를 나타내는 분할 게인(Gain) 공식은 다음과 같이 유도됩니다:
\[\text{Gain} = \tilde{\mathcal{L}}^*_{\text{parent}} - \left( \tilde{\mathcal{L}}^*_{\text{left}} + \tilde{\mathcal{L}}^*_{\text{right}} \right)\]
부호와 상수를 정리하면 교과서에 등장하는 유명한 Gain 공식이 완성됩니다:
\[\text{Gain} = \frac{1}{2} \left[ \frac{G_L^2}{H_L + \lambda} + \frac{G_R^2}{H_R + \lambda} - \frac{(G_L + G_R)^2}{H_L + H_R + \lambda} \right] - \gamma\]
Gain 공식의 3가지 핵심 구성 요소
- 자식 노드 점수의 합 (\(\frac{G_L^2}{H_L + \lambda} + \frac{G_R^2}{H_R + \lambda}\)): 분할 후 좌·우 노드가 각각 달성한 오차 감소량
- 부모 노드 원래 점수 (\(\frac{(G_L + G_R)^2}{H_L + H_R + \lambda}\)): 분할하기 전 원래 노드가 가지고 있던 점수
- 복잡도 패널티 (\(\gamma\)): 노드를 한 번 분할함으로써 잎 노드가 1개 증가(T -> T+1)하는 데 따르는 비용
[가지치기(Pruning) 메커니즘]
만약 괄호 안의 손실 감소량이 \(\gamma\)보다 작다면 \(\text{Gain} < 0\)이 됩니다. 즉, 분할을 해봤자 모델 복잡도 증가 비용을 상쇄하지 못한다는 의미입니다. XGBoost는 우선max_depth까지 트리를 끝까지 키운 뒤(Max Tree), 역방향으로 탐색하며 Gain이 음수인 분할을 가지치기(Post-pruning)합니다.
희소성 인식 분할 (Sparsity-aware Split Finding)
실무 데이터에는 결측치(NA, NULL)나 0이 다수 포함된 희소 행렬이 흔합니다. XGBoost는 결측치가 있는 샘플들을 먼저 제외하고 \(G\)와 \(H\)를 집계한 뒤, 결측치들을 전부 좌측 노드로 보냈을 때의 Gain과 전부 우측 노드로 보냈을 때의 Gain을 각각 계산합니다. 둘 중 더 높은 Gain을 산출하는 방향을 기본 경로(Default Direction)로 영구 할당합니다. 이 덕분에 사용자가 별도의 결측치 대체를 하지 않아도 알고리즘 내부에서 데이터 기반의 최적 경로를 찾아냅니다.
4. XGBoost 7대 핵심 하이퍼파라미터 체계적 튜닝 맵
XGBoost는 튜닝할 수 있는 파라미터가 수십 개에 달합니다. 아무런 전략 없이 모든 파라미터를 동시에 튜닝하려 들면 기하급수적인 연산 시간이 소요됩니다. 과적합을 효과적으로 통제하고 일반화 성능을 끌어올리기 위한 4단계 튜닝 로드맵을 제안합니다.
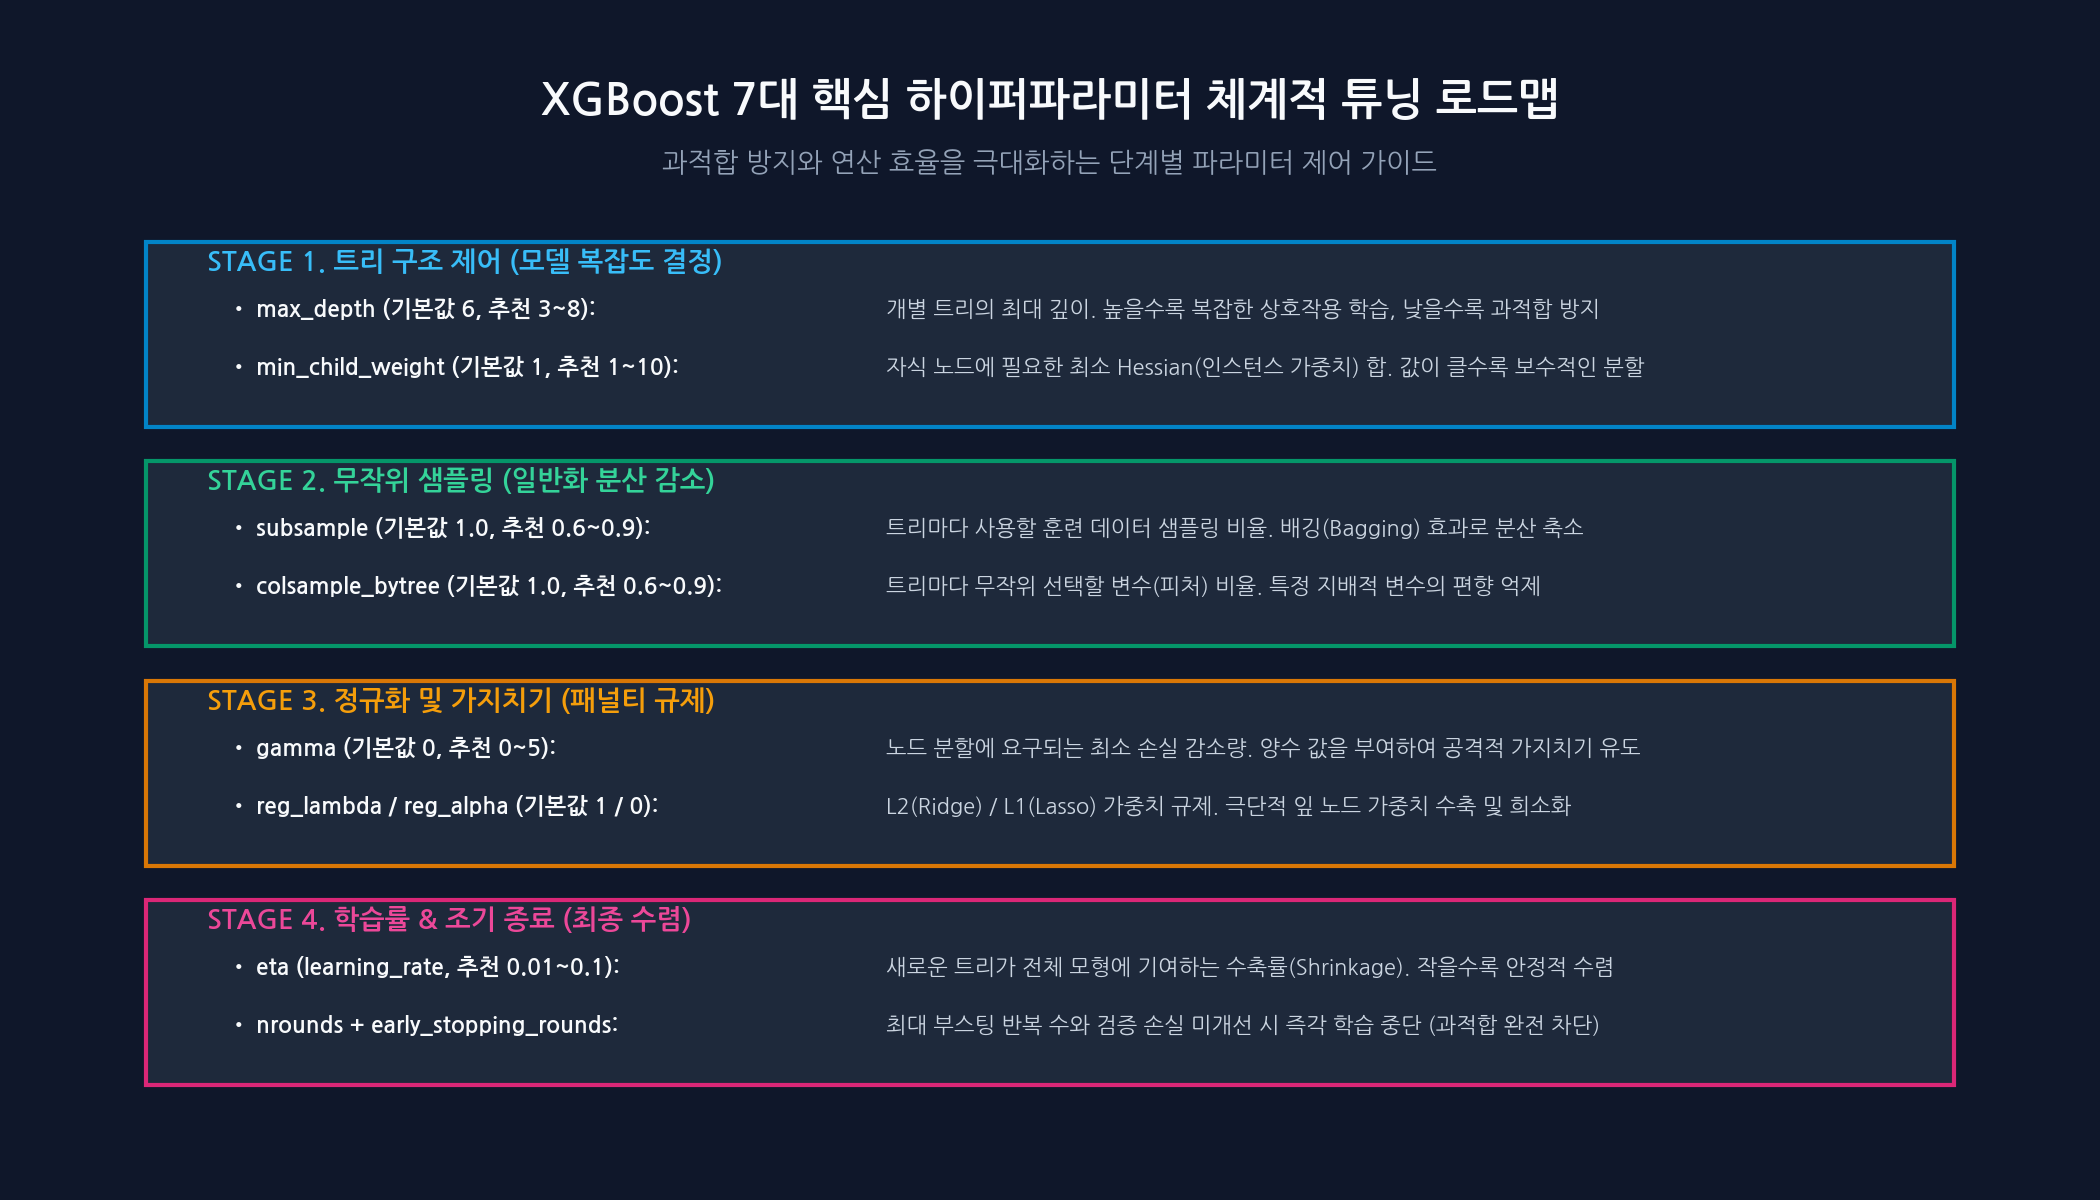
하이퍼파라미터 상세 제어 가이드
| 파라미터명 | 기본값 | 권장 탐색 범위 | 주요 기능 및 튜닝 전략 |
|---|---|---|---|
max_depth |
6 | 3 ~ 8 | 개별 트리의 최대 깊이. 깊을수록 고차 상호작용을 포착하지만 과적합 위험 급증. 정형 데이터 실무에서는 4~6이 가장 안정적 |
min_child_weight |
1 | 1 ~ 10 | 자식 노드 생성에 필요한 최소 Hessian(\(\sum h_i\)) 합. 불균형 데이터셋이나 잡음이 많을 때 값을 높여 과적합 방지 |
subsample |
1.0 | 0.6 ~ 0.9 | 각 트리를 생성할 때 사용할 데이터 샘플링 비율. 확률적(Stochastic) 배깅 효과로 트리의 분산을 줄이고 학습 속도 개선 |
colsample_bytree |
1.0 | 0.6 ~ 0.9 | 각 트리를 빌드할 때 무작위로 선택할 특성(변수) 비율. 특정 지배적 변수에 모델이 편향되는 현상을 방지 |
gamma (min_split_loss) |
0 | 0 ~ 5 | 노드 분할에 요구되는 최소 Gain 임계값. 값이 0보다 크면 보수적인 가지치기가 동작하여 트리 구조를 단순화 |
eta (learning_rate) |
0.3 | 0.01 ~ 0.1 | 새 트리가 기존 앙상블에 기여하는 가중치 수축률. 작을수록 더 많은 트리가 필요하지만 최적해에 부드럽게 수렴 |
nrounds |
100 | 100 ~ 2000 | 총 부스팅 반복 횟수(생성할 트리의 수). early_stopping_rounds와 반드시 결합하여 최적 지점에서 멈추도록 설정 |
5. R 실무 파이프라인: Caret vs Native xgboost
R 환경에서 XGBoost를 구현하는 방법은 크게 두 가지가 있습니다: 1. caret::train(method = 'xgbTree'): 직관적인 포뮬러 문법, 전처리 파이프라인 통합, 다양한 모델 간 비교 평가에 최적 2. xgboost::xgb.cv (Native): DMatrix 기반 초고속 연산, 조기 종료(Early Stopping), 학습 곡선(Loss Curve) 정밀 추적에 최적
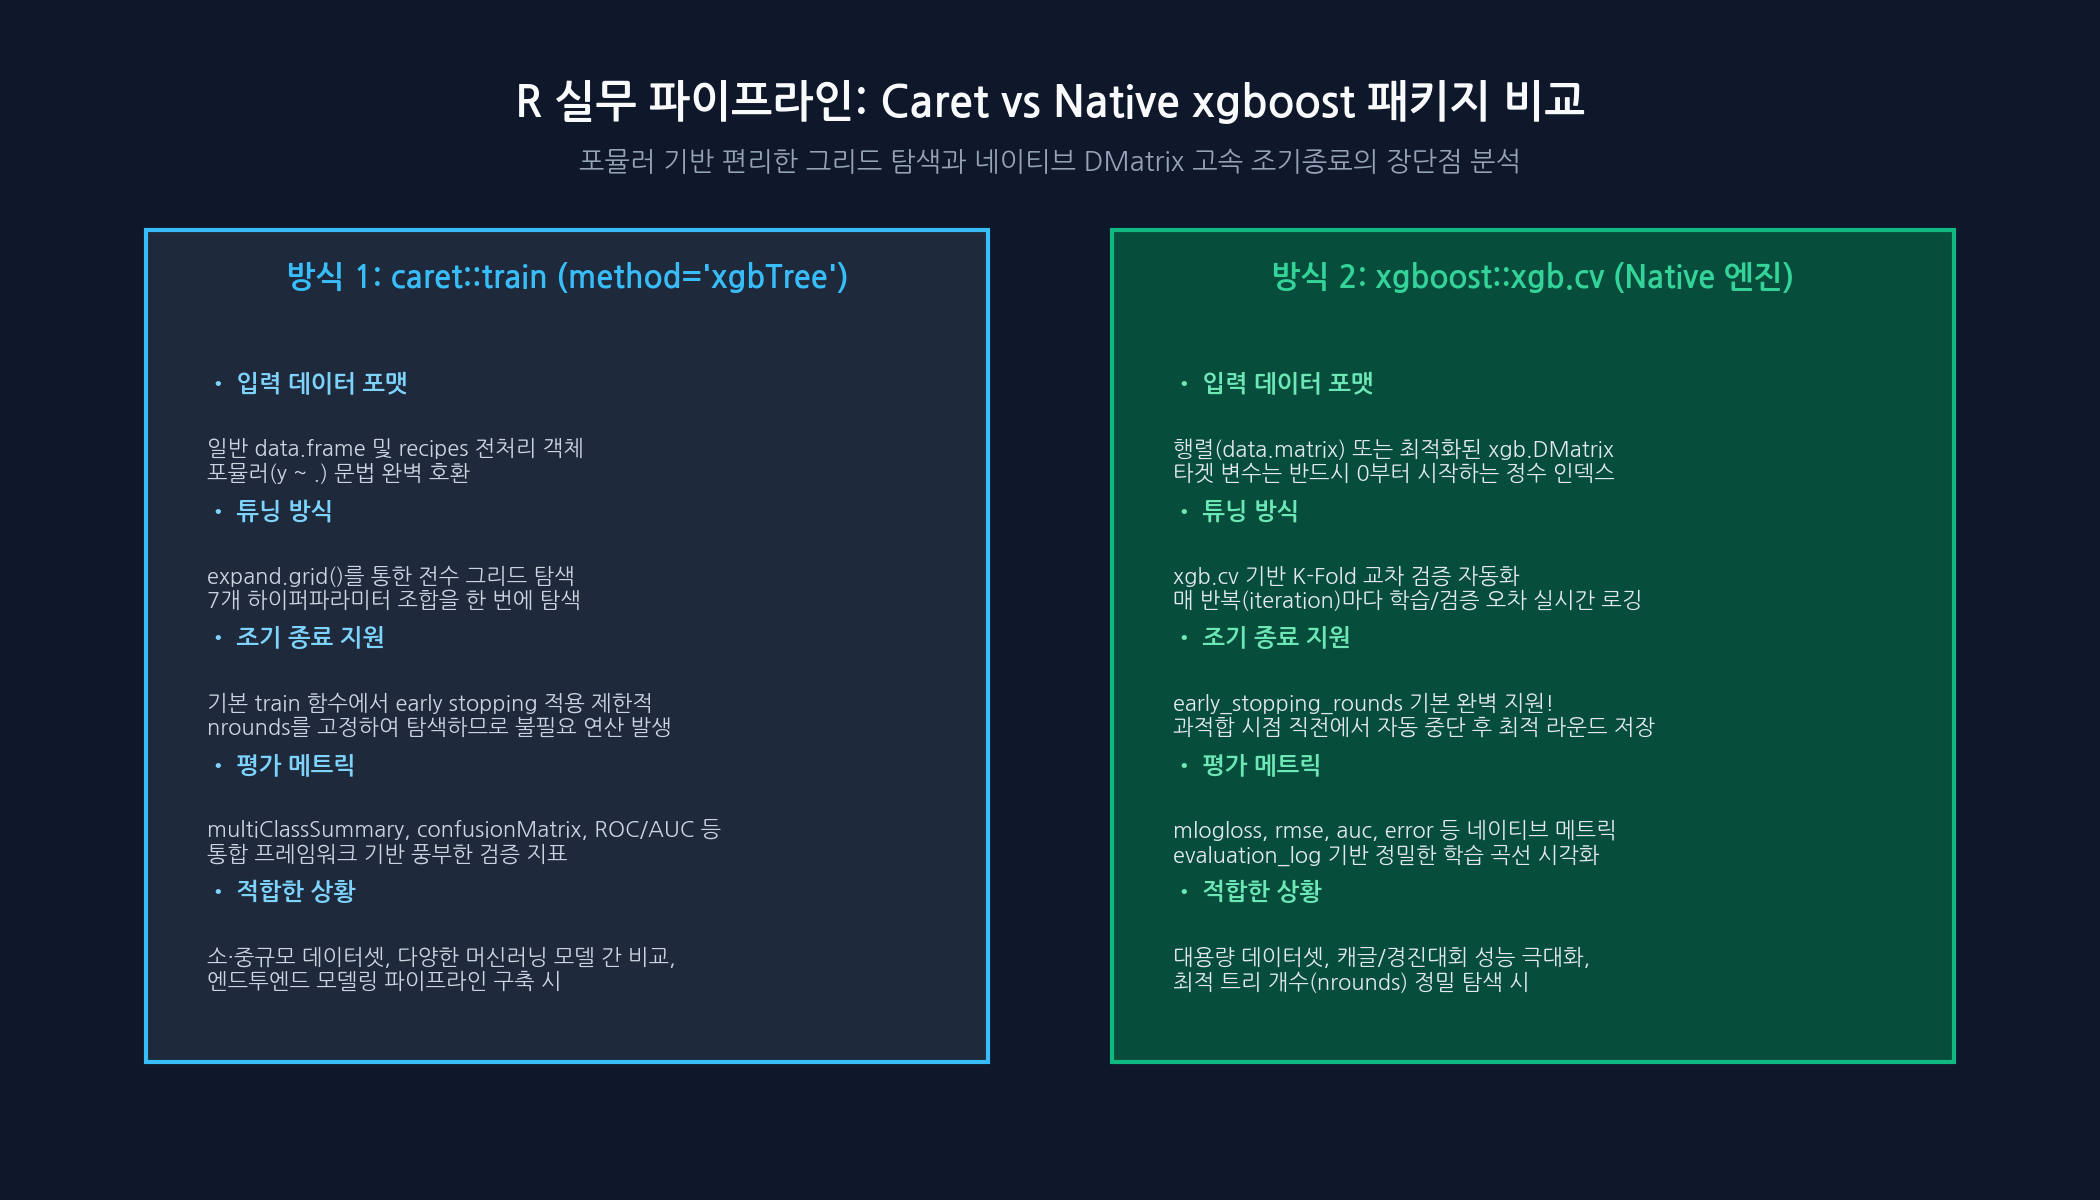
5.1 Caret 패키지를 활용한 그리드 서치 및 변수 중요도 분석
caret의 xgbTree 엔진을 사용하면 7대 하이퍼파라미터의 그리드 서치를 체계적으로 수행할 수 있습니다. 붓꽃(Iris) 데이터셋을 활용하여 3개 품종을 다중 분류하는 예제를 구현해 보겠습니다.
# 필수 패키지 로드
library(tidyverse)
library(caret)
library(xgboost)
library(rsample)
library(recipes)

# 1. 재현성을 위한 시드 고정 및 계층화 분할 (7:3)
set.seed(123)
splits <- initial_split(iris, prop = 0.7, strata = Species)
train_raw <- training(splits)
test_raw  <- testing(splits)

# 2. recipes 전처리 파이프라인 구성
# XGBoost는 정규화에 불변(Invariant)하지만, 범주형 변수의 더미화 및 전처리 계약 표준화
iris_rec <- recipe(Species ~ ., data = train_raw) %>%
  step_normalize(all_numeric_predictors()) %>% # 스케일 정규화
  prep()

train_df <- juice(iris_rec)
test_df  <- bake(iris_rec, new_data = test_raw)

# 3. 5-Fold 교차 검증 및 다중 클래스 평가 제어
control <- trainControl(
  method = "cv",
  number = 5,
  classProbs = TRUE,                  # 클래스별 예측 확률 산출
  summaryFunction = multiClassSummary, # LogLoss, Accuracy, ROC, Sensitivity 등 종합 산출
  savePredictions = "final",
  verboseIter = FALSE
)

# 4. 7대 하이퍼파라미터 튜닝 그리드 설정
tunegrid <- expand.grid(
  nrounds          = c(100, 200),
  max_depth        = c(3, 6),
  eta              = c(0.05, 0.1),
  gamma            = c(0, 1),
  colsample_bytree = c(0.8, 1.0),
  min_child_weight = c(1, 3),
  subsample        = c(0.8, 1.0)
)

cat("총 탐색할 파라미터 조합 수:", nrow(tunegrid), "\n")

# 5. XGBoost 모델 훈련 (최적화 메트릭: logLoss)
xgb_caret_fit <- train(
  Species ~ .,
  data       = train_df,
  method     = "xgbTree",
  metric     = "logLoss",
  trControl  = control,
  tuneGrid   = tunegrid
)

# 최적 하이퍼파라미터 조합 확인
print(xgb_caret_fit$bestTune)
훈련된 모델의 변수 중요도(Feature Importance)를 추출하고 테스트 데이터셋에서 최종 혼동 행렬(Confusion Matrix)을 산출합니다:
# 6. Information Gain 기반 변수 중요도 산출 및 시각화
var_imp <- varImp(xgb_caret_fit, scale = FALSE)
plot(var_imp, main = "XGBoost Variable Importance (Information Gain)")

# 7. 독립 테스트 세트 일반화 성능 검증
test_pred <- predict(xgb_caret_fit, newdata = test_df)
cm <- confusionMatrix(test_pred, test_df$Species)
print(cm)
5.2 Native xgboost::xgb.cv와 조기 종료(Early Stopping) 파이프라인
caret은 매우 편리하지만, 각 그리드마다 nrounds만큼 끝까지 트리를 생성하므로 연산 비용이 낭비될 수 있습니다. 대규모 실무 프로젝트에서는 네이티브 xgb.cv의 early_stopping_rounds 기능을 사용하여, 검증 손실(Validation Loss)이 일정 횟수 이상 개선되지 않으면 즉시 학습을 중단시키는 기법이 필수적입니다.
[R 실무 주의사항: 0-indexed Labels]
C++ 엔진으로 작성된 네이티브xgboost는 타겟 클래스를 파이썬처럼 0부터 시작하는 정수(0, 1, 2, …)로 인식합니다. R의 팩터(Factor)는 1부터 시작하므로 반드시as.numeric(y) - 1로 변환해야 에러가 발생하지 않습니다!
# 1. 설명변수 행렬(matrix)과 0-인덱스 타겟 벡터 준비
x_train <- train_raw %>% select(-Species) %>% as.matrix()
y_train <- as.numeric(train_raw$Species) - 1 # 0: setosa, 1: versicolor, 2: virginica

x_test  <- test_raw %>% select(-Species) %>% as.matrix()
y_test  <- as.numeric(test_raw$Species) - 1

# 2. 고속 연산을 위한 xgb.DMatrix 객체 생성
dtrain <- xgb.DMatrix(data = x_train, label = y_train)
dtest  <- xgb.DMatrix(data = x_test, label = y_test)

# 3. 모델 파라미터 리스트 정의
params <- list(
  booster          = "gbtree",
  objective        = "multi:softprob", # 클래스별 확률 출력
  num_class        = 3,
  eval_metric      = "mlogloss",       # 다중 클래스 로그 손실
  eta              = 0.05,
  max_depth        = 4,
  min_child_weight = 1,
  subsample        = 0.8,
  colsample_bytree = 0.8,
  gamma            = 0.5,
  lambda           = 1.0
)

# 4. xgb.cv를 활용한 5-Fold 교차 검증 및 조기 종료 실행
set.seed(42)
cv_model <- xgb.cv(
  params                = params,
  data                  = dtrain,
  nfold                 = 5,
  nrounds               = 500,         # 충분히 큰 최대 반복 수 지정
  early_stopping_rounds = 30,          # 30라운드 동안 mlogloss 미개선 시 조기 중단
  verbose               = FALSE,
  prediction            = TRUE
)

cat("최적의 부스팅 라운드 (best_iteration):", cv_model$best_iteration, "\n")
cat("검증셋 최소 mlogloss:", min(cv_model$evaluation_log$test_mlogloss_mean), "\n")
xgb.cv 객체의 evaluation_log를 추출하여 라운드별 학습(Train) 오차와 검증(Test) 오차의 추이를 시각화하는 커스텀 함수를 구현해 보겠습니다:
# 5. Cross-Validation 학습 곡선(Learning Curve) 시각화 함수
plot_xgb_learning_curve <- function(cv_res) {
  eval_log <- cv_res$evaluation_log

  # Train 및 Test 손실 데이터를 롱 포맷으로 재구성
  df_plot <- data.frame(
    nround = rep(eval_log$iter, 2),
    loss   = c(eval_log$train_mlogloss_mean, eval_log$test_mlogloss_mean),
    split  = rep(c("Train", "CV-Test"), each = nrow(eval_log))
  )

  ggplot(df_plot, aes(x = nround, y = loss, color = split)) +
    geom_line(linewidth = 1.1) +
    geom_vline(xintercept = cv_res$best_iteration, linetype = "dashed", color = "#ef4444", linewidth = 1) +
    annotate("text", x = cv_res$best_iteration + 10,
             y = max(df_plot$loss) * 0.8,
             label = paste("Best Iteration:", cv_res$best_iteration),
             color = "#ef4444", fontface = "bold") +
    scale_color_manual(values = c("Train" = "#38bdf8", "CV-Test" = "#10b981")) +
    theme_minimal(base_size = 13) +
    labs(
      title = "XGBoost 5-Fold CV Learning Curve with Early Stopping",
      subtitle = paste("Optimal rounds discovered without overfitting (early_stopping_rounds = 30)"),
      x = "Boosting Iterations (nrounds)",
      y = "Multi-class LogLoss (mlogloss)",
      color = "Dataset"
    ) +
    theme(
      legend.position = "top",
      plot.title = element_text(face = "bold", size = 15)
    )
}

# 학습 곡선 출력
plot_xgb_learning_curve(cv_model)
이 학습 곡선 그래프를 확인하면, 반복 횟수가 증가함에 따라 Train 손실은 0에 가깝게 계속 떨어지지만 CV-Test 손실은 특정 라운드 이후 더 이상 감소하지 않고 횡보하거나 반등하는 과적합의 변곡점을 시각적으로 명확하게 확인할 수 있습니다.
5.3 최적 라운드로 최종 단일 모델 피팅 및 배포
교차 검증을 통해 최적의 트리 개수(best_iteration)를 찾았다면, 전체 훈련 세트를 사용하여 최종 모델을 단 한 번 피팅합니다:
# 6. 최적 nrounds로 전체 훈련 데이터 기반 최종 모델 학습
final_xgb <- xgb.train(
  params  = params,
  data    = dtrain,
  nrounds = cv_model$best_iteration,
  verbose = FALSE
)

# 7. 테스트 데이터 예측 및 클래스 할당
pred_prob <- predict(final_xgb, newdata = dtest, reshape = TRUE)
pred_class <- max.col(pred_prob) - 1

# 혼동 행렬 및 최종 성능 리포트
test_cm <- caret::confusionMatrix(
  factor(pred_class, levels = c(0, 1, 2), labels = levels(iris$Species)),
  factor(y_test, levels = c(0, 1, 2), labels = levels(iris$Species))
)

print(test_cm$overall["Accuracy"])
print(test_cm$table)
6. 과적합 발생 시 즉시 처방하는 4단계 체크리스트
XGBoost 모델을 실무에 적용했을 때 훈련 세트의 성능은 99%인데 검증 세트의 성능이 현저히 떨어진다면, 다음 순서대로 하이퍼파라미터를 조정하십시오:
- 1단계: 트리 깊이(
max_depth) 축소 &min_child_weight상향max_depth를 6에서 3~4로 줄이고,min_child_weight를 1에서 3~5로 올립니다. 이 두 값만으로도 모델의 자유도(Degrees of Freedom)가 급격히 제어됩니다.
- 2단계: 확률적 샘플링 비율 축소 (
subsample,colsample_bytree)- 두 파라미터를 모두 0.7~0.8 수준으로 설정합니다. 매 트리마다 서로 다른 데이터와 특성을 학습하게 되어 앙상블의 다양성이 증대되고 분산이 획기적으로 감소합니다.
- 3단계: 정규화 강도 부여 (
gamma,lambda,alpha)gamma를 1.0~3.0으로 설정하여 이득이 미미한 노드 분할을 강제로 잘라냅니다.- 가중치 폭주가 의심될 경우
lambda(L2)를 5~10으로 높여 잎 가중치를 0으로 수축시킵니다.
- 4단계: 학습률(
eta) 인하 및early_stopping_rounds결합eta를 0.01~0.03으로 대폭 낮추고early_stopping_rounds = 50을 설정합니다. 보폭을 잘게 쪼개어 검증 손실이 최저점을 찍는 지점을 정밀하게 포착합니다.
7. 마치며: XGBoost를 진정으로 이해한다는 것
XGBoost는 정형 머신러닝 분야에서 오랫동안 쌓여온 공학적 최적화의 집대성입니다. - 손실함수를 2차 테일러 급수로 근사함으로써 어떤 미분 가능한 손실함수든 단일 수식 체계 안에서 최적화할 수 있는 범용성을 확보했고, - 목적함수에 내장된 정규화 항(\(\gamma T + \frac{1}{2}\lambda \sum w^2\))을 통해 수학적으로 보장된 과적합 방지 구조를 완성했습니다.
단순히 패키지 라이브러리를 블랙박스로 호출하는 수준을 넘어, 목적함수의 최적 가중치 \(w_j^* = -\frac{G_j}{H_j + \lambda}\)와 노드 분할 게인 공식이 어떻게 동작하는지 이해하는 엔지니어만이 데이터의 특성에 맞게 하이퍼파라미터를 완벽하게 제어할 수 있습니다.
이번 글에서 다룬 이론적 유도와 R 실무 파이프라인(caret 그리드 서치 및 xgb.cv 조기 종료)을 여러분의 실무 프로젝트나 데이터 경진대회 분석 파이프라인에 직접 적용해 보시길 권장합니다.
💡 연관 포스트 안내
- 앙상블 학습 완벽 가이드: 배깅, 부스팅, 랜덤 포레스트부터 보팅까지
- 서포트 벡터 머신(SVM) 완전 정복: 마진 최대화부터 커널 트릭, SVR & R 실습
- 나이브 베이즈 분류기 완벽 정복: 베이즈 정리부터 라플라스 스무딩, R 실습까지