flowchart LR
    subgraph 측정모형 ["1단계: 측정모형 (CFA)"]
        direction TB
        M1["설문 문항<br/>(관측변수)"] --> M2["잠재개념 도출<br/>(신뢰도·타당도 검증)"]
    end

    subgraph 구조모형 ["2단계: 구조모형 (Path)"]
        direction TB
        S1["원인 잠재변수<br/>(독립)"] == 가설 검증 경로 ==> S2["결과 잠재변수<br/>(종속)"]
    end

    측정모형 == "측정 품질 합격 시 이행" ==> 구조모형

    style 측정모형 fill:#F1F5F9,stroke:#64748B,stroke-width:2px
    style 구조모형 fill:#EFF6FF,stroke:#3B82F6,stroke-width:2px
💡 핵심 요약 (Executive Summary):
- 측정모형(Measurement Model)의 존재 이유: 사회과학, 경영학, 심리학, 정보시스템(IT) 등 실증 연구에서 다루는 ‘만족도’, ‘신뢰’, ‘성과기대’ 같은 잠재변수는 직접 잴 수 없습니다. 설문 문항(관측변수)으로 이를 간접 측정할 때 발생하는 측정오차를 걸러내고 개념이 올바르게 측정되었는지 입증하는 절차가 바로 확인적 요인분석(CFA) 기반의 측정모형 평가입니다.
- 측정모형 검증의 3대 핵심 질문: ① 전체 모형이 실제 데이터의 공분산을 잘 재현하는가?(전체 적합도: \(\chi^2\), CFI, TLI, RMSEA, SRMR), ② 문항들이 개념을 오차 없이 일관되게 대변하는가?(문항 신뢰도 \(\lambda \ge .70\), \(SMC \ge .50\), 내적 신뢰도 \(\text{CR} \ge .70\), 수렴타당도 \(\text{AVE} \ge .50\)), ③ 서로 다른 개념끼리 겹치지 않고 뚜렷이 구별되는가?(판별타당도: Fornell-Larcker, HTMT \(< .85\)).
- 연구자들이 가장 많이 빠지는 치명적 함정:
- AMOS의 회귀계수 검정 통계량인
C.R.(임계치/z값)을 합성신뢰도(CR)로 착각하여 논문에 “신뢰도가 6.82로 우수하다”고 적는 오류- 왜 \(\text{CR}\)은 0.85로 넉넉하게 합격인데 \(\text{AVE}\)는 0.44로 탈락하는지 수식의 기하학적 원리를 몰라 문항만 마구잡이로 지우는 행위
- Fornell-Larcker 기준의 맹점(불량 개념 탐지율 14.59%)을 보완하는 최신 기준인 HTMT를 누락하여 심사위원의 지적을 받는 경우
- 본 가이드는 수식의 직관적 원리, 실제 계산 시뮬레이션 예제, R 실습 코드(
lavaan), 그리고 학위논문 및 학술지에 바로 복사해 쓸 수 있는 표준 기술 템플릿을 제공합니다.
0. 왜 심사위원은 가설 검증 결과보다 ’측정모형 표’를 먼저 볼까?
석·박사 학위논문이나 KCI·SSCI 학술지 투고를 준비하는 연구자들이 가장 설레는 순간은 구조방정식 모형(SEM)을 돌려 “독립변수가 종속변수에 미치는 영향 경로에 드디어 유의확률 별(\(p < .001\))이 세 개 떴을 때”입니다.
하지만 논문 심사위원이나 저널 리뷰어가 원고를 받으면, 뒤편의 가설 검증 결과는 쳐다보지도 않고 제일 먼저 [제4장 연구 결과]의 ‘측정모형 적합도 및 타당도 분석 표’로 직행합니다. 그리고 다음과 같은 질문을 던집니다.
“선생님, CFI가 0.86인데 왜 구조모형을 돌리셨습니까?”
“Cronbach’s \(\alpha\)는 0.88인데, 왜 AVE는 0.41밖에 안 나오나요? 문항이 개념을 절반도 설명 못 하고 있는데요?”
“AMOS 결과표의 C.R.이 7.4라고 적어놓으셨는데, 신뢰도 계수가 어떻게 1.0을 넘습니까? Critical Ratio와 Composite Reliability를 구분 못 하신 것 아닙니까?”
이 단계에서 방어하지 못하면 연구자가 피땀 흘려 세운 가설 검증 결과는 한순간에 물거품이 됩니다. 데이터 과학의 대원칙인 “Garbage In, Garbage Out(쓰레기가 들어가면 쓰레기가 나온다)” 때문입니다.
잠재변수를 측정하는 자(Ruler)가 휘어져 있거나 눈금이 엉터리라면, 그 자로 잰 물건의 인과관계를 통계적으로 아무리 정교하게 회귀분석하더라도 그 결론은 허구에 불과합니다. 따라서 측정모형 평가는 가설 검증으로 가기 위해 반드시 거쳐야 하는 필수 관문입니다.
1. 측정모형 평가의 전체 프레임워크와 핵심 철학
1-1. 측정모형 검증의 3대 질문
CFA 측정모형을 평가할 때 연구자는 서로 독립적인 세 단계의 질문을 순서대로 통과해야 합니다. 한 영역이 우수하다고 해서 다른 영역이 자동으로 보장되지 않습니다.
flowchart TD
    A["CFA 측정모형 검증 3대 체계"] --> B["① 전체 모형 적합도<br/>(Global Model Fit)"]
    A --> C["② 개별 구성개념 품질<br/>(Reliability & Convergent Validity)"]
    A --> D["③ 구성개념 간 구별성<br/>(Discriminant Validity)"]

    B --> B1["'전체 모형이 실제 데이터의<br/>공분산을 잘 재현하는가?'"]
    B --> B2["χ², χ²/df, CFI, TLI, RMSEA, SRMR"]

    C --> C1["'문항들이 개념을 오차 없이,<br/>일관되게 잘 측정하는가?'"]
    C --> C2["요인적재량(λ), SMC, Cronbach α, CR, AVE"]

    D --> D1["'서로 다른 잠재변수들이<br/>통계적으로 뚜렷이 구별되는가?'"]
    D --> D2["Fornell-Larcker 준거, HTMT"]

    style A fill:#0F172A,stroke:#0F172A,stroke-width:2px,color:#FFFFFF
    style B fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style C fill:#DCFCE7,stroke:#16A34A,stroke-width:1.5px
    style D fill:#FCE7F3,stroke:#DB2777,stroke-width:1.5px
- 질문 1: 전체 모형은 수집된 자료에 잘 부합하는가? (전체 모형 적합도)
연구자가 이론에 따라 그린 잠재변수와 관측변수 간의 구조(모형 공분산 행렬 \(\Sigma(\theta)\))가 실제 응답자들로부터 얻은 데이터(표본 공분산 행렬 \(S\))와 전반적으로 일치하는지 확인합니다. - 질문 2: 각 구성개념은 문항들에 의해 충실히 측정되는가? (신뢰도 및 수렴타당도)
설문 문항들이 측정오차를 최소화하고 잠재변수의 분산을 충분히 설명하는지, 같은 개념을 재는 문항들이 일관되게 뭉치는지를 검증합니다. - 질문 3: 서로 다른 구성개념끼리는 명확히 구별되는가? (판별타당도)
이론적으로 분리되어야 하는 두 개 이상의 잠재변수(예: ‘직무만족’과 ’조직몰입’)가 실제 데이터상에서도 겹치지 않고 독립된 실체로 분리되는지 확인합니다.
1-2. CB-SEM과 PLS-SEM: 지표를 바라보는 두 가지 렌즈
구조방정식 분석 소프트웨어는 작동 엔진에 따라 공분산 기반 구조방정식(CB-SEM)과 부분최소제곱 구조방정식(PLS-SEM)으로 나뉩니다. 두 방식은 목표가 다르므로 지표의 우선순위도 다릅니다.
| 비교 항목 | CB-SEM (AMOS, LISREL, Mplus, R-lavaan) | PLS-SEM (SmartPLS, R-cSEM) |
|---|---|---|
| 수학적 목표 | 표본 공분산(\(S\))과 모형 공분산(\(\Sigma\))의 일치 극대화 | 잠재변수 분산 최대화 및 종속변수의 설명력(\(R^2\)) 극대화 |
| 분석 철학 | 이론 검증 및 확증 (Theory Confirmation) | 인과관계 예측 및 탐색 (Exploratory / Prediction) |
| 최우선 평가 지표 | 전체 모형 적합도 (\(\chi^2\), CFI, TLI, RMSEA, SRMR) | 측정 품질 및 설명력 (Loading, CR, AVE, HTMT, \(R^2\)) |
| 표본 수 요구 | 최소 200~300명 이상 권장 (다변량 정규성 민감) | 상대적으로 작은 표본에서도 분석 가능 (비모수적) |
📌 실무 조언:
전통적인 학위논문이나 경영·사회과학 논문은 대부분 CB-SEM(AMOS 또는 R-lavaan)을 사용하므로 전체 모형 적합도 검증이 필수입니다. 반면 최신 연구에서는 Fornell-Larcker 기준의 허점을 보완하기 위해 PLS-SEM 진영에서 개발된 HTMT를 CB-SEM 논문에도 적극적으로 병행 보고하는 것이 최신 트렌드입니다.
2. 전체 모형 적합도(Model Fit) 완전 정복
2-1. 적합도 지수의 3대 분류 체계
많은 초보 연구자가 “적합도 지수는 높을수록 좋은 것 아닌가?”라고 뭉뚱그려 생각합니다. 하지만 통계학적으로 적합도 지수는 평가 방식에 따라 세 가지로 명확히 나뉩니다.
| 분류 | 정의 및 평가 원리 | 대표 지표 | 양호 판정 방향 |
|---|---|---|---|
| 절대적합도 (Absolute Fit) |
다른 기준 모형을 두지 않고, 수집된 원자료와 연구 모형 간의 절대적 차이(불일치도)를 직접 평가 | \(\chi^2\), RMSEA, SRMR, GFI, AGFI | • \(\chi^2\), RMSEA, SRMR: 0에 가까울수록 우수 • GFI, AGFI: 1에 가까울수록 우수 |
| 증분적합도 (Incremental Fit) |
모든 변수가 완전히 무상관하다고 가정한 최악의 모형(영모형, Null Model) 대비 연구 모형이 적합도를 얼마나 개선했는지를 비율로 평가 | CFI, TLI (NNFI), NFI, IFI | • 모든 지표 공통: 1에 가까울수록 우수 (보통 \(\ge .90\) 또는 \(\ge .95\)) |
| 정보기준 (Information Criteria) |
모형 적합도뿐만 아니라 파라미터 수(모형의 복잡도)에 페널티를 부여하여 경쟁 모형 간 우수성을 상대 비교 | AIC, BIC, SABIC | • 절대적 기준선 없음 • 경쟁 모형 중 낮을수록 우수 |
⚠️ 흔한 오해 바로잡기: 절대적합도의 ’절대’의 의미
’절대적합도’라는 말은 0에 가까워야 한다는 뜻이 아닙니다. “독립모형(Null Model)과의 상대적 비교를 거치지 않고 오직 연구자 모형 자체의 공분산 재생산 능력만을 본다”는 의미입니다. 따라서 오차를 측정하는 RMSEA나 SRMR은 작을수록 좋고, 적합된 분산 비율을 측정하는 GFI는 1에 가까울수록 좋은 것입니다.
2-2. 카이제곱(\(\chi^2\)) 검정의 역설과 \(\chi^2/df\)의 실체
공분산 구조분석에서 가장 원초적인 적합도 검정은 카이제곱(\(\chi^2\)) 검정입니다.
\[\chi^2 = (N - 1) \cdot F_{ML}\]
- 귀무가설(\(H_0\)): \(\Sigma(\theta) = S\) (연구자의 이론적 모형 공분산은 모집단의 실제 공분산과 차이가 없다.)
- 통계적 해석: \(p \ge .05\)이면 귀무가설을 기각하지 못하므로, “내 모형이 데이터와 일치한다”는 뜻이 됩니다.
[ 카이제곱 검정의 표본 크기 역설 ]

표본 크기(N) 증가 ──> 검정력(Statistical Power) 급증 ──> 현실적으로 무시할 수 있는 미세한 오차도 유의미한 차이로 감지
                                                                 │
                                                                 ▼
                                                        p < .05 (모형 기각 발생!)
현실의 설문 연구는 표본 크기가 보통 200~500명 이상입니다. 이 정도 표본에서는 모형이 아무리 훌륭해도 \(p < .001\)이 나와 귀무가설이 칼같이 기각됩니다.
- 보고 원칙: “최근 학계에서는 카이제곱을 안 본다”는 말은 사실이 아닙니다. \(\chi^2\) 통계량, 자유도(\(df\)), \(p\)값은 학술 보고 시 무조건 기재하는 것이 의무입니다. 다만 단독으로 채택 여부를 결정하지 않고, 표본 크기에 둔감한 CFI, TLI, RMSEA, SRMR을 종합하여 최종 판정합니다.
- \(\chi^2/df\) (CMIN/DF): 표본 크기 왜곡을 줄이기 위해 자유도로 나눈 지표입니다. 보통 \(< 3.0\) (엄격하게는 \(< 2.0\), 느슨하게는 \(< 5.0\))을 양호한 수준으로 보지만, 이는 이론적 절대 기준이 아닌 경험적 보조 기준(Rule of Thumb)으로 활용해야 합니다.
2-3. 현대 CFA의 핵심 4대 적합도 지표와 실무 판정선
현대 방법론(Hu & Bentler, 1999)에서는 표본 크기 왜곡이 적고 모형 간명성을 적절히 평가하는 CFI, TLI, RMSEA, SRMR을 핵심 4대 지표로 삼습니다.
[ 적합도 판단 스펙트럼 ]

CFI / TLI : ──[ 재검토 필요 ]── 0.90 ──[ 수용 가능(Acceptable) ]── 0.95 ──[ 우수(Good) ]──> 1.00
RMSEA     : ──[ 우수(Good) ]── 0.06 ──[ 수용 가능(Acceptable) ]── 0.08 ──[ 재검토 필요 ]──>
SRMR : ──[ 양호한 적합도 ]── 0.08 ────────────────────────────────[ 잔차 과다 ]───>| 지표명 | 수식적 원리 및 의미 | 우수한 적합도 (Good) | 수용 가능 (Acceptable) | 실무적 위상 |
|---|---|---|---|---|
| CFI (Comparative Fit Index) |
영모형 대비 비중심 카이제곱 모수의 감소율. 표본 크기에 매우 안정적 | \(\ge .95\) | \(\ge .90\) | 최우선 핵심 |
| TLI (NNFI) (Tucker-Lewis Index) |
모형의 자유도(간명성)를 고려하여 불필요하게 복잡한 모형에 페널티 부여 | \(\ge .95\) | \(\ge .90\) | 최우선 핵심 |
| RMSEA (Root Mean Square Error of Approx.) |
자유도당 모집단 근사 오차. 반드시 90% 신뢰구간 병기 | \(\le .06\) (상한치 \(\le .08\)) |
\(\le .08\) (상한치 \(\le .10\)) |
최우선 핵심 |
| SRMR (Standardized Root Mean Residual) |
관측 상관행렬과 모형 상관행렬 간의 표준화된 평균 잔차 크기 직접 측정 | \(\le .08\) | \(\le .10\) | 최우선 핵심 |
💡 방어 가능한 실무 기술 팁:
분석 결과가 \(CFI = .941\), \(TLI = .935\), \(RMSEA = .068\), \(SRMR = .052\)로 나왔다면, 이를 “모든 기준을 완벽하게 만족하여 모형 적합도가 대단히 우수하다”고 과장하면 심사위원의 먹잇감이 됩니다.
엄격한 기준(\(\ge .95, \le .06\))에는 미치지 못하지만 실무 수용 기준(\(> .90, < .08\))을 명확히 충족하므로, “선행 연구(Hu & Bentler, 1999; Hair et al., 2010)의 기준에 비추어 전반적으로 수용 가능한(Acceptable) 수준의 적합도를 나타냈다”고 보수적·객관적으로 서술하는 것이 훨씬 학술적입니다.
3. 개별 문항 평가와 신뢰도(Reliability) 검증
전체 모형 적합도가 통과되었다면, 이제 망원경을 들이대어 개별 문항들이 잠재변수를 얼마나 충실하게 측정하는지 살펴봐야 합니다.
3-1. 요인적재량(\(\lambda\))과 SMC(\(R^2\)): 왜 하필 0.70인가?
- 표준화 요인적재량(\(\lambda\), Factor Loading): 잠재변수가 1단위 변할 때 문항이 몇 단위 변하는지를 나타내는 표준화 계수로, 잠재변수와 문항 간의 상관계수 역할을 합니다.
- SMC (Squared Multiple Correlation, \(R^2\)): 문항의 전체 분산 중 잠재변수에 의해 설명되는 분산의 비율을 말하며, 개별 지표 신뢰도(Indicator Reliability)라고 부릅니다.
단순 측정모형에서 두 지표 사이에는 다음과 같은 명쾌한 수학적 관계가 성립합니다.
\[\boxed{SMC = \lambda^2}, \quad \text{오차분산}(\theta) = 1 - \lambda^2\]
[ 문항 총 분산(100%)의 내부 구조 ]

┌─────────────────────────────────────────────────────────────┐
│  잠재변수가 설명하는 분산 (SMC = λ²)        │ 측정오차 분산 (θ = 1 - λ²)   │
│  [================= 50% =================] │ [================ 50% ================] │
└─────────────────────────────────────────────────────────────┘
                      ▲
                      │
               SMC = 0.50 지점 ──> λ = √0.50 ≈ 0.707
많은 개론서나 강의에서 “요인적재량은 0.60 이상, SMC는 0.50 이상이어야 한다”고 병기하지만, 이는 수학적으로 앞뒤가 안 맞는 설명입니다. * 만약 \(\lambda = 0.60\)이라면, \(SMC = 0.60^2 = 0.36(36\%)\)이 되어 \(SMC \ge .50\)을 만족하지 못합니다. * 반대로 “문항 분산의 절반(50%) 이상은 측정오차가 아니라 잠재변수에 의해 설명되어야 한다”는 최소한의 상식을 만족하려면, 요인적재량은 필연적으로 다음을 만족해야 합니다. \[\lambda \ge \sqrt{0.50} \approx \mathbf{0.707}\]
따라서 학술 연구의 표준 권장선은 \(\lambda \ge .70\) (\(p < .001\))입니다. 다만 탐색적 연구나 문항 보존이 중요한 경우 내용타당도와 뒤에서 다룰 AVE 값을 종합 고려하여 \(.50 \sim .70\) 구간을 조건부 허용하기도 합니다.
3-2. 내적 일관성 신뢰도: Cronbach’s \(\alpha\) vs 합성신뢰도(CR)
신뢰도(Reliability)의 본질은 측정의 일관성과 안정성입니다. “동일한 성향을 가진 사람이 응답했을 때 노이즈 없이 일관된 점수가 나오는가?”를 평가합니다.
[ Cronbach's α vs 합성신뢰도(CR)의 가정 차이 ]

Cronbach's α (Tau-Equivalence 동등 가정)      합성신뢰도 CR (Congeneric 현실 반영)
        잠재변수 (η)                                  잠재변수 (η)
     ┌───────┼───────┐                             ┌───────┼───────┐
     │λ=0.7  │λ=0.7  │λ=0.7                        │λ=0.85 │λ=0.72 │λ=0.61
     ▼       ▼       ▼                             ▼       ▼       ▼
   [문항1]  [문항2]  [문항3]                     [문항1]  [문항2]  [문항3]
  "모든 문항의 기여도가 똑같다"                   "문항마다 품질(적재량)이 다르다"
-> 실제 신뢰도를 과소추정함 -> 실제 데이터 구조를 정밀 반영- 크론바흐 알파(Cronbach’s \(\alpha\))의 치명적 한계:
모든 문항의 요인적재량이 동일하다는 엄격한 동등타우(Tau-equivalence) 가정에 기반합니다. 하지만 현실 데이터에서 문항들의 품질은 제각각입니다. 따라서 \(\alpha\) 계수는 척도의 실제 신뢰도를 체계적으로 과소추정(Underestimation)하는 결함을 가집니다. - 합성신뢰도(CR, Composite Reliability / McDonald’s \(\omega\)):
문항마다 서로 다른 요인적재량(\(\lambda_i\))과 오차분산(\(\theta_i\))을 개별 반영하여 척도 묶음 전체의 진점수 신뢰도를 산출합니다.- 합격 기준: \(\text{CR} \ge .70\) (탐색적 연구 \(.60\) 이상)
\[\boxed{\text{CR} = \frac{\left( \sum_{i=1}^n \lambda_i \right)^2}{\left( \sum_{i=1}^n \lambda_i \right)^2 + \sum_{i=1}^n \theta_i}}\]
(단, \(\lambda_i\)는 \(i\)번째 문항의 표준화 요인적재량, \(\theta_i = 1 - \lambda_i^2\)는 개별 문항의 표준화 오차분산)
3-3. 🚨 AMOS 사용자 필독: CR(합성신뢰도) vs C.R.(임계비)의 비극
AMOS 프로그램을 처음 접하는 연구자들이 학위논문에서 가장 많이 저지르는 치명적 실수가 바로 이 ‘동음이의어 CR’입니다.
| 구분 | Composite Reliability (CR) | Critical Ratio (C.R.) |
|---|---|---|
| 한글 명칭 | 합성신뢰도 (개념신뢰도) | 임계치 (임계비 / 검정통계량 \(z\)값) |
| 통계적 의미 | 척도의 내적 일관성 신뢰도 지표 | 회귀계수가 0인지 아닌지 검정하는 통계량 (\(\frac{\text{Estimate}}{\text{S.E.}}\)) |
| 수치 범위 | \(0.00 \sim 1.00\) | \(-\infty \sim +\infty\) |
| 합격 기준 | \(\ge .70\) 이면 신뢰도 확보 | \(|C.R.| \ge 1.96\) 이면 \(p < .05\) 유의미 |
| AMOS 출력 여부 | 자동 출력 안 됨! (별도 엑셀 수식이나 플러그인 필요) | Regression Weights 표의 기본 열로 자동 출력됨 |
⛔ 주의: AMOS 결과표의
C.R.열에 적힌 \(5.42\), \(8.19\) 같은 숫자를 보고 “신뢰도가 5.42로 매우 높게 나타났다”고 논문에 쓰면, 심사위원에게 “통계 기본도 모르는 연구자”로 찍히게 됩니다. AMOS가 출력해 주는 C.R.은 \(t\)값(\(z\)값)일 뿐이므로, 합성신뢰도 CR은 표준화 적재량을 엑셀에 넣어 직접 계산해야 합니다.
4. 타당도(Validity)의 두 기둥: 수렴타당도 vs 판별타당도
신뢰도가 “도구가 일관된가?”를 묻는다면, 타당도(Validity)는 “도구가 측정하고자 의도한 바로 그 개념을 정확하게 재어내고 있는가?”를 묻습니다.
flowchart LR
    V["타당도 (Validity)<br/>의도한 것을 정확히 쟀는가?"]
    V --> CV["수렴타당도 (Convergent)<br/>같은 개념끼리 한곳으로 모이는가?"]
    V --> DV["판별타당도 (Discriminant)<br/>다른 개념끼리 확실히 구별되는가?"]

    CV --> AVE["핵심 지표: AVE ≥ 0.50"]
    DV --> FL["기준 1: Fornell-Larcker (√AVE > r)"]
    DV --> HTMT["기준 2: HTMT < 0.85 (or 0.90)"]

    style V fill:#0F172A,stroke:#0F172A,stroke-width:2px,color:#FFFFFF
    style CV fill:#DCFCE7,stroke:#16A34A,stroke-width:1.5px
    style DV fill:#FCE7F3,stroke:#DB2777,stroke-width:1.5px
4-1. 수렴타당도(Convergent Validity)와 AVE
수렴타당도는 하나의 잠재변수를 구성하는 지표 문항들이 얼마나 한 방향으로 강하게 뭉쳐 있는가를 평가합니다. 그 중심에 평균분산추출값(AVE, Average Variance Extracted)이 있습니다.
- AVE의 직관적 공식: 각 문항의 요인적재량을 제곱(\(\lambda^2\))하여 분산 설명력을 구한 뒤, 이를 산술평균 낸 값입니다.
- 판정 기준: \(AVE \ge .50\) (잠재변수가 설명하는 분산이 측정오차 분산보다 커야 함).
\[\boxed{AVE = \frac{\sum_{i=1}^n \lambda_i^2}{n}}\]
4-2. 연구자들의 최대 미스터리: 왜 CR은 합격인데 AVE는 탈락할까?
실제 데이터를 분석하다 보면 다음과 같은 기이한 현상에 직면하여 밤을 새우는 연구자들이 부지기수입니다.
“선생님, 제 척도의 합성신뢰도(CR)는 0.74로 기준(0.70)을 넘겼는데, 왜 AVE는 0.48로 기준(0.50) 미달로 빨간불이 켜질까요?”
두 공식의 계산 메커니즘을 뜯어보면 이유가 명쾌하게 드러납니다.
[ CR과 AVE의 계산 메커니즘 비교 ]

           적재량 합의 제곱                     적재량 제곱의 합
CR  = ─── (Σ λ)² ───              AVE = ─── Σ (λ²) ───  ÷  n
        분자 + Σ (1 - λ²)

* CR: 적재량을 먼저 다 더한 뒤 괄호째 제곱하므로 '신호(Signal)'가 지수적으로 증폭됨.
* AVE: 문항별 품질(λ²)을 개별 계산하여 단순 평균 낸 순수 지표.
[실제 사례 시뮬레이션]
어떤 설문 척도의 문항별 요인적재량이 \(Q1 = 0.80\), \(Q2 = 0.75\), \(Q3 = 0.50\)으로 도출되었다고 가정해 보겠습니다.
- AVE 계산: \[AVE = \frac{0.80^2 + 0.75^2 + 0.50^2}{3} = \frac{0.64 + 0.5625 + 0.25}{3} = \frac{1.4525}{3} = \mathbf{0.484} \quad (< 0.50 \ \mathbf{탈락!})\]
- CR 계산:
- Loading 합의 제곱: \((0.80 + 0.75 + 0.50)^2 = 2.05^2 = 4.2025\)
- 오차분산 합: \((1-0.64) + (1-0.5625) + (1-0.25) = 0.36 + 0.4375 + 0.75 = 1.5475\)
- \(CR = \frac{4.2025}{4.2025 + 1.5475} = \frac{4.2025}{5.75} \approx \mathbf{0.731} \quad (\ge 0.70 \ \mathbf{합격!})\)
| 지표 | 계산 결과 | 판정 기준 | 판정 | 실무 통계학적 해석 |
|---|---|---|---|---|
| CR | 0.731 | \(\ge 0.70\) | 합격 | 문항들을 합쳐서 총점으로 쓸 때의 종합 신뢰성은 확보됨 |
| AVE | 0.484 | \(\ge 0.50\) | 탈락 | 저품질 문항(\(Q3, \lambda=0.50\)) 탓에 문항들의 평균 설명력이 50% 아래로 추락함 |
문항 수 증가 시뮬레이션의 비밀
품질이 고만고만한 문항(\(\lambda = 0.70\), 분산설명력 \(49\%\))을 3개 쓸 때와 6개 쓸 때를 비교해 보겠습니다. * AVE: 3개든 6개든 단순 평균이므로 \(0.490\)으로 완벽히 동일합니다. 문항 수를 늘린다고 속일 수 없습니다. * CR: 분자가 합산 후 제곱되므로 문항이 3개일 때는 \(0.742\)였던 값이, 문항이 6개로 늘어나면 \(0.852\)로 대폭 상승합니다!
💡 명쾌한 해결책:
CR은 합격인데 AVE가 미달했다면, 적재량이 저조한 문항(위 예시의 \(Q3, \lambda=0.50\))이 평균을 갉아먹고 있는 것입니다. 이때 내용타당도를 검토한 후 해당 불량 문항을 과감히 제거하고 재분석하면, 남아있는 우수 문항들 덕분에 AVE가 \(0.50\) 이상으로 수직 상승하여 두 기준을 모두 충족하게 됩니다.
4-3. 판별타당도(Discriminant Validity): Fornell-Larcker vs HTMT
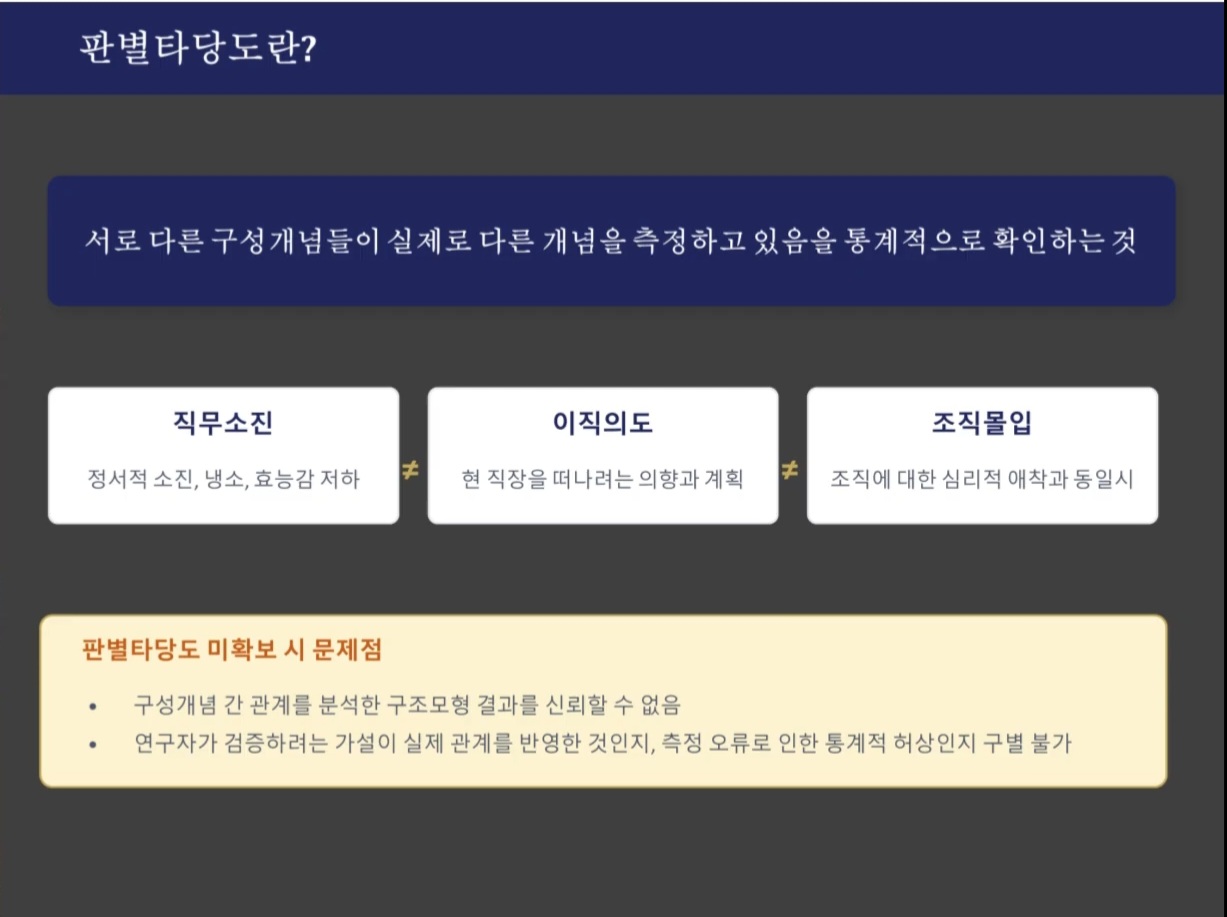
판별타당도는 “서로 다른 두 잠재변수가 데이터상에서도 통계적으로 명확히 분리되는가?”를 확인하는 관문입니다.
1. 전통적 기준: Fornell-Larcker 준거
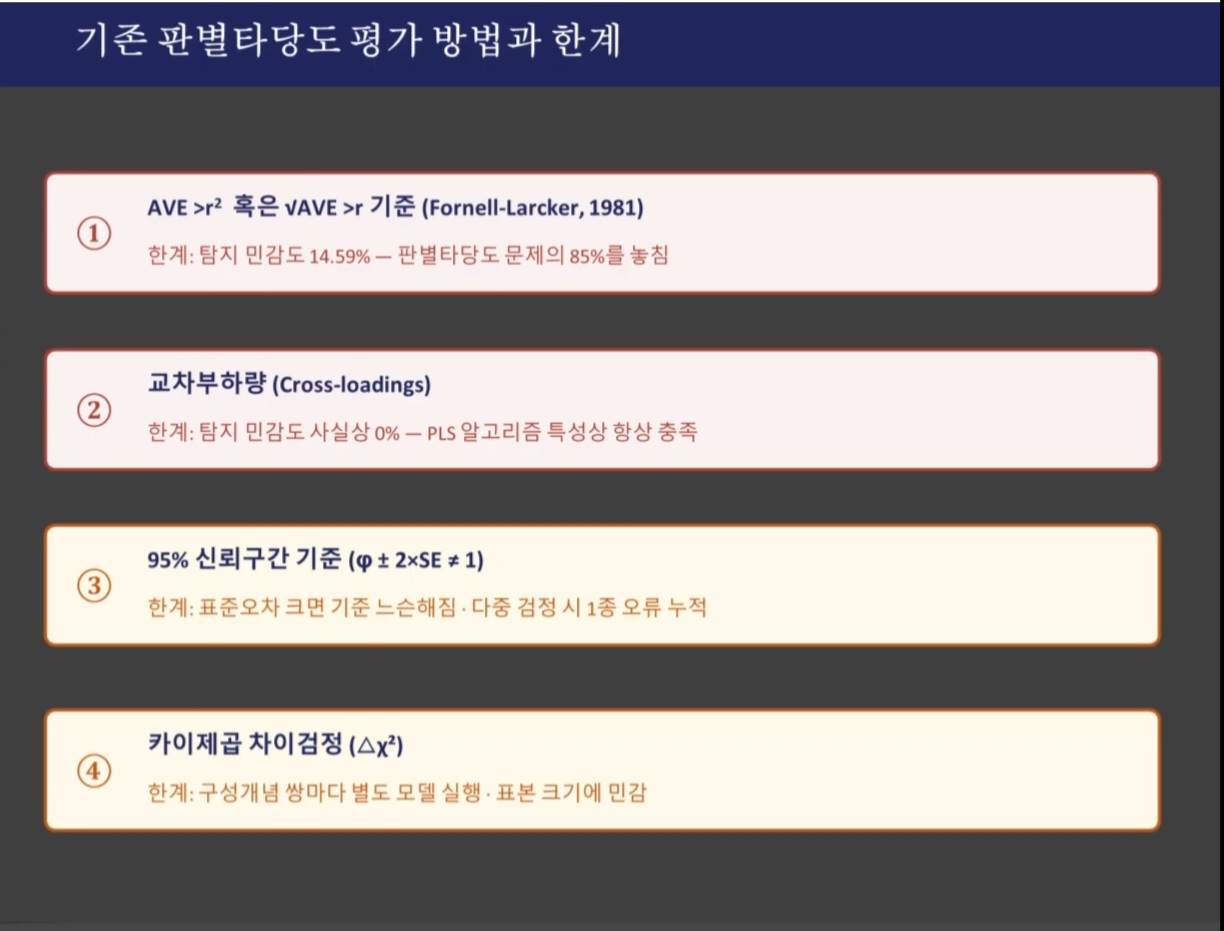
- 원리: “어떤 잠재변수가 자기 문항들과 공유하는 분산(\(AVE\))이 다른 잠재변수와 공유하는 분산(\(r^2\))보다 커야 한다.”
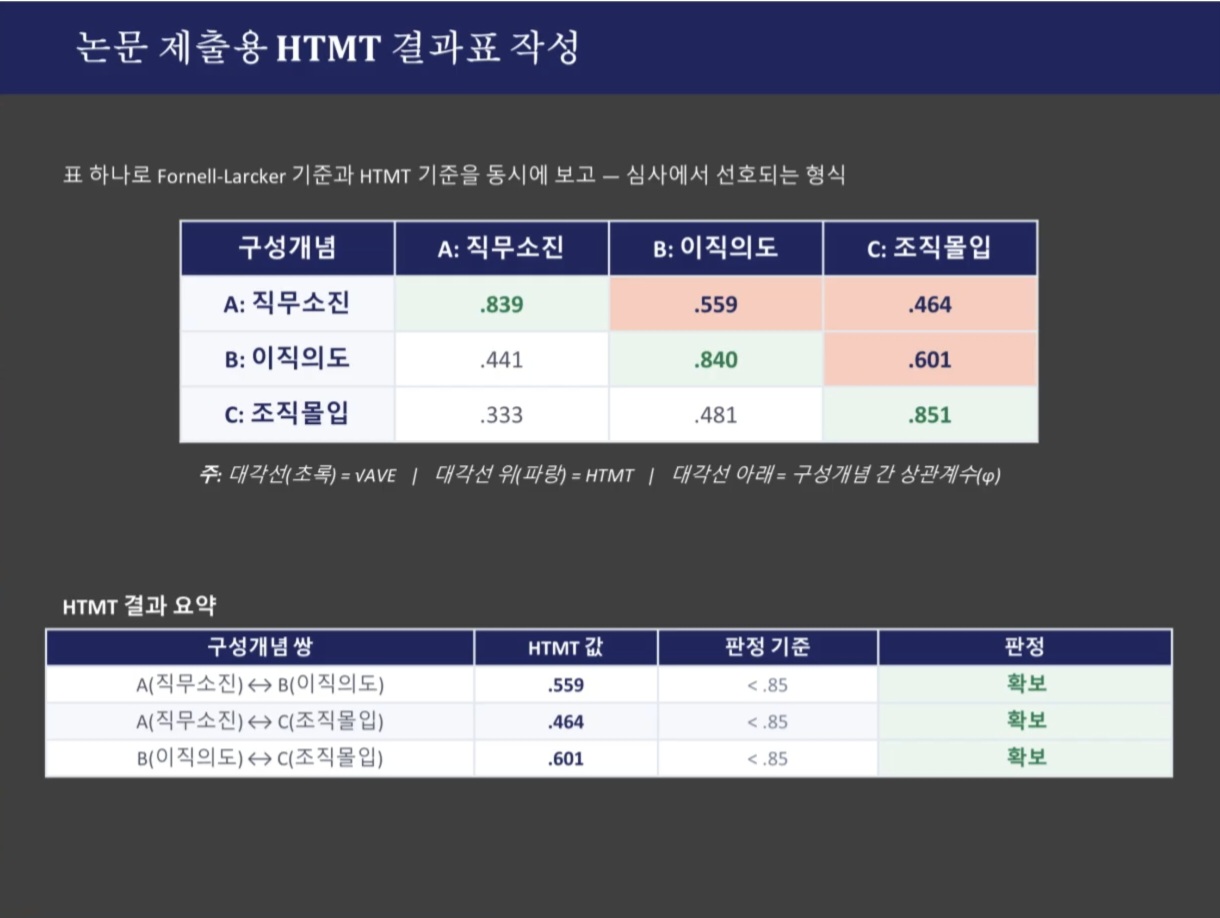
- 공식: \(\boxed{\sqrt{AVE_A} > |r_{AB}|}\)
(즉, 상관계수 행렬표의 대각선에 위치한 \(\sqrt{AVE}\) 값이 해당 행과 열의 모든 상관계수보다 커야 통과)
- Fornell-Larcker의 치명적 한계:
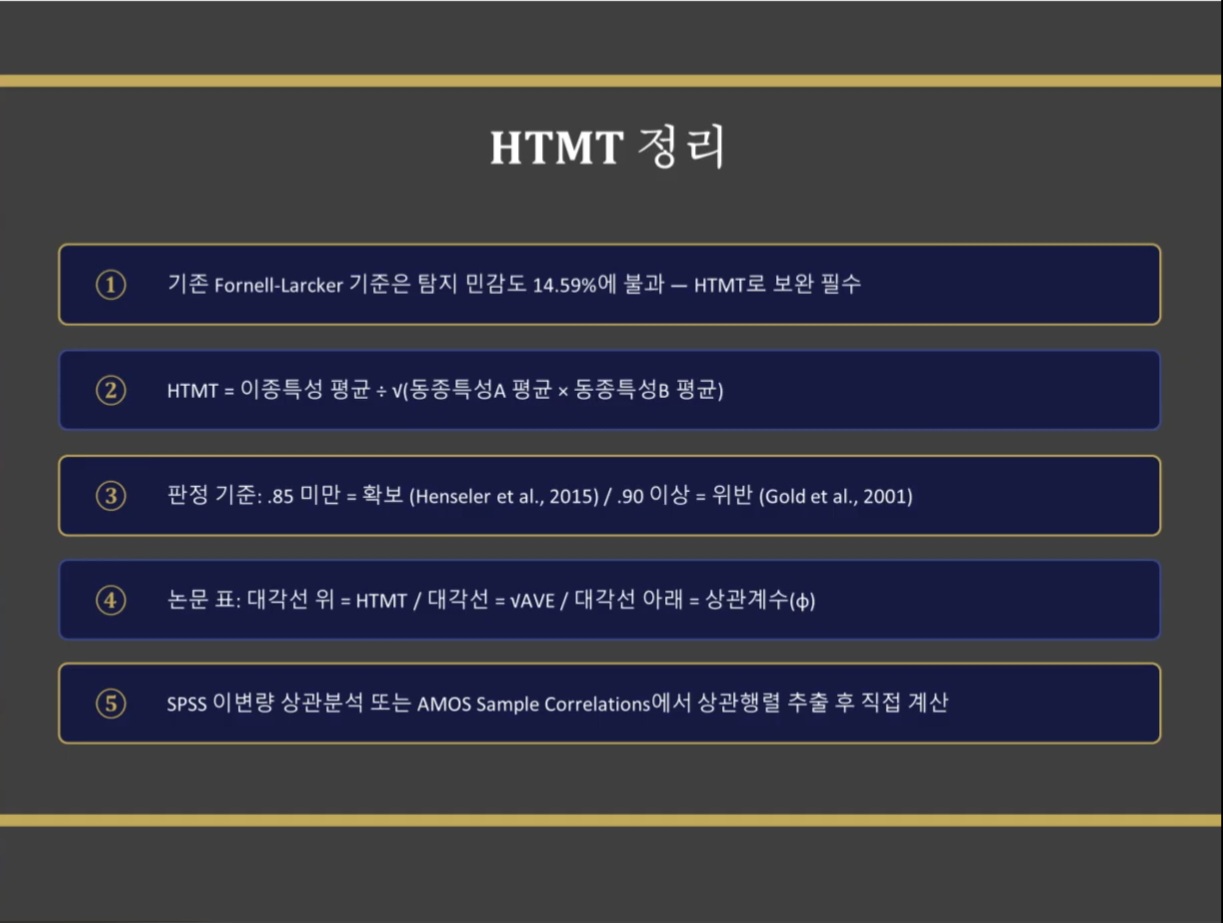
Henseler et al.(2015)의 몬테카를로 시뮬레이션 연구에 따르면, 두 잠재변수가 실제로는 거의 똑같은 개념(상관 0.9 이상)인데도 Fornell-Larcker 기준이 문제를 잡아내는 비율은 고작 14.59%에 불과했습니다. 즉, 85%의 확률로 불량 모형을 그냥 통과시켜 버리는 치명적 위음성(False Negative) 결함이 밝혀진 것입니다.
2. 현대적 대안: HTMT (Heterotrait-Monotrait Ratio of Correlations)
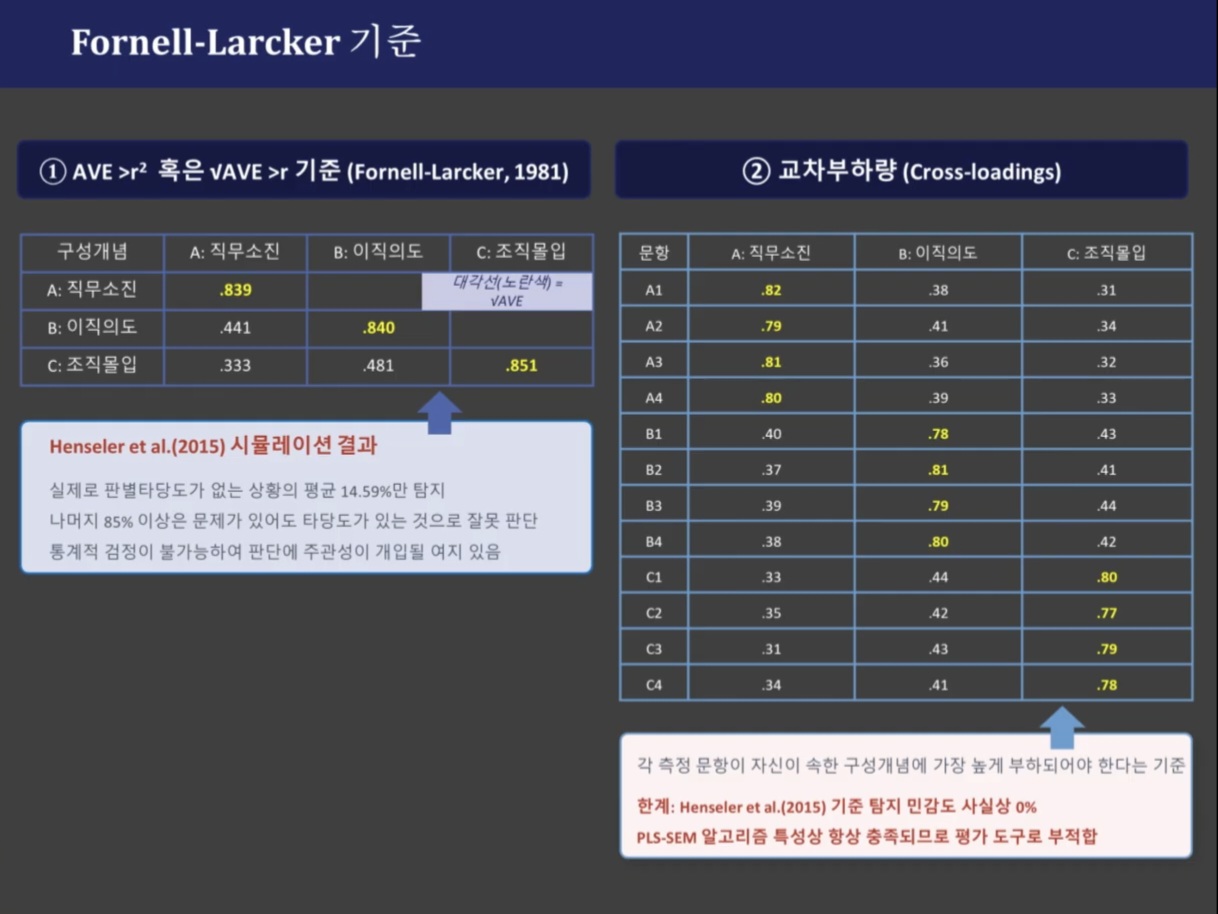
이러한 전통적 기준의 한계를 극복하기 위해 제안되어 현재 학계의 표준으로 정착한 것이 바로 HTMT(이종특성-동종특성 상관비율)입니다.
👕 직관적인 비유: “학교 교복 구별하기”
A반과 B반 학생들을 멀리서 구별해야 한다고 상상해 봅시다. * 분모 (동종특성 상관): A반 학생들끼리는 교복 디자인이 아주 비슷해야 합니다. (우리 반 일관성 높음) * 분자 (이종특성 상관): A반 학생과 B반 학생의 교복은 디자인이 확연히 달라야 합니다. (다른 반 유사성 낮음)
\[HTMT = \frac{\text{서로 다른 반 학생들 간의 교복 유사성 (이종특성)}}{\text{같은 반 학생들 간의 교복 유사성 (동종특성)}}\]
분자(남의 문항과 닮은 정도)가 작고 분모(내 문항끼리 뭉친 정도)가 클수록 HTMT 값은 작아집니다. 즉, HTMT 값이 낮을수록 두 개념이 헷갈리지 않고 명확하게 구별된다는 뜻입니다!
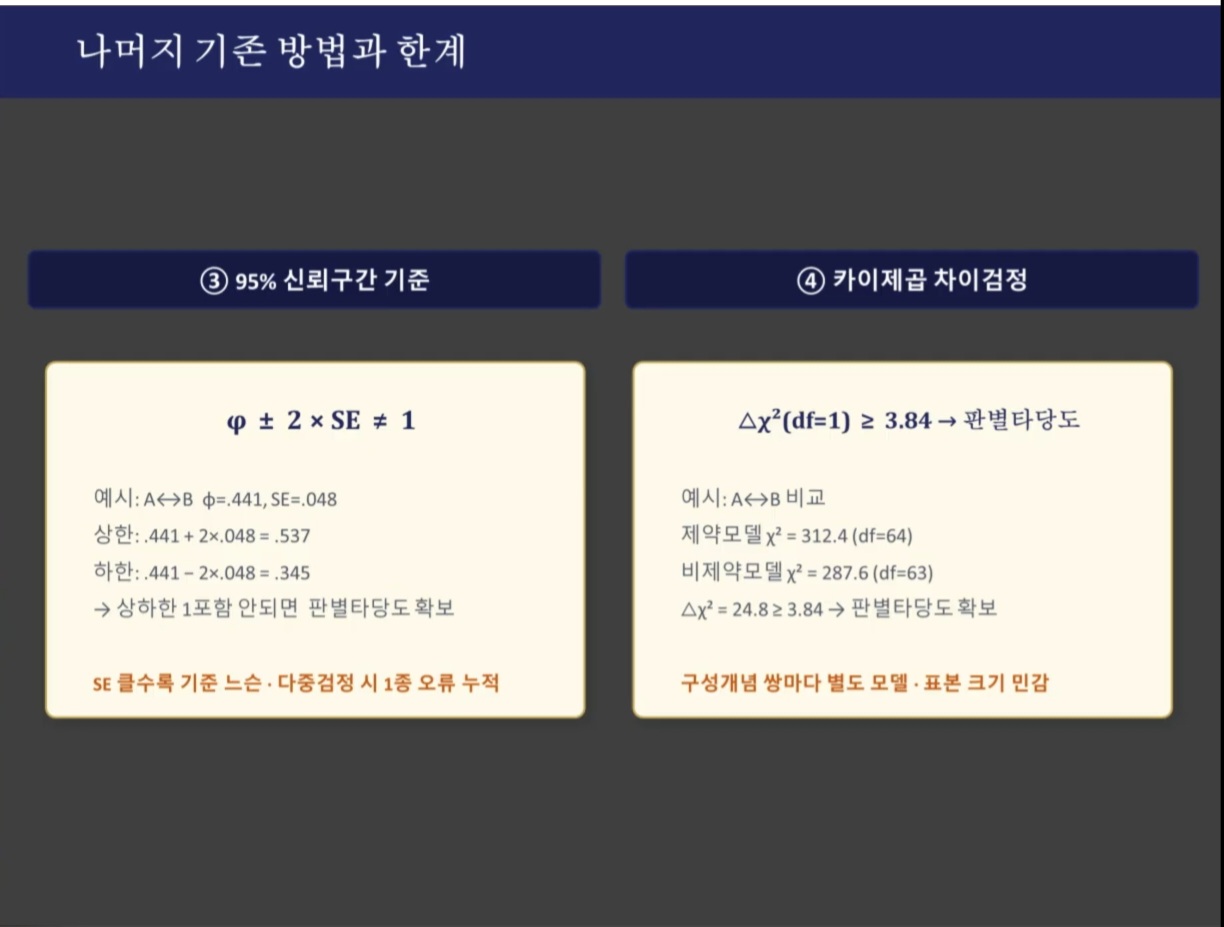
| HTMT 수치 범위 | 학술적 판정 및 해석 | 적용 지침 |
|---|---|---|
| \(\text{HTMT} \le 0.85\) | 엄격한 기준에서 판별타당도 강력 지지 | 개념 간 차이가 뚜렷해야 하는 일반 연구 권장 (HTMT.85) |
| \(0.85 < \text{HTMT} \le 0.90\) | 조건부 수용 및 주의 구간 | 이론적으로 매우 인접한 개념 간 연구에서 선행연구 제시 (HTMT.90) |
| \(\text{HTMT} > 0.90\) | 개념 중복 우려 (판별타당도 결여) | 문항 내용 중복 점검, 불량 문항 제거 또는 단일 변수 통합 |
| \(\text{HTMT} \approx 1.00\) | 동일 개념 (구별 불가) | 두 잠재변수가 사실상 같은 개념을 묻고 있음 |
4-4. HTMT 단계별 수기 계산 실습
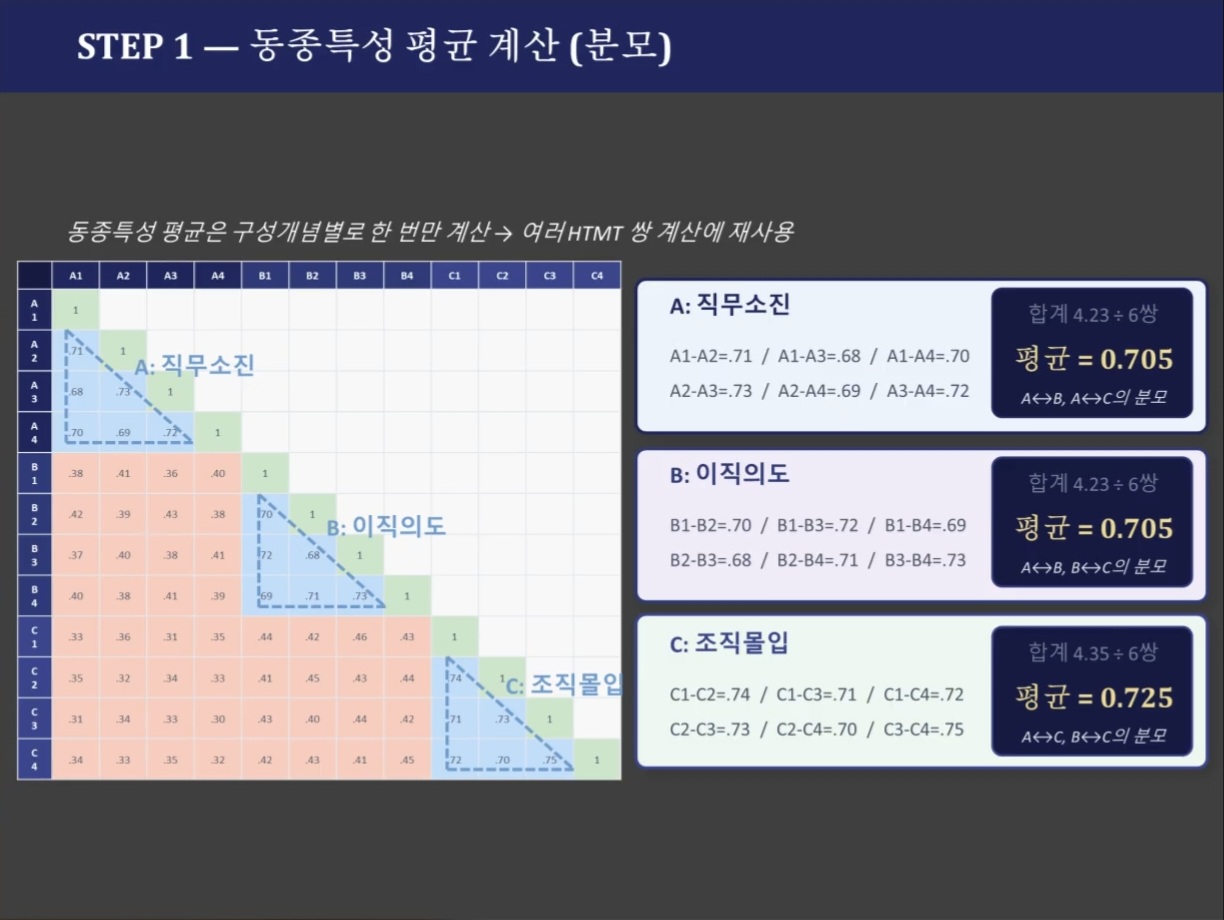
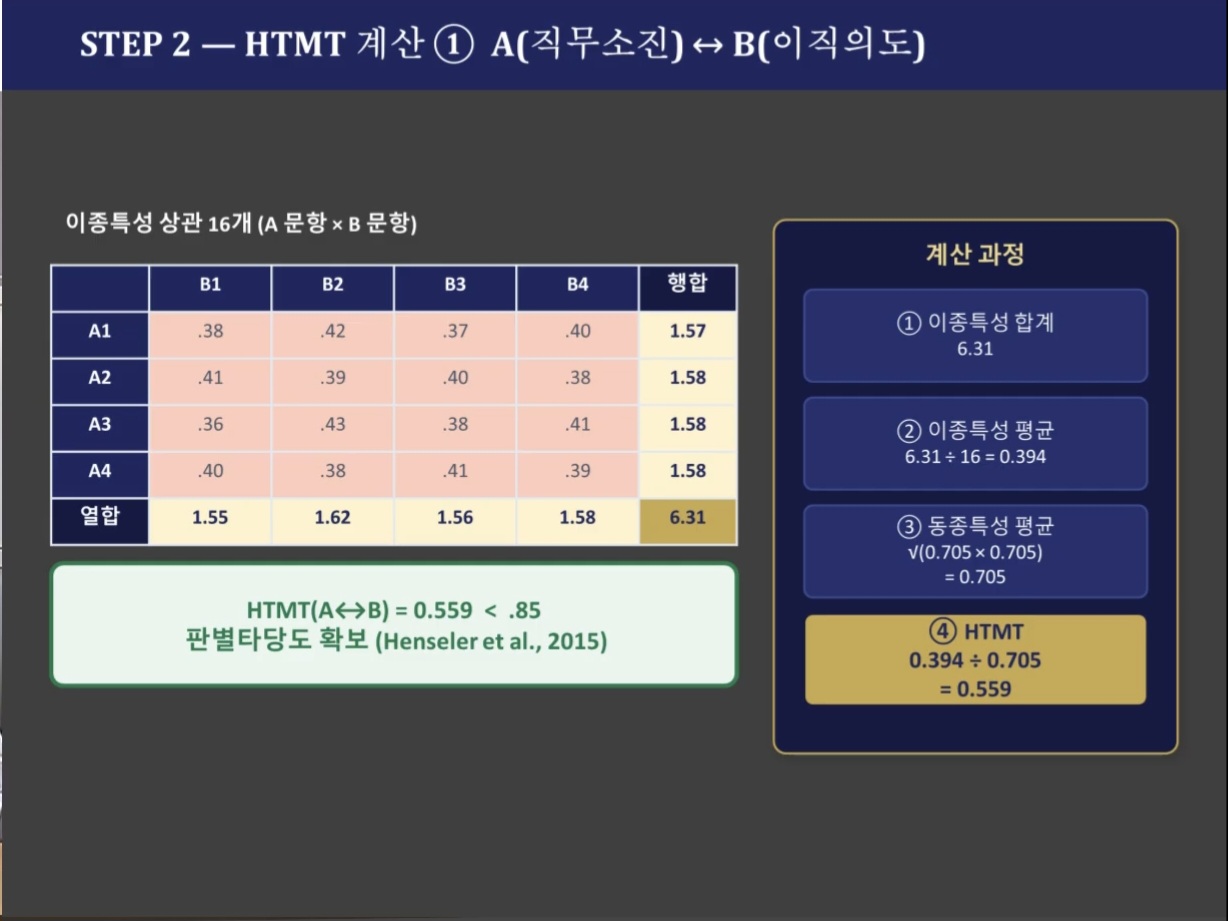
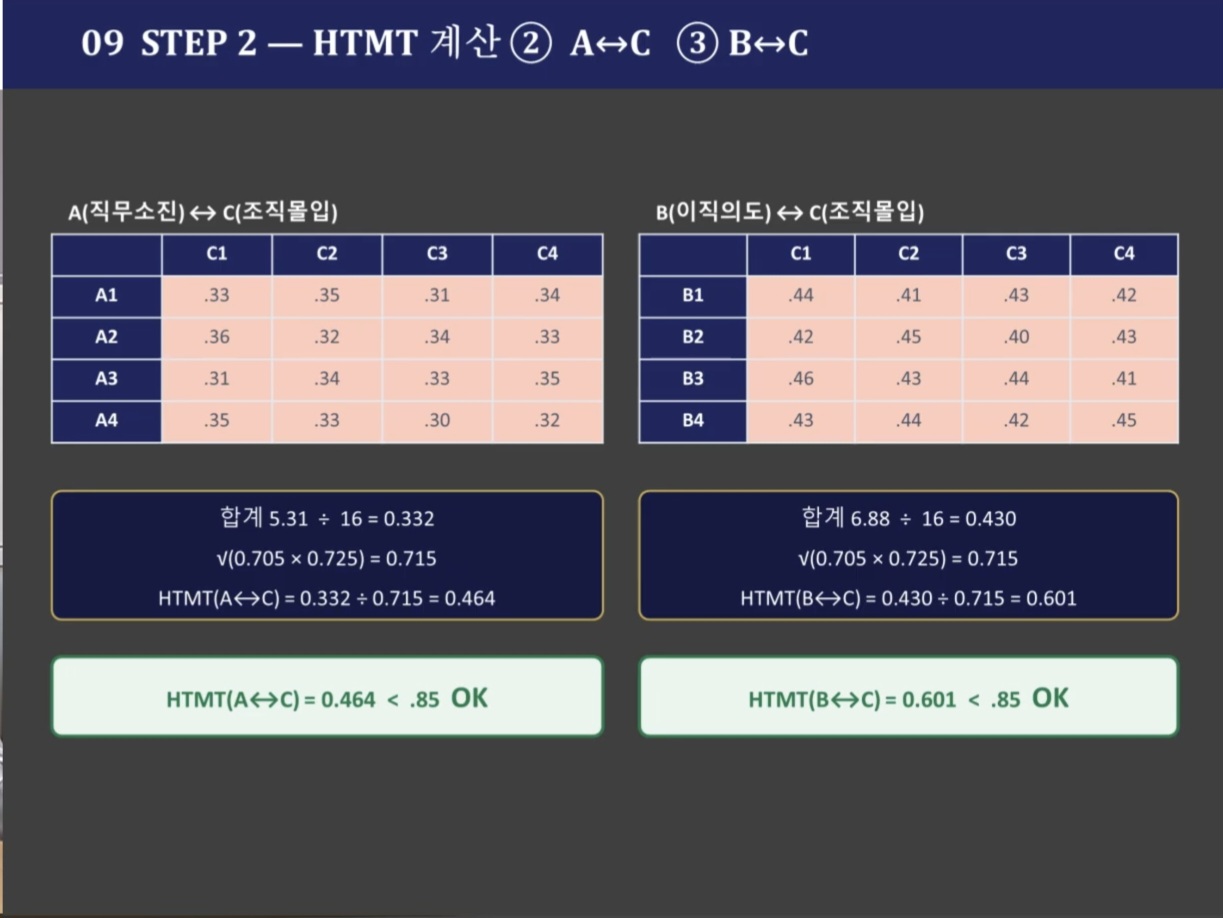
개념을 완전히 내 것으로 만들기 위해, 3개 변수(직무소진 A, 이직의도 B, 조직몰입 C; 각 4문항)의 피어슨 상관행렬을 이용해 직접 계산해 보겠습니다.
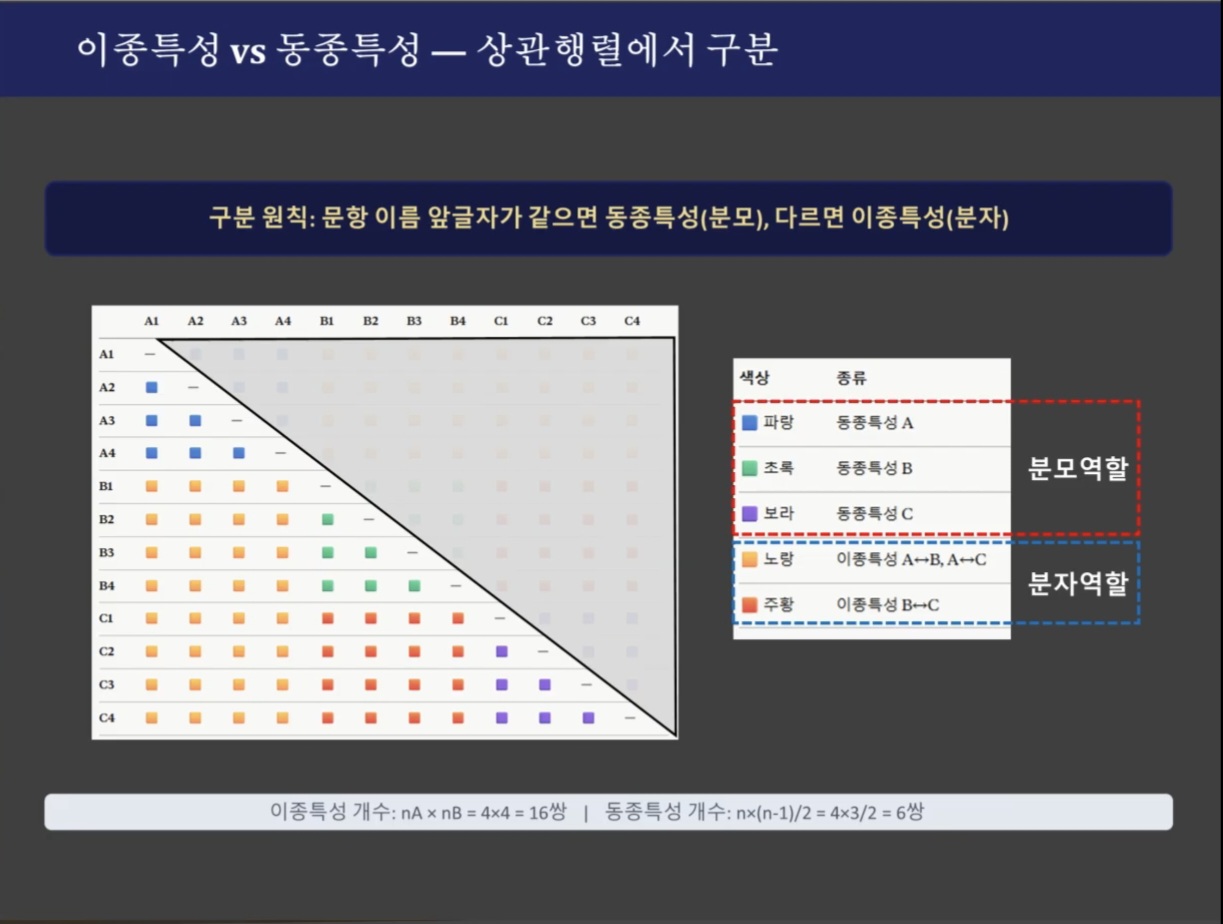
- 1단계: 동종특성(내부 문항끼리) 평균 계산:
- A 내부 상관(6개 쌍): 평균 \(0.705\)
- B 내부 상관(6개 쌍): 평균 \(0.705\)
- C 내부 상관(6개 쌍): 합계 \(4.35 \div 6 =\) \(0.725\)
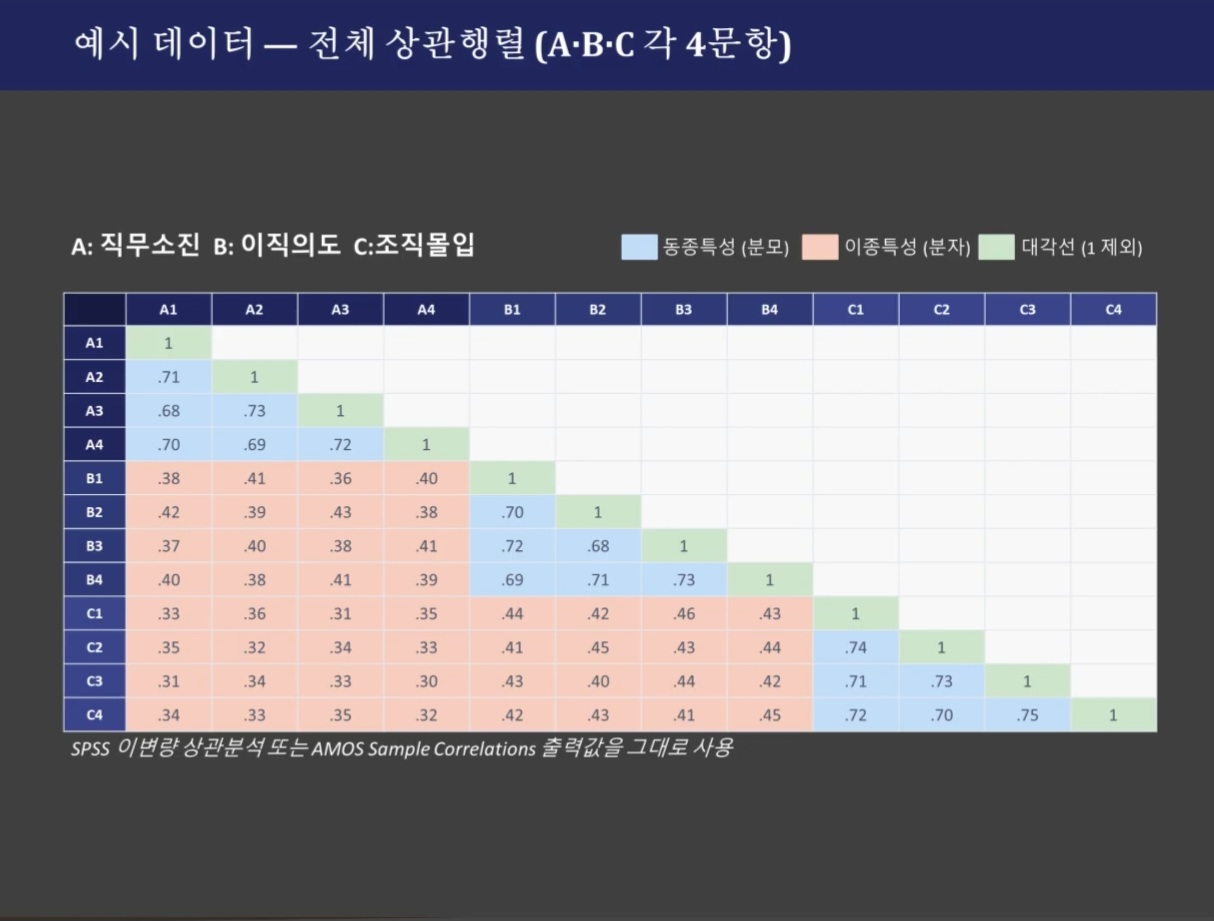
- 2단계: 이종특성(서로 다른 변수 문항끼리) 평균 계산:
- A-B 사이 상관(16개 쌍): 평균 \(0.394\)
- A-C 사이 상관(16개 쌍): 평균 \(0.332\)
- B-C 사이 상관(16개 쌍): 평균 \(0.430\)
- 3단계: 최종 공식 대입: \[HTMT_{AB} = \frac{0.394}{\sqrt{0.705 \times 0.705}} = \frac{0.394}{0.705} = \mathbf{0.559} \quad (< 0.85 \ \mathbf{통과!})\] \[HTMT_{AC} = \frac{0.332}{\sqrt{0.705 \times 0.725}} = \frac{0.332}{0.715} = \mathbf{0.464} \quad (< 0.85 \ \mathbf{통과!})\] \[HTMT_{BC} = \frac{0.430}{\sqrt{0.705 \times 0.725}} = \frac{0.430}{0.715} = \mathbf{0.601} \quad (< 0.85 \ \mathbf{통과!})\]
모든 값이 엄격한 기준인 \(0.85\)를 넉넉하게 하회하므로 세 잠재변수 간 판별타당성이 확고하게 입증되었습니다.
4-5. 판별타당도 결여 vs 다중공선성(VIF)의 층위 차이
초보 연구자가 자주 겪는 또 다른 혼선은 “판별타당도 결여”와 “다중공선성(Multicollinearity)”을 뒤섞는 것입니다.
[ 판별타당도 vs 다중공선성: 분석 층위의 차이 ]

  판별타당도 결여 (CFA / 측정 층위의 문제)          다중공선성 문제 (회귀 / 구조경로 층위의 문제)
     ┌───────────┐     ┌───────────┐                  ┌───────────┐     ┌───────────┐
     │  잠재개념A │ <──>│  잠재개념B │                  │  독립변수1 │ <──>│  독립변수2 │
     └─────┬─────┘     └─────┬─────┘                  └─────┬─────┘     └─────┬─────┘
           │ r = 0.92        │                              │                 │
           ▼                 ▼                              └────────┬────────┘
    "설문 문항들이 두 대상을 구별 못 함"                             ▼
    두 개념은 분리되지 않는 단일 개념임.               종속변수(Y)를 예측할 때 표준오차 폭증,
-> 지표: Fornell-Larcker 미달, HTMT > .90 경로계수 부호 왜곡 -> 지표: VIF > 5~10- 판별타당도: “개념 \(A\)와 \(B\)가 별개의 실체인가?”를 따지는 측정 단위의 타당성 문제입니다.
- 다중공선성: “여러 설명변수들이 독립적인 고유 정보를 주는가?”를 따지는 예측/회귀 차원의 추정 안정성 문제입니다.
- 따라서 CFA 단계에서 VIF를 들이밀며 판별타당도를 입증했다고 주장하는 것은 분석의 층위를 혼동한 통계학적 오류입니다.
4-6. 국소적 문제 진단: 표준화 잔차 공분산(SRC)과 수정지수(MI)
모형 적합도가 나쁠 때 어디에 문제가 있는지 콕 집어내는 진단 도구입니다.
- 표준화 잔차 공분산 (SRC: Standardized Residual Covariance):
표본 공분산과 모형 추정 공분산 간의 잔차를 표준화한 오차 행렬입니다.- 기준: 통계적 유의수준(\(\alpha = .01\))에 따라 \(|SRC| < 2.58\) (보수적으로는 \(1.96\)) 이내여야 합니다.
- \(|SRC| \ge 2.58\)인 문항 쌍은 모형이 그 관계를 제대로 설명하지 못하고 과소·과대 추정하고 있다는 경고등입니다.
- 기준: 통계적 유의수준(\(\alpha = .01\))에 따라 \(|SRC| < 2.58\) (보수적으로는 \(1.96\)) 이내여야 합니다.
- 수정지수 (MI: Modification Index):
고정된 파라미터(예: 오차 공분산, 교차 적재량)를 자유롭게 풀어주었을 때 전체 \(\chi^2\) 값이 최소한 얼마만큼 감소(개선)하는지 보여주는 통계량입니다.- ⚠️ 경고: 적합도를 억지로 올리기 위해 통계적 MI 값만 보고 무분별하게 오차항끼리 양방향 화살표(\(\theta_{ij}\))를 잇는 행위는 학계에서 “데이터 조작(Data Snooping)”으로 간주되어 논문 리젝의 지름길이 됩니다. 반드시 문항의 어문 구조가 동일하거나 측정 방식이 겹치는 등 강력한 이론적 정당성이 있을 때에만 극히 제한적으로 사용해야 합니다.
5. 실무 연구자를 위한 5단계 검증 파이프라인 및 종합 마스터 표
5-1. Step-by-Step 5단계 검증 파이프라인
flowchart TD
    Start(["측정모형 분석 시작"]) --> Step1["1단계: 전체 모형 적합도 검증<br/>• χ²(df, p), χ²/df < 3.0<br/>• CFI, TLI ≥ .90 (우수 ≥ .95)<br/>• RMSEA ≤ .08 (우수 ≤ .06), SRMR ≤ .08"]

    Step1 --> Check1{"전체 적합도<br/>수용 가능한가?"}
    Check1 -- "No" --> Diag["국소적 원인 진단<br/>• |SRC| ≥ 2.58 문항 탐색<br/>• 이론 기반 불량 문항 제거"]
    Diag --> Step1

    Check1 -- "Yes" --> Step2["2단계: 개별 문항 신뢰도 검증<br/>• 표준화 요인적재량 (λ ≥ .70, 최소 .50)<br/>• SMC (= λ² ≥ .50)"]

    Step2 --> Step3["3단계: 내적 일관성 신뢰도 검증<br/>• Cronbach's α ≥ .70<br/>• 합성신뢰도(CR) ≥ .70<br/>(AMOS C.R. 임계비와 혼동 금지!)"]

    Step3 --> Step4["4단계: 수렴타당도 검증<br/>• 평균분산추출값(AVE) ≥ .50"]

    Step4 --> Check2{"신뢰도 & 수렴타당도<br/>모두 충족하는가?"}
    Check2 -- "No" --> Revise["적재량이 극히 저조한 문항 제거 후 재분석"]
    Revise --> Step1

    Check2 -- "Yes" --> Step5["5단계: 판별타당도 검증<br/>• Fornell-Larcker: √AVE > |상관계수 r|<br/>• HTMT ≤ .85 (조건부 ≤ .90)"]

    Step5 --> Success(["측정모형 검증 완료!<br/>(구조모형 가설 검증 단계로 진입)"])

    style Start fill:#0F172A,stroke:#0F172A,color:#FFFFFF
    style Step1 fill:#E0F2FE,stroke:#0284C7
    style Step2 fill:#DCFCE7,stroke:#16A34A
    style Step3 fill:#DCFCE7,stroke:#16A34A
    style Step4 fill:#FEF3C7,stroke:#D97706
    style Step5 fill:#FCE7F3,stroke:#DB2777
    style Success fill:#1E1B4B,stroke:#4338CA,color:#FFFFFF
5-2. CFA 측정모형 평가 지표 종합 마스터 테이블
논문 작성 시 옆에 두고 확인할 최종 레퍼런스 표입니다.
| 평가 영역 | 통계 지표명 | 기호 | 우수 기준 (Good) | 수용 기준 (Acceptable) | 핵심 통계적 본질 및 연구자 체크포인트 |
|---|---|---|---|---|---|
| 전체 적합도 | 카이제곱 검정 | \(\chi^2, df, p\) | \(p \ge .05\) | \(p < .05\)도 허용 | 표본 크기에 민감하므로 기각되어도 타 지표와 함께 병기 필수 |
| 전체 적합도 | 카이제곱 자유도비 | \(\chi^2/df\) | \(< 2.0\) | \(< 3.0\) | 모형 복잡성을 보정한 간명 적합도 경험칙 |
| 전체 적합도 | 비교적합지수 | CFI | \(\ge .95\) | \(\ge .90\) | 영모형 대비 공분산 불일치 감소 비율 (최우선 핵심) |
| 전체 적합도 | 터커-루이스지수 | TLI | \(\ge .95\) | \(\ge .90\) | 자유도 페널티를 부여한 상대 개선도 (최우선 핵심) |
| 전체 적합도 | 근사원소평균자승오차 | RMSEA | \(\le .06\) | \(\le .08\) | 자유도당 모형의 근사 오차. \(90\%\) CI 병기 (최우선 핵심) |
| 전체 적합도 | 표준화잔차평균 | SRMR | \(\le .08\) | \(\le .10\) | 관측과 모형 상관행렬 잔차의 절대적 평균 크기 (최우선 핵심) |
| 문항 신뢰도 | 표준화 요인적재량 | \(\lambda\) | \(\ge .70\) | \(\ge .50\) | 잠재변수와 문항 간 상관계수 (\(p < .001\) 필수) |
| 문항 신뢰도 | 다중상관자승 | \(SMC\) | \(\ge .50\) | \(\ge .25\) | 문항 분산에 대한 잠재변수의 설명력 (\(\approx \lambda^2\)) |
| 내적 신뢰도 | 크론바흐 알파 | \(\alpha\) | \(\ge .80\) | \(\ge .70\) | 동등가정 기반 전통적 일관성 계수 (과소추정 한계) |
| 내적 신뢰도 | 합성신뢰도 | \(CR\) | \(\ge .80\) | \(\ge .70\) | 적재량 차이를 반영한 실제 척도 신뢰도 (AMOS C.R.과 구별) |
| 수렴 타당도 | 평균분산추출값 | \(AVE\) | \(\ge .60\) | \(\ge .50\) | 문항 분산 중 잠재변수가 점유하는 순수 설명 분산 비율 |
| 판별 타당도 | 포넬-라커 기준 | \(\sqrt{AVE}\) vs \(r\) | \(\sqrt{AVE} > \|r\|\) | \(\sqrt{AVE} > \|r\|\) | 개념 고유 분산 설명력이 타 개념과의 공유 분산보다 커야 함 |
| 판별 타당도 | 이종-동종상관비 | \(HTMT\) | \(\le .85\) | \(\le .90\) | 이종특성 상관 대비 동종특성 상관 비율 (현대 학계 필수) |
| 국소적 진단 | 표준화잔차공분산 | \(SRC\) | \(\|SRC\| < 1.96\) | \(\|SRC\| < 2.58\) | 모형에 의해 설명되지 않는 관측 공분산의 국소 잔차 오차 |
6. 논문 통과를 보장하는 표준 기술 양식 (Copy-Paste Templates)
학위논문 및 학술지에 바로 적용할 수 있는 표준 서술 문장입니다. 수치 부분만 본인 연구 결과에 맞게 바꾸어 활용하십시오.
6-1. 모형 적합도 기술 템플릿
“본 연구에서 제안한 측정모형의 적합도를 검증하기 위해 확인적 요인분석(CFA)을 실시하였다.
분석 결과, 카이제곱 통계량은 \(\chi^2(142) = 248.512\) (\(p < .001\))로 나타났다. 카이제곱 검정은 표본 크기에 민감하므로(Bollen, 1989), 표본 크기에 상대적으로 둔감한 대안적 적합도 지수들을 종합적으로 검토하였다.
분석 결과, \(\chi^2/df = 1.750\), \(CFI = .958\), \(TLI = .949\), \(RMSEA = .051\) (\(90\% \text{ CI } [.041, .061]\)), \(SRMR = .046\)으로 도출되었다. 비록 TLI가 엄격한 기준(.95)에 근접한 수용 범위에 있으나, CFI, RMSEA, SRMR이 모두 우수한 기준치를 충족하고 있어 본 연구의 측정모형은 전반적으로 양호한(Good) 적합도를 나타내는 것으로 판단하였다.”
6-2. 신뢰도 및 수렴타당도 기술 템플릿
“측정문항의 신뢰성과 수렴타당성을 검증한 결과는 [표 1]과 같다. 모든 관측변수의 표준화 요인적재량(\(\lambda\))은 \(.684 \sim .891\)의 분포를 보여 권장 기준인 \(.50\) 이상을 상회하였으며, 모든 경로가 통계적으로 유의하였다(\(p < .001\)). 개별 문항의 분산 설명력을 나타내는 다중상관자승(SMC)은 \(.468 \sim .794\)로 나타났다.
구성개념의 내적 일관성을 평가한 결과, 모든 잠재변수의 Cronbach’s \(\alpha\)는 \(.812 \sim .905\), 합성신뢰도(CR)는 \(.820 \sim .910\)으로 나타나 기준치인 \(.70\)을 상회하여 높은 신뢰도를 확보하였다. 아울러 수렴타당도를 평가하기 위해 산출한 평균분산추출값(AVE)은 \(.535 \sim .718\)로 모든 잠재변수에서 기준치인 \(.50\) 이상을 기록하여 수렴타당성이 입증되었다.”
6-3. 판별타당도 기술 템플릿 (Fornell-Larcker 및 HTMT 병기)
“구성개념 간 판별타당성을 검증하기 위해 Fornell & Larcker(1981) 준거와 Henseler et al.(2015)이 제안한 HTMT 비율을 함께 분석하였다([표 2] 참조).
Fornell-Larcker 기준 분석 결과, 각 잠재변수의 \(\sqrt{AVE}\) 값(최저 \(.731\))이 해당 요인과 타 요인 간의 모든 상관계수 절대값(최대 \(r = .584\))보다 크게 나타나 전통적 판별타당도 기준을 충족하였다.
추가적으로 보다 엄격한 현대적 기준인 HTMT 비율을 확인한 결과, 요인 간 모든 HTMT 수치가 \(.512 \sim .743\)으로 엄격한 보수적 기준치인 \(.85\) 이하를 만족하였다. 따라서 본 연구의 구성개념 간 판별타당성이 완전히 확보되었음을 확인하였다.”
7. R 실습: lavaan & semTools로 5단계 파이프라인 단번에 끝내기
R을 활용하면 AMOS에서 복잡하게 엑셀을 돌리지 않고도 단 몇 줄의 코드로 적합도, 신뢰도, AVE, HTMT를 깔끔하게 일괄 산출할 수 있습니다.
# 필수 패키지 로드
library(lavaan)
library(semTools)

# 1. 측정모형 정의 (CFA)
cfa_model <- '
  # 잠재변수 =~ 관측변수
  Burnout    =~ a1 + a2 + a3 + a4
  Turnover   =~ b1 + b2 + b3 + b4
  Commitment =~ c1 + c2 + c3 + c4
'

# 2. CFA 실행 (최대우도추정 ML)
fit <- cfa(cfa_model, data = df, std.lv = TRUE)

# 3. 전체 모형 적합도 확인
fit_indices <- fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper", "srmr"))
print(round(fit_indices, 3))

# 4. 신뢰도(CR, Cronbach alpha) 및 수렴타당도(AVE) 일괄 산출
reliability_results <- semTools::reliability(fit)
print(round(reliability_results, 3))
# 출력 결과 중:
# - alpha: Cronbach's alpha
# - omega: Composite Reliability (CR)
# - avevar: Average Variance Extracted (AVE)

# 5. 최신 판별타당도 HTMT 산출 (HTMT2 적용)
htmt_results <- semTools::htmt(cfa_model, data = df, absolute = TRUE, htmt2 = TRUE)
print(round(htmt_results, 3))
8. 연구자가 자주 묻는 질문 (FAQ & Troubleshooting)
Q1. CFI는 0.92로 통과했는데, TLI가 0.89로 아슬아슬하게 걸립니다. 어떻게 해야 하나요?
답변: TLI는 자유도(모형의 복잡도)에 페널티를 주는 지표입니다. 문항 수가 많거나 잠재변수가 복잡할 때 CFI보다 낮게 나오는 것이 일반적입니다. CFI, RMSEA, SRMR이 모두 양호하다면, 선행연구(Marsh et al., 2004)를 인용하며 “주요 지표가 수용 범위를 만족하므로 전반적 적합도가 인정된다”고 보수적으로 기술하고 심사위원을 설득할 수 있습니다.
Q2. AVE가 0.47로 살짝 모자랍니다. 문항을 지워야만 하나요?
답변: Fornell & Larcker(1981)의 원 논문에 따르면, “합성신뢰도(CR)가 0.60(또는 0.70) 이상으로 충분히 높다면, AVE가 0.50에 다소 미치지 못하더라도 수렴타당성을 조건부로 인정할 수 있다”는 예외 조항이 명시되어 있습니다. 이 근거를 각주에 인용하여 방어하거나, 요인적재량이 가장 낮은 문항 하나를 제거하여 AVE를 0.50 위로 올리는 방법 중 연구 맥락에 맞게 선택할 수 있습니다.
Q3. Fornell-Larcker는 통과했는데 HTMT가 0.91이 나왔습니다.
답변: 바로 이것이 학계가 HTMT를 도입한 이유입니다! 응답자들은 두 변수를 구별하지 못하고 있는데 Fornell-Larcker가 둔감하여 잡아내지 못한 전형적인 케이스입니다. 두 변수 간의 설문 문항 내용을 대조해 보십시오. 거의 동일한 표현을 묻고 있는 문항 쌍을 찾아 제거하거나, 이론적으로 두 변수를 하나의 상위 개념으로 묶는 고차 요인 모형(Higher-order model)을 검토해야 합니다.
9. 관련 글 둘러보기
CFA 측정모형을 통과했다면, 이제 구조모형과 심화 통계 기법으로 나아갈 차례입니다. 함께 읽으면 연구의 깊이를 더해주는 포스트들을 추천합니다.
- HTMT 판별타당도 완전 정복: R semTools 실습과 논문 표 작성법
- 구조방정식 모형(SEM)의 이해: 탄생 배경, 역사적 계보, 그리고 PROCESS Macro Model 7 실전 가이드
- UTAUT(통합기술수용이론) 완벽 해설: 8대 모태 이론부터 UTAUT2 확장, 연구모형 설계·SEM 분석 가이드
- R 변수 선택과 다중공선성(VIF) 완전 정복 가이드