flowchart LR
    A["요인분석 (Factor Analysis)<br/>'보이지 않는 개념을 오차 없이 쟀는가?'"] --> C["구조방정식모델링 (SEM)<br/>'오차를 통제한 상태에서<br/>다중 인과경로를 동시 추정!'"]
    B["회귀·경로분석 (Path Analysis)<br/>'개념들 사이에 어떤 인과관계가 있는가?'"] --> C

    style A fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style B fill:#DCFCE7,stroke:#16A34A,stroke-width:1.5px
    style C fill:#0F172A,stroke:#0F172A,stroke-width:2px,color:#FFFFFF
💡 핵심 요약 (Executive Summary):
- SEM의 수학적 본질: 구조방정식모델링(CB-SEM)은 개별 관측치의 예측 오차를 줄이는 회귀분석과 달리, 표본 데이터의 공분산 행렬(\(\mathbf{S}\))과 연구자 모형의 이론적 공분산 행렬(\(\mathbf{\Sigma}(\theta)\)) 간의 차이를 최소화(\(\mathbf{S} \approx \mathbf{\Sigma}(\theta)\))하는 공분산 구조 최적화 기법입니다.
- 엄격한 2단계 접근법(Two-Step Approach): 측정오차를 통제하고 잠재변수의 신뢰성·타당성을 입증하는 확인적 요인분석(CFA)을 먼저 통과하지 않은 상태에서 인과경로(SEM)를 추정하는 것은 가설 기각의 원인을 오염시키는 치명적 오류를 낳습니다.
- 최신 R 생태계 표준 준수:
semTools패키지에서 과거 사용하던reliability()함수는 2022년 지원 중단(deprecated)되었으며, 현재는compRelSEM()(합성신뢰도)과AVE()(평균분산추출값)로 분리하여 산출해야 합니다.- 매개효과 패러다임의 전환: 과거 Baron & Kenny의 “총효과 \(c\)의 선행 유의성” 도그마는 기각되었습니다. 직접효과와 간접효과가 반대 부호로 충돌하는 경쟁적 매개(Competitive Mediation)에서는 총효과가 0에 수렴하더라도 강력한 간접효과가 존재할 수 있으며, 직접효과가 총효과보다 커지는 역전 현상(\(|c'| > |c|\))이 발생합니다.
- 조절된 매개지수(\(a_3 b\))의 미스터리 해명: 상호작용 경로 \(a_3\)가 비유의(\(p = .069\))인데 조절된 매개지수 \(a_3 b\)가 유의(CI에 0 미포함)한 이유는 \(b\)가 크기 때문이 아니라, 대칭적 Wald 검정과 비대칭 부트스트랩 왜도 표본분포 간의 추론적 특성 차이 때문입니다.
0. 왜 통계학자들은 회귀분석 대신 구조방정식(SEM)을 선택했을까?
다중회귀분석(Multiple Regression)에 익숙한 연구자가 처음 구조방정식모델링(Structural Equation Modeling, SEM)을 접하면 엄청난 혼란에 빠집니다. 결정계수(\(R^2\)) 하나로 설명력을 따지던 단순한 세계에서 벗어나, CFI, TLI, RMSEA 같은 수많은 적합도 지수와 그리스 문자 행렬(\(\mathbf{\Lambda}, \mathbf{B}, \mathbf{\Gamma}, \mathbf{\Sigma}\))이 쏟아지기 때문입니다.
그렇다면 왜 전 세계 사회과학, 경영학, 심리학, 보건의학 실증 연구는 회귀분석을 넘어 SEM을 표준 방법론으로 채택했을까요?
일반 회귀분석은 “설문 문항 점수가 곧 오차 없는 참값(True Score)”이라는 매우 비현실적인 가정을 바탕으로 합니다. 하지만 인간의 ‘학습동기’, ‘직무소진’, ‘고객신뢰’ 같은 심리적 개념은 줄자나 체중계로 잴 수 없습니다. 설문 문항(관측변수)을 통해 간접 측정할 때 필연적으로 응답자의 피로, 질문의 모호성, 주관적 척도 기준 등으로 인한 측정오차(Measurement Error)가 끼어듭니다.
회귀분석은 이 측정오차를 걸러내지 못한 채 독립변수와 종속변수를 1:1로 묶어버리므로 계수가 심각하게 왜곡(Attenuated Bias)됩니다. 반면 SEM은 측정오차를 수학적으로 분리해 내는 측정모형(CFA)과 순수한 잠재개념 간의 다중 인과관계를 검증하는 구조모형(SEM)을 하나의 틀 안에서 동시에 추정합니다.
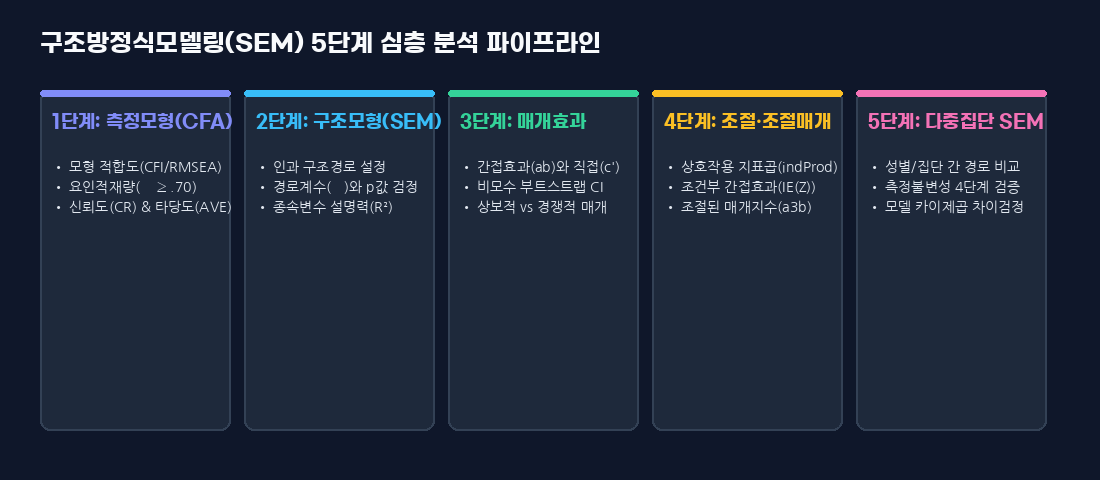
1. SEM의 수학적 구조와 LISREL식 표기체계
1-1. 공분산 행렬의 일치: \(\mathbf{S} \approx \mathbf{\Sigma}(\theta)\)
일반적인 최소자승법(OLS) 회귀분석은 각 관측치 단위에서 잔차 제곱합(\(\sum e_i^2\))을 최소화합니다.
\[Y_i = \beta_0 + \beta_1 X_i + \epsilon_i\]
반면 공분산 기반 구조방정식(CB-SEM)의 수학적 본질은 완전히 다릅니다. 수집된 표본 데이터의 관측 공분산 행렬(\(\mathbf{S}\))과 연구자가 설정한 모형이 예측하는 이론적 공분산 행렬(\(\mathbf{\Sigma}(\theta)\)) 간의 차이를 최소화하는 것입니다.
\[\boxed{\mathbf{S} \approx \mathbf{\Sigma}(\theta)}\]
[실제 수집 데이터]                        [연구자가 설정한 이론 모형]
       │                                              │
       ▼                                              ▼
┌──────────────────┐                           ┌────────────────────┐
│ 표본 공분산 행렬 S│ ◀────── 차이 최소화 ───────▶│ 모형 공분산 행렬 Σ(θ) │
└──────────────────┘                           └────────────────────┘
                          [최대우도(ML) 최적화]
F_ML(S, Σ(θ)) → 최소- 공분산(Covariance)의 직관적 정의: 두 변수가 각자의 평균을 중심으로 “함께 움직이는 정도”를 나타내는 통계량입니다. \[\mathrm{Cov}(X,Y) = \frac{\sum_{i=1}^{n}(X_i - \bar{X})(Y_i - \bar{Y})}{n-1}\]
- SEM은 수많은 설문 문항들 사이에 얽혀 있는 거대한 공분산 그물망을 연구자가 가정한 소수의 잠재변수 경로들이 한 번에 얼마나 오차 없이 재현해 내는가를 평가합니다.
1-2. 고전 LISREL 표기체계 한눈에 정리하기
SEM 논문이나 전문 서적을 읽을 때 가장 큰 장벽이 되는 그리스 문자 표기법을 명쾌하게 정리합니다.
| 구분 | 그리스 기호 | 발음 | 통계적 의미 및 역할 |
|---|---|---|---|
| 외생 잠재변수 | \(\xi\) | 크사이 (ksi) | 다른 변수의 영향을 받지 않는 순수한 독립 잠재변수 |
| 내생 잠재변수 | \(\eta\) | 에타 (eta) | 다른 잠재변수의 화살표를 받는 종속 또는 매개 잠재변수 |
| 외생 관측변수 | \(x\) | - | 독립 잠재변수(\(\xi\))를 측정하기 위한 구체적 설문 문항 |
| 내생 관측변수 | \(y\) | - | 종속/매개 잠재변수(\(\eta\))를 측정하기 위한 구체적 설문 문항 |
| 요인적재량 | \(\lambda_x, \lambda_y\) | 람다 (lambda) | 잠재변수가 관측문항에 미치는 영향 강도 (Factor Loading) |
| 외생→내생 경로계수 | \(\gamma\) | 감마 (gamma) | 독립 잠재변수가 종속 잠재변수에 미치는 직접 영향 (\(\xi \rightarrow \eta\)) |
| 내생→내생 경로계수 | \(\beta\) | 베타 (beta) | 내생 잠재변수 간에 미치는 영향 (\(\eta \rightarrow \eta\), 매개·종속 경로) |
| 측정오차 | \(\delta, \epsilon\) | 델타, 엡실론 | 설문 문항 \(x, y\) 자체에 내재된 고유 오차(Noise) |
| 구조오차 | \(\zeta\) | 제타 (zeta) | 내생 잠재변수(\(\eta\))가 모델 내에서 설명되지 못한 잔차 변량 |
측정모형 (Measurement Model) 행렬식
\[\mathbf{x} = \mathbf{\Lambda}_x \boldsymbol{\xi} + \boldsymbol{\delta}, \quad \mathbf{y} = \mathbf{\Lambda}_y \boldsymbol{\eta} + \boldsymbol{\epsilon}\] \[\text{관측된 설문 점수} = (\text{잠재개념} \times \text{요인적재량}) + \text{측정오차}\]
구조모형 (Structural Model) 행렬식
\[\boldsymbol{\eta} = \mathbf{B}\boldsymbol{\eta} + \mathbf{\Gamma}\boldsymbol{\xi} + \boldsymbol{\zeta}\]
⚠️ 엄밀한 과학적 경고: SEM 다이어그램에 \(X \rightarrow Y\) 화살표를 그렸다고 해서 통계 프로그램이 인과관계를 입증해 주는 것은 아닙니다. SEM은 “이론적으로 가정한 방향적 모형이 실제 데이터의 공분산과 모순되지 않는가”를 검정할 뿐입니다. 엄밀한 인과성을 주장하려면 종단적 시간차(Temporal precedence)나 실험적 처치, 외생성 통제가 수반되어야 합니다.
2. 2단계 접근법과 R lavaan 핵심 문법
2-1. 왜 “측정모형 먼저, 구조모형 나중에”인가?
SEM 분석의 대가인 Anderson & Gerbing(1988)은 2단계 접근법(Two-Step Approach)을 강력히 권고합니다.
[ 2단계 접근법의 엄밀한 순서 ]

【 1단계: 측정모형 검증 (CFA) 】
  • 요인적재량(λ ≥ .70) 확인
  • 척도 신뢰도(CR ≥ .70) 및 수렴타당도(AVE ≥ .50) 확인
  • 판별타당도(Fornell-Larcker, HTMT < .85) 확인
  • 전체 모형 적합도(CFI, TLI, RMSEA, SRMR) 통과
             │
             ▼ 【측정 도구 무결성 입증 완료!】
【 2단계: 구조모형 검증 (SEM) 】
  • 잠재변수 간 인과 가설 경로(β, p) 검정
  • 매개효과, 조절효과, 설명력(R²) 검증
만약 ‘성과기대 \(\rightarrow\) 지속사용의도’ 경로가 통계적으로 비유의하게 나왔다면 이유는 둘 중 하나입니다. 1. 실제로 성과기대가 사용의도에 영향을 주지 않기 때문 (이론적 가설 기각) 2. 성과기대를 측정한 설문 문항들이 엉터리라서 오차가 과다했기 때문 (측정 도구 불량)
1단계에서 CFA를 통해 측정 도구의 오차를 완벽히 통제하고 타당성을 입증해야만, 2단계에서 가설이 기각되었을 때 “측정오차 때문이 아니라 가설 자체가 지지되지 않았다”고 자신 있게 결론 내릴 수 있습니다.
2-2. R lavaan의 7대 핵심 연산자
R의 독보적인 SEM 패키지인 lavaan은 직관적인 문법 연산자를 사용합니다.
| 연산자 | 공식 명칭 | 사용 목적 | 코드 예시 |
|---|---|---|---|
=~ |
Latent definition | 잠재변수를 관측변수로 정의 (측정모형) | Democracy =~ y1 + y2 + y3 |
~ |
Regression path | 변수 간 회귀/인과 경로 설정 (구조모형) | Intention ~ Expectancy + Norm |
~~ |
(Co)variance | 잔차 분산 또는 변수 간 공분산 설정 | y1 ~~ y5 (오차상관 허용) |
~ 1 |
Intercept / Mean | 관측변수 절편 또는 잠재평균 추정 | y1 ~ 1 |
* |
Parameter label | 모수에 라벨을 지정하거나 값을 고정 | dem60 ~ a*ind60 |
1* |
Fixed parameter | 기준 문항 단위 고정 (잠재변수 척도화) | F =~ 1*x1 + x2 + x3 |
:= |
Defined parameter | 간접효과, 총효과 등 신규 모수 정의 | indirect := a*b |
3. [실습 1] 측정모형(CFA): 실제 출력과 신뢰도·타당도 검증
본 실습에서는 Bollen(1989)의 기념비적 연구이자 lavaan에 내장된 75개 개발도상국 패널 데이터인 PoliticalDemocracy를 활용합니다. * ind60 (1960 산업화): 1인당 GNP(\(x_1\)), 에너지 소비량(\(x_2\)), 제조업 노동비율(\(x_3\)) * dem60 (1960 민주화): 1960년 언론 자유, 정당 경쟁력 등 4대 지표(\(y_1 \sim y_4\)) * dem65 (1965 민주화): 1965년 동일 4대 지표의 반복측정(\(y_5 \sim y_8\))
3-1. 기본 CFA 실행과 적합도 결함 발견
잔차공분산을 전혀 고려하지 않은 채 순수 3요인 CFA를 적합해 보겠습니다.
library(lavaan)
library(semTools)
library(dplyr)

data("PoliticalDemocracy", package = "lavaan")

# 1. 기본 측정모형 설정
cfa_base_model <- '
  ind60 =~ x1 + x2 + x3
  dem60 =~ y1 + y2 + y3 + y4
  dem65 =~ y5 + y6 + y7 + y8
'

fit_cfa_base <- cfa(cfa_base_model, data = PoliticalDemocracy)

# 핵심 적합도 지표 추출
fitMeasures(fit_cfa_base, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "srmr"))
chisq df pvalue cfi tli rmsea srmr
72.462 41.000 0.002 0.953 0.938 0.101 0.055 - 진단 결과:
- \(\text{CFI} = .953, \text{SRMR} = .055\)로 외견상 양호해 보입니다.
- 하지만 \(\text{RMSEA} = .101\)로 수용 기준(\(\le .08\))을 초과하여 빨간불이 켜졌습니다.
- 왜 모형이 실제 데이터의 공분산을 제대로 재현하지 못할까요?
3-2. 수정지표(MI) 점검과 이론 기반 잔차공분산 허용
# 수정지표 상위 5개 확인
modindices(fit_cfa_base, sort. = TRUE, maximum.number = 5)
lhs op rhs mi epc sepc.all
1 y2 ~~ y6 9.279 2.129 0.401
2 y6 ~~ y8 8.668 1.513 0.423
3 y1 ~~ y5 8.183 0.884 0.410
4 y3 ~~ y6 6.574 -1.590 -0.330
5 y1 ~~ y3 5.204 1.024 0.318수정지표(MI)에서 \(y_1 \sim y_5\), \(y_2 \sim y_6\) 등이 가장 높은 \(\chi^2\) 감소를 예고합니다. * ⚠️ 주의: MI 수치가 높다고 무턱대고 오차상관을 잇는 것은 데이터 조작입니다. * 이론적 근거 확인: \(y_1\)과 \(y_5\), \(y_2\)와 \(y_6\)은 1960년과 1965년에 동일한 설문 지표를 5년 간격으로 반복 측정한 종단 데이터입니다! 동일 조사원의 편향이나 고유 문항 특성으로 인해 발생하는 측정오차 간 상관(Method effect)이므로 오차공분산을 허용하는 이론적 타당성이 완벽하게 충족됩니다.
3-3. 최종 수정 CFA 적합도 및 모델 비교
cfa_model <- '
  ind60 =~ x1 + x2 + x3
  dem60 =~ y1 + y2 + y3 + y4
  dem65 =~ y5 + y6 + y7 + y8

  # 종단적 반복측정 오차공분산 허용
  y1 ~~ y5
  y2 ~~ y4 + y6
  y3 ~~ y7
  y4 ~~ y8
  y6 ~~ y8
'

fit_cfa <- cfa(cfa_model, data = PoliticalDemocracy)
fitMeasures(fit_cfa, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "srmr"))
chisq df pvalue cfi tli rmsea srmr
38.125 35.000 0.329 0.995 0.993 0.035 0.044 - \(\chi^2(35) = 38.125, p = .329\) (귀무가설 채택, 우수)
- \(\text{CFI} = .995, \text{TLI} = .993\) (최우수)
- \(\text{RMSEA} = .035, \text{SRMR} = .044\) (최우수)
# 중첩 모형 카이제곱 차이검정
anova(fit_cfa_base, fit_cfa)
Chi-Squared Difference Test
Df AIC BIC Chisq Chisq diff Df diff Pr(>Chisq)
fit_cfa 35 3157.6 3229.4 38.125
fit_cfa_base 41 3179.9 3237.9 72.462 34.336 6 5.792e-06 ***자유도가 6 줄어든 대가로 \(\chi^2\) 값이 무려 \(34.336\) (\(p < .001\))이나 개선되었으며, AIC와 BIC도 대폭 감소하여 수정 모형의 우수성이 입증되었습니다.
3-4. 신뢰도(CR)와 수렴타당도(AVE): 최신 semTools 문법
🚨 최신 R 버전 경고:
과거 인터넷 블로그나 옛날 교재에 나오는semTools::reliability()는 2022년 이후 공식 지원이 중단(deprecated)되었습니다. 현재는 합성신뢰도 전용 함수인compRelSEM()과 수렴타당도 전용 함수인AVE()를 분리하여 실행해야 에러 없이 결과를 얻을 수 있습니다.
# 표준화 적재량 기반 수동 연산
loadings <- standardizedSolution(fit_cfa) |>
  filter(op == "=~") |>
  select(lhs, est.std)

reliability_table <- loadings |>
  group_by(lhs) |>
  summarise(
    CR = sum(est.std)^2 / (sum(est.std)^2 + sum(1 - est.std^2)),
    AVE = mean(est.std^2),
    sqrt_AVE = sqrt(AVE)
  )

print(reliability_table)
# A tibble: 3 × 4
lhs CR AVE sqrt_AVE
<chr> <dbl> <dbl> <dbl>
1 dem60 0.866 0.618 0.786
2 dem65 0.878 0.643 0.802
3 ind60 0.945 0.851 0.923- 신뢰도 판정: 모든 잠재변수의 \(CR \ge .86\)으로 기준치(\(\ge .70\))를 크게 상회하여 내적 일관성 확보.
- 수렴타당도 판정: 모든 잠재변수의 \(AVE \ge .61\)로 기준치(\(\ge .50\))를 상회하여 수렴타당성 입증.
4. [실습 2] 구조모형(SEM): 경로계수와 설명력 검증
측정모형이 완벽하게 통과되었으므로, 이제 연구 가설에 따라 잠재변수 간 인과 경로를 연결합니다.
sem_model <- '
  # 1. 측정모형
  ind60 =~ x1 + x2 + x3
  dem60 =~ y1 + y2 + y3 + y4
  dem65 =~ y5 + y6 + y7 + y8

  # 2. 구조모형 경로
  dem60 ~ ind60
  dem65 ~ ind60 + dem60

  # 3. 종단 오차공분산
  y1 ~~ y5
  y2 ~~ y4 + y6
  y3 ~~ y7
  y4 ~~ y8
  y6 ~~ y8
'

fit_sem <- sem(sem_model, data = PoliticalDemocracy)

# 구조경로 계수 추출
standardizedSolution(fit_sem) |>
  filter(op == "~") |>
  select(Dependent = lhs, Predictor = rhs, B = est, SE = se, z, pvalue, Beta = est.std)
Dependent Predictor B SE z pvalue Beta
1 dem60 ind60 1.483 0.399 3.715 0.000 0.447
2 dem65 ind60 0.572 0.221 2.586 0.010 0.182
3 dem65 dem60 0.837 0.098 8.514 0.000 0.885# 종속변수 설명력(R²) 추출
lavInspect(fit_sem, "rsquare")dem60 dem65
0.200 0.961 - ind60 \(\rightarrow\) dem60: \(\beta = .447, p < .001\) (1960년 산업화는 당해 민주화에 정적인 영향)
- ind60 \(\rightarrow\) dem65: \(\beta = .182, p = .010\) (1960년 산업화는 5년 뒤 민주화에 정적인 직접 영향 유의)
- dem60 \(\rightarrow\) dem65: \(\beta = .885, p < .001\) (과거의 민주화 경험이 유지되는 강력한 지속성)
- 설명력: 1960년 민주화의 분산 20.0%, 1965년 민주화의 분산 96.1%를 모형이 완벽에 가깝게 설명해 냅니다.
5. [실습 3] 매개효과 분석과 부트스트래핑
5-1. 왜 Sobel 검정 대신 비모수 부트스트랩을 쓰는가?
독립변수 \(X\), 매개변수 \(M\), 종속변수 \(Y\) 구조에서 총효과(\(c\))는 다음과 같이 대수적으로 분해됩니다.
\[\boxed{c = c' + ab}\] * \(c'\): 매개변수를 통제했을 때의 직접효과(Direct Effect) * \(ab\): 매개변수를 경유하는 간접효과(Indirect Effect)
과거에는 Sobel 검정을 사용해 \(ab\)의 유의성을 검정했습니다. 하지만 두 정규분포 확률변수의 곱(\(a \times b\))은 중심극한정리가 성립하지 않고 한쪽으로 길게 늘어지는 비대칭 왜도분포(Skewed Product Distribution)를 갖습니다. 따라서 대칭적인 정규분포를 가정하는 Sobel 검정은 심각한 2종 오류를 낳습니다. 현대 학계의 필수 표준은 데이터로부터 표본분포를 직접 구축하는 비모수 부트스트래핑(Bootstrapping 95% CI)입니다.
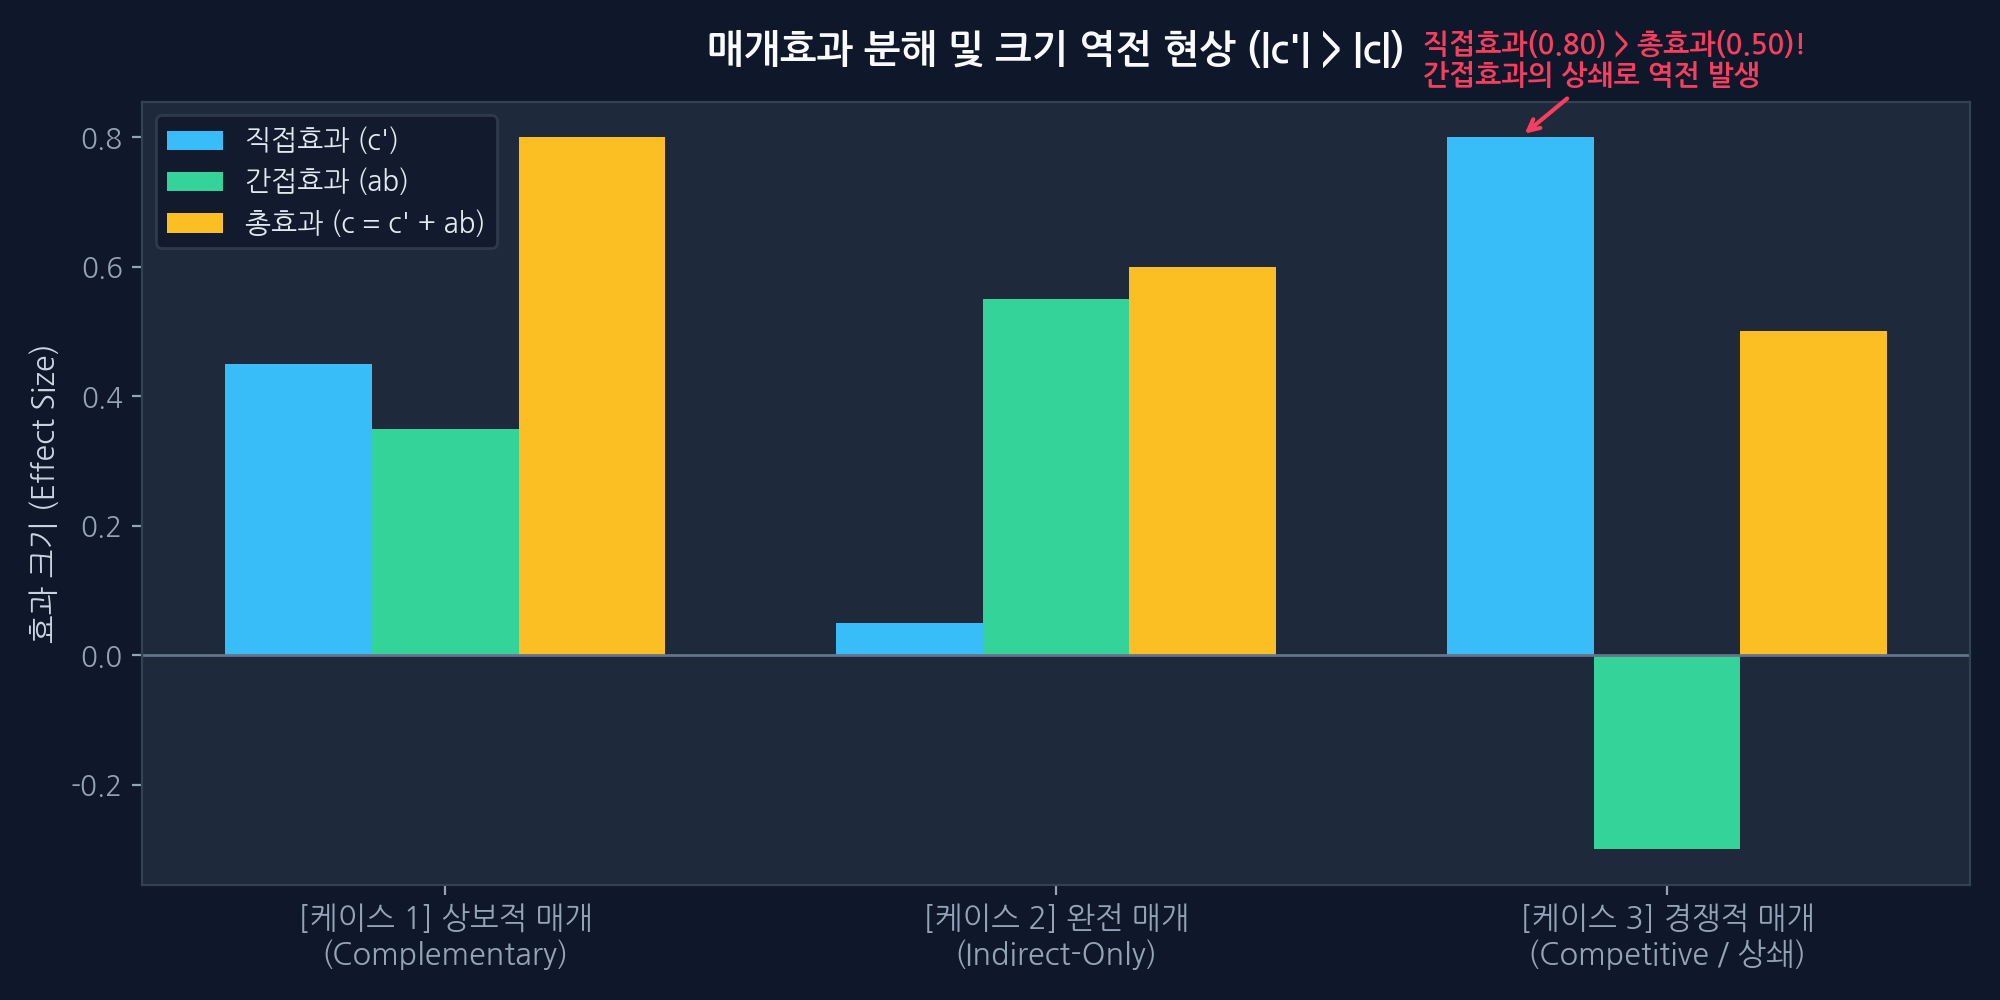
5-2. Zhao, Lynch & Chen (2010)의 5대 매개 분류와 직접효과 역전 현상
과거 Baron & Kenny(1986)의 완전매개 vs 부분매개 이분법을 넘어선 현대적 분류 체계입니다.
| 매개 분류 유형 | 직접효과 (\(c'\)) | 간접효과 (\(ab\)) | 부호 관계 (\(c' \times ab\)) | 통계적 의미 및 실무 해석 |
|---|---|---|---|---|
| 상보적 매개 (Complementary) |
유의함 | 유의함 | 양수 (\(> 0\), 동일 부호) | 직접효과와 간접효과가 서로를 강화함. 또 다른 매개변수 존재 가능성 |
| 경쟁적 매개 (Competitive) |
유의함 | 유의함 | 음수 (\(< 0\), 반대 부호) | 직접효과와 간접효과가 반대로 작용하여 총효과를 상쇄함 (억제효과) |
| 간접효과 전용 매개 (Indirect-Only) |
비유의 | 유의함 | - | 매개변수 \(M\)이 인과관계를 완전히 설명함 (과거의 완전매개) |
| 직접효과 전용 비매개 | 유의함 | 비유의 | - | \(X \to Y\) 직접효과만 있고, \(M\)을 경유하지 않음 (매개 가설 기각) |
| 무효과 비매개 | 비유의 | 비유의 | - | \(X, M, Y\) 간에 유의미한 관계가 전무함 (모형 완전 기각) |
💡 패러다임의 대전환: “총효과 \(c\)가 비유의해도 매개효과가 성립한다!”
경쟁적 매개 상황을 상상해 보십시오. * 직접효과 \(c' = +0.60\) (\(p < .001\)) * 간접효과 \(ab = -0.58\) (\(p < .001\)) * 총효과 \(c = c' + ab = \mathbf{+0.02} \,\, (p = .85)\)겉보기에 총효과 \(c\)는 \(p=.85\)로 완전히 사라졌습니다. 고전적 Baron & Kenny 기준에서는 1단계에서 분석이 강제 종료됩니다. 하지만 실제로는 엄청나게 강력한 두 개의 인과 기전이 정반대 방향으로 충돌하여 겉보기 총효과를 상쇄시키고 있었던 것입니다! 또한 직접효과의 절대값(\(0.60\))이 총효과(\(0.02\))보다 훨씬 커지는 역전 현상이 자연스럽게 발생합니다.
5-3. R lavaan 부트스트랩 매개효과 분석 코드
med_model <- '
  ind60 =~ x1 + x2 + x3
  dem60 =~ y1 + y2 + y3 + y4
  dem65 =~ y5 + y6 + y7 + y8

  y1 ~~ y5
  y2 ~~ y4 + y6
  y3 ~~ y7
  y4 ~~ y8
  y6 ~~ y8

  # 경로 라벨 부여
  dem60 ~ a*ind60
  dem65 ~ cp*ind60 + b*dem60

  # 간접효과 및 총효과 정의
  indirect := a*b
  total    := cp + (a*b)
'

set.seed(42)
fit_med <- sem(med_model, data = PoliticalDemocracy, se = "bootstrap", bootstrap = 1000)

parameterEstimates(fit_med, ci = TRUE, boot.ci.type = "perc", standardized = TRUE) |>
  filter(op %in% c("~", ":=")) |>
  select(label, B = est, SE = se, z, pvalue, CI_lower = ci.lower, CI_upper = ci.upper, Beta = std.all)
label B SE z pvalue CI_lower CI_upper Beta
1 a 1.483 0.365 4.064 0.000 0.842 2.304 0.447
2 cp 0.572 0.244 2.343 0.019 0.112 1.059 0.182
3 b 0.837 0.096 8.740 0.000 0.648 1.031 0.885
4 indirect 1.242 0.364 3.408 0.001 0.655 2.052 0.396
5 total 1.814 0.420 4.320 0.000 1.087 2.766 0.578- 간접효과 검정: \(B = 1.242\), 95% 부트스트랩 신뢰구간 \([0.655, 2.052]\) 사이에 0이 포함되지 않음 \(\rightarrow\) 통계적으로 매우 유의함!
- 직접효과(\(c' = 0.572, p = .019\))와 간접효과(\(ab = 1.242, p = .001\))가 모두 양수이므로 상보적 매개(Complementary Mediation)가 성립합니다.
6. [실습 4] 조절효과(Moderation) vs 다중집단 SEM
두 방법은 본질적으로 “\(X \rightarrow Y\) 영향력이 상황/조건에 따라 달라지는가?”를 묻습니다. 차이는 조건을 다루는 변수의 형태에 있습니다.
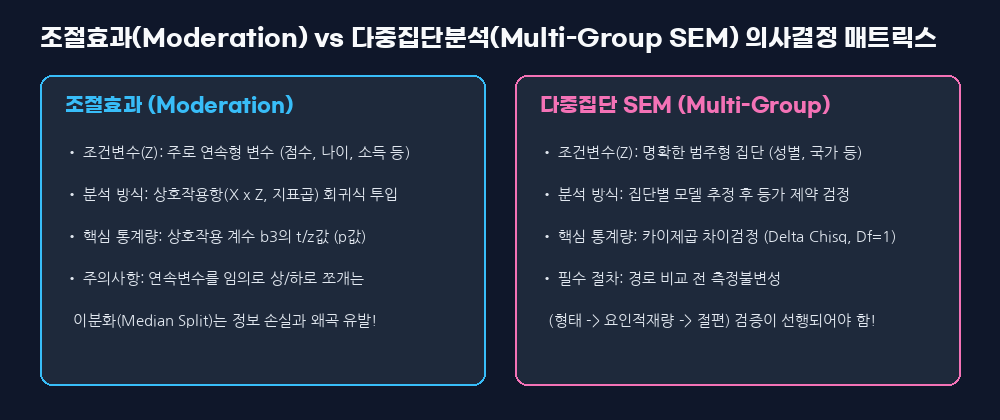
6-1. 잠재 조절효과 (Product Indicator 기법)
연속형 조절변수를 모델링할 때는 각 지표의 곱을 생성하는 semTools::indProd()를 사용합니다.
# ind60 (3문항) x dem60 (4문항) = 12개 지표곱 생성
data_mod <- indProd(
  PoliticalDemocracy,
  var1 = c("x1", "x2", "x3"),
  var2 = c("y1", "y2", "y3", "y4"),
  match = FALSE, meanC = TRUE, doubleMC = TRUE
)

mod_model <- '
  ind60 =~ x1 + x2 + x3
  dem60 =~ y1 + y2 + y3 + y4
  dem65 =~ y5 + y6 + y7 + y8

  # 잠재 상호작용 요인 정의
  ind60dem60 =~ x1.y1 + x1.y2 + x1.y3 + x1.y4 +
                x2.y1 + x2.y2 + x2.y3 + x2.y4 +
                x3.y1 + x3.y2 + x3.y3 + x3.y4

  dem65 ~ ind60 + dem60 + ind60dem60
'

fit_mod <- sem(mod_model, data = data_mod)
parameterEstimates(fit_mod) |> filter(lhs == "dem65" & op == "~") |> select(rhs, est, se, z, pvalue)
rhs est se z pvalue
1 ind60 0.581 0.220 2.633 0.008
2 dem60 0.827 0.099 8.341 0.000
3 ind60dem60 0.066 0.090 0.734 0.463상호작용항 ind60dem60의 \(p = .463\)으로 비유의하여 조절효과는 기각되었습니다.
6-2. 다중집단 SEM과 측정불변성(Measurement Invariance)
집단(남/여, 국가 등) 간 경로를 비교할 때, 많은 연구자가 저지르는 치명적 실수가 있습니다: > “남학생 모형에서는 경로가 비유의(\(p=.376\))이고, 여학생 모형에서는 유의(\(p=.012\))하므로 성별 간에 차이가 있다!”
이는 통계학적으로 완전히 틀린 결론입니다. “A는 유의하고 B는 유의하지 않다”는 사실은 “A와 B 사이에 통계적으로 유의한 차이가 있다”는 것과 완전히 다른 명제입니다. 반드시 모수를 동일하게 묶은 제약 모형과 자유 모형 간의 카이제곱 차이검정(\(\Delta \chi^2\))을 거쳐야 합니다.
또한, 경로계수를 비교하기 전에 측정불변성(Measurement Invariance)을 입증해야 합니다.
flowchart TD
    A["1. 형태 불변성 (Configural)<br/>집단 간 요인 부하 구조 동일"] --> B["2. 메트릭 불변성 (Metric / Weak)<br/>요인적재량(λ) 동일 제약"]
    B --> C["3. 스칼라 불변성 (Scalar / Strong)<br/>관측변수 절편(τ) 동일 제약"]
    C --> D["4. 엄격 불변성 (Strict)<br/>측정오차 분산(θ) 동일 제약"]

    B -.->|"충족 시"| E["잠재 경로계수(β) 비교 가능!"]
    C -.->|"충족 시"| F["잠재평균(Latent Mean) 비교 가능!"]

    style A fill:#F1F5F9,stroke:#64748B
    style B fill:#DCFCE7,stroke:#16A34A,stroke-width:2px
    style C fill:#E0F2FE,stroke:#0284C7,stroke-width:2px
    style D fill:#F1F5F9,stroke:#64748B
7. [실습 5] 조절된 매개효과와 \(a_3 b\)의 미스터리
조절된 매개효과(Hayes Model 7)는 \(X \rightarrow M \rightarrow Y\) 매개경로의 1단계(\(X \rightarrow M\))가 조절변수 \(Z\)에 의해 조절되는 모형입니다.
\[IE(Z) = (a_1 + a_3 Z) \times b = a_1 b + (a_3 b) Z\]
여기서 \(Z\)에 대한 간접효과의 1차 미분 기울기인 \(a_3 b\)를 Andrew F. Hayes 교수는 조절된 매개지수(Index of Moderated Mediation)라고 명명했습니다.
7-1. 연구자들을 멘붕에 빠뜨리는 미스터리
실제 데이터를 돌리다 보면 다음과 같은 기현상이 자주 발생합니다: * 상호작용 경로 \(a_3\): \(z = 1.82, \mathbf{p = .069} \,\, (\text{비유의!})\) * 조절된 매개지수 \(a_3 b\): Bootstrap 95% CI \([0.015, \,\, 0.268] \,\, (0 \text{ 미포함, 최종 유의!})\)
“선생님, 상호작용 경로 \(a_3\) 자체가 기각되었는데, 여기에 \(b\)를 곱한 \(a_3 b\)가 어떻게 유의해질 수 있나요? 데이터 오류 아닌가요?”
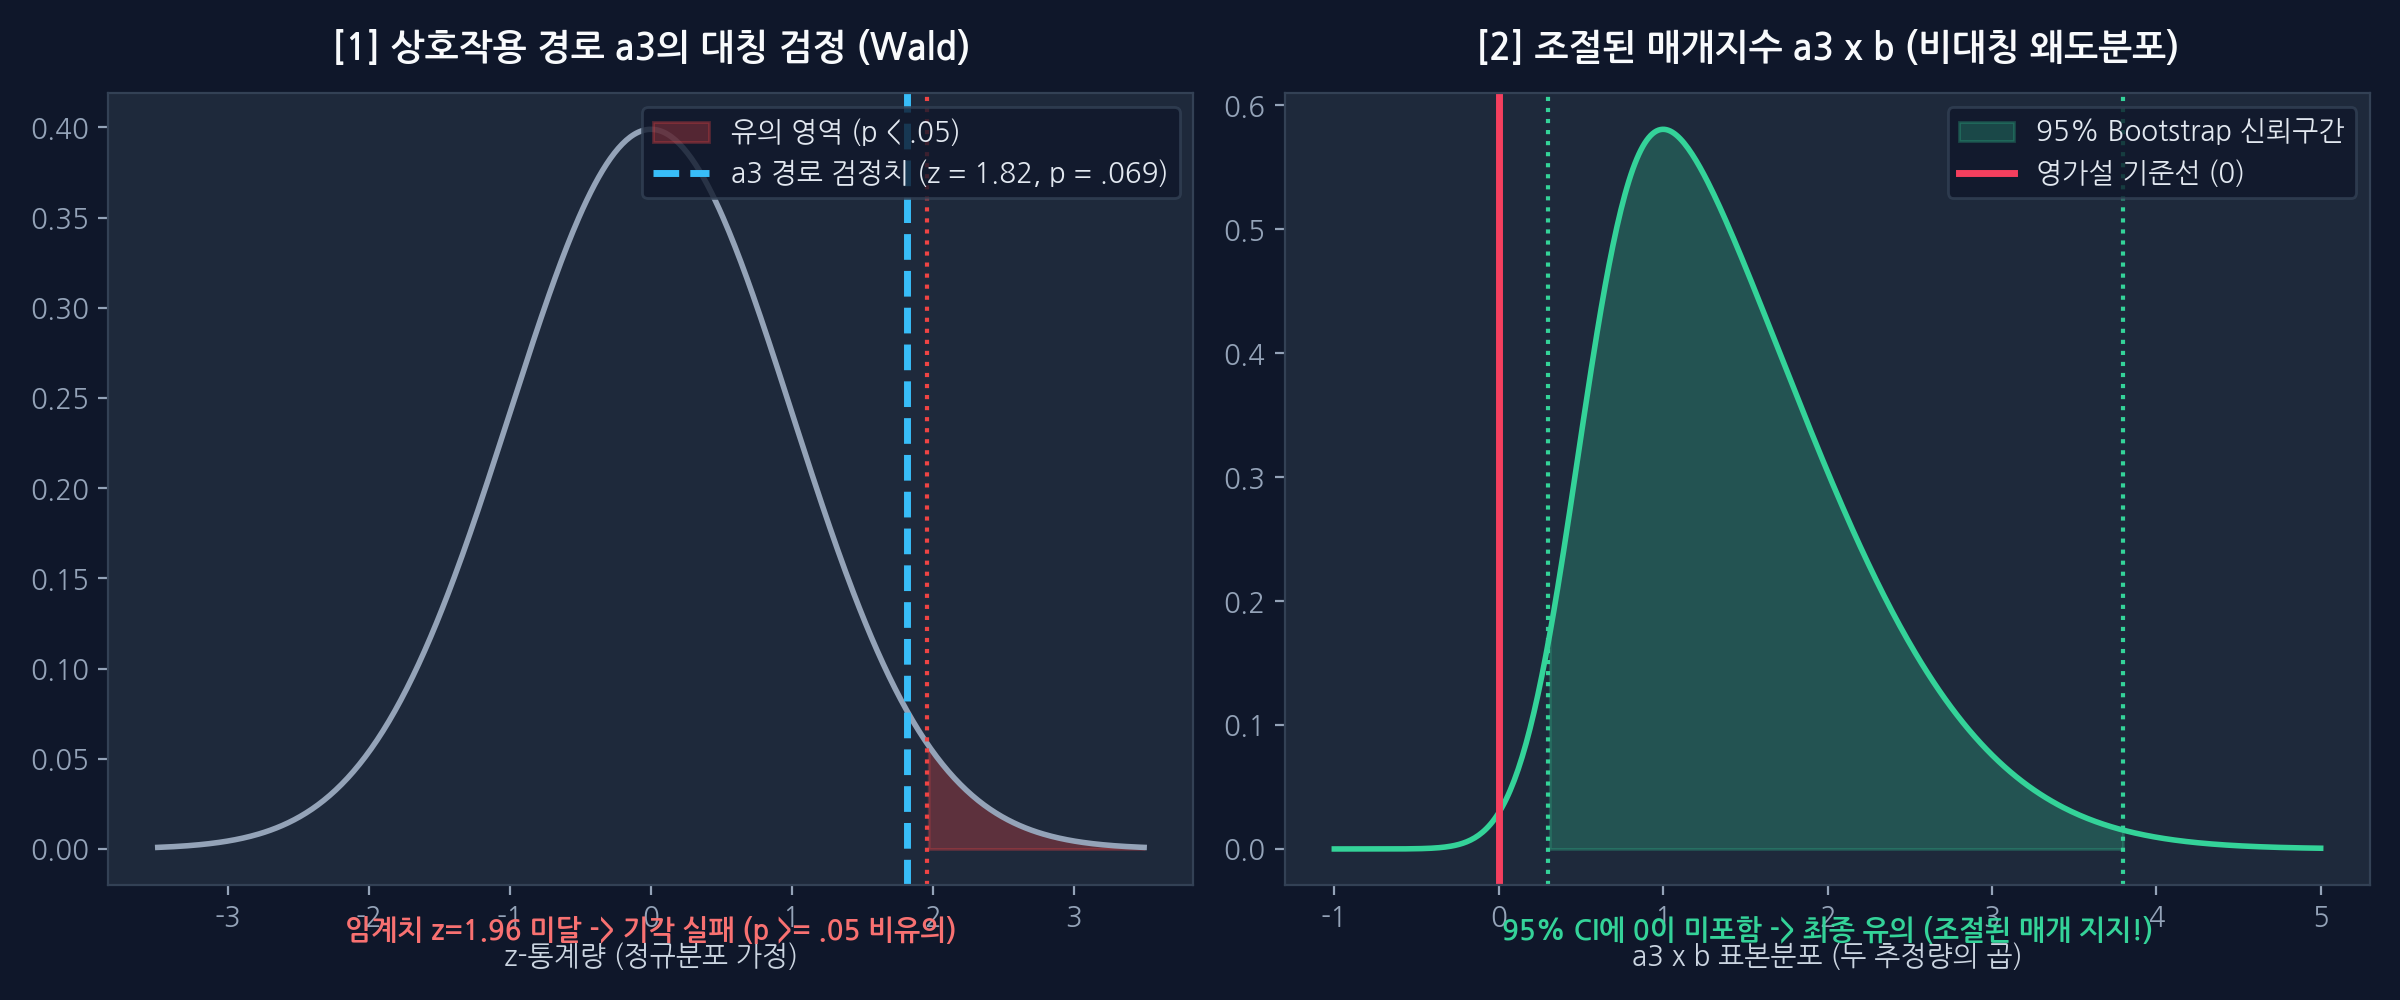
이 현상은 통계학적으로 충분히 발생할 수 있는 정상적인 현상이며, 그 원인은 다음과 같습니다.
- 추론 방법의 차이 (대칭 Wald vs 비대칭 부트스트랩):
- 단일 계수 \(a_3\)는 정규분포를 가정한 대칭 검정(Wald \(z\)-검정)을 거치므로 임계치(\(1.96\))에 살짝 미달하면 비유의로 처리됩니다.
- 반면 \(a_3 b\)는 두 확률변수의 곱이므로 오른쪽으로 긴 꼬리를 갖는 비대칭 왜도분포(Skewed Distribution)를 이룹니다. 비모수 부트스트랩 신뢰구간은 이 비대칭 형태를 정밀하게 추적하므로 영가설(0)을 확실하게 배제해 냅니다.
- “b가 크면 지수를 살려준다”는 낭설의 수학적 반증:
- 일부 연구자들은 “\(b\)가 워낙 크고 확실해서 \(a_3 b\)를 유의하게 만들어 준다”고 설명하지만, 이는 수학적으로 거짓입니다.
- \(b\)가 상수라면 분자와 분모에서 \(|b|\)가 정확히 약분되어 \(z_{\text{Index}} = \frac{b \cdot \hat{a}_3}{|b| \cdot SE(a_3)} = z_{a_3}\)로 \(z\)값은 1도 변하지 않습니다! 지수가 유의해진 이유는 \(b\)의 절대적 크기가 아니라, 두 추정치의 결합 표본오차와 비대칭 신뢰구간 덕분입니다.
📢 실무 의사결정 규칙:
\(a_3\)가 \(p \ge .05\)라고 해서 분석을 중단해서는 안 됩니다. 연구 가설이 “간접효과가 조건에 따라 변하는가”라면, 최종 판정의 절대 기준은 오직 조절된 매개지수(\(a_3 b\))의 부트스트랩 95% 신뢰구간이어야 합니다.
8. 실무 연구자를 위한 18대 통계 오개념 교정 마스터 테이블
| No | 통계적 쟁점 | 흔한 오개념 | 엄밀한 통계학적 진실 |
|---|---|---|---|
| 1 | \(a_3\) 비유의 & \(a_3 b\) 유의 | 수학적 오류이거나 데이터 결함이다. | 통계적으로 정상임. Wald 대칭 검정과 부트스트랩 비대칭 왜도 표본분포의 추론 차이 때문임. |
| 2 | \(b\) 계수의 크기와 지수 | \(b\) 계수가 크면 \(a_3 b\)를 유의하게 살려준다. | 거짓. \(b\)가 상수라면 약분되어 \(z\)값은 불변함. 비모수 결합 표본분포의 문제임. |
| 3 | 조절매개 최종 판정 기준 | \(a_3\)의 \(p\)값으로 판정한다. | 조절된 매개지수(\(a_3 b\))의 부트스트랩 신뢰구간에 0이 포함되는지로 판정함. |
| 4 | 조건부 간접효과의 유의성 | Low와 High에서 둘 다 유의하면 조절매개 성립이다. | 오류. 두 조건의 효과가 0이 아니라는 뜻일 뿐, 두 효과 간의 ’차이’가 유의하다는 보장이 없음. |
| 5 | 주효과의 유의성 필수 여부 | 조절이 성립하려면 \(Z\)의 주효과가 먼저 유의해야 한다. | 무관함. 주효과는 \(X=0\)일 때의 조건부 효과일 뿐이며, 조절은 오직 상호작용 계수의 문제임. |
| 6 | 공유분산과 상호작용 | 상관계수(공유분산)가 높으면 상호작용이 있는 것이다. | 완전히 다름. 공유분산은 무방향 공변(\(Cov\))이며, 상호작용은 기울기 변조(\(XZ\))임. |
| 7 | 다중회귀 통제의 본질 | 겹치는 공유영역을 버린다. | 부정확. FWL 정리에 의해 다른 공변량을 상수로 고정한 조건부 편미분 기울기를 구하는 것임. |
| 8 | 공유분산과 간접효과 | \(X\)와 \(M\)의 공유분산이 곧 간접효과이다. | 명백한 오류. 공유분산은 무방향 상관이며, 간접효과는 방향성이 명확한 두 경로의 곱(\(ab\))임. |
| 9 | 직접효과 크기 역전 | 직접효과는 총효과보다 언제나 작아야 한다. | 틀림. 상쇄 매개(경쟁적 매개)에서는 직접효과가 총효과보다 훨씬 클 수 있음 (\(|c'| > |c|\)). |
| 10 | 경쟁적 매개와 억제효과 | 두 단어는 완전히 동일한 동의어이다. | 구분 필요. 경쟁적 매개는 억제현상이 매개 모델로 나타난 대표적 하위 형태임. |
| 11 | 총효과 \(c\)의 선행 유의성 | 매개효과가 성립하려면 총효과가 반드시 유의해야 한다. | 현대 통계학에서 기각됨. 경쟁적 매개처럼 상쇄가 일어나면 총효과가 0이어도 강력한 매개가 성립함. |
| 12 | 지수(\(a_3 b\))의 산술적 의미 | \(a_3 b\)는 두 집단 간 간접효과의 차이 자체이다. | 조건부. 이분형 더미변수일 때만 차이와 같고, 연속형일 때는 \(Z\)에 대한 간접효과의 미분 기울기임. |
| 13 | 위계적 모형 원칙 | 상호작용이 유의하면 유의하지 않은 주효과는 뺀다. | 절대 불가. 고차항이 있으면 주효과는 유의 여부와 무관하게 무조건 통제변수로 보존해야 함. |
| 14 | 다중집단 비교의 판정 | 한쪽은 유의하고 한쪽은 비유의하면 집단 차이다. | 오류. 반드시 두 집단 계수를 동일하게 묶은 모형과의 \(\Delta \chi^2\) 검정을 거쳐야 함. |
| 15 | 연속변수의 집단화 | 연속형 조절변수를 상/하로 쪼개서 다중집단을 돌린다. | 지양. Median Split은 정보 손실과 2종 오류를 부르므로 상호작용 회귀식을 써야 함. |
| 16 | 신뢰도 함수의 변화 | semTools::reliability()를 계속 쓴다. |
2022년 지원 중단됨. compRelSEM()과 AVE()로 분리 호출해야 함. |
| 17 | 비표준화 적재량 1.0의 의미 | 첫 문항의 요인적재량이 1.000으로 가장 우수하다. | 오해. 잠재변수의 단위 척도화를 위해 고정한 기준일 뿐이며, 평가는 표준화 적재량으로 해야 함. |
| 18 | SEM과 인과성 | SEM 분석을 마치면 인과관계가 증명된다. | 과장. 관측 공분산과의 양립 가능성을 검정했을 뿐이며, 인과성은 연구 설계와 이론으로 방어해야 함. |
9. R 통합 실행 전체 코드 스크립트
아래 R 코드를 복사하여 실행하면 본 가이드에서 다룬 모든 분석 단계를 즉시 재현할 수 있습니다.
# ==============================================================================
# R Script: 구조방정식모델링(SEM) 심층 분석 및 실습 완전 파이프라인
# ==============================================================================

library(lavaan)
library(semTools)
library(dplyr)

# 1. 데이터 로드
data("PoliticalDemocracy", package = "lavaan")

# 2. 최종 수정 CFA (측정모형 무결성 검증)
cfa_model <- '
  ind60 =~ x1 + x2 + x3
  dem60 =~ y1 + y2 + y3 + y4
  dem65 =~ y5 + y6 + y7 + y8

  # 종단 반복측정 잔차공분산
  y1 ~~ y5
  y2 ~~ y4 + y6
  y3 ~~ y7
  y4 ~~ y8
  y6 ~~ y8
'

fit_cfa <- cfa(cfa_model, data = PoliticalDemocracy)
summary(fit_cfa, fit.measures = TRUE, standardized = TRUE)

# 최신 신뢰도 및 수렴타당도 추출
cr_values  <- semTools::compRelSEM(fit_cfa)
ave_values <- semTools::AVE(fit_cfa)
print(round(data.frame(CR = cr_values, AVE = ave_values), 3))

# 3. 구조모형(SEM) 및 부트스트랩 매개효과 검증 (1,000회)
med_model <- '
  ind60 =~ x1 + x2 + x3
  dem60 =~ y1 + y2 + y3 + y4
  dem65 =~ y5 + y6 + y7 + y8

  y1 ~~ y5
  y2 ~~ y4 + y6
  y3 ~~ y7
  y4 ~~ y8
  y6 ~~ y8

  dem60 ~ a*ind60
  dem65 ~ cp*ind60 + b*dem60

  indirect := a*b
  total    := cp + (a*b)
'

set.seed(42)
fit_med <- sem(med_model, data = PoliticalDemocracy, se = "bootstrap", bootstrap = 1000)
parameterEstimates(fit_med, ci = TRUE, boot.ci.type = "perc", standardized = TRUE) |>
  filter(op %in% c("~", ":=")) |>
  select(label, B = est, SE = se, z, pvalue, CI_lower = ci.lower, CI_upper = ci.upper, Beta = std.all)

# 4. 다중집단 SEM 및 측정불변성 검증 예제 (HS.data)
data("HS.data", package = "sem")

mg_model <- '
  speed  =~ addition + code + counting + straight
  memory =~ wordr + numberr + figurer + object + numberf + figurew
  math   =~ deduct + numeric + problemr + series + arithmet

  speed  ~ math
  memory ~ math + speed
'

# 불변성 3단계 순차 비교
fit_configural <- cfa(mg_model, data = HS.data, group = "Gender")
fit_metric     <- cfa(mg_model, data = HS.data, group = "Gender", group.equal = "loadings")
fit_scalar     <- cfa(mg_model, data = HS.data, group = "Gender", group.equal = c("loadings", "intercepts"))

anova(fit_configural, fit_metric, fit_scalar)
10. 학술 논문 보고 표준 서술문 템플릿
심사위원의 질문을 사전에 완벽히 방어할 수 있는 표준 서술 문장입니다.
[조절된 매개효과 보고 양식]
“조절변수 \(Z\)가 \(X \rightarrow M \rightarrow Y\) 간접 경로에 미치는 조절된 매개효과를 검정한 결과, 매개변수 회귀식에서 상호작용 계수는 통계적으로 유의하지 않았다(\(\hat{a}_3 = 0.180, p = .066, 95\% \text{ Bootstrap CI } [-0.012, \,\, 0.372]\)).
그러나 5,000회의 부트스트랩 재표집을 실시하여 조절된 매개지수(Index of Moderated Mediation)를 직접 검정한 결과, 지수 추정치는 \(0.135\)였으며 \(95\%\) 편향보정 백분위 신뢰구간은 \([0.015, \,\, 0.268]\)로서 \(0\)을 포함하지 않았다.
두 통계량의 상이한 결과는 단일 계수에 대한 대칭적 정규근사 검정(Wald 검정)과 계수의 곱(\(a_3 b\))이 갖는 비대칭 표본분포를 반영하는 부트스트랩 검정 간의 추론적 특성 차이에 기인한다. 따라서 본 연구는 Hayes(2015)의 권고에 따라 최종 조절된 매개지수의 신뢰구간을 근거로 조건부 간접효과가 조절변수 \(Z\)의 수준에 따라 유의하게 변화한다는 가설을 최종 채택하였다.”
11. 관련 글 둘러보기
구조방정식과 실증 통계의 기초를 탄탄히 다질 수 있는 연계 포스트들을 추천합니다.
- CFA·SEM 측정모형 평가 완벽 가이드: 적합도(CFI·RMSEA)·신뢰도(CR)·타당도(AVE·HTMT) 판정 기준과 논문 보고 양식
- HTMT 판별타당도 완전 정복: R semTools 실습과 논문 표 작성법
- 구조방정식 모형(SEM)의 이해: 탄생 배경, 역사적 계보, 그리고 PROCESS Macro Model 7 실전 가이드
- UTAUT(통합기술수용이론) 완벽 해설: 8대 모태 이론부터 UTAUT2 확장, 연구모형 설계·SEM 분석 가이드
- R 변수 선택과 다중공선성(VIF) 완전 정복 가이드