flowchart TD
    A["범주형 데이터 수집<br/>(예: 성별 × 체질 유형)"] --> B["분할표(Contingency Table) 작성<br/>관측빈도 O_ij 산출"]
    B --> C["귀무가설(H0: 독립) 하의<br/>기대빈도 E_ij 계산"]
    C --> D{"대표본 조건 검토<br/>E_ij < 5 인 셀이 20% 이하인가?"}
    D -- "조건 불만족 (소표본)" --> E["피셔의 정확검정<br/>fisher.test()"]
    D -- "조건 만족 (대표본)" --> F["피어슨 카이제곱 검정<br/>chisq.test()"]
    F --> G{"p-value < 0.05 유의한가?"}
    E --> G
    G -- "유의함 (연관성 존재)" --> H["사후분석 & 효과크기<br/>1. 수정된 표준잔차 (|z| > 1.96)<br/>2. 크래머의 V (Cramer's V)"]
    G -- "비유의 (독립)" --> I["두 변수는 통계적으로 독립임"]

    style A fill:#F1F5F9,stroke:#64748B,stroke-width:1.5px
    style B fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style C fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style D fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style E fill:#FEE2E2,stroke:#DC2626,stroke-width:1.5px
    style F fill:#DCFCE7,stroke:#16A34A,stroke-width:1.5px
    style G fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style H fill:#F3E8FF,stroke:#7C3AED,stroke-width:2px
    style I fill:#F1F5F9,stroke:#64748B,stroke-width:1px
💡 핵심 요약 (Executive Summary):
- 카이제곱 통계량의 수학적 본질: 카이제곱 검정은 “두 변수가 서로 아무런 관련이 없다(독립이다)”라는 귀무가설 하에서 계산된 기대빈도(\(E_{ij} = \frac{R_i \times C_j}{N}\))와 실제 수집된 관측빈도(\(O_{ij}\)) 간의 표준화된 편차 제곱합(\(\sum \frac{(O - E)^2}{E}\))을 검정 통계량으로 삼습니다.
- 검정 3대 유형의 연구설계상 차이: 동일한 수식(\(\chi^2\))을 사용하더라도 연구 표본 추출 방식에 따라 적합도 검정(단일 표본 1개 변수), 독립성 검정(단일 표본 2개 변수 간 연관), 동질성 검정(서로 다른 모집단에서 추출한 다중 표본 간 분포 일치)으로 명확히 구분됩니다.
- Cochran의 대표본 가정과 피셔의 정확검정: 카이제곱 분포는 표본 크기가 무한대로 갈 때 성립하는 점근적(Asymptotic) 근사입니다. 따라서 “기대빈도가 5 미만인 셀이 전체의 20%를 초과”하거나 어떤 셀의 기대빈도라도 1 미만이면 근사가 붕괴하므로, 초기하분포 기반의 피셔의 정확검정(
fisher.test)으로 즉시 전환해야 합니다.- 카이제곱 검정의 최대 맹점 극복 (수정된 표준잔차): 카이제곱 검정의 \(p\)-값이 유의하게 나오더라도 “구체적으로 어떤 범주 조합에서 차이가 발생했는가?”는 알려주지 못합니다. 각 셀의 표준오차를 분할표 주변 합으로 보정한 수정된 표준잔차(Adjusted Standardized Residuals, \(|z_{ij}| > 1.96\))를 계산해야만 차이를 주도한 핵심 셀을 식별할 수 있습니다.
- 효과크기(Effect Size) 평가: 표본 크기 \(N\)이 커지면 사소한 차이도 무조건 \(p < .001\)로 유의하게 나옵니다. 이를 통제하고 두 범주형 변수의 순수한 연관성 강도를 평가하기 위해 \(2 \times 2\) 표에서는 오즈비(Odds Ratio), \(r \times c\) 표에서는 크래머의 V(Cramer’s V)를 반드시 병행 보고해야 합니다.
0. “A/B 테스트 결과, 성별에 따라 선호도가 다른 걸까?”
디지털 마케팅, 의학 통계, 설문조사 실무에서 가장 흔하게 마주치는 데이터는 숫자가 아니라 ’이름표’가 붙은 범주형(Categorical) 데이터입니다. * 성별(남/여)에 따라 선호하는 스마트폰 브랜드(애플/삼성)가 다른가? * 약물 투여 여부(투여/위약)에 따라 질병 완치율에 유의미한 차이가 있는가? * 고객의 연령대(20대/30대/40대 이상)와 멤버십 등급(일반/VIP) 사이에 연관성이 존재하는가?
이러한 범주형 변수 간의 연관성을 파악하기 위해 데이터를 교차 집계한 표를 분할표(Contingency Table) 또는 교차표(Cross Table)라고 부르며, 이 표에서 두 변수가 독립적인지를 통계적으로 입증하는 기법이 바로 카이제곱 검정(Chi-Square Test)입니다.
단순히 “카이제곱 검정 결과 \(p < .05\)로 유의하다”에서 끝내면 안 됩니다. 실무에서는 어느 집단에서 차이가 벌어졌는지(수정된 표준잔차), 그리고 그 차이가 실제 비즈니스 관점에서 얼마나 강력한지(효과크기)까지 증명해야 합니다.
1. 분할표와 카이제곱 통계량의 수학적 메커니즘
1-1. 기대빈도(\(E_{ij}\))는 어떻게 유도되는가?
수학적 원리를 이해하기 위해 \(2 \times 2\) 분할표를 살펴보겠습니다.
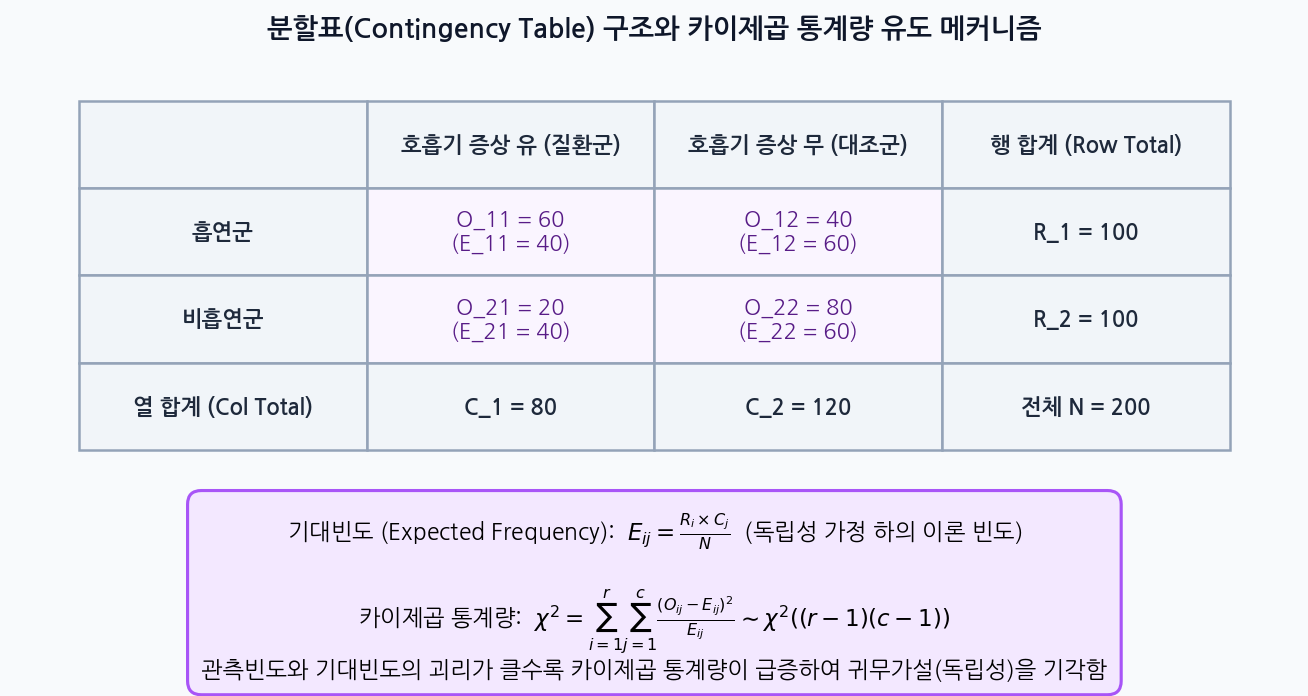
확률론에서 두 사건 \(A\)와 \(B\)가 서로 독립(Independent)이라는 것의 수학적 정의는 두 사건이 동시에 발생할 확률이 각 사건의 발생 확률의 곱과 같다는 것입니다.
\[P(A \cap B) = P(A) \times P(B)\]
이를 분할표의 \(i\)번째 행(\(R_i\))과 \(j\)번째 열(\(C_j\))에 대입해 봅시다. * 어떤 표본이 \(i\)행에 속할 확률: \(P(R_i) = \frac{R_i}{N}\) * 어떤 표본이 \(j\)열에 속할 확률: \(P(C_j) = \frac{C_j}{N}\)
만약 두 변수가 완벽하게 독립이라면, 한 관측치가 \(i\)행과 \(j\)열의 교차 셀에 들어갈 확률은 다음과 같습니다.
\[P(\text{Cell}_{ij}) = P(R_i) \times P(C_j) = \frac{R_i}{N} \times \frac{C_j}{N}\]
따라서 전체 표본 \(N\)명 중에서 이 셀에 들어갈 것으로 예상되는 이론적 기대빈도(Expected Frequency, \(E_{ij}\))는 확률에 전체 표본수를 곱한 값이 됩니다.
\[\boxed{E_{ij} = N \times P(\text{Cell}_{ij}) = N \times \left( \frac{R_i}{N} \times \frac{C_j}{N} \right) = \frac{R_i \times C_j}{N}}\]
“해당 행의 합계(\(R_i\))와 해당 열의 합계(\(C_j\))를 곱한 뒤 전체 표본수(\(N\))로 나눈다”는 실무 공식이 바로 이 확률론적 독립성 정의에서 자연스럽게 도출된 것입니다.
1-2. 카이제곱 통계량(\(\chi^2\))의 유도와 자유도
실제 관측된 빈도 \(O_{ij}\)와 독립일 때 나와야 하는 기대빈도 \(E_{ij}\) 사이의 격차를 정량화합니다.
\[\chi^2 = \sum_{i=1}^r \sum_{j=1}^c \frac{(O_{ij} - E_{ij})^2}{E_{ij}}\]
- 왜 제곱을 취하는가?: \((O_{ij} - E_{ij})\)의 단순 합은 언제나 정확히 \(0\)이 되므로 부호를 제거하기 위해 제곱합니다.
- 왜 분모에 \(E_{ij}\)를 나누는가?: 기대빈도가 1000명일 때의 오차 10명과, 기대빈도가 2명일 때의 오차 10명은 차원의 무게가 다릅니다. 상대적 편차를 표준화(Standardization)하기 위해 분모에 \(E_{ij}\)를 나누어 줍니다.
- 자유도(Degrees of Freedom, \(df\)): \[df = (r - 1)(c - 1)\] 전체 행의 합과 열의 합이 이미 고정되어 있으므로, \(r\)개의 행 중 \((r-1)\)개, \(c\)개의 열 중 \((c-1)\)개의 셀 빈도만 자유롭게 채워지면 나머지 셀의 빈도는 산술적으로 자동 결정되기 때문입니다.
2. 카이제곱 검정 3대 유형: 연구설계에 따른 명확한 구분
수식과 계산법은 완전히 동일하지만, 데이터를 어떻게 수집했느냐(연구 설계)에 따라 해석과 가설의 이름이 완전히 달라집니다. ADP 시험과 실무 보고서에서 가장 엄격하게 따지는 부분입니다.
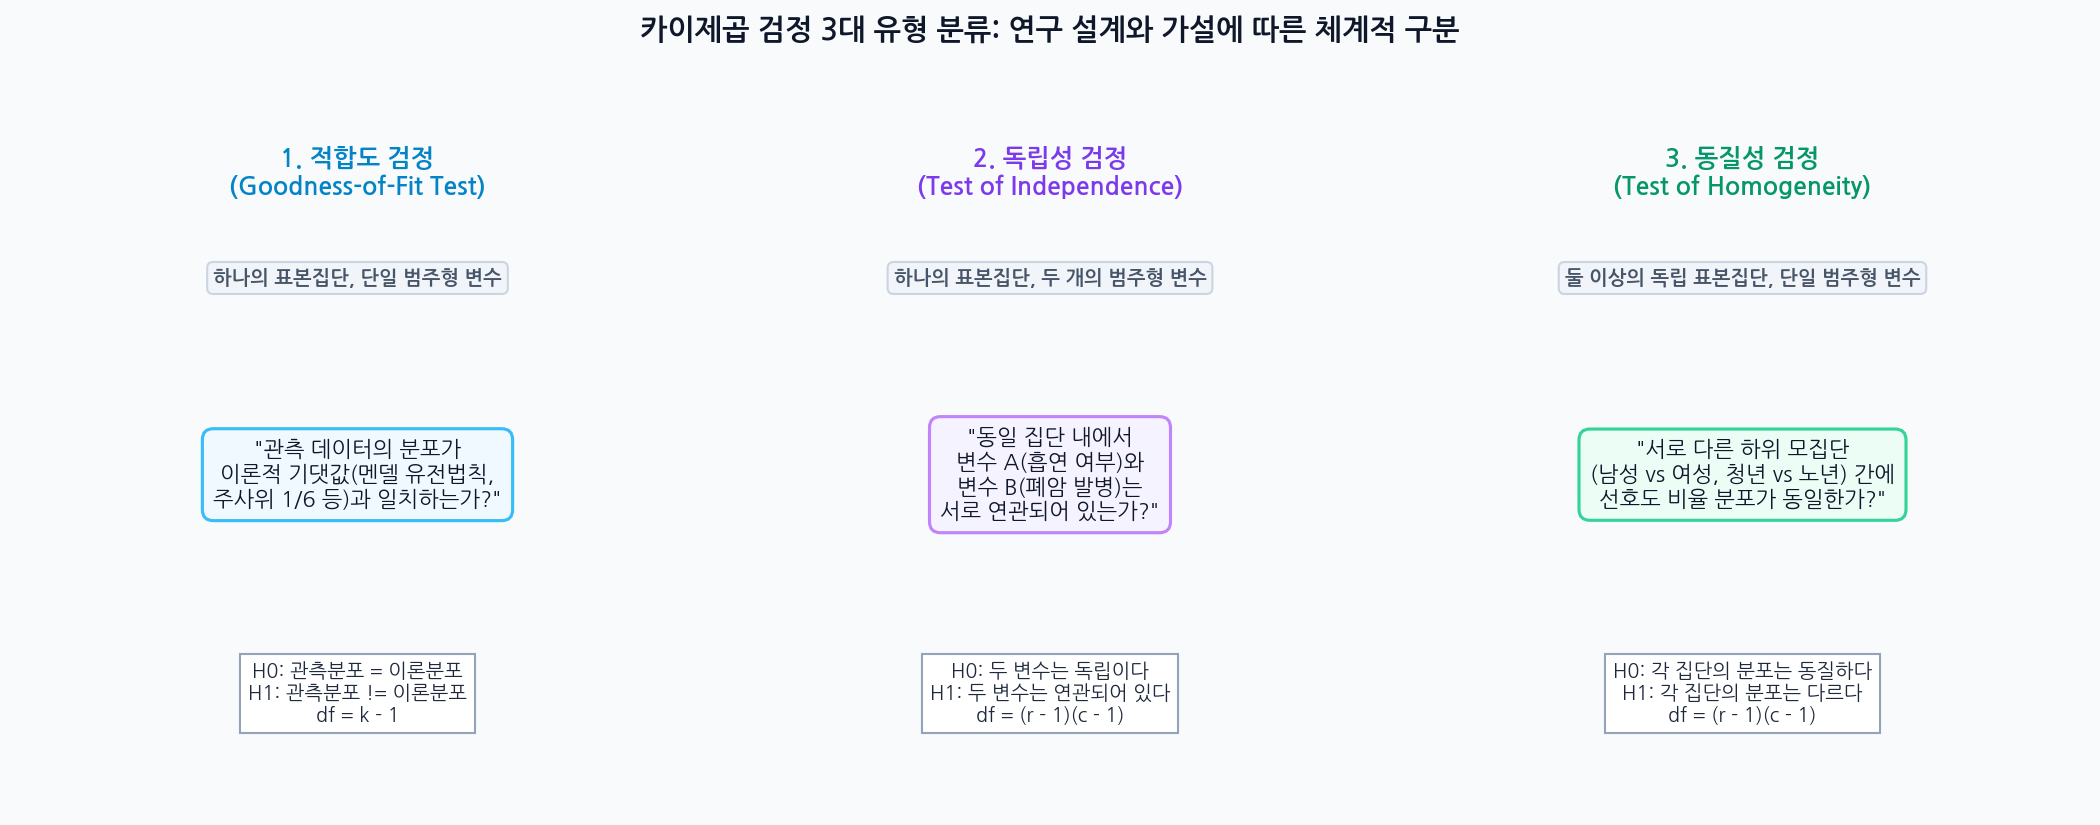
2-1. 3대 검정 종합 비교
| 구분 | 1. 적합도 검정 (Goodness-of-fit) | 2. 독립성 검정 (Independence) | 3. 동질성 검정 (Homogeneity) |
|---|---|---|---|
| 표본 추출 | 단일 표본집단 (\(1\)개 모집단) | 단일 표본집단 (\(1\)개 모집단) | 둘 이상의 독립된 하위 표본 (\(k\)개 모집단) |
| 관찰 변수 | 단일 범주형 변수 (\(1\)개) | 두 개의 범주형 변수 (\(2\)개) | 단일 범주형 변수 (\(1\)개) |
| 연구 질문 | “관측 분포가 이론적 비율(멘델 유전비, 균등분포 등)과 일치하는가?” | “동일 집단 내에서 변수 A와 변수 B가 서로 얽혀 있는가?” | “서로 다른 모집단(성별, 지역별) 간에 선호 비율 분포가 같은가?” |
| 귀무가설(\(H_0\)) | 관측분포는 기대분포를 따른다. | 두 변수는 서로 독립이다. | 각 모집단의 범주별 비율은 동질하다. |
| 대립가설(\(H_1\)) | 관측분포는 기대분포를 따르지 않는다. | 두 변수는 서로 연관되어 있다. | 적어도 한 모집단의 비율 분포가 다르다. |
| 자유도(\(df\)) | \(k - 1\) (\(k\): 범주 수) | \((r - 1)(c - 1)\) | \((r - 1)(c - 1)\) |
3. 대표본 조건과 피셔의 정확검정(Fisher’s Exact Test)
카이제곱 분포는 표본수 \(N \to \infty\)일 때 성립하는 점근적(Asymptotic) 중심극한정리 기반의 근사치입니다. 표본이 작거나 특정 범주에 관측치가 몰려 기대빈도가 너무 작아지면 이 근사는 완전히 붕괴합니다.
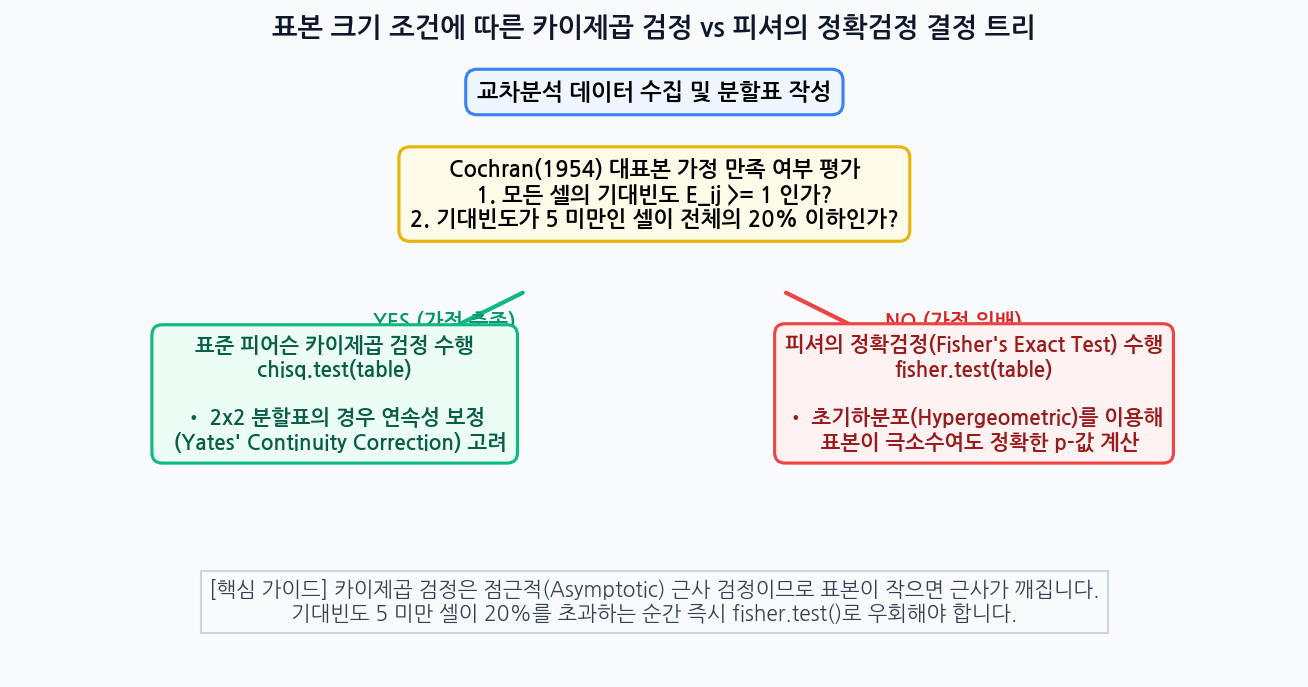
3-1. Cochran(1954)의 대표본 충족 기준
- 분할표의 모든 셀에서 기대빈도가 최소 1 이상(\(E_{ij} \ge 1\))이어야 한다.
- 기대빈도가 5 미만(\(E_{ij} < 5\))인 셀의 비율이 전체 셀의 20% 이하여야 한다.
이 두 가지 조건 중 단 하나라도 깨지는 순간 카이제곱 검정의 \(p\)-값은 왜곡되며, R 콘솔에 Warning: Chi-squared approximation may be incorrect라는 경고 메시지가 출력됩니다.
3-2. 피셔의 정확검정(Fisher’s Exact Test)의 구원
대표본 조건이 깨졌을 때 구원투수로 등판하는 것이 피셔의 정확검정(fisher.test)입니다. 피셔의 정확검정은 점근적 근사를 사용하지 않고, 분할표의 행 합계(\(R_i\))와 열 합계(\(C_j\))가 고정되어 있다는 조건 하에서 조합론(Combinatorics)의 초기하분포(Hypergeometric Distribution)를 이용해 해당 데이터가 우연히 관측될 수 있는 정확한 확률(Exact Probability)을 직접 계산합니다.
\[P = \frac{\binom{a+b}{a}\binom{c+d}{c}}{\binom{N}{a+c}} = \frac{(a+b)! (c+d)! (a+c)! (b+d)!}{a! b! c! d! N!}\]
표본이 단 10개, 20개에 불과하더라도 통계적 오류 없이 정확한 결론을 내릴 수 있습니다.
# R 실무 처리 코드
ctable <- table(df$gender, df$preference)

# 1. 기대빈도 조건 충족 여부 사전 확인
chisq_obj <- chisq.test(ctable)
prop_small_cells <- mean(chisq_obj$expected < 5)

if (prop_small_cells > 0.20 || any(chisq_obj$expected < 1)) {
  cat("경고: 기대빈도 5 미만 셀 비율이", round(prop_small_cells * 100, 1),
      "%로 대표본 조건을 위배함 -> 피셔의 정확검정 실행\n")
  final_test <- fisher.test(ctable)
} else {
  cat("대표본 조건 충족 -> 표준 카이제곱 검정 실행\n")
  final_test <- chisq.test(ctable)
}
print(final_test)
4. 사후분석의 핵심: 수정된 표준잔차(Adjusted Standardized Residuals)
“카이제곱 검정을 돌렸더니 \(p = .002\)로 유의하게 나왔습니다. 그래서 남성과 여성의 선호도가 다릅니다!”
이 보고를 들은 팀장이나 교수님의 다음 질문은 뻔합니다. “그래서, 남성이 어떤 제품을 유의하게 더 선호한다는 뜻인가요?”
이 질문에 답하지 못하면 카이제곱 검정은 반쪽짜리에 불과합니다. ANOVA에서 사후검정(Tukey HSD)을 하듯, 분할표에서는 수정된 표준잔차(Adjusted Standardized Residuals)를 통해 차이를 유발한 진원지를 추적해야 합니다.
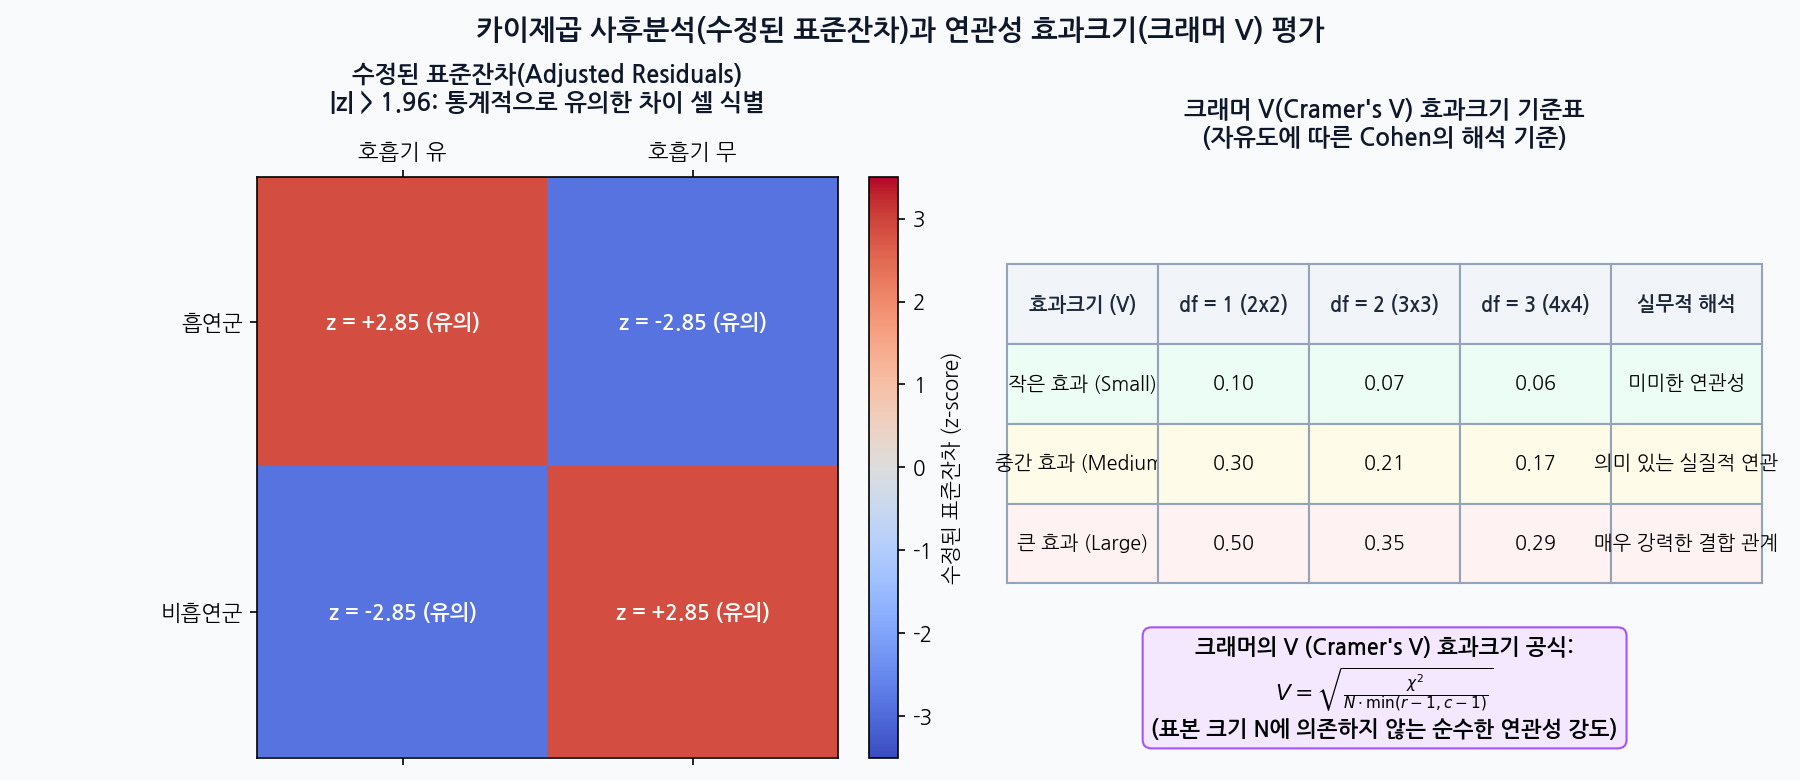
4-1. 잔차의 3단계 진화
- 피어슨 잔차 (Pearson Residual): \[e_{ij} = \frac{O_{ij} - E_{ij}}{\sqrt{E_{ij}}}\] 단순 관측과 기대의 편차를 표준화했으나, 셀 간의 상호 종속성으로 인해 분산이 1이 되지 않습니다.
- 표준화 잔차 (Standardized Residual): 피어슨 잔차의 분산을 부분적으로 보정한 형태입니다.
- 수정된 표준잔차 (Adjusted Standardized Residual, \(z_{ij}\)): Haberman(1973)이 제안한 방식으로, 분할표 주변합의 비율을 분모에 반영하여 완벽하게 표준정규분포 \(\mathcal{N}(0, 1)\)을 따르도록 분산을 정확히 1로 교정한 통계량입니다.
\[\boxed{z_{ij} = \frac{O_{ij} - E_{ij}}{\sqrt{E_{ij} \left(1 - \frac{R_i}{N}\right) \left(1 - \frac{C_j}{N}\right)}} \sim \mathcal{N}(0, 1)}\]
4-2. 해석 기준 (Z-score 룰)
- \(z_{ij} > +1.96\) (\(p < .05\)): 해당 셀의 관측빈도가 기대빈도보다 통계적으로 유의하게 많이 발생함 (선호/집중).
- \(z_{ij} < -1.96\) (\(p < .05\)): 해당 셀의 관측빈도가 기대빈도보다 통계적으로 유의하게 적게 발생함 (기피/이탈).
- \(|z_{ij}| > 2.58\) (\(p < .01\)): \(99\%\) 신뢰수준에서 매우 강력한 차이를 보임.
5. 연관성 강도 측정: 오즈비(OR)와 크래머의 V(Cramer’s V)
표본 크기 \(N\)이 10만 명쯤 되면, 남녀 선호도 차이가 겨우 \(0.1\%\)p에 불과해도 카이제곱 통계량은 수백으로 치솟고 \(p\)-값은 \(0.0000001\)이 됩니다. 이것은 표본이 커서 생긴 통계적 유의성일 뿐, 실무적으로는 아무런 가치가 없는 연관성입니다. 따라서 표본수 \(N\)의 영향을 완벽히 제거한 효과크기(Effect Size)를 반드시 계산해야 합니다.
5-1. 2x2 분할표의 표준: 오즈비(Odds Ratio, OR)
\[OR = \frac{O_{11} \times O_{22}}{O_{12} \times O_{21}}\]
- 흡연자 중 질환 발병 승산 / 비흡연자 중 질환 발병 승산
- \(OR = 1\): 연관성 없음, \(OR > 1\): 양의 연관, \(OR < 1\): 음의 연관
5-2. rx c 분할표의 표준: 크래머의 V (Cramer’s V)
\(3 \times 3\), \(2 \times 4\) 등 일반적인 다범주 분할표에서는 피어슨 카이제곱 통계량을 바탕으로 \(0\)과 \(1\) 사이의 값으로 정규화한 크래머의 V를 사용합니다.
\[\boxed{V = \sqrt{\frac{\chi^2}{N \times \min(r - 1, c - 1)}}}\]
- \(0 \le V \le 1\)의 범위를 가집니다.
- \(V = 0\): 두 변수 간에 완전한 독립
- \(V = 1\): 두 변수 간에 완벽한 연관
- Cohen(1988)의 실무 해석 기준 (자유도 \(k^* = \min(r-1, c-1) = 1\) 기준):
- \(V \approx 0.10\): 작은 효과 (미미한 연관성)
- \(V \approx 0.30\): 중간 효과 (유의미하고 실질적인 연관성)
- \(V \ge 0.50\): 큰 효과 (대단히 강력한 결합 관계)
6. R gmodels::CrossTable() 완전 해독 가이드
R에서 교차분석을 수행할 때 가장 널리 쓰이는 표준 패키지가 gmodels의 CrossTable 함수입니다. 처음 이 함수의 출력을 보면 쏟아지는 숫자에 당황하기 쉽습니다.
library(gmodels)

CrossTable(df$gender, df$constitution,
           expected = TRUE,     # 기대빈도 표시
           chisq = TRUE,        # 카이제곱 검정 결과 표시
           fisher = TRUE,       # 피셔 정확검정 표시
           asresid = TRUE,      # 수정된 표준잔차(Adjusted Standardized Residual) 표시
           prop.c = FALSE,      # 열 비율 숨김 (가독성 향상)
           prop.r = TRUE,       # 행 비율 표시
           prop.t = FALSE,      # 전체 비율 숨김
           prop.chisq = FALSE)  # 셀 기여 카이제곱 숨김
========================================================================
Total Observations in Table: 200
========================================================================
| df$constitution
df$gender | 열소한소 | 열소한대 | 열대한소 | 열대한대 | Row Total |
-------------|------------|------------|------------|------------|------------|
남자 | 15 | 35 | 20 | 30 | 100 |
| 25.000 | 25.000 | 25.000 | 25.000 | | <- Expected (기대빈도)
| 0.150 | 0.350 | 0.200 | 0.300 | 0.500 | <- Row Prop (행 비율)
| -2.828 | 2.828 | -1.414 | 1.414 | | <- Adj Std Resid (수정표준잔차)
-------------|------------|------------|------------|------------|------------|
여자 | 35 | 15 | 30 | 20 | 100 |
| 25.000 | 25.000 | 25.000 | 25.000 | |
| 0.350 | 0.150 | 0.300 | 0.200 | 0.500 |
| 2.828 | -2.828 | 1.414 | -1.414 | |
-------------|------------|------------|------------|------------|------------|
Column Total | 50 | 50 | 50 | 50 | 200 |
========================================================================
Statistics for All Table Factors:
Pearson's Chi-squared test:
Chi^2 = 16.0, d.f. = 3, p-value = 0.001134출력 해독 포인트:
- 전체 검정: 카이제곱 통계량이 \(16.0\), \(df=3\), \(p = 0.0011\)로 성별과 체질 구분 사이에는 유의미한 연관성이 존재합니다.
- 사후 분석 (수정된 표준잔차):
- 남자의 ‘열소한대’ 셀의 \(z = +2.828\) (\(> 1.96\)): 남성은 기대치보다 ‘열소한대’ 체질이 통계적으로 유의하게 많음.
- 남자의 ‘열소한소’ 셀의 \(z = -2.828\) (\(< -1.96\)): 남성은 기대치보다 ‘열소한소’ 체질이 유의하게 적음.
- 반대로 여성은 ‘열소한소’(\(z = +2.828\))가 유의하게 많고 ‘열소한대’(\(z = -2.828\))가 유의하게 적음.
- ’열대한소’와 ’열대한대’는 \(|z| = 1.414 < 1.96\)이므로 성별에 따른 유의한 차이가 없음.
7. 실전 R 실습 풀코드: 호흡기 질환과 한열 체질 교차분석 파이프라인
데이터 생성부터 분할표 작성, 기대빈도 검토, 카이제곱 및 피셔 검정, 수정된 표준잔차 사후분석, 크래머 V 효과크기 산출까지 한 번에 완료하는 표준 템플릿입니다.
#######################################################
# 교차분석 및 카이제곱 검정 실전 완전 정복 파이프라인
#######################################################

suppressPackageStartupMessages({
  library(tidyverse)
  library(gmodels)
  library(vcd)       # Cramer's V 등 연관성 분석용
  library(epitools)  # Odds Ratio 신뢰구간 산출용
})

# 1. 예제 데이터 생성 (한의학 체질 구분 및 성별 데이터)
set.seed(123)
n <- 240
gender <- sample(c("남자", "여자"), n, replace = TRUE, prob = c(0.5, 0.5))

# 성별에 따른 체질 할당 확률 (차이가 존재하도록 설계)
prob_male   <- c(0.15, 0.40, 0.20, 0.25)
prob_female <- c(0.35, 0.15, 0.30, 0.20)
levels_const <- c("열소한소", "열소한대", "열대한소", "열대한대")

constitution <- character(n)
for(i in 1:n) {
  if(gender[i] == "남자") {
    constitution[i] <- sample(levels_const, 1, prob = prob_male)
  } else {
    constitution[i] <- sample(levels_const, 1, prob = prob_female)
  }
}

df <- data.frame(
  gender = factor(gender, levels = c("남자", "여자")),
  constitution = factor(constitution, levels = levels_const)
)

# 2. 기초 교차표 생성
tab <- table(df$gender, df$constitution)
cat("=== 1. 기본 분할표 (관측빈도) ===\n")
print(tab)

# 3. 카이제곱 검정 및 기대빈도 조건 점검
chisq_res <- chisq.test(tab)
cat("\n=== 2. 기대빈도(Expected Frequency) 테이블 ===\n")
print(round(chisq_res$expected, 2))

prop_under_5 <- mean(chisq_res$expected < 5)
cat("\n기대빈도 5 미만 셀의 비율:", round(prop_under_5 * 100, 1), "%\n")

# 4. 검정 방식 자동 분기 (대표본 vs 피셔 검정)
if(prop_under_5 > 0.20 || any(chisq_res$expected < 1)) {
  cat("\n[주의] 기대빈도 조건 미충족 -> 피셔의 정확검정(Fisher's Exact Test) 결과:\n")
  print(fisher.test(tab))
} else {
  cat("\n[통과] 대표본 조건 만족 -> 피어슨 카이제곱 검정 결과:\n")
  print(chisq_res)
}

# 5. 사후분석: 수정된 표준잔차(Adjusted Standardized Residuals)
adj_residuals <- chisq_res$stdres
cat("\n=== 3. 수정된 표준잔차(Adjusted Residuals) 매트릭스 ===\n")
print(round(adj_residuals, 3))

cat("\n💡 유의한 차이를 보이는 셀 (|z| > 1.96):\n")
sig_cells <- which(abs(adj_residuals) > 1.96, arr.ind = TRUE)
for(k in 1:nrow(sig_cells)) {
  r_idx <- sig_cells[k, 1]
  c_idx <- sig_cells[k, 2]
  z_val <- adj_residuals[r_idx, c_idx]
  direction <- ifelse(z_val > 0, "유의하게 높음(+)", "유의하게 낮음(-)")
  cat(" -", rownames(adj_residuals)[r_idx], "×", colnames(adj_residuals)[c_idx],
      ": z =", round(z_val, 2), "(", direction, ")\n")
}

# 6. 효과크기(Effect Size) 계산: 크래머의 V
v_val <- assocstats(tab)$cramer
cat("\n=== 4. 연관성 효과크기 (Cramer's V) ===\n")
cat("Cramer's V:", round(v_val, 3), "\n")
if(v_val < 0.15) {
  cat("해석: 두 변수 간의 연관성은 미미함(Small).\n")
} else if(v_val < 0.35) {
  cat("해석: 두 변수 간에 실질적으로 의미 있는 연관성이 존재함(Medium).\n")
} else {
  cat("해석: 두 변수 간에 대단히 강력한 연관성이 존재함(Large).\n")
}

# 7. gmodels CrossTable을 활용한 종합 보고서 출력
cat("\n=== 5. CrossTable 통합 보고서 ===\n")
CrossTable(df$gender, df$constitution,
           expected = TRUE,
           chisq = TRUE,
           asresid = TRUE,
           prop.c = FALSE,
           prop.r = TRUE,
           prop.t = FALSE,
           prop.chisq = FALSE)
8. 실무 체크리스트 및 결론
교차분석은 통계학의 가장 기초적인 기법 중 하나이지만, 올바른 절차를 밟지 않으면 잘못된 의사결정을 초래하기 가장 쉬운 기법이기도 합니다.
┌─────────────────────────────────────────────────────────────┐
│              [ 실무 교차분석 6대 핵심 체크리스트 ]             │
├─────────────────────────────────────────────────────────────┤
│ [ ] 1. 연구 목적이 적합도, 독립성, 동질성 중 어디에 속하는가? │
│ [ ] 2. 기대빈도가 5 미만인 셀이 20%를 초과하지 않는가?        │
│ [ ] 3. 소표본 조건 위배 시 피셔의 정확검정으로 우회했는가?    │
│ [ ] 4. 유의한 결과 시 수정된 표준잔차(|z| > 1.96)를 확인했는가?│
│ [ ] 5. 표본수 과다에 따른 p-값 착시를 크래머 V로 보정했는가? │
│ [ ] 6. 2x2 분할표의 경우 오즈비(OR)와 신뢰구간을 함께 적었는가?│
└─────────────────────────────────────────────────────────────┘
단순히 \(p\)-값 하나만 보고 “유의하다”고 끝내는 보고서와, 수정된 표준잔차로 원인 셀을 밝히고 크래머의 V로 현실적 파급력을 제시하는 보고서는 전문성의 차원이 다릅니다. 이 완벽한 파이프라인을 실무에 바로 적용해 보시기 바랍니다.