flowchart TD
    A["단일 결정트리 (Decision Tree)<br/>'직관적이나 과적합과 분산이 심함'"] --> B{"어떻게 트리를 결합할 것인가?"}
    B -- "병렬 독립 학습 (분산 축소)" --> C["배깅 (Bagging) & 랜덤 포레스트<br/>• 부트스트랩 샘플링 (행 무작위)<br/>• mtry 특성 샘플링 (열 무작위)"]
    B -- "순차 오차 보정 (편향 축소)" --> D["부스팅 (Boosting, GBM, XGBoost)<br/>• 잔차(Residual)에 새로운 트리 적합<br/>• 학습률(Learning Rate) 수축"]
    B -- "이종 모델 결합" --> E["보팅 & 스태킹 (Voting & Stacking)<br/>• 하드 보팅 vs 소프트 보팅<br/>• 가중 평균 (Weighted Averaging)"]

    style A fill:#FEE2E2,stroke:#DC2626,stroke-width:1.5px
    style B fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style C fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style D fill:#DCFCE7,stroke:#16A34A,stroke-width:1.5px
    style E fill:#F3E8FF,stroke:#7C3AED,stroke-width:2px
💡 핵심 요약 (Executive Summary):
- 앙상블(Ensemble)의 통계적 본질: 앙상블 학습은 단일 모델의 한계를 극복하기 위해 다수의 약한 학습기(Weak Learners)를 결합하여 강한 학습기(Strong Learner)를 구축하는 ‘집단지성’ 기법입니다.
- 단일 결정트리의 아킬레스건(고분산): 결정트리(Decision Tree)는 설명력이 우수하고 비선형 관계를 잘 포착하지만, 훈련 데이터가 조금만 바뀌어도 트리 구조가 통째로 바뀌는 극단적인 고분산(High Variance, 과적합) 문제를 안고 있습니다.
- 배깅(Bagging) vs 부스팅(Boosting):
- 배깅(Bootstrap Aggregation): 데이터를 복원 추출하여 여러 트리를 독립적으로 병렬 학습시킨 뒤 평균/투표를 취해 분산(Variance)을 대폭 감쇄시킵니다.
- 부스팅(Boosting): 이전 트리가 틀린 잔차(Residual)와 오답에 가중치를 부여해 순차적으로 직렬 학습함으로써 편향(Bias)을 극소화합니다.
- 랜덤 포레스트의 핵심 비밀 (\(mtry\)): 단순 배깅은 강한 변수가 모든 트리의 루트 노드를 독점하여 트리 간 상관관계(\(\rho\))가 높아지는 맹점이 있습니다. 랜덤 포레스트는 노드 분할마다 무작위로 \(mtry\)개의 특성만 후보로 제한함으로써 트리 간 상관계수를 강제로 떨어뜨려 \(\mathrm{Var}(\text{Ensemble}) = \rho \sigma^2 + \frac{1-\rho}{B}\sigma^2\)의 이론적 분산을 최소화합니다.
- 보팅(Voting)과 가중 평균: 서로 다른 알고리즘(RF, SVM, 로지스틱)을 묶을 때는 단순 다수결인 하드 보팅보다 확률적 확신도를 반영하는 소프트 보팅(Soft Voting) 또는 검증 성능 기반의 가중 평균(Weighted Averaging)이 월등한 일반화 성능을 제공합니다.
0. “세 명의 평범한 목수가 모여 제갈량을 이긴다”
머신러닝 대회(Kaggle)의 리더보드 상위권을 독식하는 솔루션들의 공통점은 무엇일까요? 단 하나의 초거대 모델이 아니라, 서로 다른 알고리즘 수십 개를 정교하게 엮어낸 앙상블 모델(Ensemble Model)이라는 점입니다.
서로 다른 관점과 실수를 저지르는 여러 학습기들을 모아 다수결 투표를 하거나 평균을 내면, 개별 모델의 편향과 잡음은 서로 상쇄되고 데이터 이면의 공통된 진실만이 증폭됩니다.
이번 글에서는 앙상블 학습을 지탱하는 편향-분산 트레이드오프의 수학적 원리부터, 배깅과 랜덤 포레스트의 2중 무작위성, 부스팅의 잔차 학습 메커니즘, 그리고 R caret 패키지를 활용한 실전 튜닝 및 보팅 파이프라인까지 한 번에 정리합니다.
1. 편향-분산 트레이드오프(Bias-Variance Tradeoff)의 수학
어떤 머신러닝 모델의 일반화 예측 오차(Expected Prediction Error)는 수학적으로 다음과 같이 3개의 독립적인 성분으로 정확히 분해됩니다.
\[\mathbb{E}\left[ (y - \hat{f}(\mathbf{x}))^2 \right] = \underbrace{\left( \mathbb{E}[\hat{f}(\mathbf{x})] - f(\mathbf{x}) \right)^2}_{\text{편향 제곱 (Bias}^2\text{)}} + \underbrace{\mathbb{E}\left[ (\hat{f}(\mathbf{x}) - \mathbb{E}[\hat{f}(\mathbf{x})])^2 \right]}_{\text{분산 (Variance)}} + \underbrace{\sigma^2}_{\text{환원 불가능한 오차}}\]
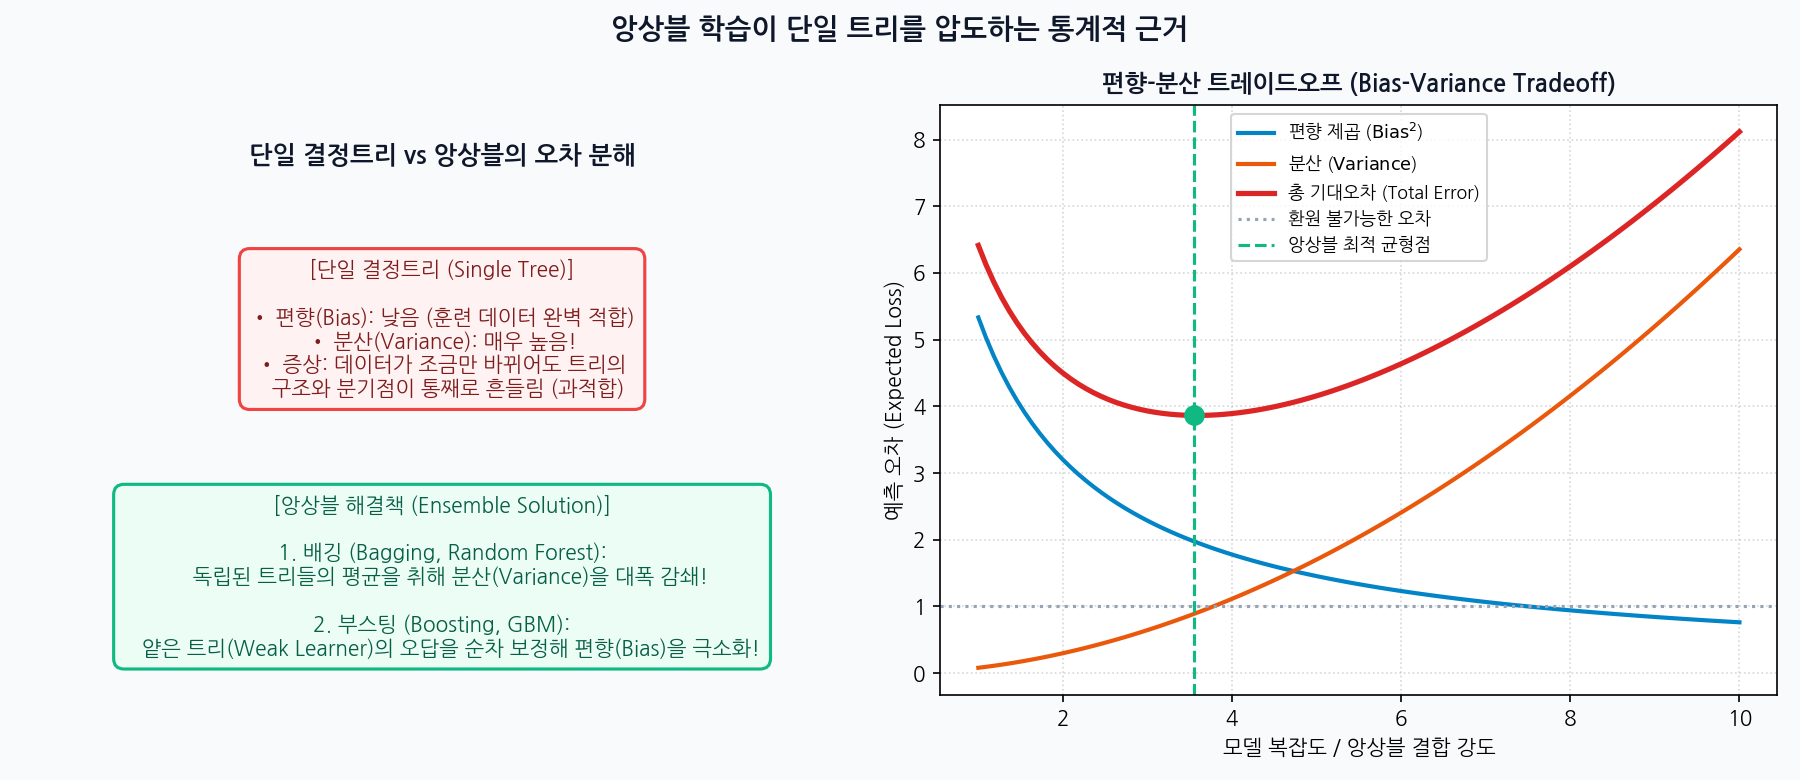
- 편향(Bias): 모델이 복잡한 현실 세계를 너무 단순화하여 발생하는 오차입니다. 편향이 높으면 과소적합(Underfitting)이 발생합니다.
- 분산(Variance): 훈련 데이터의 작은 변동(노이즈)에 모델이 얼마나 민감하게 요동치는가를 나타냅니다. 분산이 높으면 과적합(Overfitting)이 발생합니다.
단일 결정트리(Decision Tree)의 딜레마
- 가지치기(Pruning)를 하지 않은 깊은 결정트리는 훈련 데이터를 100% 암기하므로 편향은 극도로 낮지만, 분산이 통제 불능으로 높습니다.
- 훈련 데이터에서 몇 개의 행만 바뀌어도 루트 노드부터 분기 기준이 완전히 뒤바뀌는 불안정성을 가집니다.
- 배깅(Bagging)은 이 낮은 편향을 유지한 채 분산만을 기적적으로 깎아내는 수학적 해법입니다.
- 반대로 깊이가 1~3에 불과한 얕은 트리(Decision Stump)는 분산은 매우 낮지만 편향이 큽니다. 부스팅(Boosting)은 이 얕은 트리들을 연결하여 편향을 단계적으로 깎아내는 해법입니다.
2. 배깅(Bagging)과 부스팅(Boosting): 아키텍처 완전 비교
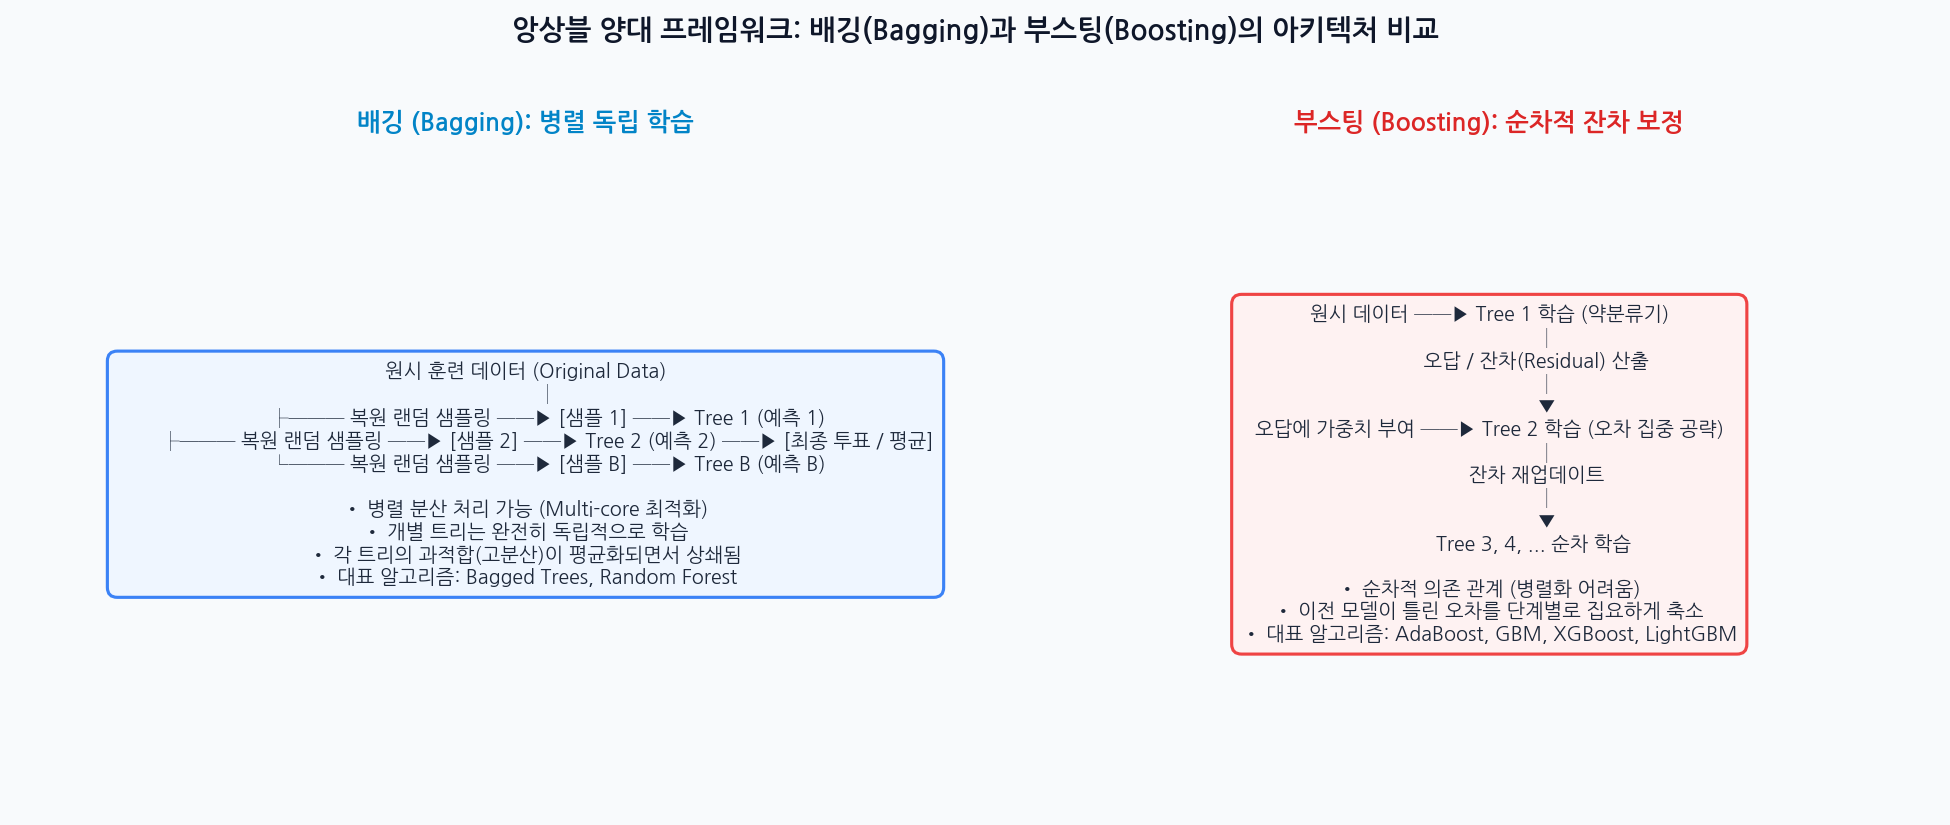
| 비교 항목 | 배깅 (Bagging: Bootstrap Aggregation) | 부스팅 (Boosting: Gradient Boosting / AdaBoost) |
|---|---|---|
| 학습 방식 | 병렬 독립 학습 (Parallel & Independent) | 순차적 직렬 학습 (Sequential & Dependent) |
| 핵심 메커니즘 | 원본 데이터에서 복원 추출(Bootstrap)하여 각각 학습 | 이전 모델의 잔차(Residual)와 오답에 가중치 집중 |
| 주요 오차 개선 | 분산(Variance) 감소 (과적합 완화) | 편향(Bias) 감소 (정확도 극대화) |
| 베이스 모델 | 충분히 깊고 복잡한 고분산 트리 (Fully grown trees) | 깊이가 얕고 단순한 약학습기 (Weak learners, depth 2~6) |
| 과적합 위험 | 트리를 아무리 많이 늘려도 과적합되지 않음 | 트리가 너무 많아지면 노이즈를 암기하여 과적합 위험 |
| 대표 알고리즘 | Bagged Trees (treebag), Random Forest (rf) |
AdaBoost, GBM, XGBoost, LightGBM, CatBoost |
3. 랜덤 포레스트(Random Forest): 2중 무작위성의 완성
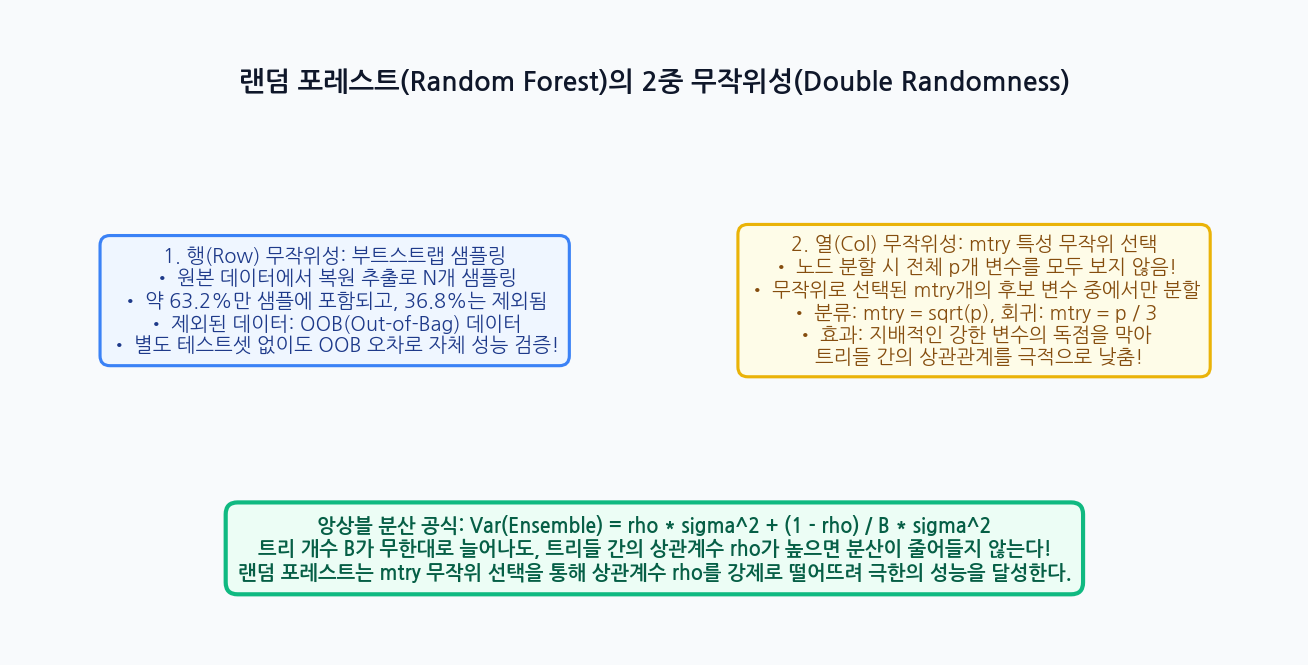
단순 배깅에도 맹점이 하나 있습니다. 만약 데이터셋에 종속변수와 매우 강력한 상관관계를 가진 ’슈퍼 변수’가 하나 존재한다면, 부트스트랩으로 뽑힌 모든 서브 트리들이 첫 번째 분기(Root Node)에서 그 슈퍼 변수를 똑같이 선택하게 됩니다. 결과적으로 수백 개의 트리들이 서로 매우 비슷해져서 트리들 간의 상관관계(\(\rho\))가 치솟게 됩니다.
3-1. 앙상블 분산의 불변 법칙
각각 분산 \(\sigma^2\)을 가지고 상호 상관계수 \(\rho\)를 갖는 \(B\)개의 단일 트리들을 평균 냈을 때의 앙상블 전체 분산은 다음과 같습니다.
\[\boxed{\mathrm{Var}(\bar{T}) = \rho \sigma^2 + \frac{1 - \rho}{B} \sigma^2}\]
- 트리 개수 \(B\)를 \(1,000\)개, \(10,000\)개로 무한히 늘리면 뒷부분 \(\frac{1-\rho}{B}\sigma^2\)은 \(0\)으로 사라집니다.
- 하지만 앞부분 \(\rho \sigma^2\)은 영원히 사라지지 않고 바닥에 남습니다!
- 트리들끼리 비슷하게 생겼다면(\(\rho \to 1\)), 트리를 10만 개 만들어도 앙상블의 분산은 단일 트리의 분산(\(\sigma^2\))과 다를 바가 없어집니다.
3-2. \(mtry\)의 혁신: 강제적 다양성 확보
랜덤 포레스트의 창시자 레오 브라이먼(Leo Breiman)은 천재적인 해법을 고안했습니다. 트리의 매 분기 노드마다 전체 \(p\)개의 변수를 모두 후보로 올리지 않고, 무작위로 \(mtry\)개의 변수만 제비뽑기하여 그 안에서만 최적의 분할을 찾도록 강제한 것입니다.
- 분류(Classification): \(mtry = \lfloor \sqrt{p} \rfloor\) (기본 권장값)
- 회귀(Regression): \(mtry = \lfloor p / 3 \rfloor\) (기본 권장값)
이렇게 하면 슈퍼 변수가 제비뽑기에서 탈락하는 트리가 대거 생성되면서, 다른 2등, 3등 변수들이 루트 노드로 활약할 기회를 얻게 됩니다. 결과적으로 트리들 간의 형태가 완전히 달라져 상관계수 \(\rho\)가 바닥으로 떨어지며, 앙상블의 분산이 극적으로 줄어듭니다.
3-3. OOB(Out-of-Bag) 데이터: 무료 검증 세트
크기 \(N\)인 원본 데이터에서 복원 추출로 \(N\)개를 뽑을 때, 특정 관측치가 한 번도 선택되지 않을 확률은 다음과 같습니다.
\[\lim_{N \to \infty} \left( 1 - \frac{1}{N} \right)^N = \frac{1}{e} \approx 0.368 \quad (36.8\%)\]
즉, 각 트리가 만들어질 때 전체 데이터의 약 \(36.8\%\)는 학습에 전혀 쓰이지 않고 남겨집니다. 이를 OOB(Out-of-Bag) 데이터라고 부릅니다. 랜덤 포레스트는 별도의 \(k\)-겹 교차 검증(CV)을 돌리지 않아도, 각 관측치가 OOB로 제외되었던 트리들의 예측치만 모아서 계산한 OOB 오차(OOB Error Rate)를 통해 모델의 일반화 성능을 즉시 비편향적으로 검증할 수 있습니다.
4. 모델 결합 전략: 하드 보팅 vs 소프트 보팅 vs 가중 평균
서로 다른 메커니즘을 가진 이종 모델들(예: 랜덤 포레스트, 서포트 벡터 머신, 로지스틱 회귀)을 최종 융합할 때 사용하는 대표적 기법들입니다.
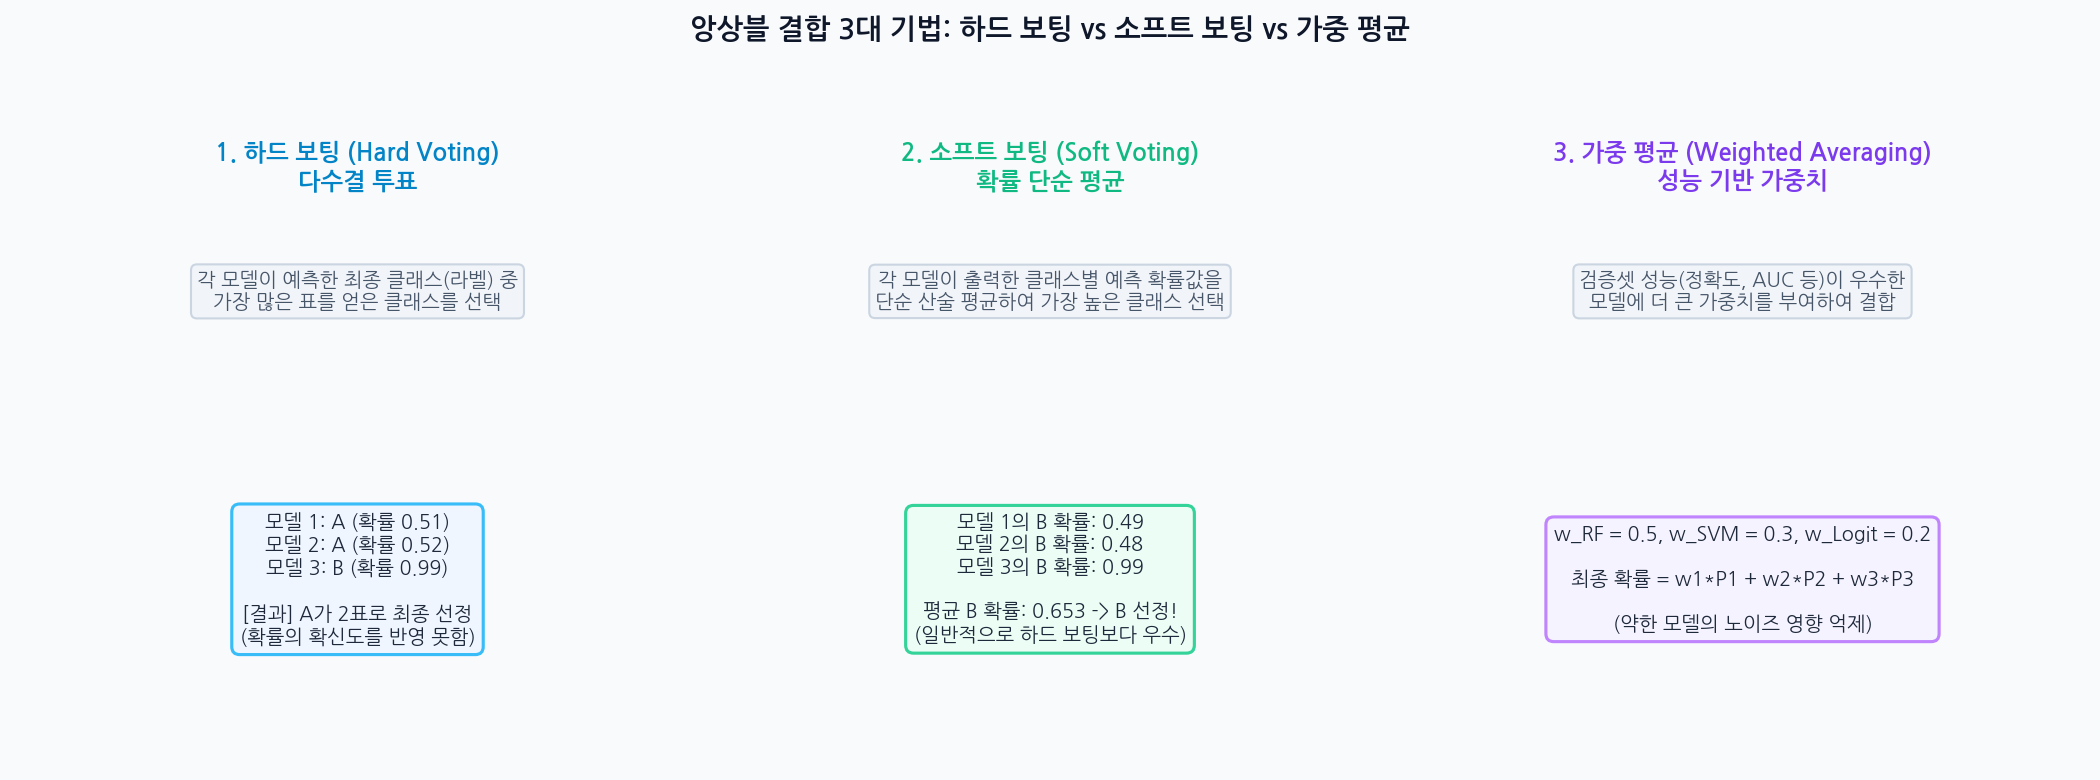
- 하드 보팅 (Hard Voting): 각 모델이 뱉어낸 최종 클래스 라벨(\(0\) 또는 \(1\))을 모아 가장 많은 표를 받은 클래스를 채택합니다. 단순하지만 모델이 얼마나 확신을 갖고 예측했는지(확률의 크기)를 반영하지 못하는 단점이 있습니다.
- 소프트 보팅 (Soft Voting): 각 모델이 산출한 클래스별 소속 확률을 단순 산술 평균하여 가장 높은 확률의 클래스를 선택합니다. 일반적으로 하드 보팅보다 훨씬 뛰어난 성능을 보입니다.
- 가중 평균 (Weighted Averaging): 교차 검증 성능(정확도 또는 AUC)이 더 우수한 모델에 더 큰 가중치(\(w_m\))를 부여하여 선형 결합합니다. 성능이 떨어지는 모델의 헛발질(Noise)을 억제할 수 있습니다.
\[\hat{P}(Y=c) = \sum_{m=1}^M w_m P_m(Y=c) \quad \left( \sum w_m = 1 \right)\]
5. 실전 R 실습: caret 패키지로 구축하는 대출 승인 예측 앙상블 파이프라인
Universal Bank 고객 대출 승인 가상 데이터를 활용하여 전처리(recipes), 단일 결정트리(rpart), 배깅(treebag), 랜덤 포레스트(rf), 부스팅(gbm), 그리고 사용자 정의 가중 소프트 보팅(Weighted Voting) 앙상블까지 한 번에 구현하는 실전 풀코드입니다.
#######################################################
# 앙상블 학습(Ensemble Learning) 실전 완전 정복 파이프라인
#######################################################

suppressPackageStartupMessages({
  library(tidyverse)
  library(caret)
  library(recipes)
  library(rpart)
  library(randomForest)
  library(gbm)
})

# 1. 예제 데이터 생성 (개인 대출 승인 가상 데이터셋)
set.seed(123)
n <- 1500
age <- round(runif(n, 23, 65))
income <- round(rnorm(n, mean = 75, sd = 35))
income <- pmax(15, income) # 최소 소득 보정
experience <- pmax(0, age - 22 + round(rnorm(n, 0, 2)))
family <- sample(1:4, n, replace = TRUE)
cc_avg <- round(abs(rnorm(n, 2.0, 1.5)), 1)
education <- sample(c("Undergrad", "Graduate", "Professional"), n, replace = TRUE)

# 대출 승인 여부(Personal.Loan) 생성
logit_p <- -5.5 + 0.05 * income + 0.3 * cc_avg + 0.8 * (education == "Professional") + 0.2 * family
true_prob <- 1 / (1 + exp(-logit_p))
loan <- factor(ifelse(runif(n) < true_prob, "Yes", "No"), levels = c("No", "Yes"))

bank_df <- data.frame(
  Age = age,
  Experience = experience,
  Income = income,
  Family = factor(family),
  CCAvg = cc_avg,
  Education = factor(education),
  Personal.Loan = loan
)

cat("=== 1. 데이터셋 요약 및 클래스 비율 ===\n")
print(table(bank_df$Personal.Loan))

# 2. 훈련 및 테스트 데이터 분할 (Train 70% : Test 30%)
train_idx <- createDataPartition(bank_df$Personal.Loan, p = 0.7, list = FALSE)
train_raw <- bank_df[train_idx, ]
test_raw  <- bank_df[-train_idx, ]

# 3. 데이터 전처리 파이프라인 (recipes)
bank_recipe <- recipe(Personal.Loan ~ ., data = train_raw) %>%
  step_dummy(all_nominal_predictors()) %>%
  step_zv(all_predictors()) %>%
  prep()

train_df <- juice(bank_recipe)
test_df  <- bake(bank_recipe, new_data = test_raw)

# 4. 공통 5-Fold 교차 검증 제어 설정 (확률값 산출 및 ROC 기준)
cv_ctrl <- trainControl(
  method = "cv",
  number = 5,
  classProbs = TRUE,
  summaryFunction = twoClassSummary,
  savePredictions = "final"
)

# ----------------------------------------------------
# 5. 모델 1: 단일 결정트리 (Decision Tree: rpart)
# ----------------------------------------------------
cat("\n=== [모델 1] 단일 결정트리(rpart) 학습 중... ===\n")
fit_tree <- train(
  Personal.Loan ~ ., data = train_df,
  method = "rpart",
  metric = "ROC",
  trControl = cv_ctrl,
  tuneLength = 5
)

# ----------------------------------------------------
# 6. 모델 2: 배깅 (Bagged Trees: treebag)
# ----------------------------------------------------
cat("=== [모델 2] 배깅(treebag) 학습 중... ===\n")
fit_bag <- train(
  Personal.Loan ~ ., data = train_df,
  method = "treebag",
  metric = "ROC",
  trControl = cv_ctrl,
  nbagg = 50
)

# ----------------------------------------------------
# 7. 모델 3: 랜덤 포레스트 (Random Forest: rf)
# ----------------------------------------------------
cat("=== [모델 3] 랜덤 포레스트(rf) 학습 중... ===\n")
rf_grid <- expand.grid(mtry = c(2, 3, 4, 5))
fit_rf <- train(
  Personal.Loan ~ ., data = train_df,
  method = "rf",
  metric = "ROC",
  trControl = cv_ctrl,
  tuneGrid = rf_grid,
  ntree = 200
)

# ----------------------------------------------------
# 8. 모델 4: 부스팅 (Gradient Boosting: gbm)
# ----------------------------------------------------
cat("=== [모델 4] 부스팅(gbm) 학습 중... ===\n")
fit_gbm <- train(
  Personal.Loan ~ ., data = train_df,
  method = "gbm",
  metric = "ROC",
  trControl = cv_ctrl,
  verbose = FALSE,
  tuneGrid = expand.grid(
    n.trees = c(100, 200),
    interaction.depth = c(2, 4),
    shrinkage = c(0.05, 0.1),
    n.minobsinnode = 10
  )
)

# ----------------------------------------------------
# 9. 테스트 데이터셋 예측 확률 추출
# ----------------------------------------------------
prob_tree <- predict(fit_tree, newdata = test_df, type = "prob")[, "Yes"]
prob_bag  <- predict(fit_bag,  newdata = test_df, type = "prob")[, "Yes"]
prob_rf   <- predict(fit_rf,   newdata = test_df, type = "prob")[, "Yes"]
prob_gbm  <- predict(fit_gbm,  newdata = test_df, type = "prob")[, "Yes"]

# ----------------------------------------------------
# 10. 앙상블 결합: 가중 소프트 보팅 (Weighted Soft Voting)
# ----------------------------------------------------
# 교차 검증 ROC 점수에 비례하여 가중치 배분
roc_tree <- max(fit_tree$results$ROC)
roc_bag  <- max(fit_bag$results$ROC)
roc_rf   <- max(fit_rf$results$ROC)
roc_gbm  <- max(fit_gbm$results$ROC)

weights <- c(roc_tree, roc_bag, roc_rf, roc_gbm)
weights <- weights / sum(weights)
cat("\n=== 모델별 앙상블 가중치 ===\n")
names(weights) <- c("Tree", "Bagging", "RF", "GBM")
print(round(weights, 3))

prob_ensemble <- weights["Tree"] * prob_tree +
                 weights["Bagging"] * prob_bag +
                 weights["RF"] * prob_rf +
                 weights["GBM"] * prob_gbm

# ----------------------------------------------------
# 11. 최종 성능 비교 (Test Set F1-Score & Accuracy)
# ----------------------------------------------------
eval_model <- function(probs, actual, threshold = 0.5) {
  preds <- factor(ifelse(probs > threshold, "Yes", "No"), levels = c("No", "Yes"))
  cm <- confusionMatrix(preds, actual, positive = "Yes")
  return(c(
    Accuracy = cm$overall["Accuracy"],
    Sensitivity = cm$byClass["Sensitivity"],
    Precision = cm$byClass["Precision"],
    F1 = cm$byClass["F1"]
  ))
}

results_summary <- rbind(
  Decision_Tree = eval_model(prob_tree, test_df$Personal.Loan),
  Bagging       = eval_model(prob_bag,  test_df$Personal.Loan),
  Random_Forest = eval_model(prob_rf,   test_df$Personal.Loan),
  GBM_Boosting  = eval_model(prob_gbm,  test_df$Personal.Loan),
  Weighted_Ens  = eval_model(prob_ensemble, test_df$Personal.Loan)
)

cat("\n=== 최종 테스트셋 모델 성능 평가 표 ===\n")
print(round(results_summary, 4))
6. 실무 체크리스트 및 결론
앙상블 학습은 현대 머신러닝 실무에서 성능을 한 단계 도약시키는 가장 확실한 무기입니다.
┌─────────────────────────────────────────────────────────────┐
│              [ 실무 앙상블 모델링 6대 핵심 체크리스트 ]        │
├─────────────────────────────────────────────────────────────┤
│ [ ] 1. 데이터의 문제가 고분산(과적합)인가 고편향(과소적합)인가? │
│ [ ] 2. 랜덤 포레스트의 mtry 튜닝으로 트리 간 상관성을 낮췄는가?│
│ [ ] 3. 부스팅 적용 시 학습률(shrinkage)과 트리 수를 함께 튜닝했는가?│
│ [ ] 4. OOB 오차를 점검하여 별도 검증 없이 자체 과적합을 확인했는가?│
│ [ ] 5. 이종 모델 결합 시 하드 보팅 대신 소프트 보팅을 사용했는가?│
│ [ ] 6. 변수 중요도(varImp)를 통해 모델의 예측 근거를 해석했는가?│
└─────────────────────────────────────────────────────────────┘
하나의 완벽한 모델을 찾으려고 애쓰지 마십시오. 각자의 장단점을 가진 여러 모델들의 약점을 보완하고 장점을 결합하는 앙상블의 지혜야말로, 복잡한 실무 데이터 환경에서 가장 견고하고 흔들리지 않는 예측력을 만들어내는 비결입니다.