flowchart TD
    A["데이터 수집 및 EDA<br/>(상관행렬, 산점도 행렬)"] --> B["OLS 회귀식 적합<br/>lm(y ~ x1 + x2 + ...)"]
    B --> C{"4대 잔차 가정 검정<br/>(선형성·정규성·등분산성·독립성)"}
    C -- "가정 불만족" --> D["처방 및 교정<br/>(변수변환, 가중회귀, 차분)"]
    D --> B
    C -- "가정 충족" --> E{"다중공선성 & 영향점 검토<br/>(VIF, Cook's Distance)"}
    E -- "공선성/영향점 발견" --> F["로버스트 회귀 / 규제 회귀<br/>(Ridge, Lasso, lmrob)"]
    E -- "이상 없음" --> G["최적 변수 선택 & 최종 모델 확정<br/>(Stepwise, AIC/BIC, Cross-Validation)"]

    style A fill:#F1F5F9,stroke:#64748B,stroke-width:1.5px
    style B fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style C fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style D fill:#FEE2E2,stroke:#DC2626,stroke-width:1.5px
    style E fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style F fill:#FEE2E2,stroke:#DC2626,stroke-width:1.5px
    style G fill:#DCFCE7,stroke:#16A34A,stroke-width:2px
💡 핵심 요약 (Executive Summary):
- OLS의 수학적 본질: 최소자승법(Ordinary Least Squares, OLS)은 관측 벡터 \(\mathbf{y}\)를 설명변수 행렬 \(\mathbf{X}\)의 열공간(Column Space)에 직교 투영(Orthogonal Projection)하여 잔차 제곱합(\(\sum e_i^2\))을 최소화하는 기하학적 최적화 과정입니다. 정규방정식을 통해 유도되는 닫힌 형태의 해는 \(\mathbf{\hat{\beta}} = (\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T\mathbf{y}\)입니다.
- 가우스-마르코프 정리와 BLUE: 오차항의 평균이 0이고, 등분산이며, 서로 무상관이라는 조건이 충족될 때 OLS 추정량은 최량선형불편추정량(Best Linear Unbiased Estimator, BLUE)이 됩니다.
- 4대 잔차 가정 진단은 선택이 아닌 필수: \(p\)-값이나 \(R^2\)가 아무리 높아도 선형성(Linearity), 정규성(Normality), 등분산성(Homoscedasticity), 독립성(Independence) 중 단 하나라도 깨지면 가설검정과 신뢰구간 추정은 즉시 무효화됩니다.
- 다중공선성(Multicollinearity)의 파괴력: 설명변수 간 상관관계가 높으면 \(\mathbf{X}^T\mathbf{X}\)의 행렬식이 0에 수렴하여 표준오차가 폭발적으로 증가합니다. \(\mathrm{VIF} > 10\)인 변수는 반드시 변수 제거, PCA 결합, 또는 Ridge/Lasso 같은 규제 회귀로 처치해야 합니다.
- 이상치 vs 지렛대점 vs 영향점: 잔차가 큰 관측치(이상치)와 \(X\)값이 극단적인 관측치(지렛대점)는 그 자체로 문제가 되지 않지만, 두 조건이 결합하여 회귀직선을 통째로 비틀어버리는 영향점(Influential Point, Cook’s \(D > 4/(n-k-1)\))은 모형의 해석을 완전히 왜곡하므로 로버스트 회귀(
lmrob) 등을 통한 엄격한 진단이 요구됩니다.
0. “R²가 0.85니까 좋은 모델이다?” — 데이터 분석가가 저지르는 가장 흔한 착각
데이터 분석을 처음 접할 때 누구나 summary(lm(y ~ x, data))를 실행하고 가장 먼저 찾는 숫자가 있습니다. 바로 결정계수 \(R^2\)와 변수의 \(p\)-값(유의확률)입니다.
“설명력이 85%나 되고, 모든 변수가 별 3개(***)로 유의하니까 완벽한 모델이네요!”
실무와 학술 연구에서 가장 위험한 순간이 바로 이때입니다. 비선형 곡선 관계를 억지로 직선으로 맞추거나, 데이터 속에 극단적인 이상치(Outlier) 하나가 전체 기울기를 지배하고 있거나, 오차항끼리 강하게 얽혀 있는 시계열 데이터라면 \(R^2\)는 아무런 의미가 없는 허상에 불과합니다.
회귀분석은 단순한 ’직선 긋기’가 아닙니다. 모형이 가정한 오차 구조가 실제 모집단 생성 과정과 부합하는가를 집요하게 검증하고 교정하는 과학적 진단 과정입니다. 이번 글에서는 OLS의 수학적 뼈대부터, 회귀모형의 생사를 결정짓는 4대 가정 검정, 다중공선성, 영향점 탐색, 그리고 이상치에 흔들리지 않는 로버스트 회귀까지 실전 R 코드와 함께 완벽하게 해체해 보겠습니다.
1. OLS(최소자승법)의 수학적 본질: 기하학적 직교 투영
1-1. 잔차 제곱합(SSE)의 최소화
단순 선형 회귀모형은 다음과 같이 정의됩니다.
\[y_i = \beta_0 + \beta_1 x_i + \epsilon_i \quad (i = 1, \dots, n)\]
여기서 \(\epsilon_i\)는 관측할 수 없는 모수 오차(True Error)이며, 표본에서 추정된 회귀직선 \(\hat{y}_i = \hat{\beta}_0 + \hat{\beta}_1 x_i\)과의 차이를 잔차(Residual, \(e_i\))라고 부릅니다.
\[e_i = y_i - \hat{y}_i = y_i - (\hat{\beta}_0 + \hat{\beta}_1 x_i)\]
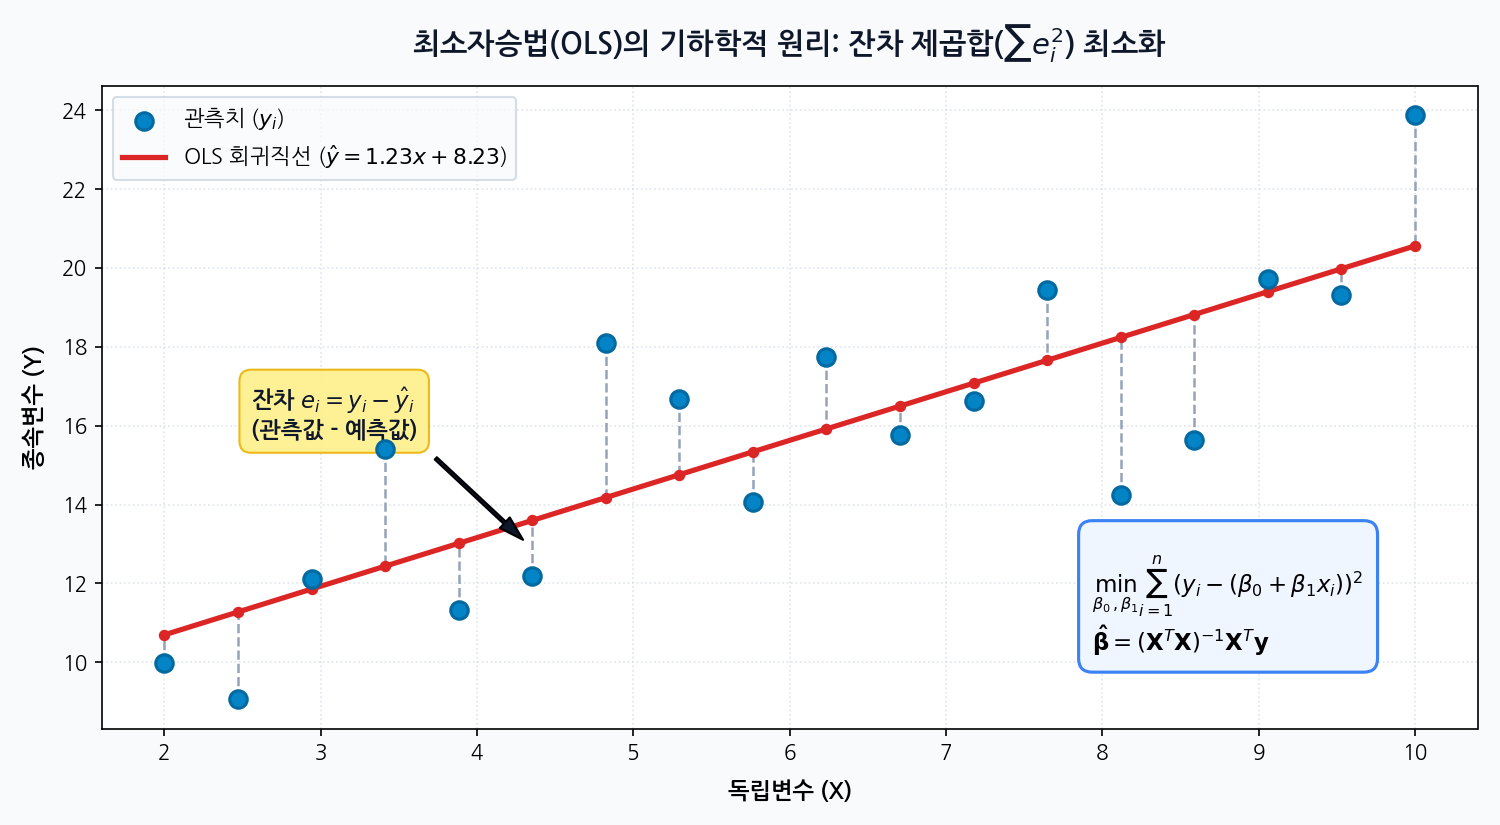
왜 우리는 잔차의 단순 합(\(\sum e_i\))이나 절댓값의 합(\(\sum |e_i|\)) 대신 제곱합(\(\sum e_i^2\))을 최소화할까요? 1. 부호 상쇄 방지: 잔차의 단순 합은 양수 오차와 음수 오차가 상쇄되어 최적선을 찾을 수 없습니다. (실제로 OLS 잔차의 산술합은 정확히 0입니다.) 2. 미분 가능성과 닫힌 해(Closed-form solution): 절댓값 함수(\(|x|\))는 원점에서 미분이 불가능하여 수치적 최적화가 복잡하지만, 제곱 함수는 2차 다항식이므로 편미분을 통해 단 한 번에 전역 최솟값(Global Minimum)을 해석적으로 계산할 수 있습니다. 3. 큰 오차에 대한 가중 페널티: 제곱을 취함으로써 회귀선에서 크게 벗어난 이상치에 기하급수적인 벌점을 부과하여 전반적인 편차를 고르게 줄입니다.
1-2. 행렬 표현과 정규방정식(Normal Equation)
설명변수가 \(p\)개인 다중 회귀분석에서는 수식이 복잡해지므로 행렬 표기법을 사용합니다.
\[\mathbf{y} = \mathbf{X}\boldsymbol{\beta} + \boldsymbol{\epsilon}\]
- \(\mathbf{y} \in \mathbb{R}^{n \times 1}\): 종속변수 벡터
- \(\mathbf{X} \in \mathbb{R}^{n \times (p+1)}\): 절편항(1로 구성된 열)을 포함한 설명변수 설계 행렬(Design Matrix)
- \(\boldsymbol{\beta} \in \mathbb{R}^{(p+1) \times 1}\): 추정해야 할 회귀계수 벡터
- \(\boldsymbol{\epsilon} \in \mathbb{R}^{n \times 1}\): 오차항 벡터
잔차 제곱합 함수 \(S(\boldsymbol{\beta})\)는 다음과 같습니다.
\[S(\boldsymbol{\beta}) = \mathbf{e}^T\mathbf{e} = (\mathbf{y} - \mathbf{X}\boldsymbol{\beta})^T(\mathbf{y} - \mathbf{X}\boldsymbol{\beta}) = \mathbf{y}^T\mathbf{y} - 2\boldsymbol{\beta}^T\mathbf{X}^T\mathbf{y} + \boldsymbol{\beta}^T\mathbf{X}^T\mathbf{X}\boldsymbol{\beta}\]
이 함수를 \(\boldsymbol{\beta}\)에 대해 편미분하여 0으로 놓으면 그 유명한 정규방정식(Normal Equation)이 도출됩니다.
\[\frac{\partial S}{\partial \boldsymbol{\beta}} = -2\mathbf{X}^T\mathbf{y} + 2\mathbf{X}^T\mathbf{X}\boldsymbol{\beta} = \mathbf{0}\]
\[\boxed{\mathbf{X}^T\mathbf{X}\boldsymbol{\hat{\beta}} = \mathbf{X}^T\mathbf{y}}\]
행렬 \(\mathbf{X}^T\mathbf{X}\)의 역행렬이 존재한다면(즉, 설명변수 간에 완전한 선형 종속이 없다면), 회귀계수 추정량 \(\boldsymbol{\hat{\beta}}\)은 유일하게 결정됩니다.
\[\boldsymbol{\hat{\beta}} = (\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T\mathbf{y}\]
📌 기하학적 직관: 직교 투영(Orthogonal Projection)
예측값 벡터 \(\mathbf{\hat{y}} = \mathbf{X}\boldsymbol{\hat{\beta}} = \mathbf{X}(\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T\mathbf{y} = \mathbf{H}\mathbf{y}\)에서 행렬 \(\mathbf{H}\)를 모자 행렬(Hat Matrix) 또는 투영 행렬(Projection Matrix)이라 부릅니다. OLS는 \(n\)차원 공간에 존재하는 관측 벡터 \(\mathbf{y}\)를 설명변수들이 이루는 부분공간(Column Space of \(\mathbf{X}\)) 위로 수직(직교) 투영하는 작업입니다. 따라서 잔차 벡터 \(\mathbf{e} = \mathbf{y} - \mathbf{\hat{y}}\)는 설명변수 평면과 완벽하게 수직(\(\mathbf{X}^T\mathbf{e} = \mathbf{0}\))을 이룹니다.
1-3. 가우스-마르코프 정리와 BLUE
통계학자들이 왜 OLS를 그토록 신뢰할까요? 바로 가우스-마르코프 정리(Gauss-Markov Theorem) 때문입니다.
다음 세 가지 기본 가정이 충족되면: 1. 오차의 기댓값은 0이다: \(\mathbb{E}(\boldsymbol{\epsilon} \mid \mathbf{X}) = \mathbf{0}\) 2. 등분산성(Homoscedasticity): \(\mathrm{Var}(\epsilon_i \mid \mathbf{X}) = \sigma^2\) (모든 관측치의 오차 분산이 동일) 3. 오차의 무상관성(No Autocorrelation): \(\mathrm{Cov}(\epsilon_i, \epsilon_j \mid \mathbf{X}) = 0 \quad (i \neq j)\)
\[\mathrm{Var}(\boldsymbol{\epsilon} \mid \mathbf{X}) = \sigma^2 \mathbf{I}_n\]
이 조건 하에서 OLS 추정량 \(\boldsymbol{\hat{\beta}}\)은 모든 선형 불편추정량(Linear Unbiased Estimator) 중에서 분산이 가장 작은 최적의 추정량(BLUE: Best Linear Unbiased Estimator)이 됩니다. 주의할 점은 가우스-마르코프 정리가 성립하기 위해 오차항의 정규분포 가정이 필요하지 않다는 사실입니다. 정규분포 가정은 \(t\)-검정이나 \(F\)-검정 같은 가설검정과 신뢰구간을 계산할 때 필요합니다.
2. 회귀분석 4대 잔차 가정: 위배 시 증상과 진단법
OLS 모델을 구축한 후 반드시 통과해야 하는 4대 관문입니다. R에서 plot(model)을 실행하면 출력되는 4개의 그래프가 바로 이 가정들을 검증하기 위한 도구입니다.
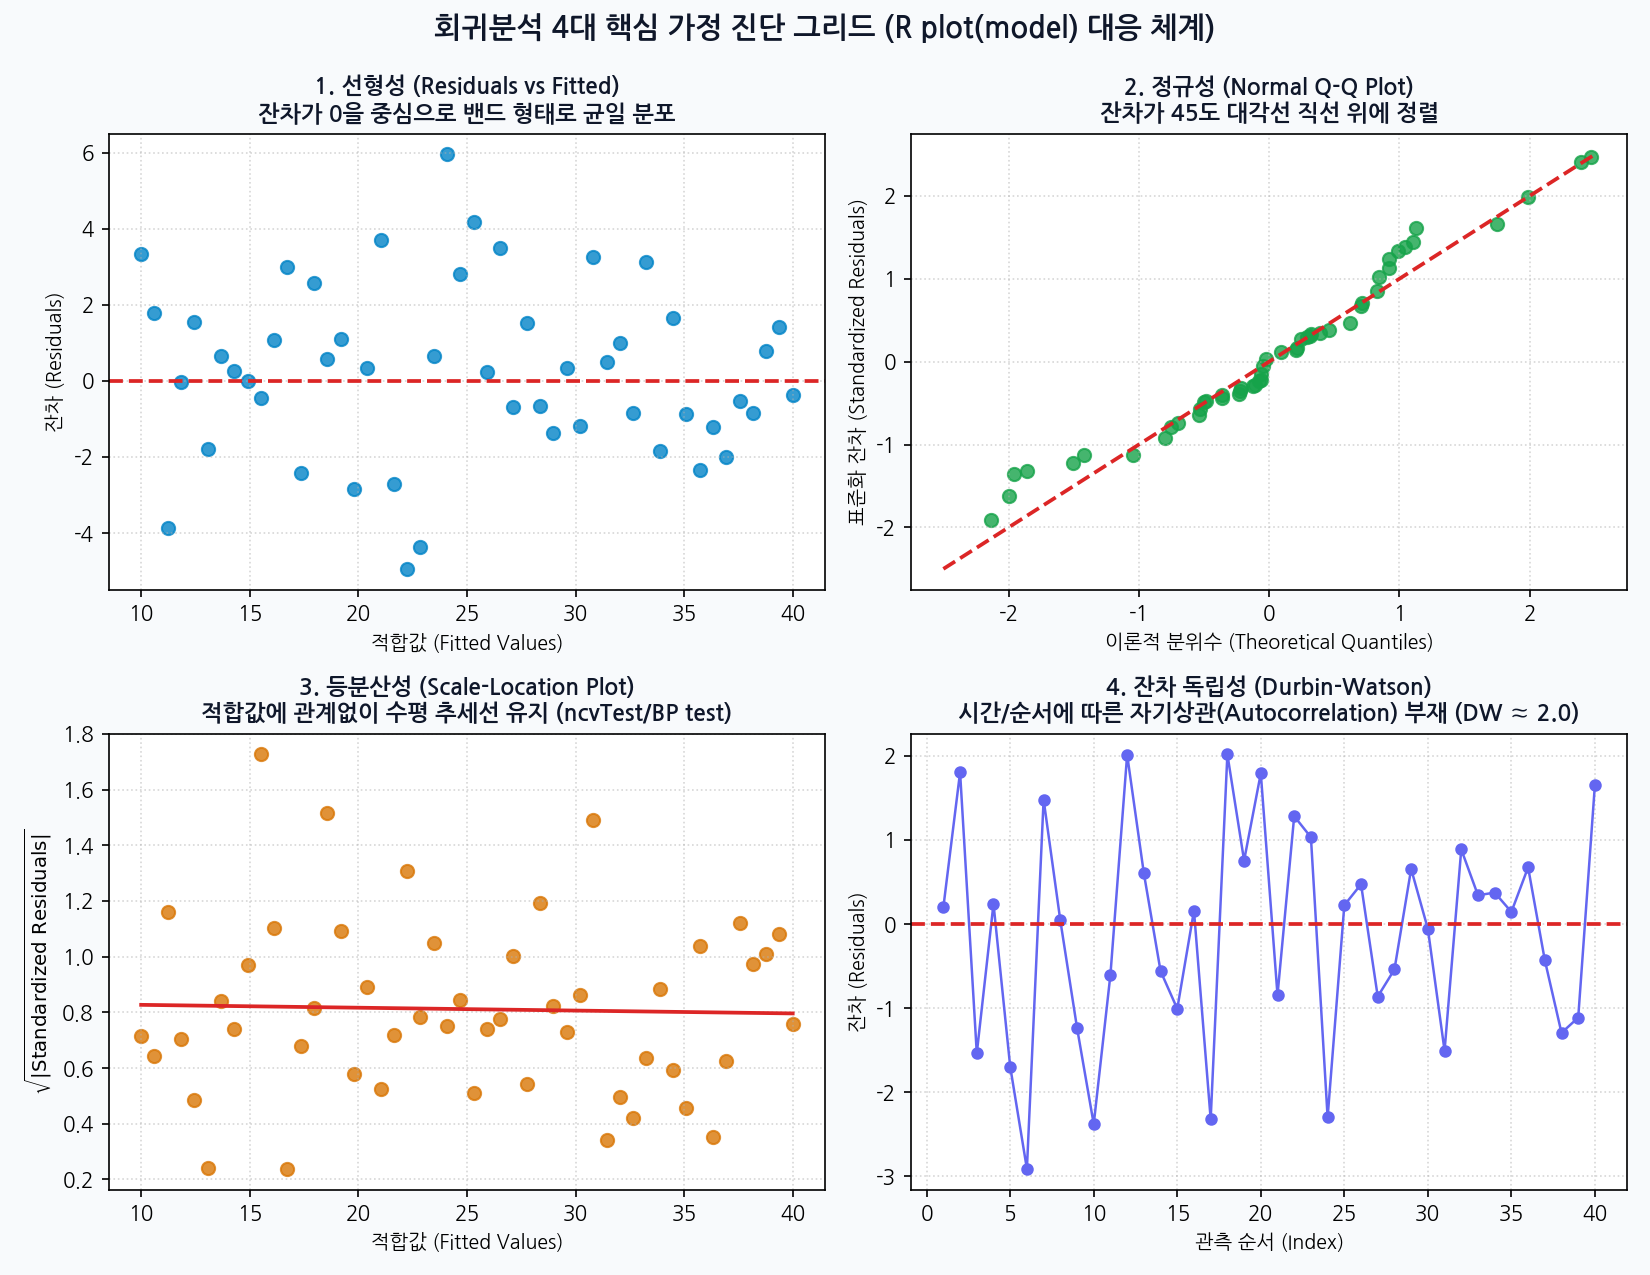
2-1. 4대 가정 종합 비교표
| 가정 | 통계적 의미 | 위배 시 발생하는 문제 | 시각적 진단 도구 | 통계적 수치 검정 | 처방 및 해결책 |
|---|---|---|---|---|---|
| 1. 선형성 (Linearity) |
\(Y\)와 \(X\)의 관계가 선형 형태를 만족해야 함 | 회귀계수 추정량 자체가 편향(Biased)됨 | Residuals vs Fitted (0선 중심 밴드 여부) |
car::residualPlots()(Curvature test \(p < .05\)) |
다항회귀(\(X^2\)), 로그/루트 변환, 스플라인(GAM) |
| 2. 정규성 (Normality) |
오차항 \(\epsilon\)이 정규분포 \(\mathcal{N}(0, \sigma^2)\)를 따라야 함 | \(t\)-검정, \(F\)-검정 \(p\)-값 왜곡, 신뢰구간 신뢰도 저하 | Normal Q-Q Plot (대각 점선 정렬 여부) |
shapiro.test(residuals)(샤피로-윌크 검정) |
종속변수 Box-Cox 변환, 데이터 확장(중심극한정리) |
| 3. 등분산성 (Homoscedasticity) |
모든 \(X\) 구간에서 오차의 분산 \(\sigma^2\)이 일정해야 함 | 추정량 분산 과소추정 \(\rightarrow\) \(p\)-값 과대평가(1종 오류 증가) | Scale-Location Plot (빨간 추세선 수평 유지) |
car::ncvTest()lmtest::bptest() (Breusch-Pagan) |
종속변수 로그/제곱근 변환, 가중최소제곱법(WLS) |
| 4. 독립성 (Independence) |
오차항들 사이에 자기상관이 없어야 함 (\(\mathrm{Cov}=0\)) | 표준오차가 극단적으로 왜곡되어 가설검정 완전 무효화 | 잔차 순서 시계열 플롯, ACF 플롯 |
car::durbinWatsonTest()(DW 통계량 \(\approx 2.0\)) |
시계열 모형(ARIMA), 오차 자기회귀 회귀, 차분 |
2-2. R을 활용한 가정 진단 및 처방 실전 코드
# 1. 예제 모델 적합 (mtcars 활용)
model <- lm(mpg ~ hp + wt, data = mtcars)

# 2. 4대 가정 그래픽 진단 (2x2 화면 분할)
par(mfrow = c(2, 2))
plot(model)
par(mfrow = c(1, 1))

# ----------------------------------------------------
# A. 선형성 정밀 검정: car 패키지의 residualPlots
# ----------------------------------------------------
library(car)
residualPlots(model)
# 해석: 각 독립변수별 곡률 검정(Curvature Test)의 p-value가 0.05 미만이면
# 선형 관계가 아니라 2차 이상의 비선형 관계가 존재함을 의미함.

# ----------------------------------------------------
# B. 정규성 검정: Shapiro-Wilk Test & car::qqPlot
# ----------------------------------------------------
shapiro.test(residuals(model))
# 귀무가설(H0): 잔차가 정규분포를 따른다.
# p-value >= 0.05 이면 정규성 만족!

qqPlot(model, labels = row.names(mtcars), id.method = "identify",
       simulate = TRUE, main = "Q-Q Plot with 95% Confidence Envelope")

# ----------------------------------------------------
# C. 등분산성 검정: Breusch-Pagan Test & ncvTest
# ----------------------------------------------------
ncvTest(model)          # Non-Constant Error Variance Test
lmtest::bptest(model)   # Breusch-Pagan Test
# 귀무가설(H0): 잔차의 분산이 일정하다(등분산성).
# p-value < 0.05 이면 이분산성(Heteroscedasticity) 문제 발생!

# ----------------------------------------------------
# D. 오차 독립성 검정: Durbin-Watson Test
# ----------------------------------------------------
durbinWatsonTest(model)
# D-W 통계량이 2에 가까우면 자기상관 없음.
# 0에 가까우면 양의 자기상관, 4에 가까우면 음의 자기상관.
2-3. 등분산성·정규성 위배 시의 마법: 박스콕스(Box-Cox) 변환
잔차가 부채꼴 형태로 퍼지거나(이분산성) 왜도(Skewness)가 심해 정규성을 만족하지 못할 때 가장 강력한 해결책은 종속변수의 멱변환(Power Transformation)인 박스콕스(Box-Cox) 변환입니다.
\[y^{(\lambda)} = \begin{cases} \dfrac{y^\lambda - 1}{\lambda}, & \text{if } \lambda \neq 0 \\[8pt] \ln(y), & \text{if } \lambda = 0 \end{cases}\]
library(MASS)

# 1. 최적 lambda 탐색을 위한 Box-Cox 프로파일 우도 함수 산출
bc <- boxcox(model, lambda = seq(-2, 2, by = 0.1))

# 2. 로그 우도를 최대화하는 최적 lambda 추출
best_lambda <- bc$x[which.max(bc$y)]
cat("최적 Lambda 값:", round(best_lambda, 3), "\n")

# lambda = 0 근처: 로그 변환 log(y)
# lambda = 0.5 근처: 제곱근 변환 sqrt(y)
# lambda = -1 근처: 역수 변환 1/y

# 3. 최적 lambda를 적용한 모형 재적합
if (abs(best_lambda) < 0.1) {
  model_fixed <- lm(log(mpg) ~ hp + wt, data = mtcars)
} else {
  model_fixed <- lm((mpg^best_lambda - 1)/best_lambda ~ hp + wt, data = mtcars)
}

# 4. 등분산성 재검정
ncvTest(model_fixed)
3. 다중공선성(Multicollinearity): 보이지 않는 암살자
3-1. 다중공선성이 발생하면 무슨 일이 벌어지는가?
다중공선성은 설명변수들 간에 강한 선형 상관관계가 존재할 때 발생합니다. 예를 들어 ‘월 소득’과 ’연간 소득’, 또는 ’키’와 ’다리 길이’를 동시에 회귀모형에 넣는 경우입니다.
수학적으로 설명변수 행렬 \(\mathbf{X}\)의 열벡터들이 선형 종속에 가까워지면, \(\mathbf{X}^T\mathbf{X}\)의 행렬식(Determinant)이 0에 수렴하게 됩니다.
\[\mathrm{Var}(\hat{\beta}_k) = \frac{\sigma^2}{(n-1)s_k^2} \times \frac{1}{1 - R_k^2} = \frac{\sigma^2}{(n-1)s_k^2} \times \mathrm{VIF}_k\]
여기서 \(R_k^2\)는 \(k\)번째 설명변수를 다른 모든 설명변수들로 회귀분석했을 때의 결정계수입니다. * 설명변수들끼리 강하게 연관될수록 \(R_k^2 \to 1\)이 됩니다. * 분모 \(1 - R_k^2 \to 0\)이 되면서 분산팽창지수(VIF)가 무한대로 폭발합니다. * 계수의 표준오차가 극단적으로 커지므로, 개별 변수의 \(t\)-값(\(\hat{\beta}/\mathrm{SE}\))이 바닥으로 떨어져 실제로는 중요한 변수인데도 \(p\)-값이 0.8, 0.9로 나와 비유의한 변수로 오판하게 됩니다. * 모델 전체의 \(F\)-검정은 \(p < .001\)로 매우 유의한데, 개별 변수는 단 하나도 유의하지 않은 기이한 모순이 발생합니다.
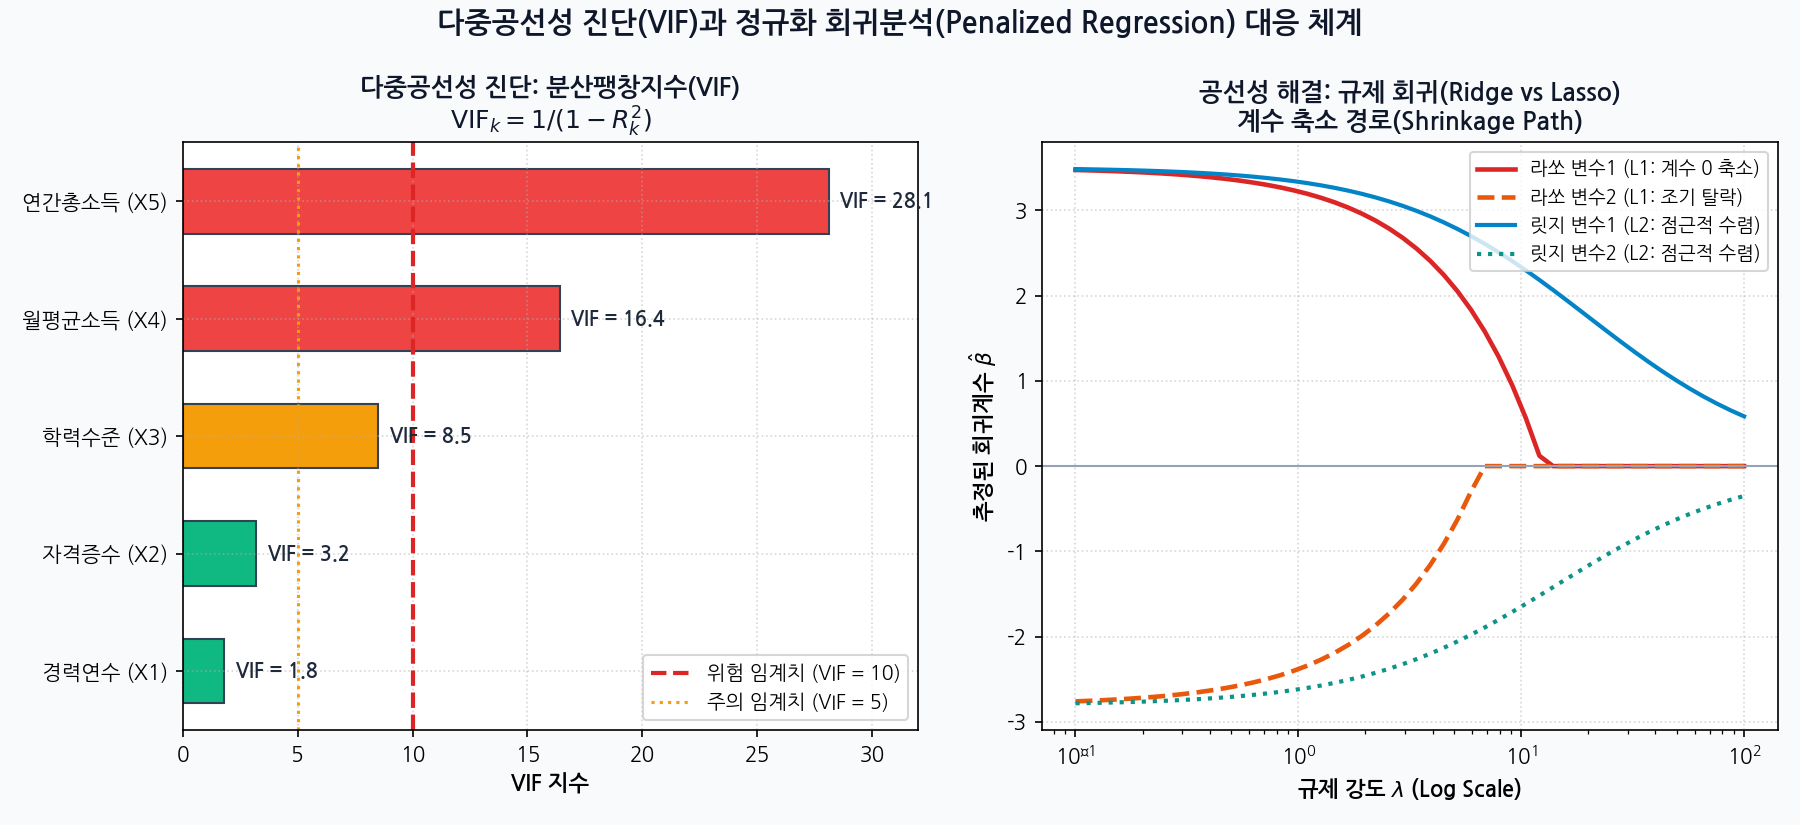
3-2. VIF 진단과 고유값(Eigenvalue) 조건지수
library(car)

# 1. VIF(Variance Inflation Factor) 산출
vif(model)

# 💡 실무 해석 기준:
# VIF < 5: 다중공선성 문제 없음 (안전)
# 5 <= VIF < 10: 주의 필요 (변수 간 상관관계 확인)
# VIF >= 10: 심각한 다중공선성 존재! 즉시 조치 필요

# 2. 고유값과 조건지수(Condition Index)를 통한 정밀 진단
X <- model.matrix(model)[, -1] # 절편 제외
X_scaled <- scale(X)
pca <- prcomp(X_scaled)
eigenvalues <- pca$sdev^2

# 조건지수 계산 (가장 큰 고유값 대비 비율의 제곱근)
cond_indices <- sqrt(max(eigenvalues) / eigenvalues)
cat("최대 조건지수(Condition Number):", max(cond_indices), "\n")
# 조건지수가 15 이상이면 공선성 의심, 30 이상이면 심각한 공선성
3-3. 다중공선성 해결 전략: 릿지(Ridge)와 라쏘(Lasso)
다중공선성이 심할 때 변수를 함부로 삭제하면 중요한 정보가 유실될 수 있습니다. 이때 머신러닝의 정규화 회귀분석(Penalized Regression)이 탁월한 대안이 됩니다.
library(glmnet)

# 데이터 준비 (행렬 형태 필요)
x_mat <- as.matrix(mtcars[, c("hp", "wt", "disp", "drat", "qsec")])
y_vec <- mtcars$mpg

# 1. 릿지 회귀 (Ridge: alpha = 0, L2 패널티)
# 모든 계수를 0 쪽으로 점근적으로 축소하여 계수 분산을 극적으로 낮춤
cv_ridge <- cv.glmnet(x_mat, y_vec, alpha = 0)
best_lambda_ridge <- cv_ridge$lambda.min
ridge_model <- glmnet(x_mat, y_vec, alpha = 0, lambda = best_lambda_ridge)
coef(ridge_model)

# 2. 라쏘 회귀 (Lasso: alpha = 1, L1 패널티)
# 공선성을 유발하는 덜 중요한 변수의 계수를 정확히 0으로 만들어 자동 변수 선택 수행
cv_lasso <- cv.glmnet(x_mat, y_vec, alpha = 1)
best_lambda_lasso <- cv_lasso$lambda.min
lasso_model <- glmnet(x_mat, y_vec, alpha = 1, lambda = best_lasso <- cv_lasso$lambda.min)
coef(lasso_model)
4. 이상치, 지렛대점, 영향점: 회귀모형을 왜곡하는 관측치 판별법
많은 분석가들이 이 세 용어를 혼용하지만, 통계학적으로 셋은 완전히 다른 개념입니다.
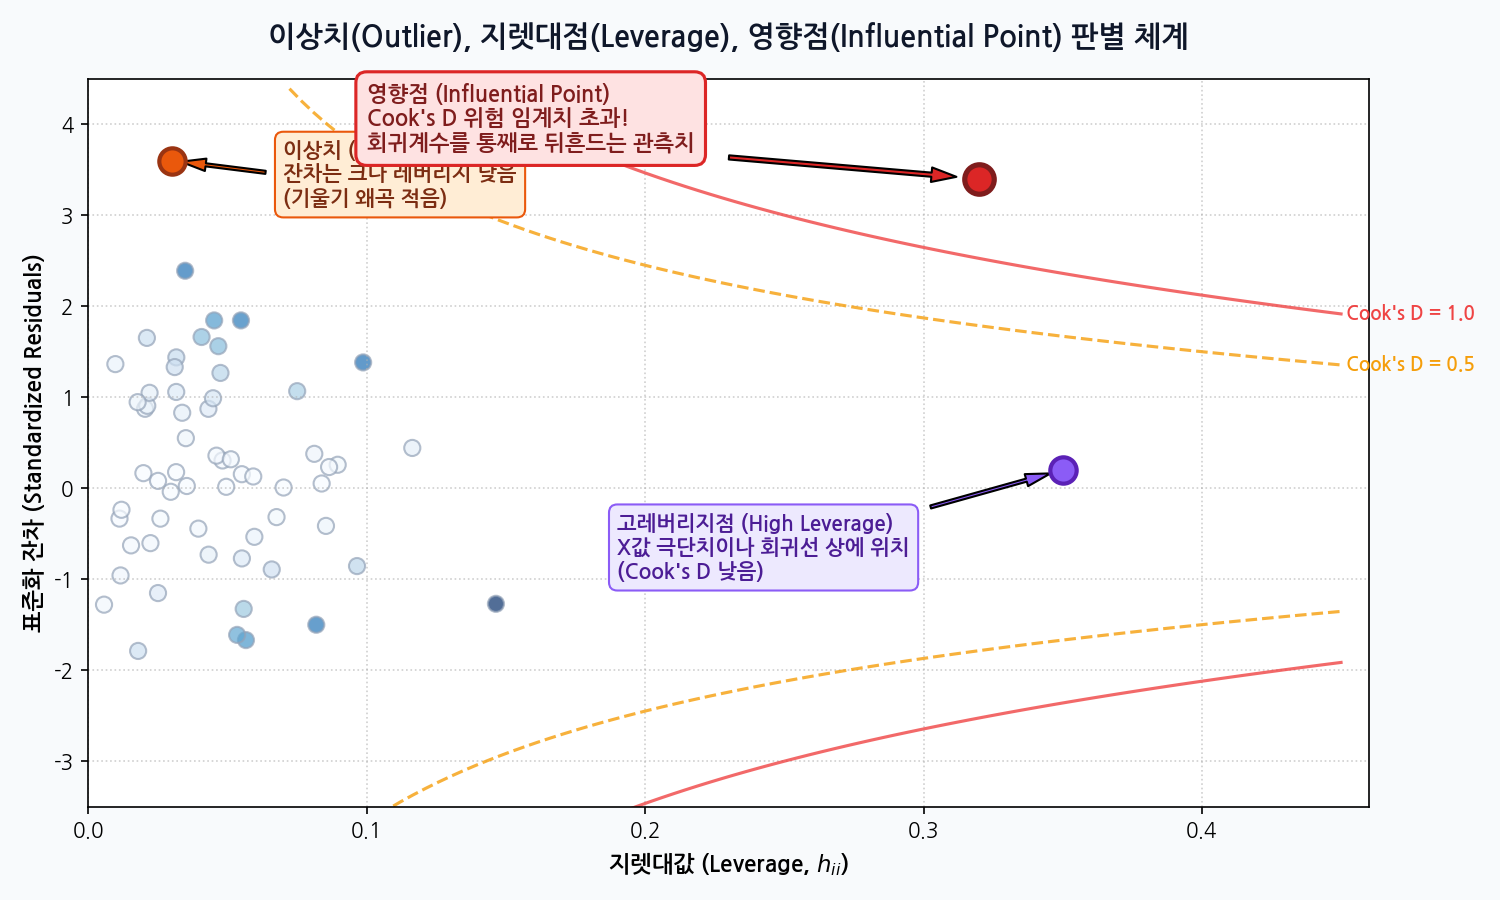
4-1. 3대 특이점 개념 명확히 구별하기
- 이상치 (Outlier):
- \(Y\)값 관점의 특이점: 주어진 \(X\)값에 비해 종속변수 \(Y\)의 관측값이 회귀선에서 수직으로 멀리 떨어진 데이터입니다.
- 측정 지표: 외적 스튜던트화 잔차(Studentized Residual,
rstudent). \(|rstudent_i| > 2\) 또는 \(3\)이면 이상치로 의심합니다.
- 지렛대점 (High Leverage Point):
- \(X\)값 관점의 특이점: 종속변수와 무관하게, 독립변수들의 평균 중심에서 극단적으로 멀리 떨어진 관측치입니다.
- 측정 지표: 모자 행렬의 대각원소인 지렛대값(Hat Value, \(h_{ii}\)).
- 임계치: \(\bar{h} = \frac{p+1}{n}\)일 때, \(h_{ii} > 2\bar{h}\) 또는 \(3\bar{h}\)이면 고레버리지점으로 판단합니다.
- 영향점 (Influential Point):
- 회귀선 왜곡의 주범: “이상치이면서 동시에 높은 지렛대값을 가진 관측치”입니다.
- 이 관측치 하나를 모델에서 제외했을 때 전체 회귀계수 벡터 \(\boldsymbol{\hat{\beta}}\)가 요동칩니다.
- 측정 지표: 쿡의 거리 (Cook’s Distance, \(D_i\))
\[D_i = \frac{\sum_{j=1}^n (\hat{y}_j - \hat{y}_{j(i)})^2}{(p+1)s^2} = \frac{r_i^2}{p+1} \left( \frac{h_{ii}}{1 - h_{ii}} \right)\]
- \(r_i\): 스튜던트화 잔차 (이상치 정도)
- \(\frac{h_{ii}}{1 - h_{ii}}\): 레버리지 비율 (지렛대 정도)
- 임계치 판정 기준:
- 보수적 기준: \(D_i > 1\) 또는 \(D_i > 0.5\)
- 표본 크기 반영 기준: \(D_i > \frac{4}{n - k - 1}\) (\(n\): 표본수, \(k\): 독립변수 수)
4-2. R 실무 영향점 진단 및 시각화
library(car)

# 1. 통합 영향력 플롯 (Bubble Plot)
# 원의 크기가 Cook's Distance를 나타냄
influencePlot(model, id.method = "noteworthy", main = "Influence Plot: mtcars")

# 2. Bonferroni 이상치 통계 검정
outlierTest(model)
# 귀무가설(H0): 해당 관측치는 이상치가 아니다.
# Bonferroni p-value < 0.05 이면 통계적으로 유의한 이상치!

# 3. 쿡의 거리 시각화
cutoff <- 4 / (nrow(mtcars) - length(model$coefficients) - 1)
plot(model, which = 4, cook.levels = cutoff)
abline(h = cutoff, col = "red", lty = 2)
4-3. 이상치를 무작정 지우지 말라: 로버스트 회귀(Robust Regression)
데이터에서 이상치가 발견되었다고 무턱대고 행을 삭제(filter(!row %in% ...))하는 것은 데이터 조작의 위험이 있으며, 현실 세계의 중요한 극단 현상을 은폐할 수 있습니다. 이때 잔차 제곱(\(e^2\)) 대신 완만한 손실 함수(Huber 손실, Tukey Bisquare 손실)를 사용하여 이상치의 가중치를 자동으로 낮추는 로버스트 회귀(lmrob)를 적용해야 합니다.
library(robustbase)

# OLS 회귀 vs 로버스트 회귀 비교
ols_fit <- lm(mpg ~ hp + wt, data = mtcars)
rob_fit <- lmrob(mpg ~ hp + wt, data = mtcars)

summary(ols_fit)$coefficients
summary(rob_fit)$coefficients
# 이상치의 영향력이 감쇄되어 계수 추정치가 훨씬 안정적으로 산출됨!
5. 최적의 변수 선택법: 정보 기준(AIC/BIC)과 All Subsets
수많은 후보 설명변수 중에서 어떤 변수를 최종 모형에 포함해야 할까요?
[후진 소거법 (Backward Elimination)]
  전체 변수 투입 (Full Model) ──▶ 기여도 가장 낮은 변수 순차 제거 ──▶ AIC 최소화 시 정지

[전진 선택법 (Forward Selection)]
  절편만 포함 (Null Model) ──▶ 설명력 가장 큰 변수 순차 추가 ──▶ AIC 개선 없을 시 정지

[단계적 선택법 (Stepwise)]
  Forward + Backward 동시 적용 ──▶ 새로운 변수 추가 시 기존 변수 재검증
5-1. R stepwise 실전 코드
# Full 모델과 Null 모델 정의
full_model <- lm(mpg ~ ., data = mtcars)
null_model <- lm(mpg ~ 1, data = mtcars)

# 1. Stepwise 선택법 (AIC 기준)
step_model <- step(null_model,
                   scope = list(lower = null_model, upper = full_model),
                   direction = "both",
                   trace = TRUE)

summary(step_model)

# 2. 모든 가능한 부분집합 회귀 (All Subsets Regression)
library(leaps)
subsets <- regsubsets(mpg ~ ., data = mtcars, nbest = 1, nvmax = 5)
summary_sub <- summary(subsets)

# 수정된 R^2가 가장 높은 최적 모델 선택
best_adjr2_idx <- which.max(summary_sub$adjr2)
cat("최적 모델 변수 조합:", names(which(summary_sub$which[best_adjr2_idx, ] == TRUE)), "\n")
6. 독립성이 깨졌을 때의 돌파구: 선형 혼합 모형(LMM)의 도입
OLS의 4대 가정 중 가장 치명적인 것이 오차의 독립성입니다. * 동일한 환자를 시간 경과에 따라 반복 측정한 데이터 (Repeated Measures) * 동일한 학급, 동일한 학교에 속한 학생들의 성적 데이터 (Clustered Data)
같은 학교의 학생들은 동일한 교사와 교육 환경을 공유하므로 관측치끼리 필연적으로 상관관계가 존재합니다. 여기에 OLS를 적용하면 표준오차가 극단적으로 과소추정되어 가짜 유의성(Type I Error)을 양산합니다.
이때 고정 효과(Fixed Effects, 관심 변수)와 랜덤 효과(Random Effects, 학교/개인별 고유 분산)를 동시에 분리하여 모델링하는 것이 바로 선형 혼합 모형(Linear Mixed Model, LMM)입니다.
\[Y_{ij} = \underbrace{\mathbf{X}_{ij}\boldsymbol{\beta}}_{\text{고정 효과}} + \underbrace{\mathbf{Z}_{ij}\mathbf{u}_j}_{\text{랜덤 효과}} + \epsilon_{ij}\]
library(lme4)

# 학교(school_id)라는 군집 구조를 반영한 랜덤 절편 모형
# 학생들의 공부시간(study_hours)이 수학 성적에 미치는 고정효과 + 학교별 기본 성적 차이(랜덤 절편)
lmm_fit <- lmer(math_score ~ study_hours + (1 | school_id), data = student_data)
summary(lmm_fit)
7. 실전 실습: 데이터 전처리부터 최종 회귀 리포트까지 A to Z 풀코드
실제 현업과 자격시험(ADP)에서 즉시 사용할 수 있는 엔드투엔드(End-to-End) R 템플릿입니다.
#######################################################
# OLS 선형 회귀분석 실전 완전 정복 파이프라인
#######################################################

# 1. 필수 라이브러리 로드
suppressPackageStartupMessages({
  library(car)
  library(MASS)
  library(lmtest)
  library(leaps)
  library(robustbase)
  library(tidyverse)
})

# 2. 데이터 준비 및 탐색
data(mtcars)
df <- mtcars %>% select(mpg, disp, hp, drat, wt, qsec)

# 3. 1차 전체 모형 적합
fit_initial <- lm(mpg ~ ., data = df)
cat("=== 초기 모형 요약 ===\n")
summary(fit_initial)

# 4. 단계적 변수 선택법 (AIC 기준)
fit_step <- step(fit_initial, direction = "both", trace = FALSE)
cat("\n=== Stepwise 최종 모형 요약 ===\n")
summary(fit_step)

# 5. 다중공선성 진단 (VIF)
cat("\n=== VIF 다중공선성 검정 ===\n")
print(vif(fit_step))

# 6. 잔차 4대 가정 수치 검정
cat("\n=== 4대 잔차 가정 정량 검정 ===\n")
cat("1. 정규성 (Shapiro-Wilk): p =", shapiro.test(residuals(fit_step))$p.value, "\n")
cat("2. 등분산성 (Breusch-Pagan): p =", bptest(fit_step)$p.value, "\n")
cat("3. 독립성 (Durbin-Watson): DW =", durbinWatsonTest(fit_step)$dw,
    ", p =", durbinWatsonTest(fit_step)$p, "\n")

# 7. 영향점 및 이상치 검정
cat("\n=== 이상치 및 영향점 탐색 ===\n")
outlier_res <- outlierTest(fit_step)
print(outlier_res)

cooks_d <- cooks.distance(fit_step)
cutoff_d <- 4 / (nrow(df) - length(coef(fit_step)) - 1)
influential_pts <- which(cooks_d > cutoff_d)
cat("Cook's D 기준 영향점 개수:", length(influential_pts),
    "(관측치:", names(influential_pts), ")\n")

# 8. 최종 진단 플롯 저장
png("regression_diagnostics.png", width = 1000, height = 800, res = 120)
par(mfrow = c(2, 2))
plot(fit_step)
par(mfrow = c(1, 1))
dev.off()
cat("\n진단 플롯 저장 완료: regression_diagnostics.png\n")
8. 실무 체크리스트 및 결론
회귀분석은 기계적으로 lm()을 돌려 나온 \(p\)-값을 보고서에 옮겨 적는 단순 작업이 아닙니다. 모형이 세운 가정이 데이터의 현실과 얼마나 일치하는지 끝없이 대화하는 과정입니다.
┌─────────────────────────────────────────────────────────────┐
│              [ 실무 선형 회귀분석 6대 체크리스트 ]             │
├─────────────────────────────────────────────────────────────┤
│ [ ] 1. 잔차 플롯이 0선을 중심으로 뚜렷한 곡률 없이 균일한가?   │
│ [ ] 2. Q-Q 플롯 양 끝단이 대각선에서 심하게 이탈하지 않는가?    │
│ [ ] 3. 등분산성 검정(BP test)의 p-값이 0.05 이상인가?         │
│ [ ] 4. Durbin-Watson 통계량이 2.0에 근접하여 자기상관이 없는가?│
│ [ ] 5. 모든 설명변수의 VIF 지수가 5 미만으로 안전한가?         │
│ [ ] 6. Cook's Distance가 임계치를 넘는 치명적 영향점은 없는가? │
└─────────────────────────────────────────────────────────────┘
이 6가지 질문에 당당하게 “그렇다”고 답할 수 있을 때, 비로소 여러분의 회귀계수와 예측값은 비즈니스 의사결정과 학술적 주장을 든든하게 받쳐주는 진짜 데이터 사이언스의 무기가 될 것입니다.