flowchart LR
    A["이진 반응변수<br/>Y in {0, 1}"] --> B["선형 확률 모형 (LPM)<br/>Y = Xβ + ε"]
    B -- "한계 봉착" --> C["1. 확률값 음수 / 1 초과 발생<br/>2. 오차 이분산성 (Var=p(1-p))<br/>3. 오차 정규성 붕괴"]
    C -- "수학적 해결" --> D["로짓 변환 & 시그모이드<br/>logit(p) = ln(p/(1-p)) = Xβ"]
    D --> E["로지스틱 회귀 완성<br/>p in [0, 1] 완전 보장!"]

    style A fill:#F1F5F9,stroke:#64748B,stroke-width:1.5px
    style B fill:#FEE2E2,stroke:#DC2626,stroke-width:1.5px
    style C fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style D fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style E fill:#DCFCE7,stroke:#16A34A,stroke-width:2px
💡 핵심 요약 (Executive Summary):
- 선형 확률 모형(LPM)의 한계와 로짓 변환: \(0\) 또는 \(1\)의 이진 반응변수에 일반 선형 회귀(OLS)를 적용하면 예측값이 음수가 되거나 \(1\)을 초과하고 오차의 등분산성이 원천적으로 파괴됩니다. 이를 극복하기 위해 확률 \(p\)를 승산(\(\mathrm{Odds} = p/(1-p)\))으로 바꾸고 자연로그를 취한 로짓 변환(\(\mathrm{logit}(p) = \mathbf{X}\boldsymbol{\beta}\))을 통해 실수 전체 영역(\(-\infty, +\infty\))을 유효한 확률 구간 \([0, 1]\)로 매핑합니다.
- 회귀계수의 본질은 오즈비(Odds Ratio, \(e^\beta\)): 일반 회귀의 계수 \(\beta\)가 “독립변수 1단위 증가 시 \(Y\)의 절대적 가산 변화”를 의미한다면, 로지스틱 회귀에서 \(\beta\)는 로그 승산의 변화량이며, 이에 지수를 취한 \(e^\beta\)는 사건 발생 승산(Odds)이 몇 배 증가하는가를 나타내는 승수적(Multiplicative) 비율입니다.
- 모형 적합도 검정은 이탈도(Deviance): OLS의 결정계수(\(R^2\)) 대신 로지스틱 회귀에서는 최대우도추정(MLE) 기반의 이탈도(Deviance, \(-2\ln L\))를 사용합니다. 널 모델과 제안 모델 간의 이탈도 감소량(\(\Delta D\))에 대해 카이제곱 검정을 수행하여 모형 전체의 통계적 유의성을 판정합니다.
- 보이지 않는 복병, 과산포(Overdispersion): 잔차 이탈도가 자유도보다 현저히 큰 경우(\(\phi > 1\)) 이항분포의 분산 가정(\(p(1-p)\))이 무너져 표준오차가 심각하게 과소추정됩니다. 이때는 반드시
quasibinomial족을 사용하여 분산 팽창을 보정한 신뢰구간을 산출해야 합니다.- 비즈니스 관점의 모델 평가: 실무와 시험(ADP)에서는 단순 정확도(Accuracy)에 의존하지 않고, 불균형 데이터에 강건한 ROC-AUC 곡선, 그리고 상위 고객 선별 마케팅 효율을 입증하는 누적 획득(Gain) 차트와 향상도(Lift) 차트를 결합하여 최종 임계치(Cut-off)를 결정합니다.
0. “고객이 이탈할 확률을 회귀분석으로 예측할 수 없을까?”
데이터 사이언티스트가 현업에서 가장 자주 마주치는 문제는 “연속형 수치”가 아니라 “둘 중 하나의 사건이 일어날 확률”입니다. * 이 고객이 다음 달에 구독을 해지할 것인가? (\(0\) 또는 \(1\)) * 신청된 신용카드 거래가 사기(Fraud)인가? (\(0\) 또는 \(1\)) * 특정 환자에게 특정 약물을 투여했을 때 완치될 것인가? (\(0\) 또는 \(1\))
이 질문에 답하기 위해 직관적으로 OLS 선형 회귀(lm(y ~ x))를 돌리는 순간, 우리는 치명적인 통계적 재앙과 마주하게 됩니다.
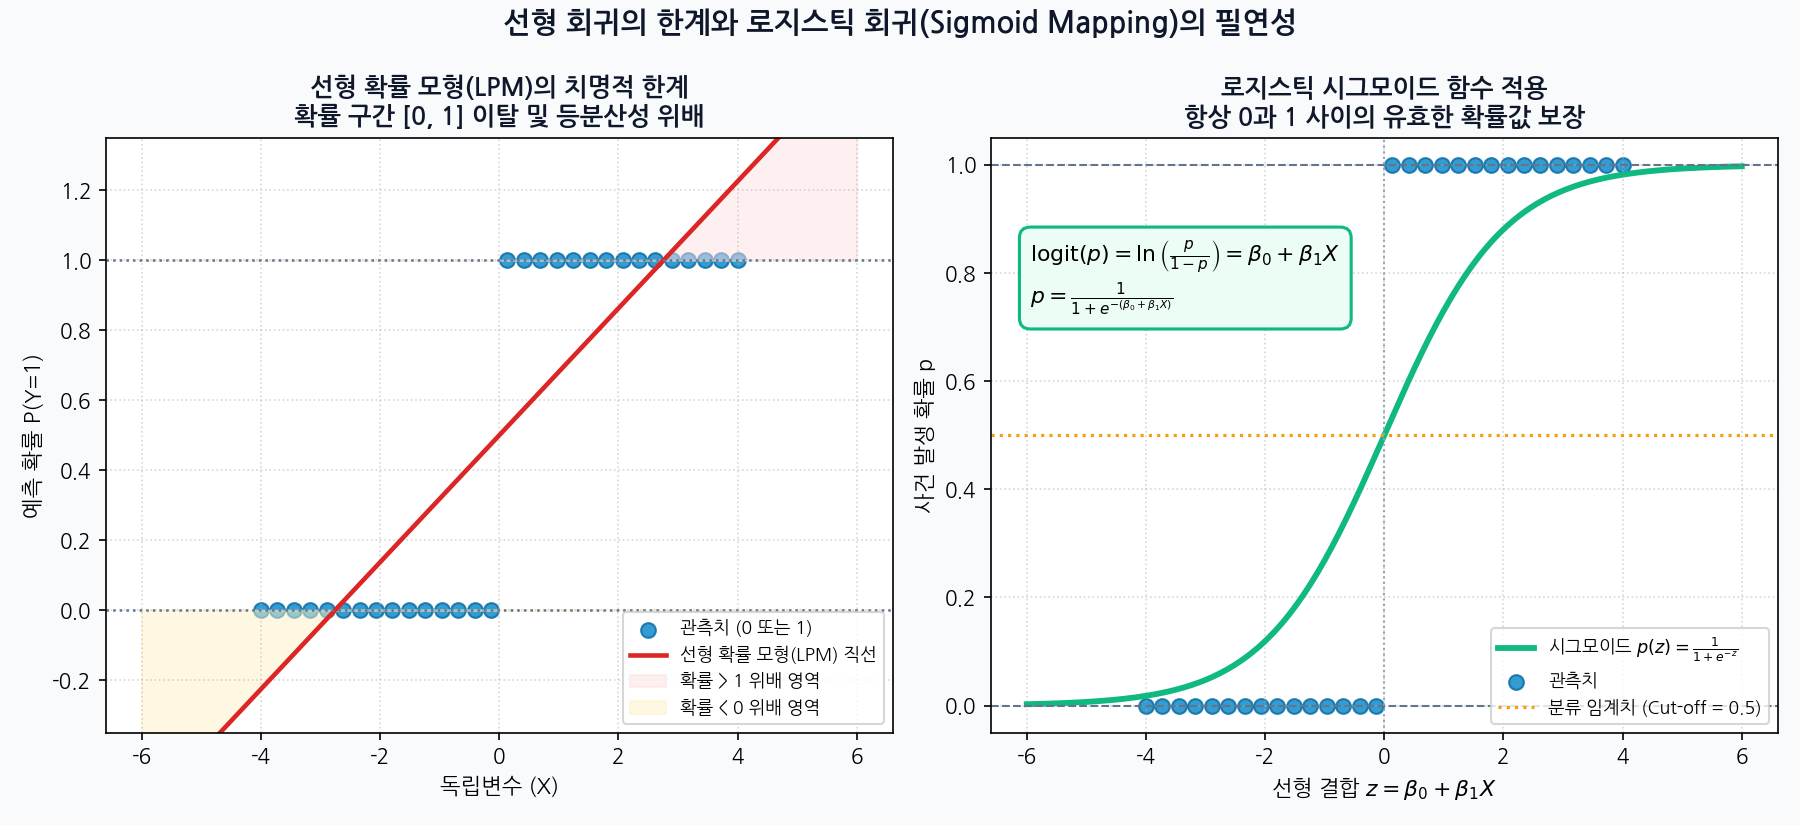
선형 회귀선은 직선이기 때문에 \(X\)값이 조금만 커지거나 작아져도 예측값이 \(1.3\), \(-0.2\)처럼 물리적으로 불가능한 확률값을 뱉어냅니다. 또한 이진 데이터의 분산은 본질적으로 \(p(1-p)\)이므로 \(X\)값에 따라 분산이 계속 변하는 심각한 이분산성(Heteroscedasticity)을 내포합니다.
이 문제를 해결하기 위해 탄생한 우아한 수학적 해법이 바로 로지스틱 회귀분석(Logistic Regression)입니다.
1. 선형 회귀에서 로지스틱으로: 수학적 3단계 유도
우리의 목표는 실수 전체(\(-\infty < \mathbf{X}\boldsymbol{\beta} < +\infty\))를 달리는 독립변수들의 선형 결합을, 항상 \(0\)과 \(1\) 사이에 갇혀 있는 유효한 확률 공간 \(p \in (0, 1)\)으로 매끄럽게 연결(Link)하는 것입니다.
1-1. 1단계: 승산(Odds)의 도입 (\([0, 1] \to [0, \infty)\))
확률 \(p\)는 \(0\)과 \(1\) 사이로 제한되어 있어 다루기 어렵습니다. 따라서 “사건이 일어날 확률”을 “사건이 일어나지 않을 확률”로 나눈 승산(Odds)을 정의합니다.
\[\mathrm{Odds} = \frac{p}{1 - p}\]
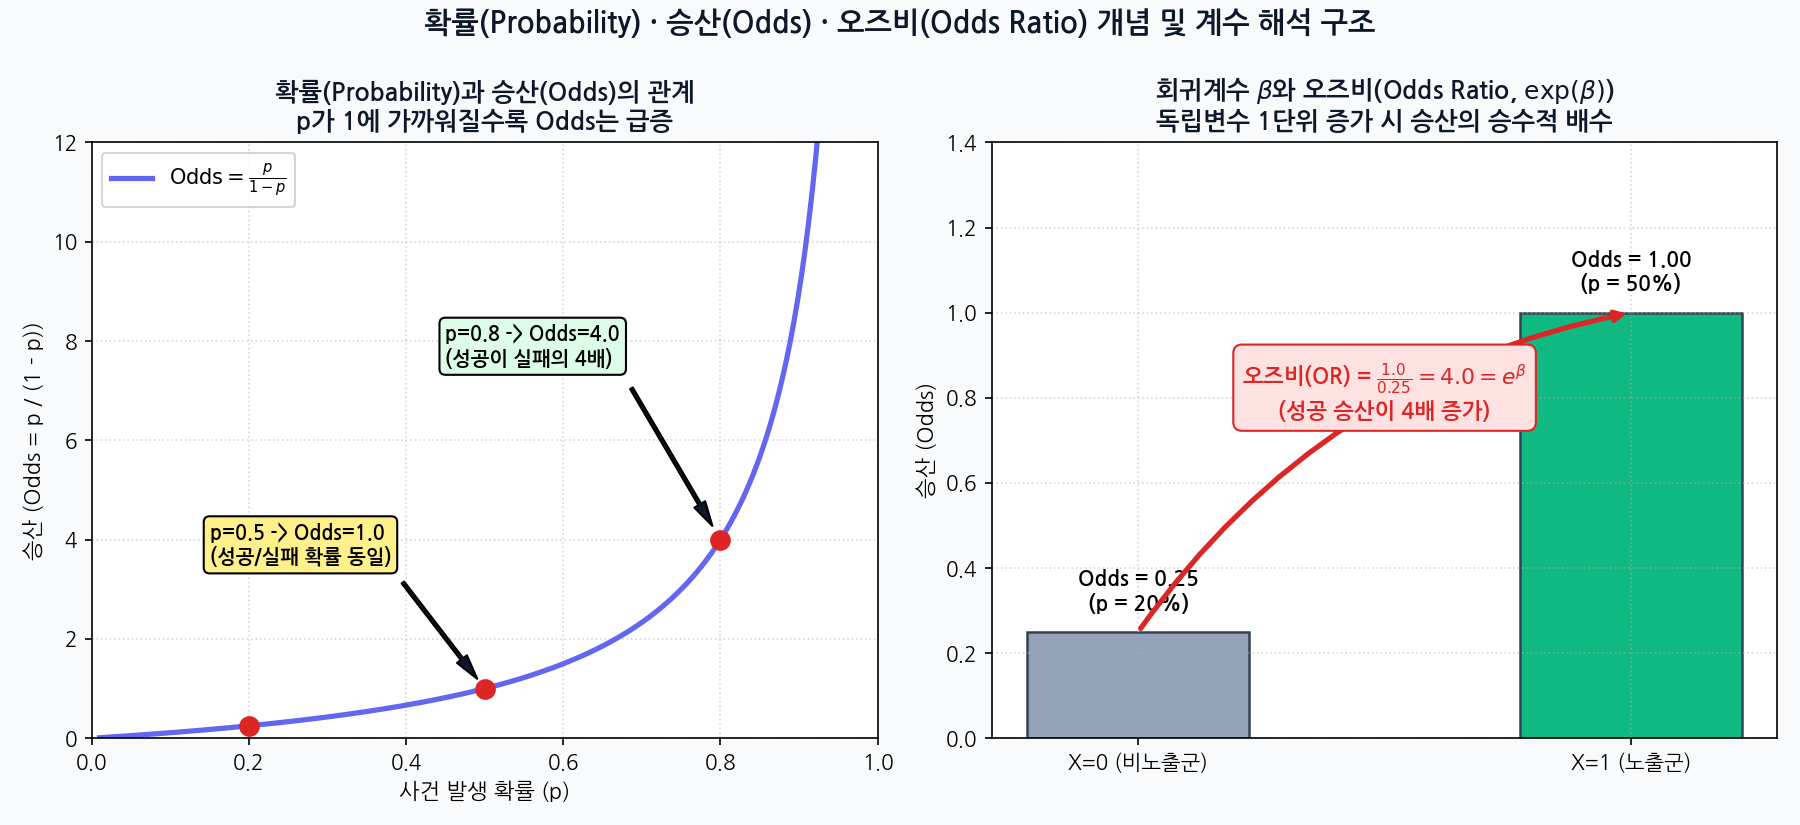
- 사건 발생 확률이 \(p = 0.5\)라면 \(\mathrm{Odds} = 0.5 / 0.5 = 1\)입니다. (성공과 실패가 반반)
- \(p = 0.8\)이면 \(\mathrm{Odds} = 0.8 / 0.2 = 4\)입니다. (성공이 실패보다 4배 높음)
- \(p \to 0\)이면 \(\mathrm{Odds} \to 0\)이고, \(p \to 1\)이면 \(\mathrm{Odds} \to \infty\)로 발산합니다.
- 승산을 취함으로써 값의 상한선(\(1\))이 걷히고 범위가 \([0, \infty)\)로 확장되었습니다.
1-2. 2단계: 로짓 변환(Logit Transformation) (\([0, \infty) \to (-\infty, \infty)\))
승산은 여전히 음수를 가질 수 없습니다. 여기에 자연로그(Natural Log)를 씌워줍니다. 이를 로짓(Logit)이라고 부릅니다.
\[\mathrm{logit}(p) = \ln(\mathrm{Odds}) = \ln\left(\frac{p}{1 - p}\right)\]
- \(p = 0.5\)일 때 \(\ln(1) = 0\)이 됩니다.
- \(p < 0.5\)이면 로그 승산은 음수(\(-\infty\))로 뻗어가고, \(p > 0.5\)이면 양수(\(+\infty\))로 뻗어갑니다.
- 이제 좌변의 로짓값은 실수 전체 \((-\infty, +\infty)\)를 가질 수 있으므로, 우변의 독립변수 선형 결합과 당당하게 등호(\(=\))를 맺을 수 있습니다!
\[\ln\left(\frac{p}{1 - p}\right) = \beta_0 + \beta_1 X_1 + \dots + \beta_k X_k = \mathbf{X}\boldsymbol{\beta}\]
1-3. 3단계: 역변환을 통한 시그모이드(Sigmoid) 함수 도출
우리가 최종적으로 알고 싶은 것은 로그 승산이 아니라 원래의 사건 발생 확률 \(p\)입니다. 위 식을 \(p\)에 대해 풀면:
\[\frac{p}{1 - p} = e^{\mathbf{X}\boldsymbol{\beta}} \implies p = e^{\mathbf{X}\boldsymbol{\beta}}(1 - p) \implies p(1 + e^{\mathbf{X}\boldsymbol{\beta}}) = e^{\mathbf{X}\boldsymbol{\beta}}\]
\[\boxed{p = \frac{e^{\mathbf{X}\boldsymbol{\beta}}}{1 + e^{\mathbf{X}\boldsymbol{\beta}}} = \frac{1}{1 + e^{-\mathbf{X}\boldsymbol{\beta}}}}\]
이것이 바로 머신러닝과 딥러닝 전반에서 활성화 함수로 널리 쓰이는 로지스틱 시그모이드(Sigmoid) 함수입니다. 어떤 실수 입력값이 들어와도 부드러운 S자 곡선을 그리며 완벽하게 \([0, 1]\) 구간 안으로 수렴합니다.
2. 오즈비(Odds Ratio): 회귀계수 \(\beta\)의 완벽한 실무 해석
로지스틱 회귀 결과를 볼 때 가장 많은 오류가 일어나는 지점이 바로 계수 해석입니다.
2-1. 선형 회귀 vs 로지스틱 회귀 계수 비교
| 구분 | 일반 선형 회귀 (OLS) | 로지스틱 회귀 (Logistic) |
|---|---|---|
| 종속변수의 형태 | 연속형 실수 (\(Y\)) | 성공/실패 이진 확률 (\(p\)) |
| 회귀식 형태 | \(Y = \beta_0 + \beta_1 X\) | \(\ln(\mathrm{Odds}) = \beta_0 + \beta_1 X\) |
| 계수 \(\beta_1\)의 의미 | \(X\)가 1단위 증가할 때 \(Y\)의 절대적 덧셈 변화량 | \(X\)가 1단위 증가할 때 로그 승산의 변화량 |
| 실무 해석 핵심 | \(\hat{\beta}_1\) 그대로 해석 | 지수 변환값 \(e^{\hat{\beta}_1}\) (오즈비)로 해석 |
| 변화의 성격 | 산술적 가산(Additive, \(+ \beta_1\)) | 승수적 배수(Multiplicative, \(\times e^{\beta_1}\)) |
2-2. 오즈비(Odds Ratio, OR)의 수학적 유도
독립변수 \(X\)가 \(x\)일 때의 승산을 \(\mathrm{Odds}_A\), \(X\)가 \(1\)단위 증가하여 \(x+1\)이 되었을 때의 승산을 \(\mathrm{Odds}_B\)라고 합시다.
\[\ln(\mathrm{Odds}_A) = \beta_0 + \beta_1 x \implies \mathrm{Odds}_A = e^{\beta_0 + \beta_1 x}\] \[\ln(\mathrm{Odds}_B) = \beta_0 + \beta_1 (x + 1) \implies \mathrm{Odds}_B = e^{\beta_0 + \beta_1 x + \beta_1}\]
이 두 승산의 비율, 즉 오즈비(Odds Ratio, OR)를 구하면:
\[\mathrm{OR} = \frac{\mathrm{Odds}_B}{\mathrm{Odds}_A} = \frac{e^{\beta_0 + \beta_1 x + \beta_1}}{e^{\beta_0 + \beta_1 x}} = \boxed{e^{\beta_1}}\]
놀랍게도 기준값 \(x\)는 완전히 약분되어 사라지고 오직 \(e^{\beta_1}\)만 남습니다!
- \(e^\beta = 1\) (\(\beta = 0\)): 독립변수 \(X\)는 사건 발생 승산에 아무런 영향을 주지 않습니다.
- \(e^\beta > 1\) (\(\beta > 0\)): \(X\)가 1단위 증가할 때마다 성공 승산이 \(e^\beta\)배로 증가합니다. (예: \(e^\beta = 1.35\)이면 승산이 \(35\%\) 증가)
- \(e^\beta < 1\) (\(\beta < 0\)): \(X\)가 1단위 증가할 때마다 성공 승산이 \(e^\beta\)배로 감소합니다. (예: \(e^\beta = 0.70\)이면 승산이 \(30\%\) 감소)
⚠️ 실무 주의: 오즈비(OR)는 확률비(Relative Risk)가 아니다!
“오즈비가 2배니까 사건 발생 확률도 2배가 된다”고 해석하면 틀립니다. 사건의 발생 확률이 매우 희귀한 경우(\(p < 0.05\))에는 \(\mathrm{Odds} \approx p\)이므로 오즈비가 상대위험도(RR)에 근접하지만, 일반적인 상황에서는 오즈비가 확률의 변화율보다 훨씬 과장되게 나타납니다.
3. 모형 적합(MLE)과 이탈도(Deviance) 가설검정
3-1. 왜 OLS를 쓸 수 없고 최대우도추정(MLE)을 쓰는가?
선형 회귀에서는 잔차가 정규분포를 따른다고 가정하므로 잔차 제곱합을 최소화하는 OLS가 최대우도추정(MLE)과 일치했습니다. 하지만 로지스틱 회귀의 반응변수 \(y_i\)는 \(0\) 또는 \(1\)의 베르누이(Bernoulli) 분포를 따릅니다.
\[P(Y_i = y_i) = p_i^{y_i} (1 - p_i)^{1 - y_i} \quad (y_i \in \{0, 1\})\]
전체 데이터에 대한 우도 함수(Likelihood Function) \(L(\boldsymbol{\beta})\)는 다음과 같습니다.
\[L(\boldsymbol{\beta}) = \prod_{i=1}^n p_i^{y_i} (1 - p_i)^{1 - y_i}\]
양변에 자연로그를 취하고 부호를 바꾼 것이 머신러닝의 이진 교차 엔트로피 손실 함수(Binary Cross-Entropy Loss)이자 로그 우도 함수입니다.
\[\ln L(\boldsymbol{\beta}) = \sum_{i=1}^n \left[ y_i \ln(p_i) + (1 - y_i) \ln(1 - p_i) \right]\]
이 식은 OLS처럼 닫힌 형태의 미분해(Closed-form)가 나오지 않으므로, 컴퓨터가 뉴턴-랩슨(Newton-Raphson) 알고리즘 또는 반복 가중 최소자승법(IRLS: Iteratively Reweighted Least Squares)을 통해 수치적으로 최적의 계수 \(\boldsymbol{\hat{\beta}}\)을 수렴 탐색합니다.
3-2. 이탈도(Deviance) 차이 검정: OLS의 F-검정에 대응
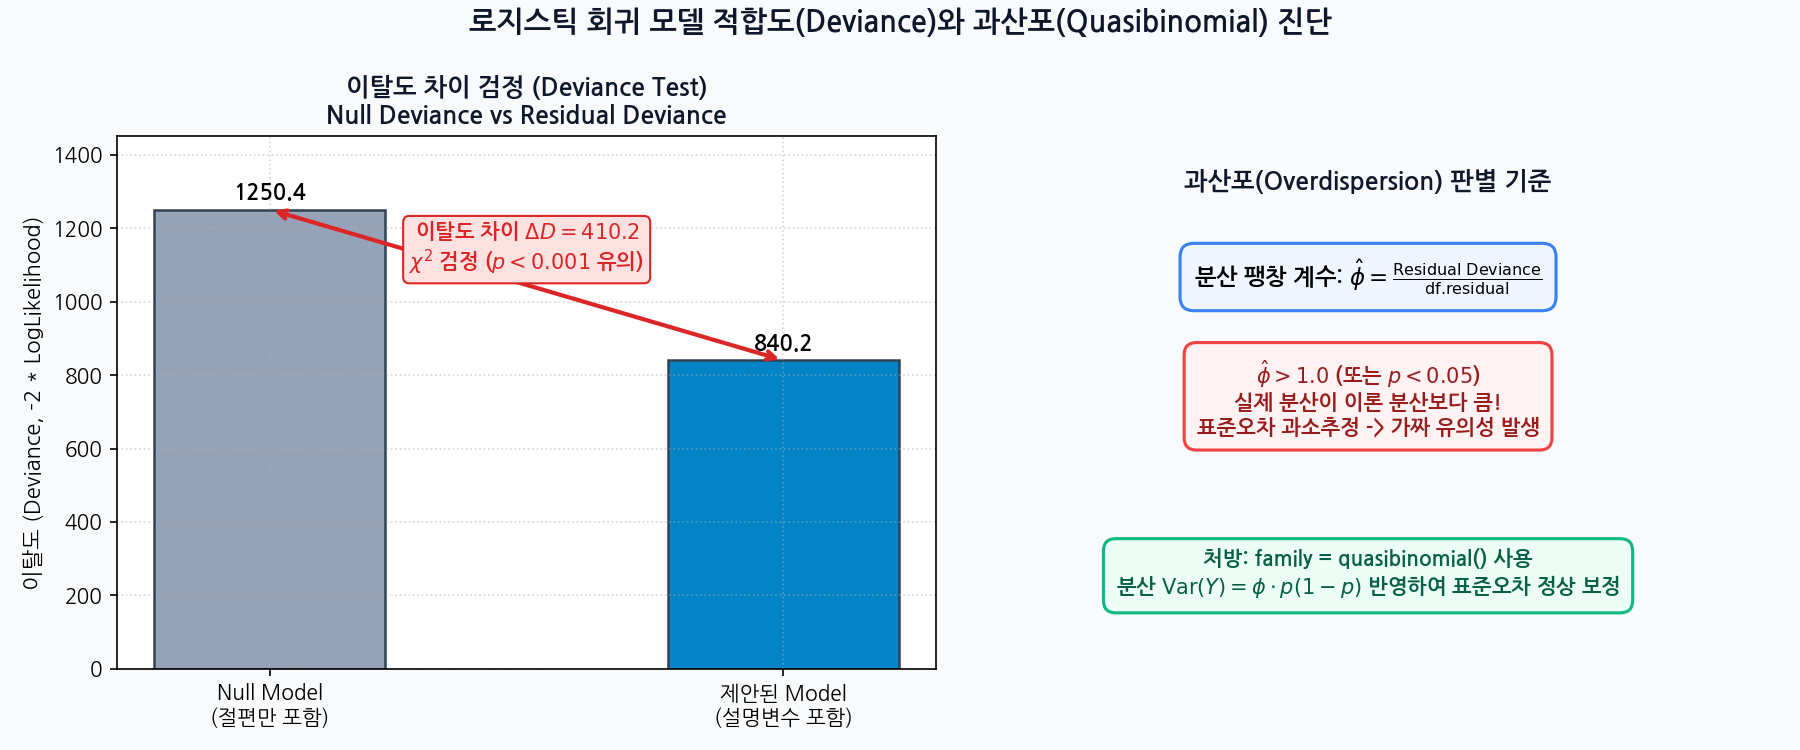
로지스틱 회귀에는 \(R^2\)가 없습니다. 대신 관측치와 모형의 오차 크기를 나타내는 이탈도(Deviance, \(D\))를 사용합니다.
\[D = -2 \ln L(\text{제안 모형}) + 2 \ln L(\text{포화 모형})\]
- 널 이탈도 (Null Deviance): 절편(\(\beta_0\))만 있고 설명변수가 하나도 없을 때의 오차 크기. (자유도: \(n - 1\))
- 잔차 이탈도 (Residual Deviance): 연구자의 설명변수들을 투입한 후 남아 있는 설명되지 않은 오차 크기. (자유도: \(n - k - 1\))
# 이탈도 감소량 카이제곱 검정
delta_deviance <- model$null.deviance - model$deviance
delta_df <- model$df.null - model$df.residual
p_val <- pchisq(delta_deviance, df = delta_df, lower.tail = FALSE)

cat("이탈도 감소량 (Chisq):", round(delta_deviance, 2), "\n")
cat("모형 유의확률 (p-value):", format.pval(p_val), "\n")
# p-value < 0.05 이면 독립변수들이 유의미하게 사건 발생을 설명하고 있음을 입증!
4. 과산포(Overdispersion): 숨겨진 표준오차 왜곡의 주범
이항 로지스틱 회귀는 반응변수의 분산이 수학적으로 \(\mathrm{Var}(Y) = p(1-p)\)로 완전히 고정되어 있다고 가정합니다. 하지만 실제 실무 데이터에서는 군집 효과, 미관측 이질성(Unobserved Heterogeneity) 등으로 인해 실제 분산이 이론 분산보다 훨씬 크게 나타나는 과산포(Overdispersion) 현상이 흔히 발생합니다.
4-1. 과산포가 발생하면 왜 위험한가?
- 오차의 분산 팽창 계수 \(\phi = \frac{\text{Residual Deviance}}{\text{df.residual}} > 1\)이 됩니다.
- 모형이 분산을 과소평가하므로, 회귀계수의 표준오차(SE)가 실제보다 작게 계산됩니다.
- 그 결과 \(z\)-값(\(\hat{\beta}/\mathrm{SE}\))이 부풀려져, 실제로는 아무 효과가 없는 변수가 대단히 유의한 것으로 둔갑하는 제1종 오류(False Positive)가 발생합니다.
4-2. R 과산포 검정 및 quasibinomial 처방
# 1. 일반 binomial 모델 적합
fit_binom <- glm(churn ~ ., data = train_df, family = binomial())

# 2. quasibinomial 모델 적합 (분산 팽창 허용)
fit_quasi <- glm(churn ~ ., data = train_df, family = quasibinomial())

# 3. 분산 팽창 계수(Dispersion parameter) 확인
phi_hat <- summary(fit_quasi)$dispersion
cat("추정된 분산 팽창 계수 (phi):", round(phi_hat, 3), "\n")

# 4. 과산포 통계적 유의성 검정
# 귀무가설(H0): phi = 1 (과산포 없음)
pchisq(phi_hat * fit_binom$df.residual, fit_binom$df.residual, lower.tail = FALSE)
# p < 0.05 이면 과산포 존재! 최종 분석 결과와 보고서에는 quasibinomial의 계수표를 사용해야 함.
5. 실무 분류 성능 평가 3종 세트: ROC, Gain, Lift 차트
분류 임계치(Cut-off)를 무조건 \(0.5\)로 고정해 두고 Accuracy만 보고하는 것은 초보 분석가의 전형적인 실수입니다. 사기 거래 탐지처럼 \(1\)의 비율이 \(1\%\)인 불균형 데이터에서는 무조건 \(0\)으로만 예측해도 정확도가 \(99\%\)가 나오기 때문입니다.
5-1. ROC Curve와 AUC: 임계치에 독립적인 모델 판별력
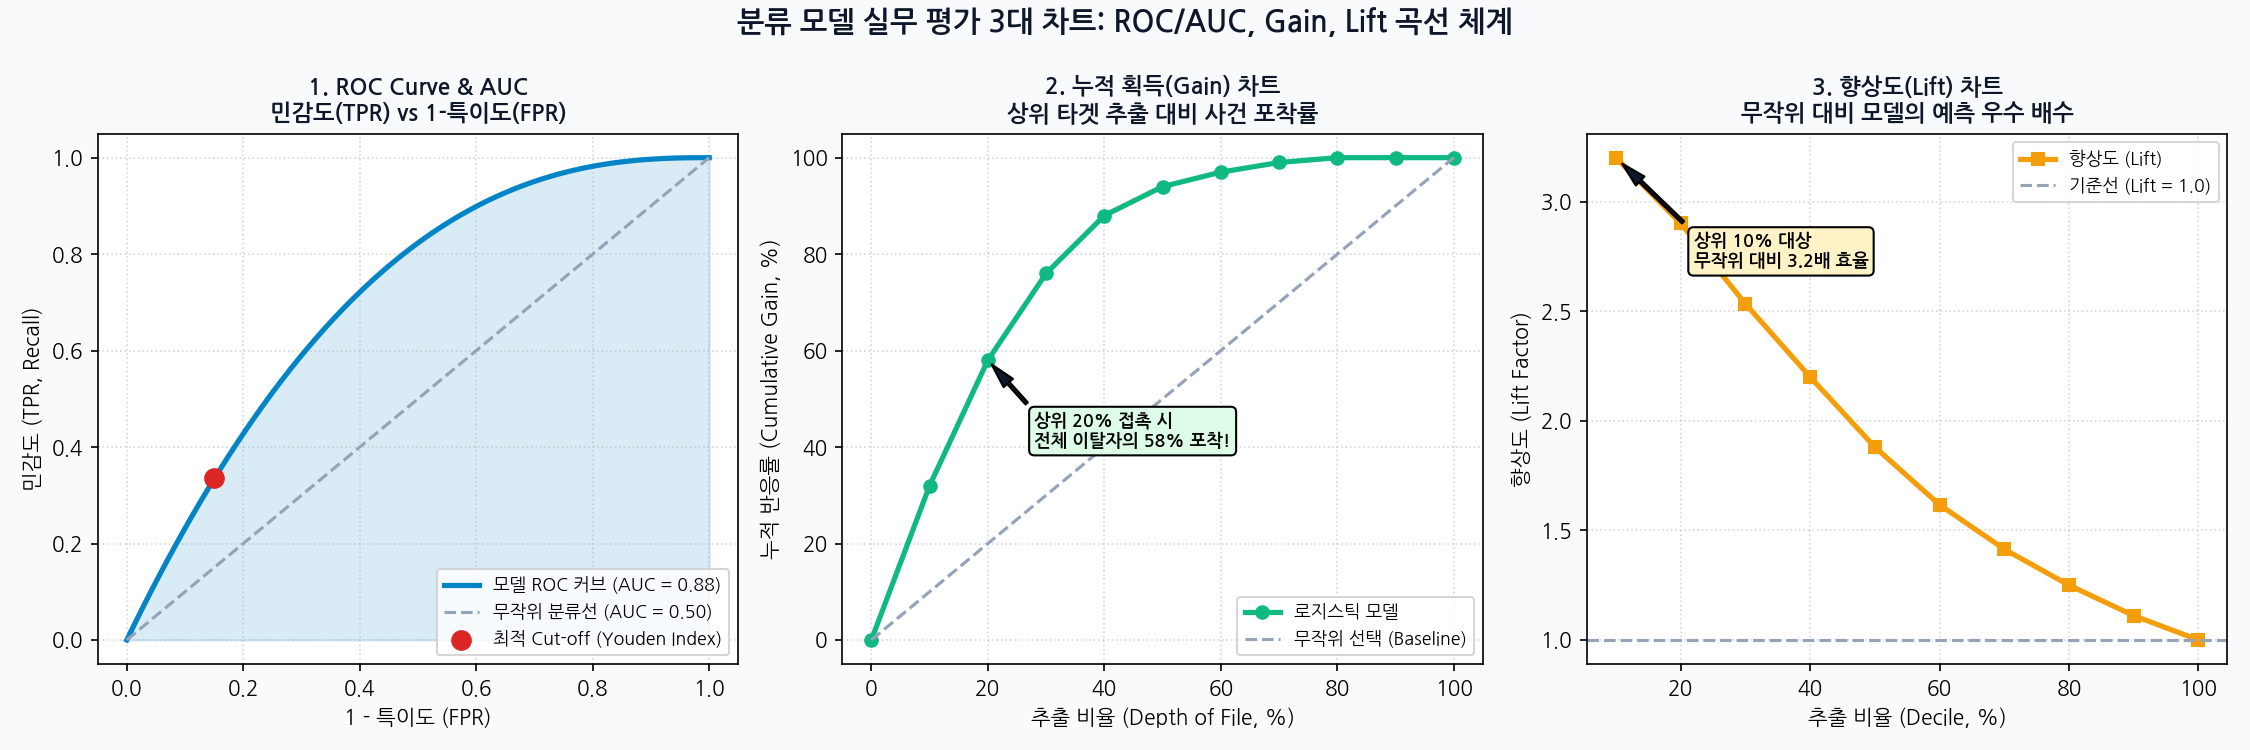
- X축 (1 - Specificity, FPR): 실제 정상인데 사기라고 오탐한 비율
- Y축 (Sensitivity, Recall, TPR): 실제 사기 중 사기라고 정확히 잡아낸 비율
- AUC (Area Under the Curve):
- \(0.5\): 무작위 동전 던지기 수준 (쓸모없음)
- \(0.7 \sim 0.8\): 양호한 판별력
- \(0.8 \sim 0.9\): 매우 우수한 모델
- \(0.9\) 이상: 탁월한 모델 (과적합 의심 필요)
library(pROC)

# 예측 확률값 산출
pred_probs <- predict(fit_binom, newdata = valid_df, type = "response")

# ROC 객체 생성
roc_obj <- roc(valid_df$churn, pred_probs)

# 최적 임계치(Youden Index 기준)와 AUC 출력
plot(roc_obj, print.thres = "best", print.auc = TRUE, col = "#0284C7", lwd = 2.5)
5-2. 누적 획득(Gain) 차트와 향상도(Lift) 차트의 비즈니스 가치
마케팅 팀이나 영업 팀에게 “우리 모델의 AUC는 0.88입니다”라고 말하면 아무도 이해하지 못합니다. 현업 의사결정권자가 듣고 싶어 하는 것은 “마케팅 예산이 부족해서 전체 고객의 20%에게만 전화를 돌릴 수 있는데, 그 20% 안에 실제 이탈 고객이 얼마나 포함되어 있는가?”입니다. 이 질문에 답하는 도구가 바로 Gain과 Lift 차트입니다.
library(gains)

# 예측 확률에 따라 10분위수(Decile)로 그룹화
gain_table <- gains(valid_df$churn, pred_probs, groups = 10)
print(gain_table)

# 💡 실무 해석 포인트:
# 1. Depth 20%: 예측 확률 상위 20% 고객을 추출했을 때
# 2. Cume Pct of Total (누적 획득률): 전체 이탈자 중 58%가 이 상위 20%에 몰려 있음!
# 3. Lift (향상도): 무작위로 20%를 뽑았을 때 대비 2.9배(58% / 20%) 더 효율적으로 이탈자를 타격함!
6. 다항 로지스틱 회귀와 포아송 회귀 확장
6-1. 반응변수 범주가 3개 이상일 때: 다항 로지스틱 회귀(Multinomial)
선택지가 ‘민주당’, ‘공화당’, ’무소속’처럼 3개 이상인 비서열 범주형 반응변수에는 다항 로지스틱 회귀를 적용합니다. 특정 기준 범주(Reference Category)를 하나 지정하고, 기준 범주 대비 각 범주를 선택할 로그 승산을 \(K-1\)개의 방정식으로 동시 추정합니다.
\[\ln\left(\frac{P(Y = j)}{P(Y = \text{기준})}\right) = \beta_{0j} + \beta_{1j} X \quad (j = 1, \dots, K-1)\]
library(nnet)

# 기준 범주 설정 (예: '정상')
data_df$type <- relevel(factor(data_df$type), ref = "Normal")

# 다항 로지스틱 회귀 적합
fit_multi <- multinom(type ~ age + income + score, data = data_df)
summary(fit_multi)

# 각 범주별 오즈비(Odds Ratio) 추출
exp(coef(fit_multi))
6-2. 사건 발생 횟수를 모델링할 때: 포아송 회귀(Poisson Regression)
“특정 기간 동안 발생한 고장 횟수”, “매장에 방문한 고객 수”처럼 음이 아닌 정수(Count Data)를 예측할 때는 정규분포 대신 포아송 분포를 사용하는 포아송 회귀를 사용합니다.
\[\ln(\lambda) = \beta_0 + \beta_1 X \implies \lambda = e^{\mathbf{X}\boldsymbol{\beta}}\]
관측 대상마다 노출 시간이나 운행 거리가 서로 다를 때는 반드시 오프셋 항(offset = log(exposure))을 지정하여 단위 시간당 발생률(Rate)로 보정해야 합니다.
# 선박 고장 건수(incidents) 예측 (운항 개월 수 service를 offset으로 보정)
fit_pois <- glm(incidents ~ type + year, data = ships_data,
                family = poisson(), offset = log(service))
summary(fit_pois)

# 포아송 회귀 역시 분산 = 평균 가정 위배 시 quasipoisson() 적용 필수!
7. 실전 R 실습 풀코드: 항공편 지연 예측 A to Z 파이프라인
데이터 전처리, 기준 범주 설정, 변수 선택, 로지스틱 회귀 적합, 과산포 진단, ROC 커브, Gain/Lift 차트 생성까지 한 번에 실행되는 실전 풀코드입니다.
#######################################################
# 로지스틱 회귀분석 실전 완전 정복 파이프라인
#######################################################

suppressPackageStartupMessages({
  library(tidyverse)
  library(car)
  library(pROC)
  library(gains)
  library(caret)
  library(bestglm)
})

# 1. 가상 항공 지연 데이터 생성 (재현성 확보)
set.seed(42)
n <- 1000
carrier <- sample(c("US", "UA", "DL"), n, replace = TRUE)
day_week <- sample(c("MON", "WED", "FRI", "SUN"), n, replace = TRUE)
distance <- rnorm(n, mean = 600, sd = 200)
dep_delay_prior <- rpois(n, lambda = 15)

# 지연 확률 생성 (로짓 모형 기반)
z <- -2.2 + 0.6 * (carrier == "UA") + 0.8 * (day_week == "FRI") +
     0.05 * dep_delay_prior + 0.001 * distance
true_prob <- 1 / (1 + exp(-z))
is_delay <- rbinom(n, size = 1, prob = true_prob)

df <- data.frame(
  carrier = factor(carrier),
  day_week = factor(day_week),
  distance = distance,
  dep_delay_prior = dep_delay_prior,
  is_delay = factor(is_delay)
)

# 기준 범주(Reference Category) 명시적 지정
df$carrier <- relevel(df$carrier, ref = "US")
df$day_week <- relevel(df$day_week, ref = "WED")

# 2. 데이터 분할 (Train 70% : Valid 30%)
train_idx <- createDataPartition(df$is_delay, p = 0.7, list = FALSE)
train_df <- df[train_idx, ]
valid_df <- df[-train_idx, ]

# 3. 로지스틱 회귀모형 적합
fit_logit <- glm(is_delay ~ ., data = train_df, family = binomial(link = "logit"))
cat("=== 로지스틱 회귀모형 요약 ===\n")
summary(fit_logit)

# 4. 회귀계수 및 오즈비(Odds Ratio)와 95% 신뢰구간
or_table <- exp(cbind(OR = coef(fit_logit), confint(fit_logit)))
cat("\n=== 오즈비(Odds Ratio) 및 95% 신뢰구간 ===\n")
print(round(or_table, 3))

# 5. 이탈도 차이 검정 (모형 적합도 F-검정 대체)
diff_dev <- fit_logit$null.deviance - fit_logit$deviance
diff_df <- fit_logit$df.null - fit_logit$df.residual
cat("\n이탈도 차이 검정 p-value:", pchisq(diff_dev, diff_df, lower.tail = FALSE), "\n")

# 6. 다중공선성(VIF) 검정
cat("\n=== VIF 다중공선성 ===\n")
print(vif(fit_logit))

# 7. 과산포(Overdispersion) 검정
fit_quasi <- glm(is_delay ~ ., data = train_df, family = quasibinomial())
disp_param <- summary(fit_quasi)$dispersion
cat("\n과산포 계수 (Dispersion):", round(disp_param, 3), "\n")

# 8. 검증 데이터셋 평가 (ROC 및 AUC)
valid_prob <- predict(fit_logit, newdata = valid_df, type = "response")
roc_curve <- roc(as.numeric(as.character(valid_df$is_delay)), valid_prob)
cat("검증셋 AUC:", round(auc(roc_curve), 4), "\n")

# 9. 혼동행렬 (최적 Cut-off 적용)
best_coords <- coords(roc_curve, "best", ret = "threshold")
best_cut <- best_coords$threshold[1]
cat("최적 Cut-off 임계치:", round(best_cut, 3), "\n")

pred_class <- ifelse(valid_prob > best_cut, 1, 0)
cm <- confusionMatrix(factor(pred_class), factor(valid_df$is_delay), positive = "1")
cat("\n=== 혼동 행렬 결과 ===\n")
print(cm$byClass[c("Sensitivity", "Specificity", "Precision", "F1")])

# 10. Gains & Lift 분석
gain_res <- gains(as.numeric(as.character(valid_df$is_delay)), valid_prob, groups = 10)
cat("\n=== 누적 획득(Gain) 테이블 (상위 3분위) ===\n")
print(head(data.frame(
  Depth_Pct = gain_res$depth,
  Cum_Gain_Pct = round(gain_res$cume.pct.of.total * 100, 1),
  Lift = round(gain_res$lift / 100, 2)
), 3))
8. 실무 체크리스트 및 결론
로지스틱 회귀분석은 단순한 머신러닝 분류 알고리즘을 넘어, 사건 발생 확률에 작용하는 위험 인자의 크기를 정확한 오즈비(Odds Ratio)로 수치화해 주는 가장 투명하고 강력한 통계적 도구입니다.
┌─────────────────────────────────────────────────────────────┐
│             [ 실무 로지스틱 회귀분석 6대 체크리스트 ]          │
├─────────────────────────────────────────────────────────────┤
│ [ ] 1. 범주형 독립변수의 기준 범주(Reference)가 명확한가?     │
│ [ ] 2. 회귀계수(beta)를 지수화하여 오즈비(exp(beta))로 해석했는가?│
│ [ ] 3. 널 이탈도 대비 잔차 이탈도 감소량이 카이제곱 유의한가?  │
│ [ ] 4. 과산포 계수(phi)가 1을 초과하여 quasibinomial이 필요한가?│
│ [ ] 5. 단순 정확도가 아닌 ROC-AUC와 최적 Cut-off를 검토했는가?  │
│ [ ] 6. 비즈니스 설득을 위해 Gain / Lift 차트를 준비했는가?    │
└─────────────────────────────────────────────────────────────┘
이 원칙들을 가슴에 품고 로지스틱 회귀를 다룬다면, 여러분의 분류 모델은 단순한 블랙박스 예측기가 아니라 비즈니스와 연구 현장에 실질적인 변화를 일으키는 가장 믿음직한 나침반이 될 것입니다.