flowchart LR
    A["이메일 텍스트 입력<br/>('무료', '대출', '당첨' 등)"] --> B["사전확률 P(스팸) 확인<br/>(전체 메일 중 스팸 비율)"]
    B --> C["조건부 독립 기반 우도 계산<br/>P(무료|스팸) × P(대출|스팸) × ..."]
    C --> D["라플라스 스무딩 적용<br/>(미관측 단어 P=0 방지)"]
    D --> E["MAP 사후확률 계산<br/>P(스팸|단어들) vs P(정상|단어들)"]
    E --> F["최종 분류 확정<br/>스팸 편지함 직행!"]

    style A fill:#F1F5F9,stroke:#64748B,stroke-width:1.5px
    style B fill:#E0F2FE,stroke:#0284C7,stroke-width:1.5px
    style C fill:#FEF3C7,stroke:#D97706,stroke-width:1.5px
    style D fill:#FEE2E2,stroke:#DC2626,stroke-width:1.5px
    style E fill:#F3E8FF,stroke:#7C3AED,stroke-width:1.5px
    style F fill:#DCFCE7,stroke:#16A34A,stroke-width:2px
💡 핵심 요약 (Executive Summary):
- 베이즈 정리의 수학적 추론: 나이브 베이즈는 관측 데이터 \(\mathbf{X}\)가 주어졌을 때 각 클래스 \(c\)에 속할 사후확률(\(P(Y=c \mid \mathbf{X})\))을 사전확률(\(P(Y=c)\))과 우도(\(P(\mathbf{X} \mid Y=c)\))의 곱으로 계산하는 최대 사후 확률(MAP: Maximum A Posteriori) 결정 기법입니다.
- ’나이브(Naive)’한 가정의 천재성: 클래스가 주어졌을 때 모든 설명변수가 서로 조건부 독립(Conditionally Independent)이라는 다소 순진한 가정을 통해, \(2^p\)개의 지수적 결합확률 연산을 \(O(p)\) 수준의 단순 곱셈(\(\prod P(X_j \mid Y)\))으로 환원시킵니다. 변수 간 상관관계가 일부 존재하더라도 사후확률의 크기 순위(Ranking)는 보존되어 실무 분류 성능이 매우 우수합니다.
- 제로 빈도(Zero Frequency)와 라플라스 스무딩: 학습 데이터에 단 한 번도 등장하지 않은 새로운 단어나 범주가 나타나면 우도가 \(0\)이 되어 다른 모든 결정적 증거를 무력화시킵니다. 이를 방지하기 위해 분자에 가상의 빈도 \(\alpha\)를 더하고 분모에 \(\alpha K\)를 더하는 라플라스 스무딩(Laplace Smoothing, \(\alpha=1\))을 필수로 적용해야 합니다.
- 데이터 유형별 3대 변형: 연속형 수치에는 정규분포를 가정하는 가우시안(Gaussian), 텍스트 단어 빈도에는 다항(Multinomial), 단어의 유무(0/1)에는 베르누이(Bernoulli) 나이브 베이즈를 적용합니다.
- 초고속 연산과 대용량 텍스트의 강자: 훈련 시간이 극단적으로 짧고 메모리 효율이 뛰어나, 스팸 메일 필터링, 감성 분석, 실시간 추천의 베이스라인 모델로 독보적인 위치를 차지합니다.
0. “스팸 메일 필터는 어떻게 0.001초 만에 스팸을 가려낼까?”
우리가 매일 사용하는 이메일 서비스는 매초 수만 건의 메일을 실시간으로 스캔하여 정상 메일과 스팸 메일을 칼같이 분류해 냅니다. 수만 개의 단어가 복잡하게 얽혀 있는 고차원 텍스트 데이터 속에서, 수십 층짜리 딥러닝 모델도 아닌 가장 단순한 확률 모델이 어떻게 30년 넘게 스팸 필터의 핵심 엔진으로 군림해 왔을까요?
그 주인공이 바로 나이브 베이즈 분류기(Naive Bayes Classifier)입니다.
이 모델의 이름에 왜 ’나이브(Naive, 순진한/단순한)’라는 다소 굴욕적인 형용사가 붙었는지, 그리고 그 순진한 가정이 어떻게 엄청난 속도와 기대 이상의 정확도를 낳는지 그 수학적 비밀을 파헤쳐 보겠습니다.
1. 베이즈 정리(Bayes’ Theorem): 사전 믿음의 사후 업데이트
나이브 베이즈의 심장은 18세기 영국의 통계학자이자 목사였던 토머스 베이즈(Thomas Bayes)가 정립한 조건부 확률의 역전 공식입니다.
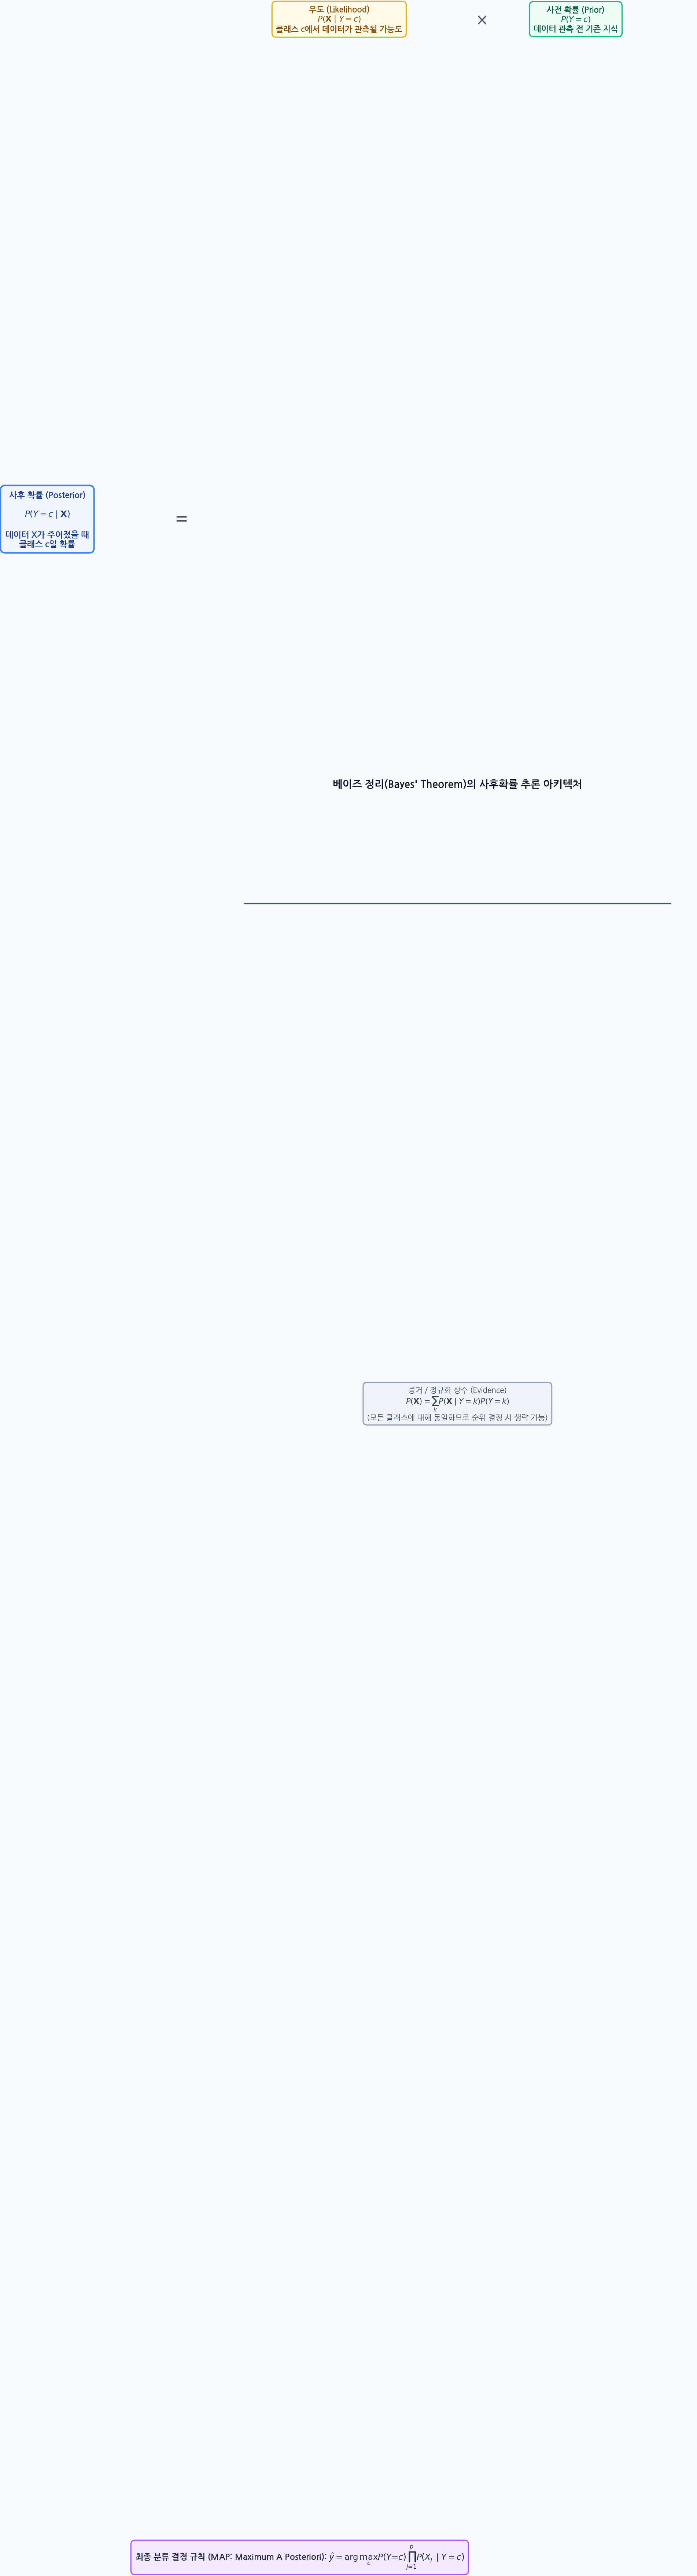
1-1. 베이즈 공식의 구성 요소
\[P(Y = c \mid \mathbf{X}) = \frac{P(\mathbf{X} \mid Y = c) \cdot P(Y = c)}{P(\mathbf{X})}\]
- 사후 확률 (Posterior Probability, \(P(Y=c \mid \mathbf{X})\)):
- 우리가 최종적으로 알고 싶은 확률입니다. 새로운 데이터(증거) \(\mathbf{X}\)가 관측되었을 때, 이 데이터가 클래스 \(c\)에 속할 확률입니다.
- 사전 확률 (Prior Probability, \(P(Y=c)\)):
- 데이터를 관측하기 전, 우리가 세상에 대해 이미 알고 있는 사전 지식 또는 클래스 비율입니다. (예: 전체 메일 중 30%가 스팸이라는 경험적 확률)
- 우도 / 가능도 (Likelihood, \(P(\mathbf{X} \mid Y=c)\)):
- 특정 클래스 \(c\)가 참이라고 가정했을 때, 현재 관측된 특성 \(\mathbf{X}\)가 나타날 확률입니다. (예: 스팸 메일 중에서 ’무료’나 ’대출’이라는 단어가 포함되어 있을 확률)
- 증거 / 한계 우도 (Evidence / Normalizing Constant, \(P(\mathbf{X})\)):
- 모든 가능한 클래스에서 데이터 \(\mathbf{X}\)가 관측될 전체 확률의 합입니다. \[P(\mathbf{X}) = \sum_{k} P(\mathbf{X} \mid Y=k) P(Y=k)\]
- 분모 \(P(\mathbf{X})\)는 모든 클래스에 대해 동일한 상수이므로, 클래스 간의 확률 순위를 비교하여 가장 큰 값을 고르는 결정 과정(MAP: Maximum A Posteriori)에서는 계산을 생략해도 무방합니다.
\[\boxed{P(Y = c \mid \mathbf{X}) \propto P(\mathbf{X} \mid Y = c) \times P(Y = c)}\]
\[\text{사후 확률} \propto \text{우도} \times \text{사전 확률}\]
2. 왜 “나이브(Naive)”인가? 조건부 독립 가정의 천재적 트릭
2-1. 완전 결합 확률이 직면하는 ‘차원의 저주’
설명변수가 \(p\)개인 다변량 데이터 \(\mathbf{X} = (X_1, X_2, \dots, X_p)\)가 주어졌을 때, 우도 \(P(\mathbf{X} \mid Y = c)\)를 엄밀하게 계산하려면 다음과 같은 결합 확률의 곱셈 법칙을 써야 합니다.
\[P(X_1, X_2, \dots, X_p \mid Y) = P(X_1 \mid Y) \cdot P(X_2 \mid X_1, Y) \cdots P(X_p \mid X_1, \dots, X_{p-1}, Y)\]
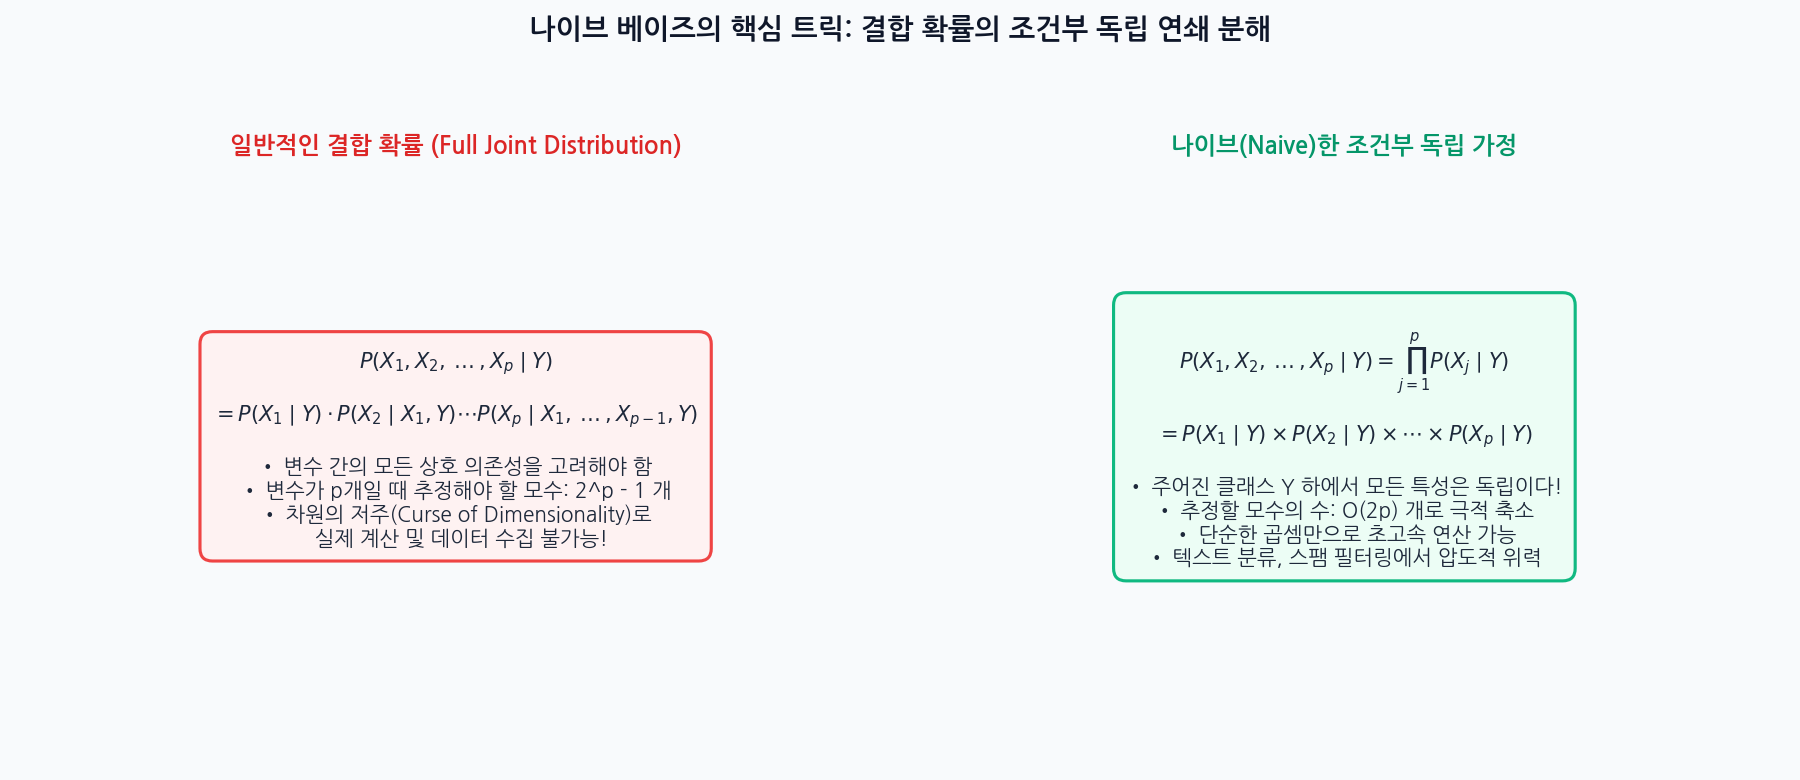
변수가 20개만 되어도 추정해야 할 조건부 확률의 경우의 수는 \(2^{20} \approx 100만\) 개로 폭발합니다. 지구상에 존재하는 어떤 데이터셋으로도 이 방대한 빈도표를 채울 수 없습니다.
2-2. 나이브 베이즈의 해법: 조건부 독립 (Conditional Independence)
여기서 나이브 베이즈는 대담하고 무모해 보이는 가정을 던집니다. “클래스 \(Y\)가 주어졌을 때, 모든 설명변수 \(X_1, X_2, \dots, X_p\)는 서로 완벽하게 독립이다!”
\[P(X_1, X_2, \dots, X_p \mid Y = c) = \prod_{j=1}^p P(X_j \mid Y = c) = P(X_1 \mid Y=c) \times P(X_2 \mid Y=c) \times \dots \times P(X_p \mid Y=c)\]
현실 세계에서 ’대출’이라는 단어와 ’이자’라는 단어는 강하게 연관되어 있으므로 둘이 독립이라는 것은 엄연한 거짓(False)입니다. 그래서 ’나이브(순진무구한)’라는 이름이 붙었습니다.
2-3. 왜 현실에서 이토록 잘 작동하는가?
통계학자들이 증명한 바에 따르면, 개별 확률값 자체는 독립 가정의 위배로 인해 과대/과소평가(오염)될 수 있지만, 두 클래스 간의 승패를 가르는 부등호의 방향(Ranking)은 거의 바뀌지 않습니다. 분류기의 목표는 정확한 절대 확률을 맞추는 것이 아니라 “A 클래스일 확률이 B 클래스보다 큰가?”를 판별하는 것이므로, 나이브 베이즈는 놀라울 정도로 견고한 실전 분류 성능을 보여줍니다.
3. 제로 빈도(Zero Frequency) 문제와 라플라스 스무딩
나이브 베이즈를 현업에 적용할 때 반드시 해결해야 하는 치명적인 버그가 있습니다. 바로 제로 빈도 문제입니다.
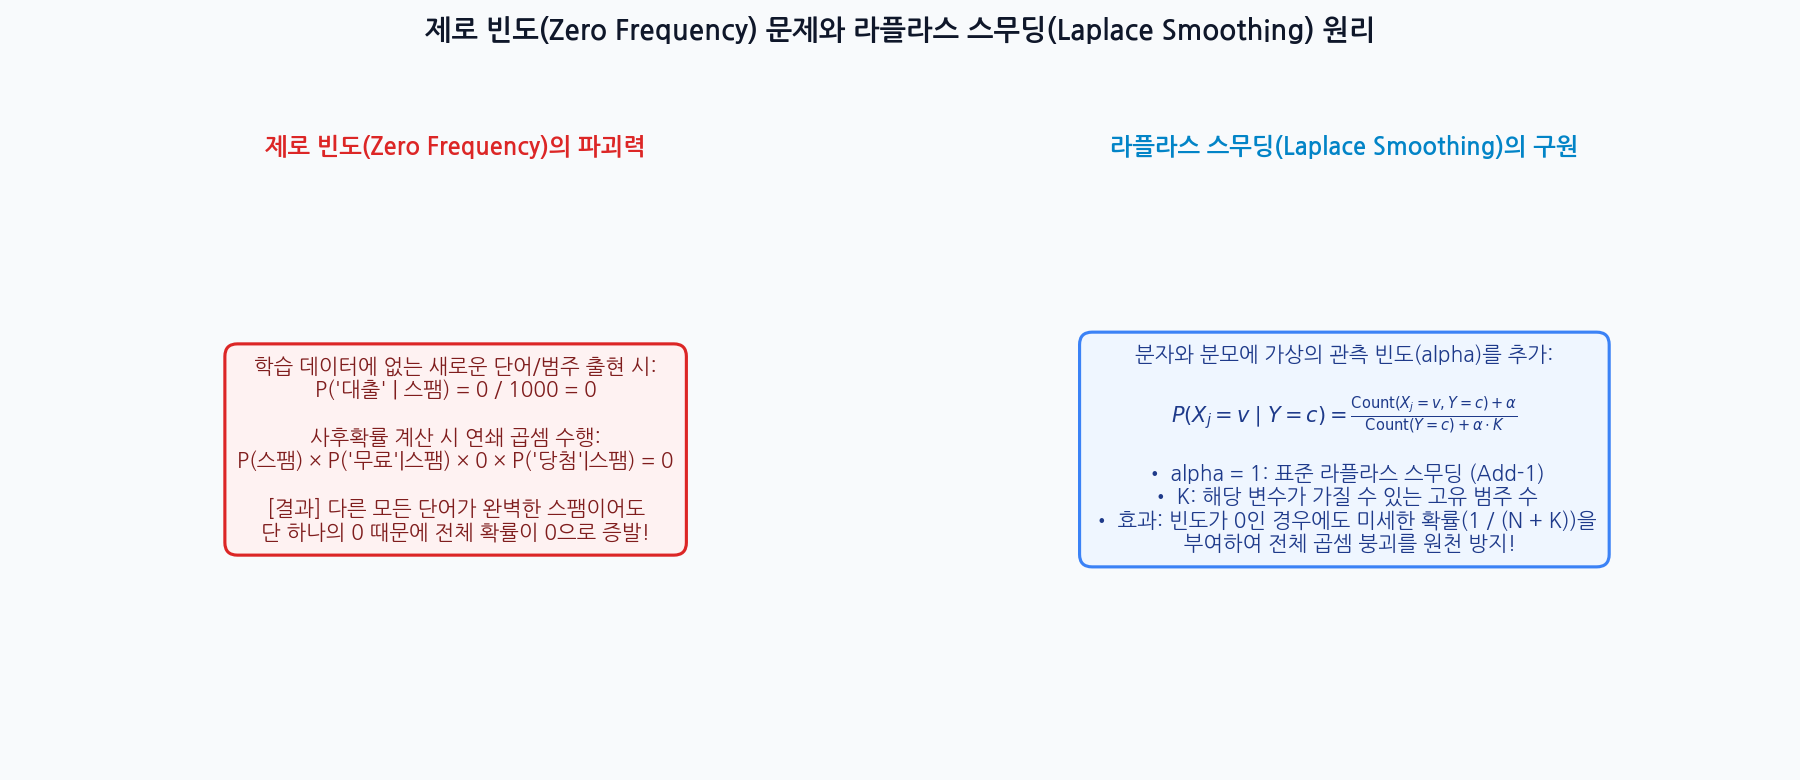
3-1. 0 하나가 모든 것을 지워버린다
어떤 이메일에 ‘카지노’, ‘로또’, ‘대출’, ’VIP’라는 전형적인 스팸 단어들이 가득합니다. 그런데 메일 끝에 ’반갑습니다’라는 단어가 하나 들어있다고 가정해 봅시다. 만약 과거 훈련 데이터의 스팸 메일 중에서 ’반갑습니다’라는 단어가 단 한 번도 등장한 적이 없다면:
\[P(\text{'반갑습니다'} \mid \text{스팸}) = \frac{0}{1000} = 0\]
사후확률은 모든 우도의 연속 곱셈이므로:
\[P(\text{스팸} \mid \text{메일}) \propto P(\text{스팸}) \times P(\text{'카지노'}\mid \text{스팸}) \times \dots \times \mathbf{0} = \mathbf{0}\]
다른 모든 단어가 99.9% 스팸임을 가리키고 있어도, 단 하나의 \(0\) 때문에 최종 스팸 확률이 완벽한 \(0\)으로 증발해 버립니다!
3-2. 라플라스 스무딩(Laplace Smoothing)의 원리
이 참사를 막기 위해 분자와 분모에 가상의 관측 빈도 \(\alpha\)를 더해주는 기법이 라플라스 스무딩(Add-\(\alpha\) Smoothing)입니다.
\[\boxed{P(X_j = v \mid Y = c) = \frac{\mathrm{Count}(X_j = v, Y = c) + \alpha}{\mathrm{Count}(Y = c) + \alpha \cdot K}}\]
- \(\alpha\): 스무딩 매개변수 (보통 \(\alpha = 1\) 적용, 이를 Add-1 스무딩이라 부름)
- \(K\): 해당 변수가 가질 수 있는 고유 범주(Vocabulary)의 총 개수
- 분모에 \(\alpha K\)를 더해주는 이유는 모든 범주에 대한 확률의 합이 정확히 \(1\)이 되도록 정규화하기 위함입니다.
- 이제 빈도가 0이었던 단어도 최소한 \(\frac{1}{N + K}\)라는 미세한 확률을 부여받아, 곱셈 전체가 0으로 무너지는 비극을 완벽하게 방지합니다.
4. 데이터 유형에 따른 나이브 베이즈 3대 변형
데이터의 속성에 따라 우도 \(P(X_j \mid Y)\)를 추정하는 확률분포가 다릅니다.
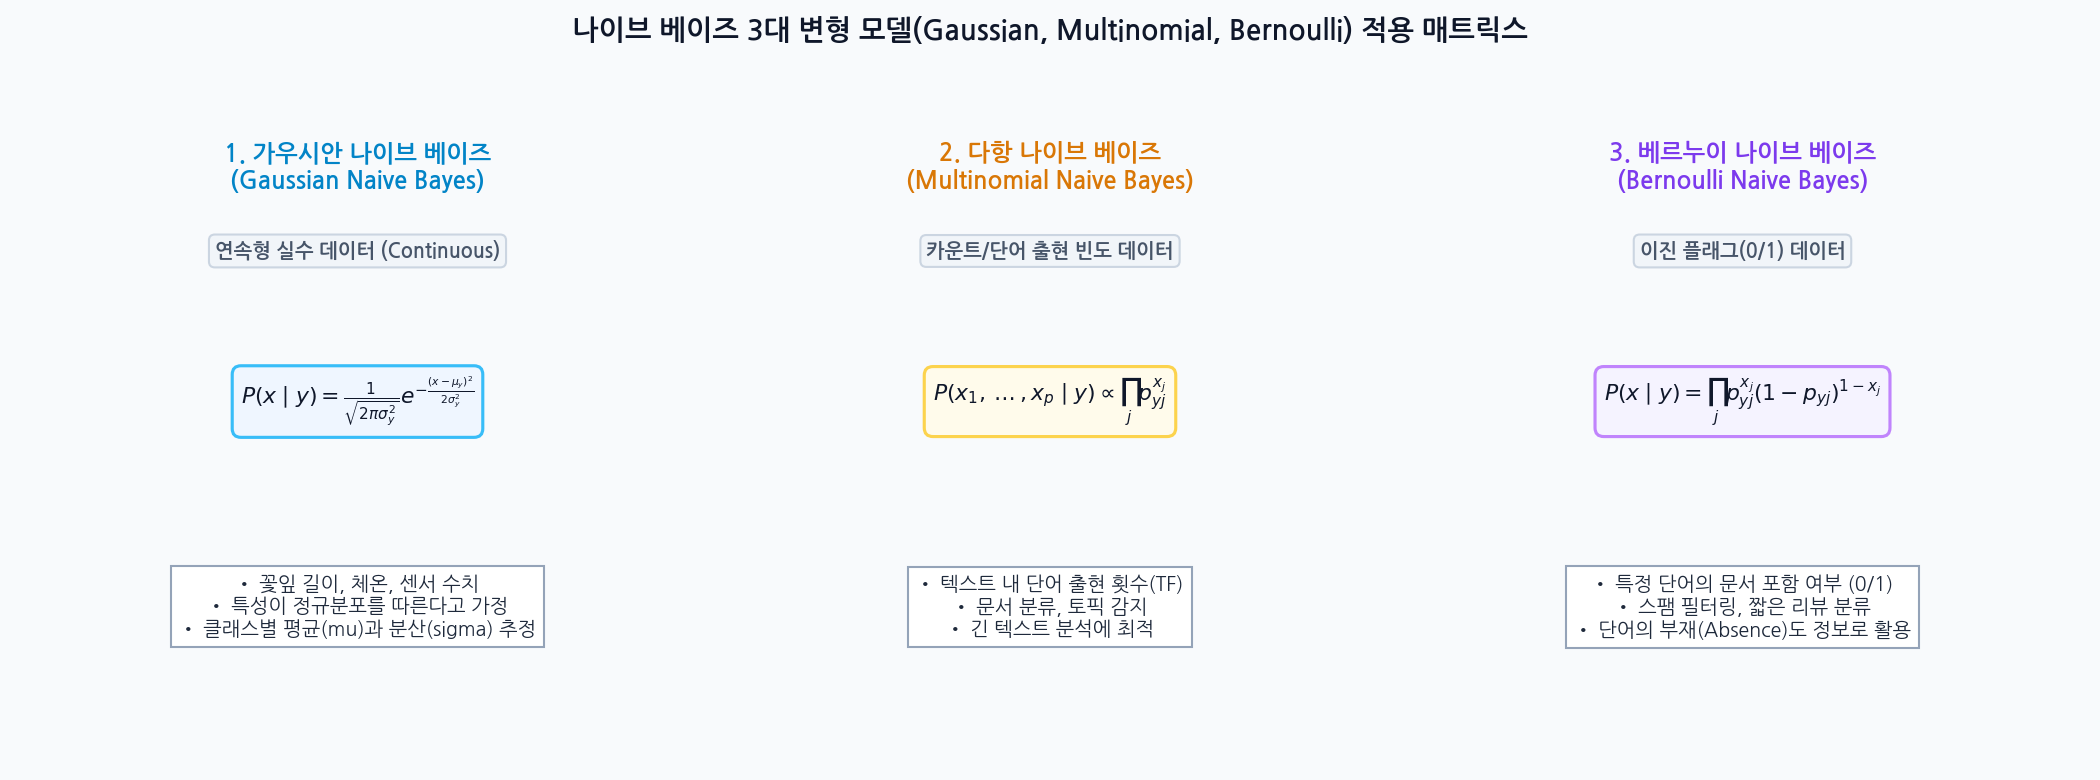
4-1. 3대 변형 모델 비교표
| 모델 유형 | 입력 데이터 형태 | 우도 추정 분포 | 주요 적용 분야 |
|---|---|---|---|
| 1. 가우시안 (Gaussian NB) | 연속형 실수 (Continuous) (키, 체중, 온도, 꽃잎 길이) |
정규분포(Gaussian) \(P(x \mid c) = \frac{1}{\sqrt{2\pi\sigma_c^2}} e^{-\frac{(x - \mu_c)^2}{2\sigma_c^2}}\) |
센서 데이터, 의학 임상 수치, 금융 지표 분류 |
| 2. 다항 (Multinomial NB) | 이산형 빈도 카운트 (Counts) (단어 출현 횟수, TF 값) |
다항분포 (Multinomial) \(P(\mathbf{x} \mid c) \propto \prod p_{cj}^{x_j}\) |
장문 텍스트 분류, 뉴스 기사 카테고리 분류 |
| 3. 베르누이 (Bernoulli NB) | 이진 플래그 (Binary, 0/1) (단어 포함 여부, 기능 사용 여부) |
베르누이분포 (Bernoulli) \(P(\mathbf{x} \mid c) = \prod p_{cj}^{x_j} (1 - p_{cj})^{1 - x_j}\) |
단문 리뷰 감성 분석, 스팸 필터링 (단어 부재도 반영) |
5. 실전 R 실습: 항공편 지연(FlightDelays) 데이터 분류 파이프라인
미국 주요 공항의 항공편 지연 데이터를 바탕으로, 나이브 베이즈 모델을 학습시키고 조건부 확률표, 예측 확률, 혼동행렬, Gain/Lift 차트를 산출하는 엔드투엔드 R 템플릿입니다.
#######################################################
# 나이브 베이즈 분류기 실전 완전 정복 파이프라인
#######################################################

suppressPackageStartupMessages({
  library(e1071)
  library(caret)
  library(gains)
  library(tidyverse)
})

# 1. 예제 데이터 생성 (항공편 지연 가상 데이터)
set.seed(42)
n <- 1200
day_week <- sample(c("MON","TUE","WED","THU","FRI","SAT","SUN"), n, replace = TRUE)
dep_time <- sample(c("Morning", "Afternoon", "Evening", "Night"), n, replace = TRUE)
carrier  <- sample(c("AA", "UA", "DL", "WN"), n, replace = TRUE)
dest     <- sample(c("JFK", "ORD", "LAX", "ATL"), n, replace = TRUE)

# 지연 여부(Flight.Status) 생성 (금요일, 저녁 시간대에 지연 확률 증가)
delay_prob <- 0.15 + 0.20 * (day_week == "FRI") + 0.15 * (dep_time == "Evening") + 0.10 * (carrier == "WN")
flight_status <- ifelse(runif(n) < delay_prob, "delayed", "ontime")

delays_df <- data.frame(
  DAY_WEEK = factor(day_week),
  DEP_TIME = factor(dep_time),
  CARRIER  = factor(carrier),
  DEST     = factor(dest),
  Flight.Status = factor(flight_status)
)

cat("=== 1. 데이터셋 구조 및 타겟 분포 ===\n")
str(delays_df)
print(table(delays_df$Flight.Status))

# 2. 훈련 데이터와 검증 데이터 분할 (Train 70% : Valid 30%)
train_idx <- createDataPartition(delays_df$Flight.Status, p = 0.7, list = FALSE)
train_df  <- delays_df[train_idx, ]
valid_df  <- delays_df[-train_idx, ]

# 3. 나이브 베이즈 모델 적합 (라플라스 스무딩 laplace = 1 적용)
nb_model <- naiveBayes(Flight.Status ~ ., data = train_df, laplace = 1)
cat("\n=== 2. 나이브 베이즈 학습 모델 요약 ===\n")
print(nb_model)

# 💡 모델 출력 해독:
# - A-priori probabilities: 사전확률 P(delayed) vs P(ontime)
# - Conditional probabilities: 각 변수 범주별 조건부확률 P(Feature | delayed)

# 4. 특정 변수(요일)에 대한 조건부 확률표 정밀 확인
cat("\n=== 3. 요일별 조건부 확률표 (prop.table) ===\n")
tab_day <- table(train_df$Flight.Status, train_df$DAY_WEEK)
prop_day <- prop.table(tab_day, margin = 1) # 행 기준(클래스별) 백분율
print(round(prop_day, 3))

# 5. 검증 데이터셋 예측 (클래스 및 사후확률값 동시 산출)
pred_class <- predict(nb_model, newdata = valid_df, type = "class")
pred_prob  <- predict(nb_model, newdata = valid_df, type = "raw")

cat("\n=== 4. 검증 데이터 예측 결과 샘플 (사후확률) ===\n")
head_results <- data.frame(
  Actual = valid_df$Flight.Status,
  Predicted = pred_class,
  Prob_delayed = round(pred_prob[, "delayed"], 4),
  Prob_ontime  = round(pred_prob[, "ontime"], 4)
)
print(head(head_results, 6))

# 6. 혼동 행렬(Confusion Matrix) 및 분류 메트릭 평가
cat("\n=== 5. 모델 평가 (Confusion Matrix) ===\n")
cm <- confusionMatrix(pred_class, valid_df$Flight.Status, positive = "delayed")
print(cm$table)
cat("\n정확도 (Accuracy):", round(cm$overall["Accuracy"], 4), "\n")
cat("민감도 (Recall/Sensitivity):", round(cm$byClass["Sensitivity"], 4), "\n")
cat("정밀도 (Precision):", round(cm$byClass["Precision"], 4), "\n")
cat("F1-Score:", round(cm$byClass["F1"], 4), "\n")

# 7. 비즈니스 의사결정을 위한 누적 획득(Gain) 및 향상도(Lift) 분석
binary_actual <- ifelse(valid_df$Flight.Status == "delayed", 1, 0)
gain_obj <- gains(binary_actual, pred_prob[, "delayed"], groups = 10)

cat("\n=== 6. 향상도(Lift) 테이블 ===\n")
lift_summary <- data.frame(
  Decile = 1:10,
  Depth_Pct = gain_obj$depth,
  Cum_Gain_Pct = round(gain_obj$cume.pct.of.total * 100, 1),
  Lift = round(gain_obj$lift / 100, 2)
)
print(lift_summary)
6. 실무 체크리스트 및 결론
나이브 베이즈는 “단순함이 복잡함을 이긴다”는 오컴의 면도날 법칙을 가장 명쾌하게 증명하는 알고리즘입니다.
┌─────────────────────────────────────────────────────────────┐
│             [ 실무 나이브 베이즈 6대 핵심 체크리스트 ]         │
├─────────────────────────────────────────────────────────────┤
│ [ ] 1. 데이터 특성에 맞는 변형(Gaussian, Multinomial 등)을 택했는가?│
│ [ ] 2. 제로 빈도 방지를 위해 라플라스 스무딩(laplace=1)을 켰는가?│
│ [ ] 3. 범주형 변수가 R에서 올바르게 factor형으로 변환되었는가?  │
│ [ ] 4. type='raw'를 통해 사후확률값을 추출하고 신뢰도를 검토했는가?│
│ [ ] 5. 불균형 데이터셋에서 사전확률(Prior) 편향을 확인했는가?   │
│ [ ] 6. 변수 간 상관성이 극단적으로 높다면 차원축소(PCA)를 검토했는가?│
└─────────────────────────────────────────────────────────────┘
복잡한 앙상블이나 딥러닝으로 넘어가기 전, 가장 먼저 나이브 베이즈로 탄탄한 베이스라인(Baseline)을 구축해 보십시오. 초당 수십만 건의 예측을 처리해야 하는 실시간 시스템에서 나이브 베이즈는 언제나 가장 든든하고 강력한 무기가 되어 줄 것입니다.