flowchart LR
    A["원시 데이터<br/>(Raw Data)"] --> B["EDA<br/>(데이터 탐색)"]
    B --> C["데이터 정제<br/>(Cleaning)"]
    C --> D["특성공학<br/>(Feature Eng.)"]
    D --> E["모델링<br/>(Modeling)"]
    E --> F["성능 평가<br/>(Evaluation)"]

    B -. "결함 식별" .-> C
    B -. "상관·상호작용 발견" .-> D
    B -. "선형·비선형 힌트" .-> E

    style A fill:#f8f9fa,stroke:#6c757d
    style B fill:#e0f2fe,stroke:#0284c7,stroke-width:2px
    style C fill:#fef3c7,stroke:#d97706
    style D fill:#ede9fe,stroke:#7c3aed
    style E fill:#fce7f3,stroke:#db2777
    style F fill:#dcfce7,stroke:#16a34a,stroke-width:2px
머신러닝이나 통계 분석 프로젝트를 진행할 때 수많은 초심자가 저지르는 가장 흔한 실수는 수집한 원시 데이터를 곧바로 복잡한 모델(XGBoost, Random Forest, 신경망 등)에 밀어 넣는 것입니다. 그러나 데이터의 품질과 구조에 대한 면밀한 검토 없이 학습된 모델은 영점 조절이 되지 않은 저울이나 왜곡된 렌즈와 같습니다.
“쓰레기를 넣으면 쓰레기가 나온다(Garbage In, Garbage Out).”
데이터 사이언스의 세계에서 이 격언은 결코 과장이 아닙니다. 데이터를 모델에 투입하기 전, 시각화와 기술통계를 활용해 데이터의 골격, 결측치, 이상치, 분포 형태, 변수 간 잠재적 관계를 다각도로 검증하는 탐색적 데이터 분석(EDA, Exploratory Data Analysis)은 분석의 성패를 결정짓는 핵심 관문입니다.
실무 현장에서 즉시 적용할 수 있는 체계적인 EDA의 단계별 워크플로와 통계적 기법, 그리고 흔히 빠지기 쉬운 함정과 데이터 누수 방지 원칙을 상세히 정리해 드립니다.
1. EDA의 본질과 데이터 사이언스 피드백 루프
EDA는 단순히 예쁜 그래프를 그리는 시각화 작업이 아닙니다. 데이터에 내재된 잠재적 결함을 식별하고, 최적의 데이터 정제(Data Cleaning), 변수 변환(Transformation), 특성공학(Feature Engineering), 알고리즘 선정(Model Selection)을 위한 과학적 근거를 수립하는 과정입니다.
실제 데이터 사이언스 프로젝트에서 EDA는 일회성 단계가 아닙니다. 위 흐름도처럼 각 분석 단계와 끊임없이 상호작용하는 반복적 피드백 루프를 가집니다.
- 결측치·이상치 발견: 원시 데이터 수집 센서의 오작동이나 전산 누락을 파악하여 정제 규칙 수립
- 심한 왜도(Skewness) 발견: 한쪽으로 쏠린 분포를 정규분포에 가깝게 교정하는 로그 변환 등의 방법론 채택
- 비선형 관계 포착: 단순 선형 회귀 대신 다항 회귀, 트리 모델, 서포트 벡터 머신 등 비선형 모델로 선회
- 다중공선성(Multicollinearity) 경고: 독립변수 간 과도한 상관관계를 감지하여 VIF 진단 및 특성 선택 유도
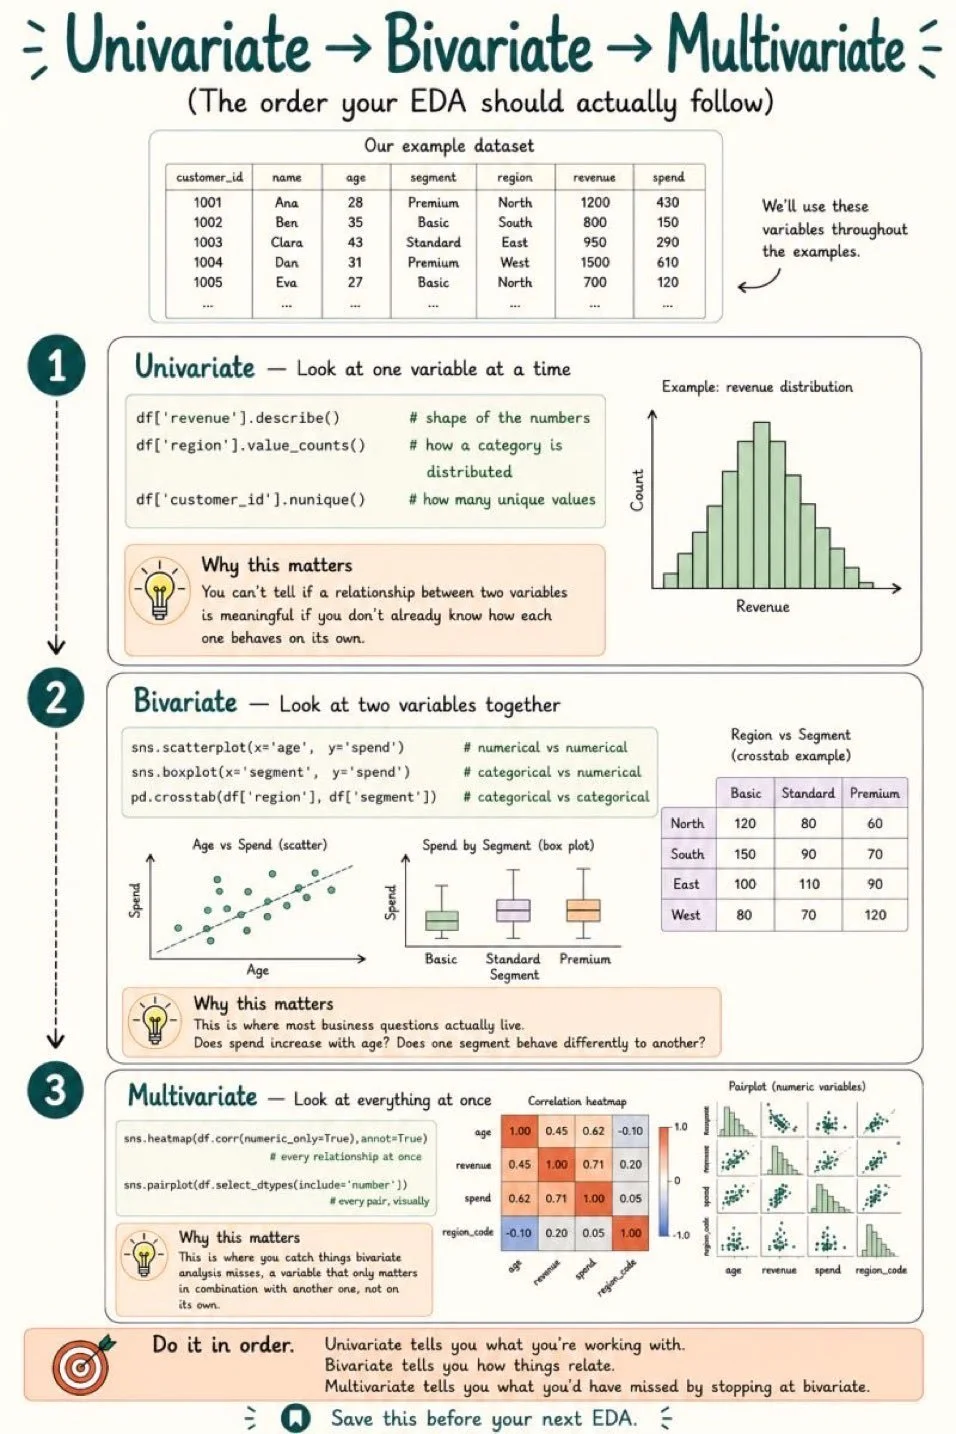
2. 1단계: Data Overview — 전체 구조와 중심경향성 진단
새로운 데이터셋을 확보했을 때 가장 먼저 실행해야 하는 기본 점검은 데이터의 물리적 규모(차원)와 컬럼별 자료형, 그리고 중심경향성을 확인하는 일입니다.
2.1 데이터의 차원과 샘플 확인
| Pandas 명령어 | 점검 목적 | 실무적 의미 |
|---|---|---|
df.shape |
(행 수 N, 열 수 p) 파악 |
표본 수 대비 특성 수의 비율 진단 (차원의 저주 여부 확인) |
df.head(5) |
초기 5개 관측치 확인 | 실제 데이터 적재 포맷 및 구분자 이상 여부 검토 |
df.info() |
컬럼명, Non-Null 수, Dtype | 메모리 사용량 및 수치형/문자형 자료형 오인 여부 점검 |
df.describe() |
수치형 기술통계 요약 | 중심경향성, 산포도, 사분위수, 최솟값·최댓값 범위 조망 |
⚠️ 주의: 숫자로 표기된 범주형 변수의 함정
고객 식별자(Customer_ID), 우편번호(10001), 상품 분류 코드(1,2,3) 등은 데이터베이스에 숫자로 저장되어 있어도 덧셈이나 평균 연산이 불가능한 명목형 범주 변수(Categorical Variable)입니다.df.info()단계에서 이러한 변수를 조기에 발견하여 범주형(category또는object)으로 전환해야 기술통계 왜곡을 방지할 수 있습니다.
2.2 중심경향성의 3대 척도와 이상치 취약성
데이터를 대표하는 하나의 중심값을 설정할 때는 데이터의 분포 형태에 따라 통계량을 신중하게 선택해야 합니다.
- 산술평균 (Arithmetic Mean, \(\bar{x}\)): \[\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i\]
- 모든 데이터를 연산에 반영하므로 정보 손실이 적습니다.
- 단, 극단적인 이상치(Outlier)에 대단히 취약합니다. 예를 들어 연봉 데이터가
[3000, 3200, 3500, 4000, 100000]일 때, 1명 때문에 평균이 22,740만 원으로 치솟아 대다수 일반인의 상황을 전혀 대변하지 못합니다.
- 중앙값 (Median):
- 데이터를 크기순으로 정렬했을 때 정확히 \(50\%\) 지점에 위치한 값입니다.
- 극단치에 영향을 받지 않는 로버스트(Robust, 강건한) 척도입니다. 비대칭 분포나 이상치가 포함된 현실 세계의 금융, 임금, 자산 데이터 분석에서 가장 신뢰할 수 있는 중심값입니다.
- 최빈값 (Mode):
- 데이터셋 내에서 가장 빈번하게 등장한 값입니다. 명목형 및 순서형 범주 변수의 중심 위치를 파악하는 유일한 지표입니다.
3. 2단계: 결측치(Missing Value) 진단과 메커니즘 분석
결측치는 시스템 장애, 사용자의 응답 거부, 전송 오류 등 다양한 원인으로 발생합니다. 결측치를 단순히 일괄 삭제하거나 평균으로 채워 넣는 것은 심각한 정보 왜곡을 초래합니다.
3.1 결측 메커니즘의 3대 유형
통계학자 도널드 루빈(Donald Rubin)이 정립한 결측 데이터 메커니즘을 이해하면 결측 원인에 맞는 올바른 전처리 전략을 수립할 수 있습니다.
flowchart TD
    Start{결측 발생 원인이<br/>다른 변수나 본래 값과 관련 있는가?}

    Start -->|전혀 무관함| MCAR["MCAR (완전 무작위 결측)<br/>데이터 누락이 완전한 우연임<br/>예: 통신 장애로 무작위 손실"]
    Start -->|관측된 다른 변수와 연관됨| MAR["MAR (무작위 결측)<br/>다른 변수의 특성으로 결측 설명 가능<br/>예: 남성이 여성보다 우울증 설문 무응답 높음"]
    Start -->|누락된 본래 값 자체와 연관됨| MNAR["MNAR (비무작위 결측)<br/>숨기려는 값 자체가 결측을 유발<br/>예: 초고소득자의 재산 설문 거부"]

    style MCAR fill:#dcfce7,stroke:#16a34a,stroke-width:2px
    style MAR fill:#fef3c7,stroke:#d97706,stroke-width:2px
    style MNAR fill:#fee2e2,stroke:#dc2626,stroke-width:2px
- MCAR (Missing Completely at Random): 결측 발생 확률이 관측된 변수나 관측되지 않은 변수 모두와 무관한 경우입니다. 단순 행 삭제(Listwise Deletion)를 수행해도 표본 편향이 발생하지 않습니다.
- MAR (Missing at Random): 결측 발생 여부가 누락된 변수 자체와는 무관하지만, 이미 수집된 다른 변수와 통계적 상관을 가지는 경우입니다. 조건부 회귀 대치나 KNN 대치 등 모델 기반 보완이 효과적입니다.
- MNAR (Missing Not at Random): 누락된 값 자체가 결측을 유발한 경우입니다. 단순 대치를 적용하면 심각한 추정 편향이 발생하므로, ’결측 여부 자체를 나타내는 지시 변수(Indicator)’를 새로 생성해 피처로 활용해야 합니다.
3.2 결측치 처리 전략 3단계
결측치 대응 프로세스
 ├── 1. Drop (삭제)
 │    ├── 행 삭제: 결측률 < 3% 미만이며 MCAR이 명확할 때
 │    └── 열 삭제: 결측률 > 60% 이상으로 정보 가치가 상실되었을 때
 ├── 2. Impute (통계적/모델 대치)
 │    ├── 수치형 정규분포: 평균(Mean) 대치
 │    ├── 수치형 왜도/이상치: 중앙값(Median) 대치
 │    ├── 범주형: 최빈값(Mode) 대치 또는 "Unknown" 카테고리화
 │    ├── 시계열 데이터: 선형 보간(Interpolation) 또는 직전값(ffill)
 │    └── 복합 연관 변수: IterativeImputer (MICE) 또는 KNNImputer
 └── 3. Missing Indicator (결측 지표 생성)
      └── 결측 여부 자체를 1과 0의 이진 피처로 보존하여 모델에 정보 제공
4. 3단계: 단변량 분석(Univariate)과 분포 형태 진단
단변량 분석은 다른 변수와의 상호작용을 배제하고, 하나의 변수가 지닌 고유한 산포와 확률 분포를 집중적으로 관찰하는 작업입니다.
4.1 수치형 변수의 히스토그램과 KDE(커널 밀도 추정)
- 히스토그램 (Histogram): 구간(Bin)의 크기에 따라 분포의 형상이 크게 달라질 수 있으므로, 적절한 Bin 수(Sturges 공식 또는 Freedman-Diaconis 규칙)를 적용해야 합니다.
- KDE Plot: 히스토그램의 불연속성을 극복하고 가우시안 커널을 통해 연속적인 확률밀도함수를 추정합니다. 대역폭(Bandwidth)이 너무 작으면 노이즈가 과적합되고, 너무 크면 다봉성(Multimodal) 정보가 뭉개집니다.
4.2 왜도(Skewness)와 비대칭 분포의 교정
왜도는 분포가 평균을 기준으로 좌우 대칭인지, 어느 쪽으로 꼬리가 길게 늘어져 있는지를 나타내는 지표입니다.
\[\text{Skewness} = \frac{\sum_{i=1}^{n} (x_i - \bar{x})^3}{(n-1) s^3}\]
[1. Right-Skewed / Positive Skew]       [2. Left-Skewed / Negative Skew]
            Mode                                             Mode
           /    \                                           /    \
          / Median\                                       /Median \
         /         Mean                                  Mean      \
        /            ───► 꼬리가 오른쪽으로 김      꼬리가 왼쪽으로 김 ◄─── \
   ────┴───────────────────────                ────────────────────────┴────
   최빈값 < 중앙값 < 평균                          평균 < 중앙값 < 최빈값
(예: 연봉, 부동산 가격, 방문자수) (예: 수명, 쉬운 시험 점수)- 오른쪽 왜도 (Right-Skewed, Skewness > 0):
- 꼬리가 오른쪽(양수 방향)으로 길게 늘어지며, 이상치로 인해 \(\text{Mean} > \text{Median} > \text{Mode}\) 관계가 성립합니다.
- 선형 모델이나 회귀 모델은 정규분포를 가정하므로, 심한 오른쪽 왜도 데이터는 로그 변환(\(\log(x)\) 또는 \(\log(1+x)\))이나 제곱근 변환(\(\sqrt{x}\))을 통해 대칭에 가깝게 펴주어야 모델의 잔차 가정을 충족할 수 있습니다.
- 왼쪽 왜도 (Left-Skewed, Skewness < 0):
- 꼬리가 왼쪽으로 늘어지며 \(\text{Mean} < \text{Median} < \text{Mode}\) 형태를 보입니다. 지수 변환(\(e^x\))이나 박스-콕스(Box-Cox) 변환을 적용합니다.
5. 4단계: 이변량 및 다변량 분석(Bivariate & Multivariate)
두 개 이상의 변수가 결합할 때 나타나는 상관성, 종속성, 그룹 간 차이를 규명합니다.
| 분석 유형 | 변수 조합 | 시각화 도구 | 통계적 가설검정 기법 |
|---|---|---|---|
| 수치형 × 수치형 | 연속형 변수 2개 | 산점도(Scatter Plot), 육각 빈 플롯 | 피어슨(Pearson) 및 스피어만(Spearman) 상관계수 |
| 범주형 × 수치형 | 그룹 변수 + 연속형 변수 | 박스 플롯(Box Plot), 바이올린 플롯 | 두 집단 t-검정 또는 세 집단 이상 ANOVA |
| 범주형 × 범주형 | 범주형 변수 2개 | 분할 막대 차트, 히트맵 | 교차분석표 및 카이제곱 독립성 검정 |
5.1 상관계수 해석 시 주의할 3대 원칙
- 피어슨 상관계수(\(r\))는 ’선형 관계’만을 측정합니다:
\(U\)자형이나 원형 등 비선형적인 관계가 뚜렷해도 피어슨 상관계수는 \(0\)에 가깝게 계산될 수 있습니다. 반드시 산점도를 눈으로 확인해야 합니다. - 이상치에 대한 취약성:
단 하나의 극단적인 이상치 때문에 상관계수가 \(0.1\)에서 \(0.8\)로 부풀려지거나 반대로 상쇄될 수 있습니다. 비모수적 순위 상관계수인 스피어만(Spearman) \(\rho\)를 교차 검증해야 합니다. - 상관관계는 인과관계를 의미하지 않습니다:
여름철 아이스크림 판매량과 익사 사고 발생률은 강한 양의 상관관계를 보이지만, 이는 ’폭염’이라는 제3의 교란 변수(Confounder)가 만들어낸 가짜 상관(Spurious Correlation)입니다.
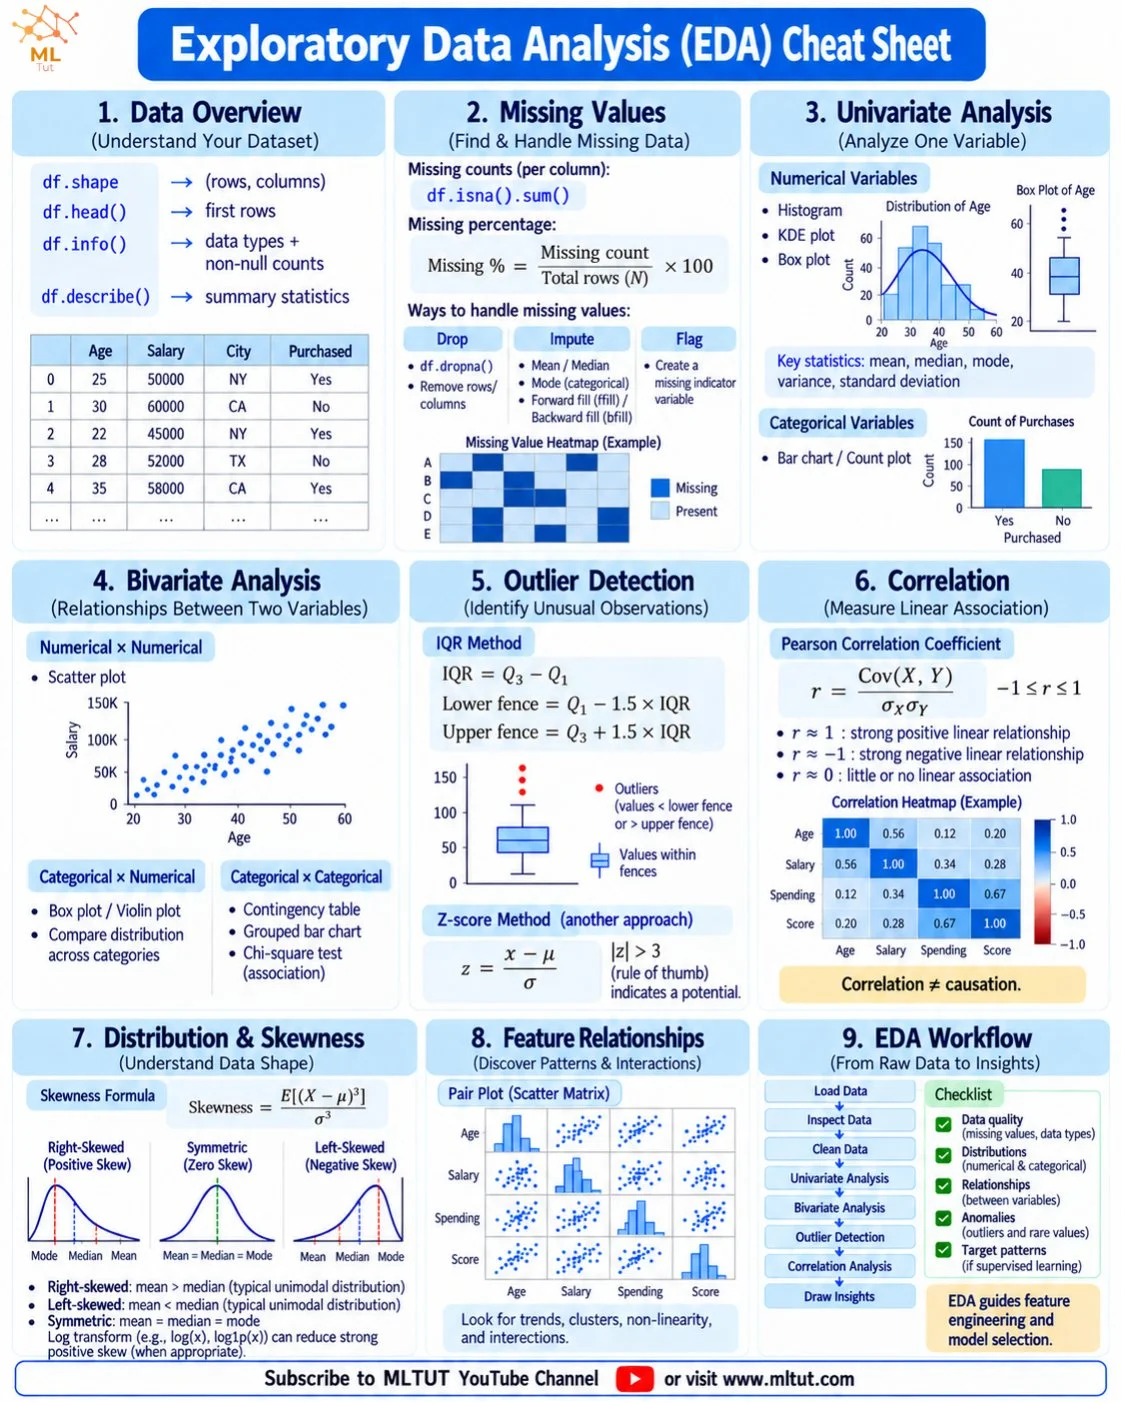
6. 5단계: 이상치(Outlier)의 본질과 수학적 탐색
이상치는 무조건 삭제해야 할 불량 데이터가 아닙니다. 이상치는 크게 두 부류로 엄격히 분리하여 대응해야 합니다.
- 오류성 이상치 (Measurement Error):
- 기입 실수(나이 999세), 단위 오기(cm를 m로 입력), 센서 단락 등
- 조치: 원천 데이터 확인 후 정정하거나 결측 처리 후 대치/제거
- 유의미한 이상치 (True Novelty / Rare Event):
- 신용카드 이상 금융 거래(FDS), 희귀 질환 유전자 변이, VIP 고객의 특이 구매 패턴
- 조치: 모델이 반드시 학습해야 할 핵심 신호이므로 보존. 이상치에 민감한 트리 기반 앙상블 모델(
RandomForest,LightGBM)이나 로버스트 회귀를 적용
6.1 IQR(사분위범위) 기반 탐색 (Tukey’s Fences)
정규분포 가정을 요구하지 않는 가장 대중적인 비모수적 이상치 탐색 공식입니다.
\[\text{IQR} = Q_3 - Q_1\] \[\text{하한선 (Lower Fence)} = Q_1 - 1.5 \times \text{IQR}\] \[\text{상한선 (Upper Fence)} = Q_3 + 1.5 \times \text{IQR}\]
- 하한선보다 작거나 상한선보다 큰 관측치를 잠재적 이상치로 식별합니다. 극단적 이상치는 \(3.0 \times \text{IQR}\)을 기준으로 판정하기도 합니다.
6.2 Z-Score 기반 탐색
데이터가 정규분포를 따를 때, 각 데이터가 평균에서 표준편차의 몇 배만큼 떨어져 있는지를 계산합니다.
\[Z = \frac{x_i - \mu}{\sigma}\]
- 통상적으로 \(|Z| > 3\) (표준편차 3배 초과 영역)에 위치하는 데이터(상하위 \(0.27\%\))를 이상치로 분류합니다.
- 데이터가 비대칭 왜도를 가질 때는 중앙값과 MAD(Median Absolute Deviation)를 기반으로 한 Modified Z-Score를 사용하는 것이 안전합니다.
7. 실무 필수 5대 EDA 체크리스트와 안티패턴 방지
EDA를 수행할 때 데이터 사이언티스트가 반드시 체크해야 할 5가지 점검 목록입니다.
[실무 필수 5대 EDA 체크리스트]
 1. 데이터 누수(Data Leakage) 차단:
    Train / Test 분할 전에 전체 데이터로 평균 대치나 스케일링을 수행했는가? (절대 금지!)
 2. 클래스 불균형(Class Imbalance) 감지:
    타깃 변수의 비율이 95:5처럼 극단적으로 쏠려 있지 않은가?
 3. 타깃 상관관계 및 예측력 확인:
    어떤 특성이 타깃 변수와 가장 유의미한 변별력을 지니는가?
 4. 다중공선성(Multicollinearity) 점검:
    독립변수끼리 상관계수 > 0.85 이상으로 얽혀 계수 추정을 방해하지 않는가?
 5. 시간축/그룹별 데이터 드리프트(Drift):
    수집 기간이나 지역에 따라 통계량의 평균/분산이 급격히 변하지 않는가?
🚨 흔히 범하는 안티패턴: Train/Test 분할 전 전처리
많은 실무자가 전체 데이터셋에 대해 df.fillna(df.mean())이나 StandardScaler()를 먼저 돌린 뒤 train_test_split을 실행합니다.
이는 테스트 데이터의 정보(평균과 표준편차)가 훈련 데이터로 유출되는 치명적인 데이터 누수(Data Leakage)입니다. 이렇게 훈련된 모델은 로컬 평가에서는 경이로운 성능을 보이지만, 실제 운영 서버에 배포되는 순간 참담한 성능 폭락을 겪게 됩니다. 모든 대치 및 변환 기준은 오직 훈련 세트(Train Set)로부터 학습된 파라미터만을 사용해야 합니다.
8. 실전 파이썬 EDA 표준 코드 템플릿
현업에서 빠르게 데이터의 전반적 상태를 스캔할 수 있는 압축 파이썬 코드입니다.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

# 1. 종합 데이터 개요 요약 함수
def summarize_dataframe(df):
    summary = pd.DataFrame({
        'Dtype': df.dtypes,
        'Null_Count': df.isna().sum(),
        'Null_Pct(%)': (df.isna().mean() * 100).round(2),
        'N_Unique': df.nunique(),
        'Skewness': [df[col].skew() if pd.api.types.is_numeric_dtype(df[col]) else np.nan for col in df.columns]
    })
    return summary

# 2. IQR 이상치 카운트 함수
def detect_iqr_outliers(df, col):
    q1 = df[col].quantile(0.25)
    q3 = df[col].quantile(0.75)
    iqr = q3 - q1
    lower_bound = q1 - 1.5 * iqr
    upper_bound = q3 + 1.5 * iqr
    outliers = df[(df[col] < lower_bound) | (df[col] > upper_bound)]
    print(f"[{col}] Outliers Count: {len(outliers)} ({len(outliers)/len(df)*100:.2f}%)")
    return outliers

# 3. 상관관계 히트맵 시각화
def plot_correlation_matrix(df):
    numeric_df = df.select_dtypes(include=[np.number])
    corr = numeric_df.corr(method='spearman')
    mask = np.triu(np.ones_like(corr, dtype=bool))

    plt.figure(figsize=(10, 8))
    sns.heatmap(corr, mask=mask, annot=True, fmt=".2f", cmap='coolwarm',
                vmin=-1, vmax=1, cbar_kws={"shrink": .8})
    plt.title("Spearman Correlation Matrix", fontsize=14)
    plt.tight_layout()
    plt.show()
9. 요약: 한눈에 보는 EDA 핵심 원칙
- 선입견 없는 관찰: 사전에 세운 가설에 데이터를 억지로 끼워 맞추지 말고, 데이터가 스스로 보여주는 분포와 결핍을 겸허하게 확인합니다.
- 시각화와 수치의 상호보완: 요약통계 수치(평균, 상관계수)만 믿지 말고 산점도와 박스플롯으로 가시화하여 앤스컴 콰르텟(Anscombe’s Quartet)의 함정을 피합니다.
- 도메인 맥락 중심의 정제: 이상치나 결측치는 기계적인 삭제 대상이 아니며, 비즈니스 현장의 실제 맥락을 고려해 보존 또는 변환 여부를 결정합니다.