비즈니스 현장에서 우리가 마주하는 데이터의 대다수는 정답 라벨(Target Label)이 존재하지 않습니다. 수십만 명의 고객 구매 이력, 수천 대의 공장 센서 로그, 웹사이트 방문자들의 내비게이션 경로에는 “이 고객은 VIP다”, “이 센서는 이상 징후다”라는 꼬리표가 미리 붙어있지 않습니다.
이처럼 아무런 사전 지식이나 정답이 없는 거친 데이터 속에서 “본질적으로 유사한 특성을 가진 관측치들을 하나의 묶음으로 집단화”하는 핵심 비지도 학습 기법이 바로 군집 분석(Clustering)입니다.
하지만 실무에서 많은 데이터 분석가들이 습관적으로 kmeans() 함수만을 호출한 뒤, 왜 군집 형태가 일그러지는지, 왜 이상치(Outlier) 하나 때문에 전체 군집 중심점이 엉뚱한 곳으로 끌려가는지, 군집 수 \(k\)를 몇 개로 지정해야 하는지 갈피를 잡지 못합니다. 데이터의 기하학적 분포와 이상치 민감도, 변수 유형(혼합형 변수 등)에 따라 적합한 군집 알고리즘은 완전히 달라집니다.
이번 글에서는 K-Means를 비롯하여 이상치에 강력한 PAM(K-Medoids), 시각적 트리를 구성하는 계층적 군집(Hierarchical Clustering), 확률적 소프트 할당을 수행하는 GMM(가우시안 혼합 모델), 그리고 기하학적 비선형 군집과 노이즈를 완벽하게 분리하는 DBSCAN까지 5대 알고리즘을 전격 비교하고, 최적 \(k\) 결정법과 R 실무 검증 파이프라인을 총정리해 보겠습니다.
1. 군집 분석 5대 대표 알고리즘 아키텍처 비교
군집 분석 알고리즘들은 “유사한 데이터를 어떻게 정의하고 묶을 것인가?”에 대한 철학적·수학적 가정에 따라 5가지 패러다임으로 나뉩니다.
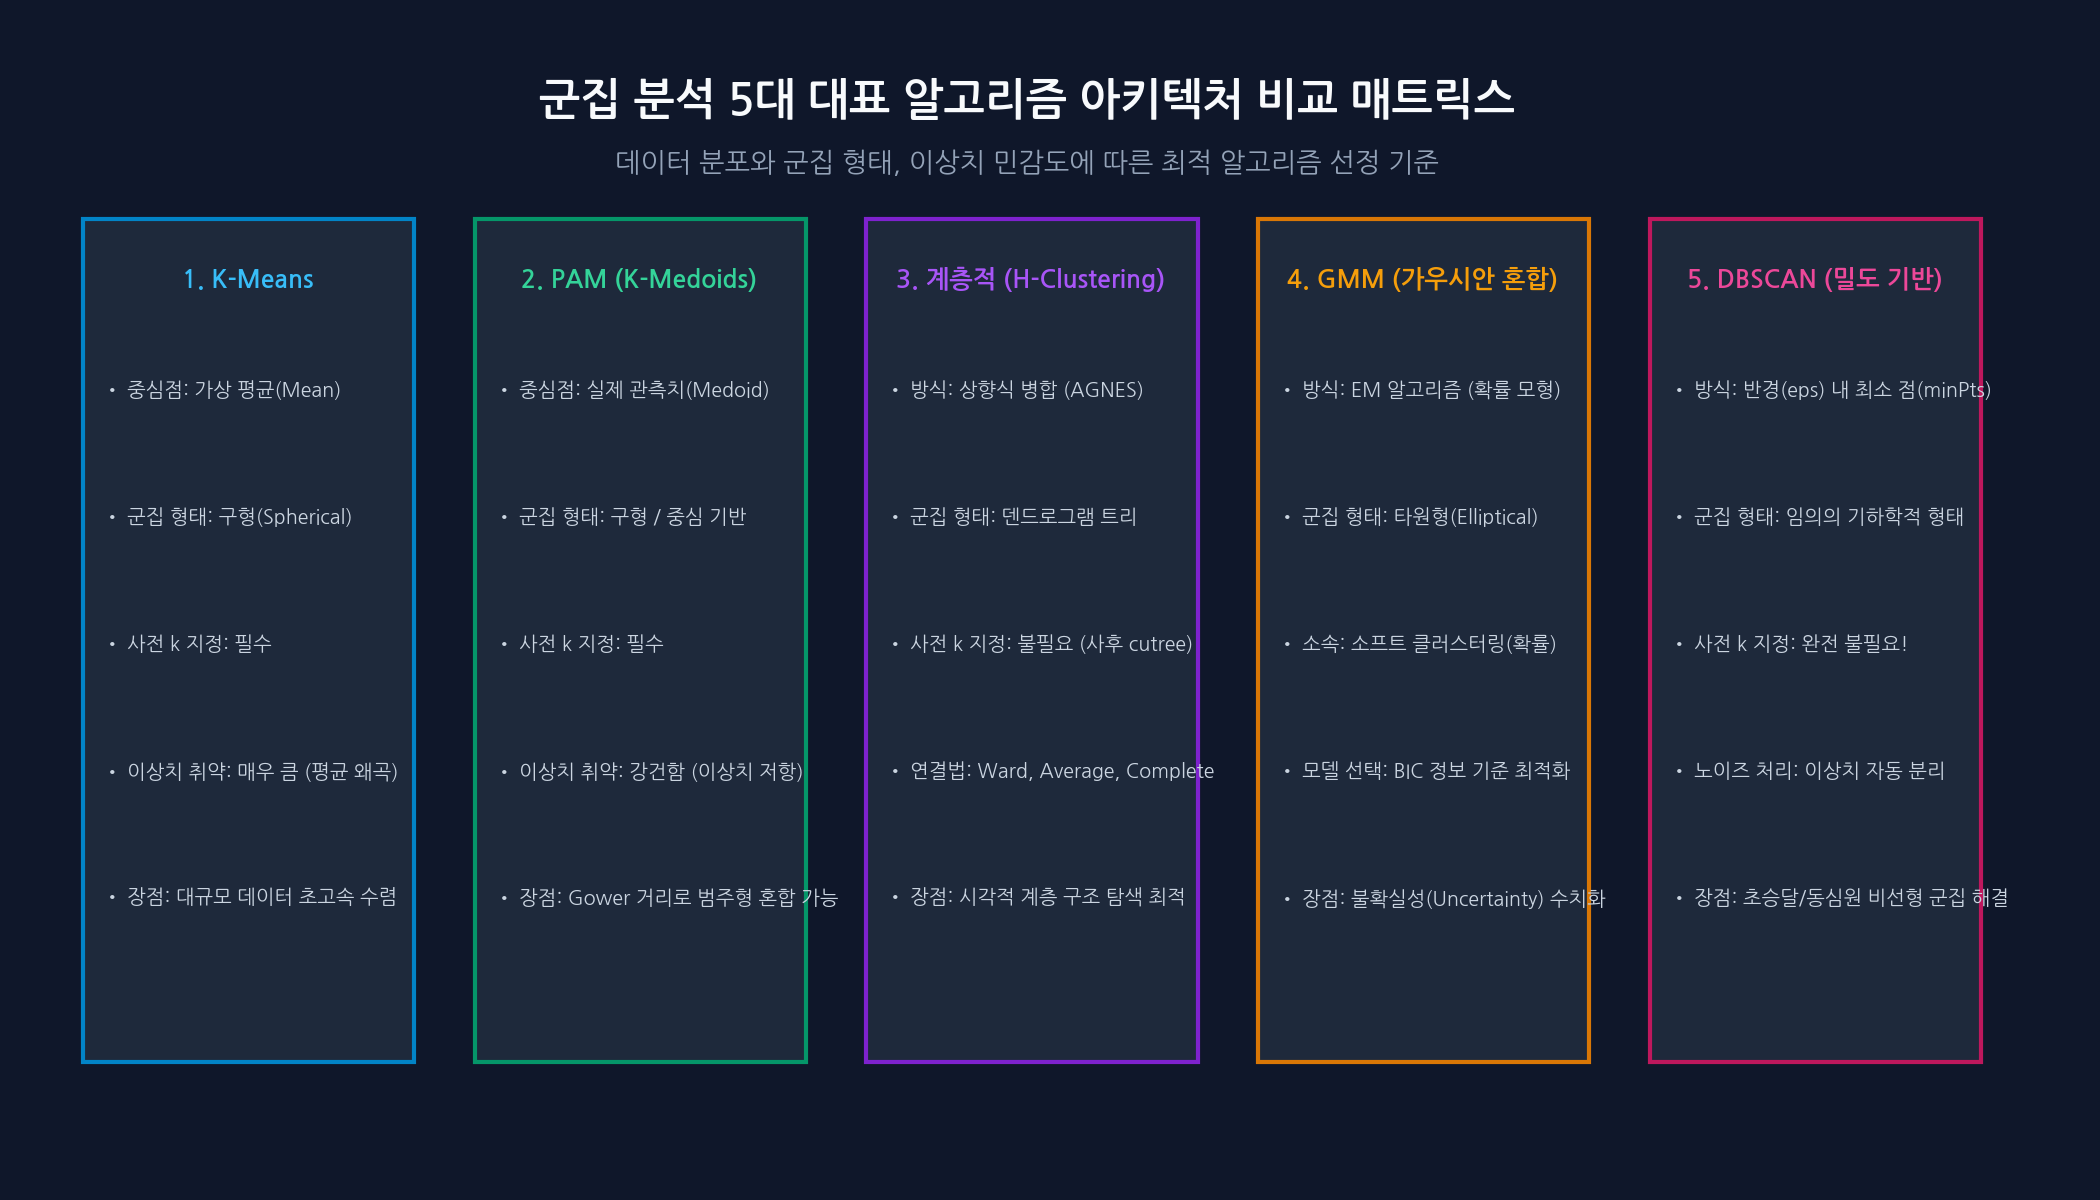
| 알고리즘 | 중심점 정의 | 군집 기하 구조 | 사전 \(k\) 지정 | 이상치 민감도 | 핵심 장점 및 실무 적용처 |
|---|---|---|---|---|---|
| K-Means | 가상 평균 (Centroid) | 구형(Spherical) | 필수 | 매우 취약 (평균 왜곡) | 대규모 데이터 초고속 수렴, 가장 단순하고 보편적인 세분화 |
| PAM (K-Medoids) | 실제 관측치 (Medoid) | 중심 기반 분할 | 필수 | 매우 강건 (이상치 저항) | 이상치가 많은 데이터, Gower 거리로 범주형 혼합 데이터 분석 |
| 계층적 군집 | 연결법 거리 기준 | 덴드로그램 계층 트리 | 사후 결정 | 연결법에 따라 상이 | 군집 간 계층적 종속 관계 파악, 유전체/분류학 연구 |
| GMM (mclust) | 가우시안 확률 분포 | 타원형 (Elliptical) | BIC 자동 탐색 | 보통 | 확률적 소프트 클러스터링, 관측치별 소속 불확실성(Uncertainty) 제공 |
| DBSCAN | 밀도 반경 (\(\epsilon\), MinPts) | 임의의 비선형 형태 | 완전 불필요 | 완벽 면역 (이상치 자동 분리) | 초승달/도넛 모양의 기하학적 패턴, 지리공간 이상치 탐지 |
1.1 K-Means vs PAM (K-Medoids): 왜 이상치에 PAM이 강건한가?
- K-Means의 목적함수: 각 군집의 중심점(Centroid, \(\mu_k\))과 소속 데이터 간의 군집 내 오차 제곱합(Within-Cluster Sum of Squares, WSS)을 최소화합니다: \[\text{WSS} = \sum_{k=1}^K \sum_{i \in C_k} \|x_i - \mu_k\|^2\] 문제는 중심점 \(\mu_k = \frac{1}{|C_k|}\sum x_i\)가 산술 평균이라는 점입니다. 만약 극단적인 이상치(Outlier)가 하나라도 끼어들면 평균 중심점이 이상치 쪽으로 심하게 끌려가 전체 군집의 경계가 왜곡됩니다.
- PAM의 해결책: 가상의 수학적 평균 대신, 군집 내부 데이터들 간의 거리 합을 최소화하는 실제 관측치 하나를 대표값(메도이드, Medoid)으로 지정합니다. 중간값(Median)이 평균(Mean)보다 이상치에 강건하듯, PAM은 이상치에 극도로 강건하며
cluster::daisy()함수와 결합하여 범주형과 연속형이 섞인 혼합 데이터셋에도 고워 거리(Gower Distance)를 완벽하게 적용할 수 있습니다.
1.2 DBSCAN: 사전 군집 수 지정 없는 비선형 밀도 기반 군집화
K-Means와 PAM의 치명적인 한계는 모든 군집이 볼록한 구형(Spherical)이나 원형으로 뭉쳐 있다고 가정한다는 점입니다. 만약 데이터가 초승달 모양이나 동심원, 혹은 복잡한 도로망을 따라 분포되어 있다면 K-Means는 이 데이터를 억지로 반쪽으로 잘라버립니다.
DBSCAN(Density-Based Spatial Clustering of Applications with Noise)은 오직 두 가지 파라미터로 작동합니다: - \(\epsilon\) (Epsilon): 한 점을 기준으로 탐색할 이웃 반경 거리 - \(\text{MinPts}\): 반경 \(\epsilon\) 내에 존재해야 하는 최소 데이터 점 개수
반경 내에 \(\text{MinPts}\) 이상의 이웃이 있으면 그 점을 핵심 점(Core Point)으로 정의하고, 핵심 점들끼리 서로 닿아있는 한 군집을 무한히 연장해 나갑니다. 반경 내에 점이 모자라면 경계 점(Border Point)이 되며, 어디에도 속하지 못하는 외딴 점들은 잡음(Noise / Outlier)으로 자동 분류되어 군집에서 제외됩니다. 사전에 \(k\)를 정할 필요가 없으며 노이즈를 완벽하게 걸러냅니다.
2. 최적 군집 수(\(k\)) 결정을 위한 3대 통계적 기법
군집 분석을 수행할 때 가장 곤혹스러운 질문은 “도대체 군집을 몇 개(\(k\))로 나누어야 하는가?”입니다. 주관적 감에 의존하지 않고 객관적인 수치로 최적의 \(k\)를 결정하는 3대 기법을 숙지해야 합니다.
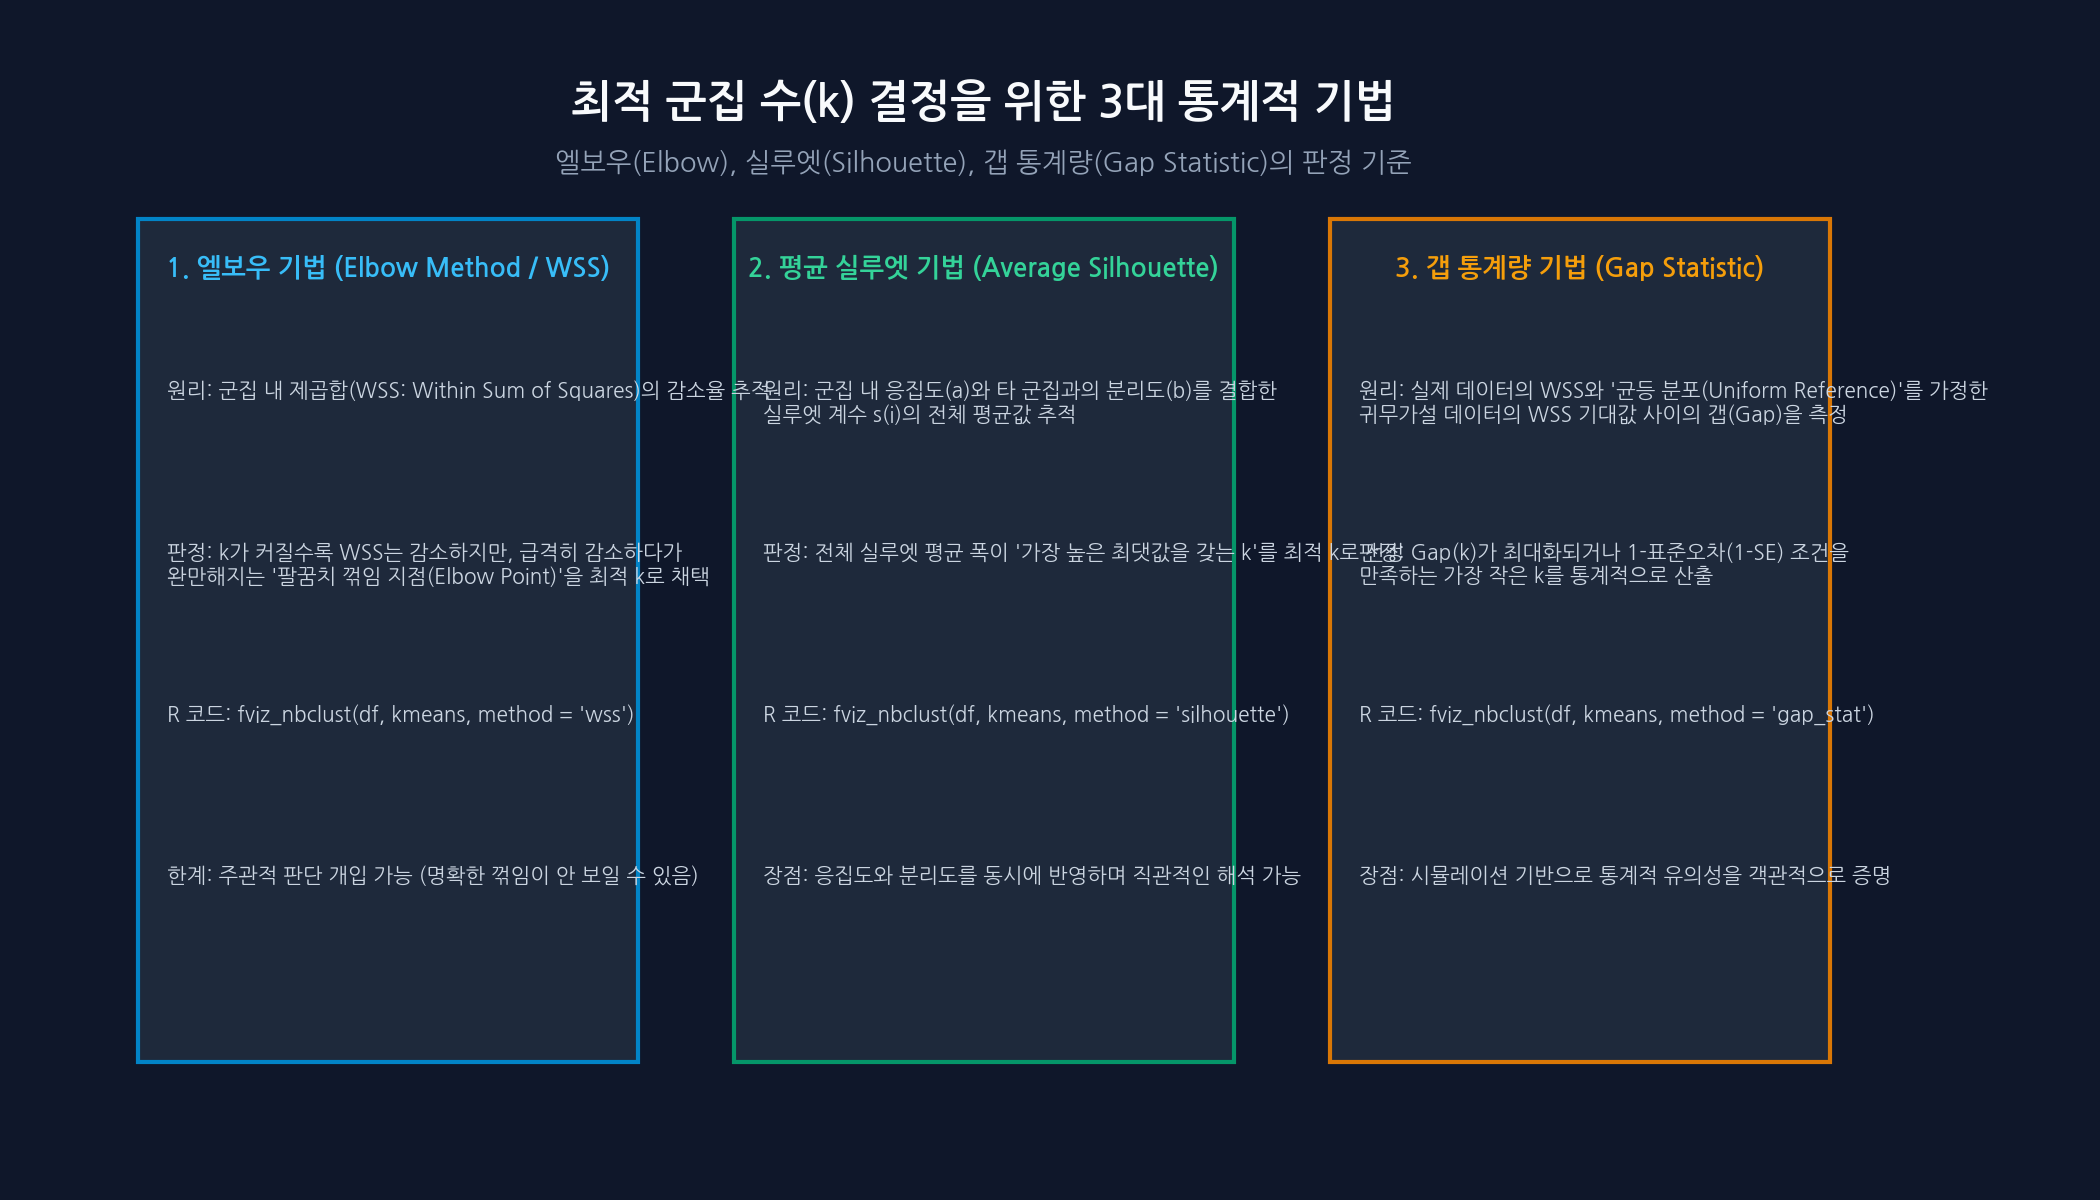
- 엘보우 기법 (Elbow Method / WSS)
\(k\)를 1부터 점진적으로 증가시키며 WSS(군집 내 제곱합)를 플롯합니다. \(k\)가 증가할수록 WSS는 당연히 감소하지만, 어느 순간 감소 폭이 급격히 둔화되며 완만해지는 지점이 발생합니다. 이 ’팔꿈치(Elbow)’처럼 꺾이는 변곡점을 최적 \(k\)로 선택합니다. - 평균 실루엣 기법 (Average Silhouette Method)
모든 데이터 포인트의 실루엣 폭(Silhouette Width)의 전체 평균을 계산합니다. 전체 평균 실루엣 계수가 가장 높은 최댓값을 찍는 \(k\)를 최적의 군집 수로 채택합니다. - 갭 통계량 기법 (Gap Statistic - Tibshirani et al., 2001)
실제 데이터의 군집 내 분산과, 아무런 군집 구조가 없는 균등 분포(Uniform Distribution) 가상 데이터셋에서 시뮬레이션된 분산의 기대값 사이의 차이(Gap)를 측정합니다. 통계적 귀무가설 대비 가장 큰 갭을 산출하는 \(k\)를 수학적으로 엄밀하게 찾아냅니다.
3. 군집 유효도 내부 평가 지표: 실루엣 & 던 인덱스
분류 모델은 정답 라벨과 비교하여 정확도(Accuracy)나 AUC를 계산할 수 있지만, 정답이 없는 군집 분석에서는 내부 유효성 측도(Internal Validation Measures)를 통해 알고리즘의 품질을 스스로 평가해야 합니다.
3.1 실루엣 계수 (Silhouette Coefficient)
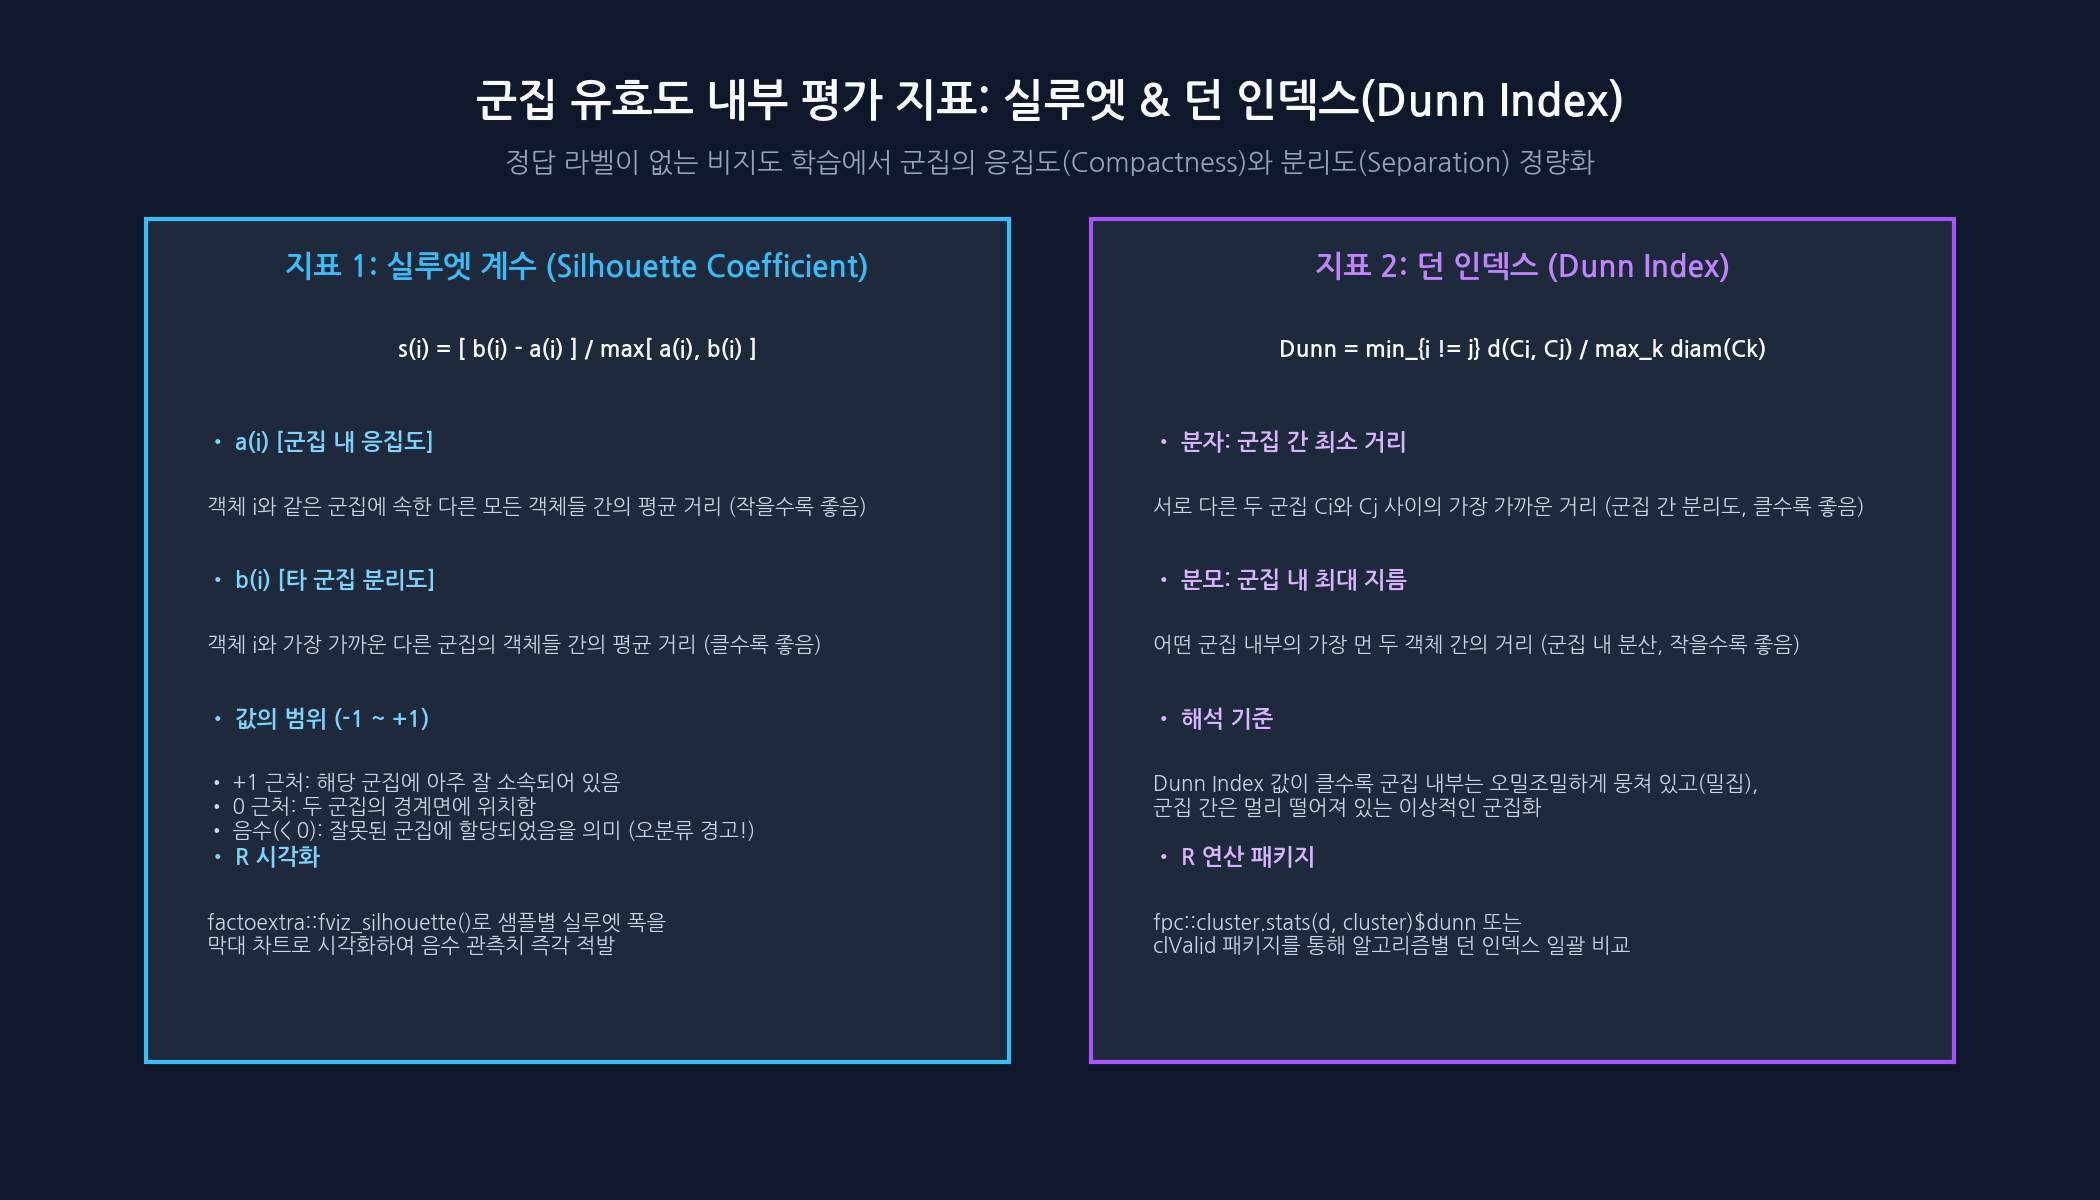
데이터 포인트 \(i\)에 대한 실루엣 계수 \(s(i)\)는 군집 내부의 응집도 \(a(i)\)와 가장 인접한 타 군집과의 분리도 \(b(i)\)를 동시에 결합합니다:
\[s(i) = \frac{b(i) - a(i)}{\max(a(i), b(i))}\]
- \(a(i)\): 점 \(i\)와 자신이 속한 군집 내 다른 점들 간의 평균 거리 (작을수록 응집도가 높음)
- \(b(i)\): 점 \(i\)와 가장 가까운 다른 군집의 점들 간의 평균 거리 (클수록 분리도가 높음)
- 값의 해석:
- \(s(i) \approx +1\): 자신이 속한 군집의 중심에 매우 잘 정착되어 있음
- \(s(i) \approx 0\): 두 군집의 아슬아슬한 경계면에 걸쳐 있음
- \(s(i) < 0\) (음수): 자신이 속한 군집보다 이웃 군집에 더 가까움! 즉, 잘못된 군집에 할당되었음을 경고하는 적신호
3.2 던 인덱스 (Dunn Index)
던 인덱스는 군집 간의 가장 가까운 거리(분리도)를 군집 내부의 가장 먼 거리(군집 지름 / 응집도)로 나눈 비율입니다:
\[\text{Dunn} = \frac{\min_{i \ne j} d(C_i, C_j)}{\max_k \text{diam}(C_k)}\]
- 해석 기준: 분자는 클수록(군집 간 거리가 멀수록), 분모는 작을수록(군집 내 분산이 촘촘할수록) 좋습니다. 따라서 던 인덱스 값이 클수록 이상적으로 잘 격리되고 응집된 최우수 군집화를 의미합니다.
4. R 군집 분석 엔드투엔드 실전 파이프라인
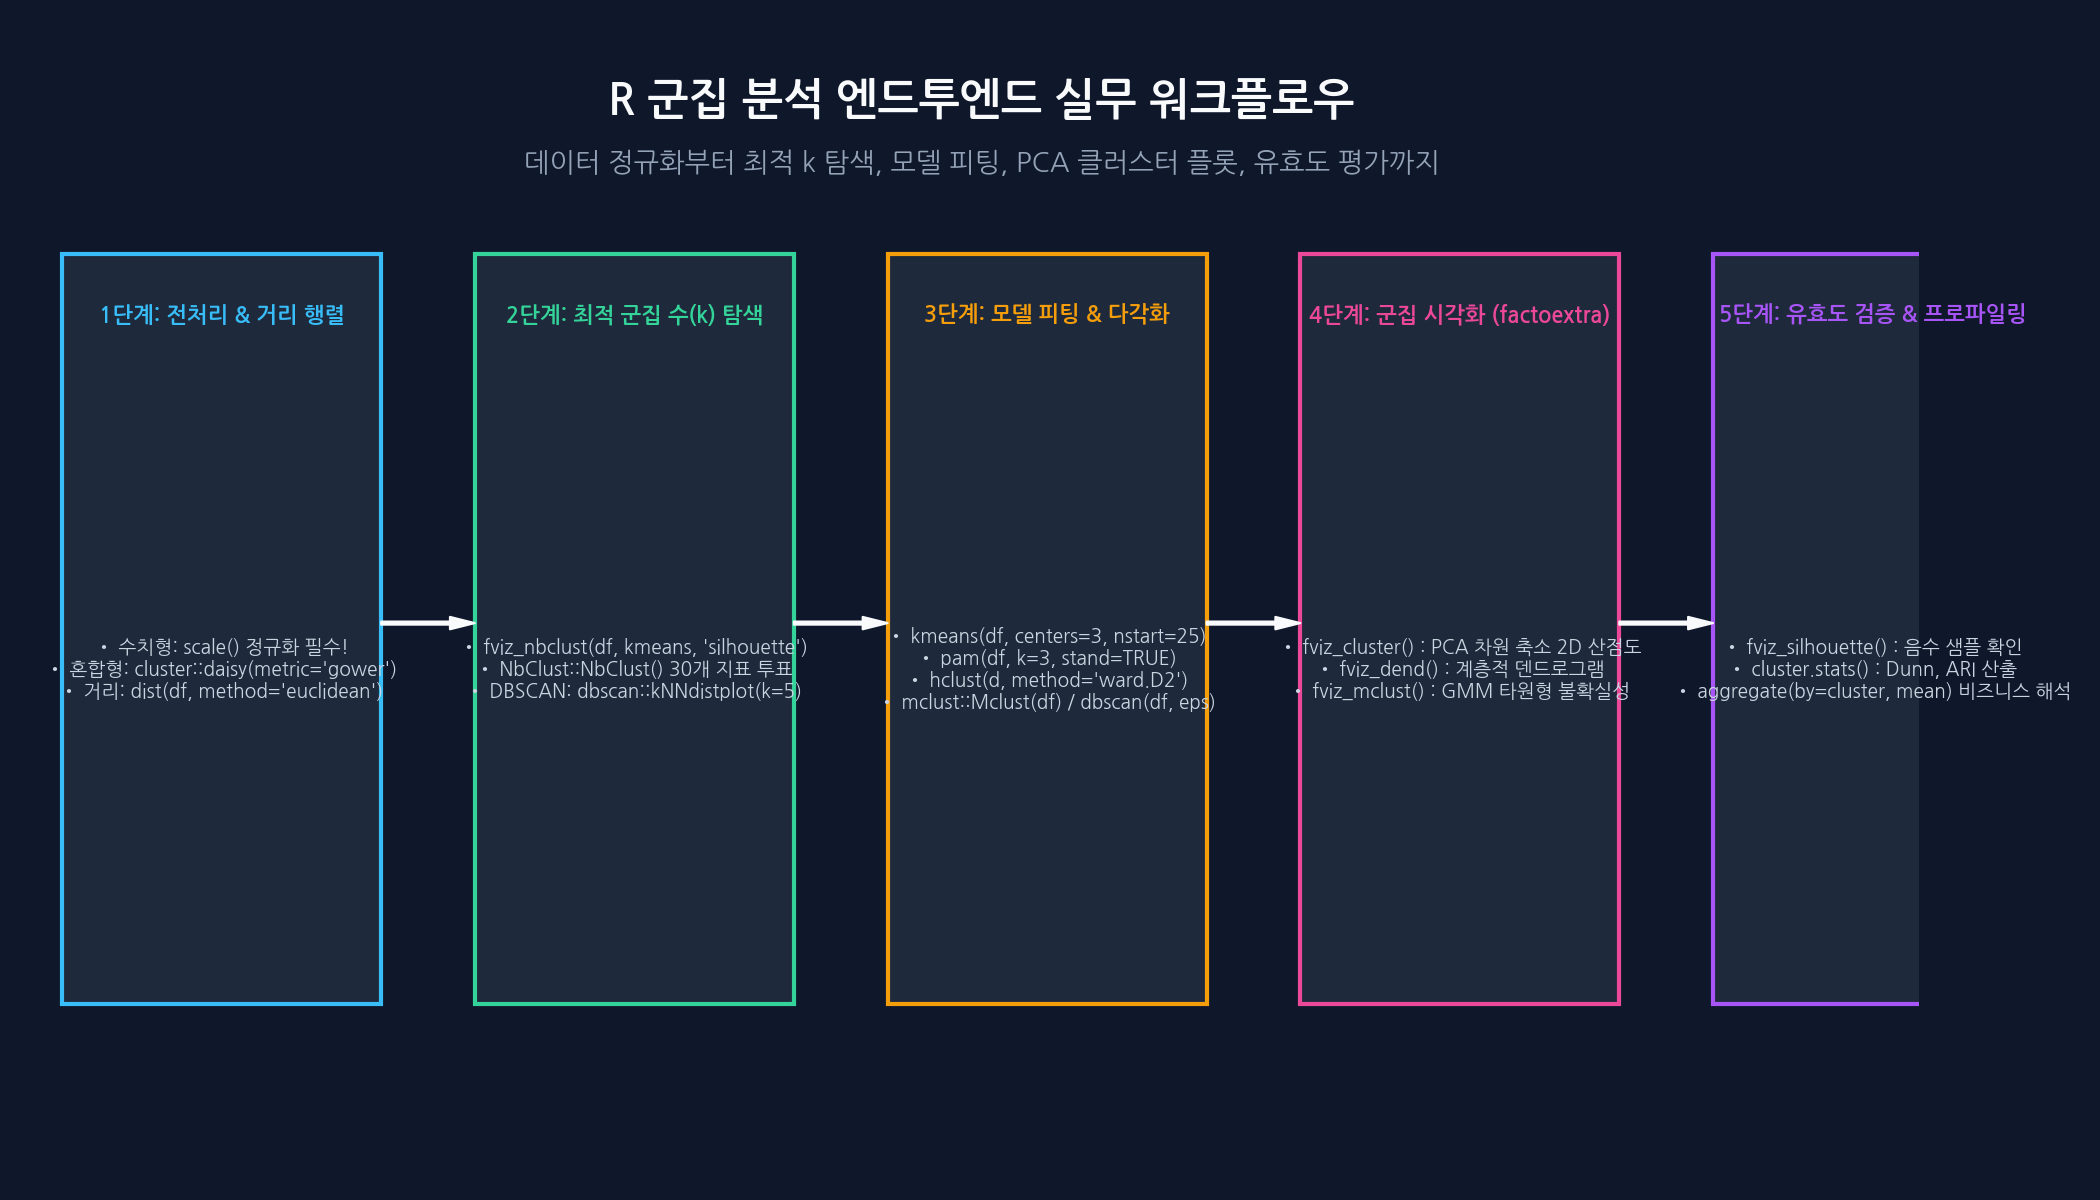
R의 factoextra, cluster, mclust, dbscan 패키지를 활용한 완벽한 실무 분석 파이프라인을 구현해 보겠습니다. 미국 공공 유틸리티 기업 데이터셋(Utilities.csv)의 주요 재무 지표를 표준화하여 기업들을 유형별로 군집화합니다.
# 필수 패키지 로드
library(tidyverse)
library(cluster)
library(factoextra)
library(mclust)
library(dbscan)
library(fpc)

# 1. 재현 가능한 가상 유틸리티 기업 재무 데이터 생성 (22개 기업)
set.seed(42)
companies <- paste0("Corp_", LETTERS[1:22])
utilities_df <- tibble(
  Company       = companies,
  Fixed_Charge  = rnorm(22, mean = 1.1, sd = 0.3),
  RoR           = rnorm(22, mean = 10.5, sd = 2.0),
  Cost          = rnorm(22, mean = 170, sd = 40),
  Load_Factor   = rnorm(22, mean = 55, sd = 5),
  Demand_Growth = rnorm(22, mean = 3.2, sd = 1.2),
  Nuclear       = runif(22, 0, 40),
  Fuel_Cost     = rnorm(22, mean = 1.1, sd = 0.5)
)

# 2. 기업명을 행 이름으로 지정하고 모든 연속형 수치 정규화 (Z-score 표준화)
# ※ 거리 기반 군집화에서는 스케일링이 누락되면 분산이 큰 Cost 변수가 전체 군집을 왜곡합니다!
df_scaled <- utilities_df %>%
  column_to_rownames(var = "Company") %>%
  scale()

head(df_scaled, 4)
4.1 최적 군집 수 \(k\) 탐색 및 K-Means 모델링
factoextra::fviz_nbclust를 사용하여 실루엣 폭을 최대화하는 최적 \(k\)를 찾고, nstart = 25로 안정적인 전역 최적해를 도출합니다:
# 3. 평균 실루엣 폭 기준 최적 군집 수 탐색
set.seed(123)
fviz_nbclust(df_scaled, kmeans, method = "silhouette") +
  labs(title = "Optimal Number of Clusters (Silhouette Method)")

# 4. K-Means 모델 생성 (k = 3, nstart = 25로 국소 최적해 방지)
set.seed(123)
km_res <- kmeans(df_scaled, centers = 3, nstart = 25)

# 군집 크기 및 중심점 확인
print(km_res$size)
print(km_res$centers)

# 5. 주성분 분석(PCA) 기반 2차원 클러스터 시각화
fviz_cluster(
  km_res,
  data = df_scaled,
  ellipse.type = "convex",
  repel = TRUE, # 레이블 겹침 방지
  main = "K-Means Clustering on Utilities (k = 3)"
)
4.2 PAM(K-Medoids) 군집화 및 실루엣 유효도 검증
이상치에 강건한 PAM 모델을 피팅하고, 음수 실루엣을 가진 오분류 데이터가 존재하는지 정밀 점검합니다:
# 6. PAM 모델 피팅 (k = 3)
set.seed(123)
pam_res <- pam(df_scaled, k = 3)

# 실제 데이터 중에서 선정된 3대 메도이드(대표 기업) 확인
print(pam_res$medoids)

# 7. factoextra를 활용한 실루엣 다이어그램 시각화
# ※ 음수 실루엣 폭을 가진 기업이 있는지 육안으로 즉시 검증
fviz_silhouette(pam_res)

# 음수 실루엣 관측치 적발
sil_widths <- pam_res$silinfo$widths
misplaced_cases <- sil_widths[sil_widths$sil_width < 0, ]
cat("잘못 할당된 음수 실루엣 기업 수:", nrow(misplaced_cases), "\n")
4.3 계층적 군집(Hierarchical Clustering)과 덴드로그램
데이터 간의 상향식 병합 계보를 트리 구조로 시각화하고, \(k=3\) 지점에서 사각형 테두리를 둘러 군집을 나눕니다:
# 8. 유클리드 거리 행렬 계산 및 Ward.D2 최소 분산 연결법 적용
dist_mat <- dist(df_scaled, method = "euclidean")
hclust_res <- hcut(df_scaled, k = 3, hc_method = "ward.D2")

# 9. 색상과 사각형 테두리가 포함된 고해상도 덴드로그램 시각화
fviz_dend(
  hclust_res,
  k = 3,
  rect = TRUE,
  rect_fill = TRUE,
  main = "Hierarchical Dendrogram (Ward.D2 Linkage)"
)
4.4 DBSCAN을 활용한 비선형 군집 및 노이즈 검출
사전에 군집 수를 지정하지 않고, k-NN 거리 그래프의 변곡점을 찾아 밀도 기반 군집화를 실행합니다:
# 10. k-NN 거리 그래프를 통한 최적 eps 탐색 (k = MinPts = 4)
kNNdistplot(df_scaled, k = 4)
abline(h = 2.0, lty = 2, col = "#ef4444") # 변곡점 임계치 eps = 2.0 지정

# 11. DBSCAN 실행
set.seed(123)
db_res <- dbscan::dbscan(df_scaled, eps = 2.0, minPts = 4)

# 군집 할당 결과 및 노이즈(Cluster 0) 기업 확인
table(db_res$cluster)
DBSCAN 결과에서 cluster == 0으로 분류된 기업들은 다른 어떤 기업들과도 재무 패턴이 유사하지 않은 진정한 이상치(독특한 사업 구조를 가진 특이 기업)로 판별할 수 있습니다.
5. 군집 분석 실무 적용 시 4대 핵심 체크리스트
- 단위 표준화(Standardization)는 생명이다
유클리드 거리는 측정 단위의 크기에 절대적인 지배를 받습니다. 매출액(수백억 단위)과 부채비율(소수점 단위)을 그대로 넣으면 매출액 변수 하나가 전체 거리를 100% 결정해 버립니다. 반드시scale()을 거쳐야 합니다. - K-Means의 초기값 함정과
nstart = 25
K-Means는 초기 중심점 위치에 따라 결과가 판이하게 달라지는 국소 최적점(Local Optima)에 취약합니다. R에서kmeans()를 호출할 때는 반드시nstart = 25이상을 지정하여 서로 다른 25개의 무작위 시작점 중 가장 낮은 WSS를 달성한 모델을 채택해야 합니다. - 고차원의 저주(Curse of Dimensionality)와 차원 축소
변수가 20~30개를 넘어가면 모든 데이터 간의 거리가 균일해져 군집화 성능이 급격히 저하됩니다. 사전에 PCA(주성분 분석)나 UMAP을 통해 3~5개 핵심 차원으로 축소한 뒤 군집화를 수행하는 것이 훨씬 깨끗한 경계를 형성합니다. - 비즈니스 프로파일링과 네이밍(Naming) 부여
군집 번호(1, 2, 3) 자체는 아무런 가치가 없습니다. 각 군집별 변수 평균을aggregate()로 요약하여, “군집 1: 고위험-고수익 공격형 기업”, “군집 2: 원전 중심 저비용 기업”, “군집 3: 설비 투자 과다형 기업”과 같이 실무진이 직관적으로 이해할 수 있는 페르소나(Persona)를 부여해야 비로소 분석이 완결됩니다.
6. 마치며: 데이터 속에 숨은 집단의 얼굴을 발견하다
군집 분석은 아무도 정답을 알려주지 않는 어둠 속에서, 수학적 거리와 밀도라는 손전등을 비추어 데이터 스스로 말하게 만드는 가장 순수한 형태의 머신러닝입니다.
- 대규모 데이터의 빠른 프로토타이핑에는 K-Means,
- 이상치와 범주형 변수가 섞인 비즈니스 데이터에는 PAM,
- 조직도나 도메인 계층 구조를 규명할 때는 계층적 덴드로그램,
- 기하학적 형상과 노이즈 검출이 생명인 센서/지리 데이터에는 DBSCAN을 선택하는 안목이 필요합니다.
이번 가이드에서 다룬 5대 알고리즘의 원리와 R factoextra 기반 유효도 검증 기법을 활용하여, 여러분의 도메인 데이터 속에 숨겨진 최적의 고객 세그먼트와 숨은 집단을 발굴해 보시기 바랍니다.
💡 연관 포스트 안내
- 협업 필터링(Collaborative Filtering) 추천 시스템 완벽 가이드: UBCF vs IBCF
- 연관 분석(Apriori) 완벽 정복: 지지도·신뢰도·향상도 수학적 원리부터 R 실습까지
- 인공신경망(ANN) 완벽 입문 가이드: 퍼셉트론·역전파 수학적 원리부터 R 실습까지