flowchart LR
    A["환자 검사 데이터 입력"] --> B["AI 모델 확률 점수 출력<br/>(0.0 ~ 1.0)"]
    B --> C{"판정 임계값(Threshold)<br/>기준선 설정"}
    C -->|"엄격한 기준 (0.8 이상)"| D["오진(FP)은 줄어들지만<br/>진짜 환자(FN)를 대거 놓침"]
    C -->|"느슨한 기준 (0.2 이상)"| E["환자(TP)는 다 잡지만<br/>정상인을 환자로 오진(FP) 폭증"]

    style A fill:#f8f9fa,stroke:#6c757d
    style B fill:#e0f2fe,stroke:#0284c7,stroke-width:2px
    style C fill:#fef3c7,stroke:#d97706,stroke-width:2px
    style D fill:#fee2e2,stroke:#dc2626
    style E fill:#fce7f3,stroke:#db2777
머신러닝과 인공지능 분류(Classification) 알고리즘을 평가할 때 가장 널리 쓰이면서도, 실무에서 가장 많은 오해와 혼선을 빚는 지표가 바로 ROC 곡선(Receiver Operating Characteristic Curve)과 PR 곡선(Precision-Recall Curve)입니다.
- “왜 단순 분류 정확도(Accuracy)가 99%인데 모델이 무용지물일까?”
- “ROC 곡선은 왜 왼쪽 위 \((0, 1)\)로 가야 하고, PR 곡선은 왜 오른쪽 위 \((1, 1)\)로 가야 하는가?”
- “두 곡선 모두 분류 모델을 평가하는 지표인데, 어떤 비즈니스 상황에서 무엇을 채택해야 하는가?”
이 의문들에 명확하게 답하지 못하면, 모델의 실제 성능을 과대평가하여 프로덕션 배포 후 막대한 비즈니스 손실(오진 사태, 이상 거래 탐지 실패 등)을 겪게 됩니다. 혼동 행렬의 기초부터 시작하여 두 곡선의 작동 원리, AUC의 확률적 의미, 그리고 불균형 데이터셋에서 발생하는 치명적인 통계적 착시를 극복하는 실전 가이드를 완벽하게 해체해 드립니다.
1. 들어가며: 임계값(Threshold)의 상충관계와 질병 진단 비유
수학적 수식에 앞서, 병원에서 AI가 환자의 희귀 질병을 진단하는 상황을 떠올려 보면 두 곡선의 본질을 직관적으로 이해할 수 있습니다.
- 실제 환자 (Positive): 치료가 시급한 양성 환자
- 실제 정상인 (Negative): 질병이 없는 건강한 음성인
- AI의 출력값: 흑백 단정이 아닌, \(0.0\)부터 \(1.0\) 사이의 위험도 확률 점수
여기서 AI는 두 가지 상충되는 목표를 마주합니다: 1. 환자 누락 방지 (목표 1): 진짜 환자를 한 명도 놓치지 않고 건져 올리기 2. 과잉 오진 방지 (목표 2): 건강한 사람에게 암 환자라고 잘못 통보하여 불필요한 공포와 의료비용을 유발하지 않기
판정 기준선인 임계값(Threshold)을 높이면 오진은 방어되지만 환자를 놓치고, 기준을 낮추면 환자는 다 잡지만 멀쩡한 정상인이 휩쓸려 들어옵니다. ROC 곡선과 PR 곡선은 바로 이 상충관계(Trade-off) 속에서 모델이 얼마나 뛰어난 판별 잠재력을 가졌는지 보여주는 나침반입니다.
2. 필수 배경지식: 혼동 행렬(Confusion Matrix)과 4대 평가지표
분류 모델의 결과를 수학적으로 평가하기 위해서는 4개의 상자로 분할된 혼동 행렬(Confusion Matrix)을 정확히 분해해야 합니다.
| 구분 | 실제 양성 (Actual Positive, 환자) | 실제 음성 (Actual Negative, 정상인) |
|---|---|---|
| AI 예측: 양성 (Predicted Positive) | TP (True Positive, 진짜 양성) 환자를 환자로 적중 |
FP (False Positive, 가짜 양성 / 1종 오류) 정상인을 환자로 오진 |
| AI 예측: 음성 (Predicted Negative) | FN (False Negative, 가짜 음성 / 2종 오류) 환자를 정상인으로 놓침 |
TN (True Negative, 진짜 음성) 정상인을 정상인으로 적중 |
2.1 4대 핵심 평가지표의 정의와 공식
\[\text{재현율 (Recall / TPR / 민감도)} = \frac{\text{TP}}{\text{TP} + \text{FN}}\] - 의미: “실제 환자 집단 중 AI가 놓치지 않고 찾아낸 비율” (환자 포착력)
\[\text{거짓 양성 비율 (FPR / Fall-out)} = \frac{\text{FP}}{\text{FP} + \text{TN}}\] - 의미: “정상인 집단 중 AI가 환자로 잘못 오진한 비율” (오진율)
\[\text{특이도 (Specificity / TNR)} = \frac{\text{TN}}{\text{FP} + \text{TN}} = 1 - \text{FPR}\] - 의미: “실제 정상인 중 정상인으로 올바르게 판정한 비율”
\[\text{정밀도 (Precision / PPV)} = \frac{\text{TP}}{\text{TP} + \text{FP}}\] - 의미: “AI가 환자라고 지목한 사람들 중 진짜 환자가 차지하는 비율” (판정의 순도)
💡 [역사적 기원] 왜 이름이 ’수신자 조작 특성(ROC)’인가?
제2차 세계대전 당시, 영국군 레이더 오퍼레이터(수신자, Receiver)들은 스크린에 포착된 신호가 독일 폭격기 편대인지, 아니면 단순한 철새 무리나 노이즈인지 판단해야 했습니다. 레이더 수신 감도(임계값)를 조작(Operating)함에 따라 폭격기 탐지율(TPR)과 새 떼를 폭격기로 오인하는 착오율(FPR) 사이의 반응 곡선이 그려졌고, 여기서 Receiver Operating Characteristic이라는 명칭이 탄생했습니다.
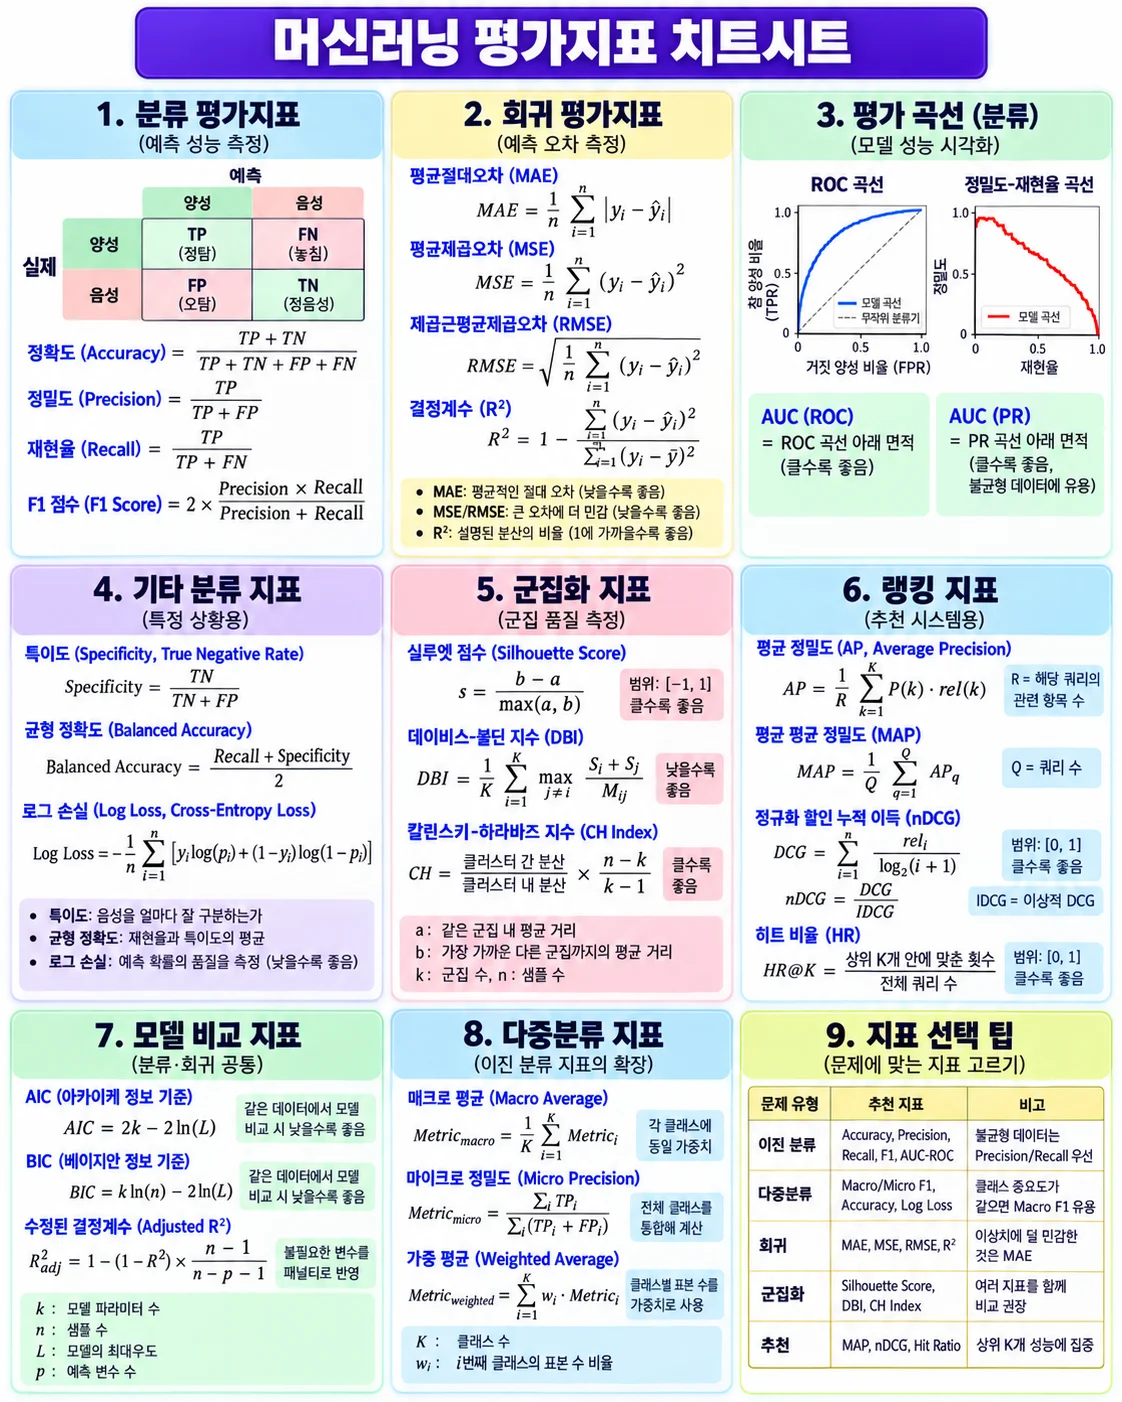
3. ROC 곡선(Receiver Operating Characteristic Curve) 완전 정복
3.1 ROC 좌표계의 원리와 8명 환자 시뮬레이션
ROC 그래프는 가로축에 FPR(오진율), 세로축에 TPR(환자 발견율)을 배치합니다.
- 세로축 (Y, TPR): 위로 갈수록 우수 (\(\uparrow\))
- 가로축 (X, FPR): 왼쪽으로 갈수록 우수 (\(\leftarrow\))
- 궁극의 이상점: 좌상단 \((0, 1)\) — 오진율 0%이면서 환자 발견율 100%
실제 8명의 환자/정상인 검사 데이터로 임계값 변화에 따른 ROC 발자국을 추적해 보겠습니다.
- 실제 환자 (4명): \(A(0.90), B(0.80), D(0.55), F(0.35)\)
- 건강한 사람 (4명): \(C(0.70), E(0.45), G(0.20), H(0.10)\)
| 임계값 (\(\ge\)) | 환자 판정 대상 | TP | FP | TPR (\(Y = \text{TP}/4\)) | FPR (\(X = \text{FP}/4\)) | ROC 좌표 \((X, Y)\) |
|---|---|---|---|---|---|---|
| 1.00 초과 | 판정자 없음 | 0 | 0 | \(0.00\) (\(0\%\)) | \(0.00\) (\(0\%\)) | \((0.00, 0.00)\) |
| 0.80 이상 | A(0.90), B(0.80) | 2 | 0 | \(0.50\) (\(50\%\)) | \(0.00\) (\(0\%\)) | \((0.00, 0.50)\) |
| 0.50 이상 | A, B, C(0.70), D(0.55) | 3 | 1 | \(0.75\) (\(75\%\)) | \(0.25\) (\(25\%\)) | \((0.25, 0.75)\) |
| 0.30 이상 | A, B, C, D, E(0.45), F(0.35) | 4 | 2 | \(1.00\) (\(100\%\)) | \(0.50\) (\(50\%\)) | \((0.50, 1.00)\) |
| 0.00 이상 | A ~ H 전원 환자 판정 | 4 | 4 | \(1.00\) (\(100\%\)) | \(1.00\) (\(100\%\)) | \((1.00, 1.00)\) |
graph TD
    subgraph ROC_Extremes ["ROC 곡선의 4대 극점 의미"]
        P0["(0, 0) : 임계값 1.0<br/>전원 정상인 판정<br/>(TPR=0, FPR=0)"]
        P1["(0, 1) : 완벽한 신의 모델<br/>환자 100% 포착, 오진 0%<br/>(TPR=1, FPR=0)"]
        P2["(1, 1) : 임계값 0.0<br/>전원 환자 판정<br/>(TPR=1, FPR=1)"]
        P3["(1, 0) : 완벽히 반대로 틀린 모델<br/>환자 0% 포착, 정상인만 오진<br/>(TPR=0, FPR=1)"]
    end

    style P0 fill:#f8f9fa,stroke:#6c757d
    style P1 fill:#dcfce7,stroke:#16a34a,stroke-width:3px
    style P2 fill:#f8f9fa,stroke:#6c757d
    style P3 fill:#fee2e2,stroke:#dc2626
- 대각선 (\(y = x\)) 점선: 동전을 던져 무작위로 찍는 수준 (변별력 0)
- 곡선이 대각선에서 멀어져 좌측 상단 모서리 \((0, 1)\)로 볼록하게 부풀어 오를수록 변별력이 탁월한 우수한 모델입니다.
4. AUC(Area Under the Curve): 모델의 판별력을 단일 숫자로 요약하기
ROC 곡선은 시각적으로 훌륭하지만 복수의 모델을 정량적으로 벤치마킹할 때는 곡선 아래 면적을 적분한 AUROC (Area Under the ROC Curve)를 사용합니다.
- \(\text{AUC} = 1.0\): 완벽한 분리 (두 클래스 분포가 전혀 겹치지 않음)
- \(\text{AUC} = 0.8 \sim 0.9\): 실무에서 대단히 우수한 신뢰성을 보장하는 모형
- \(\text{AUC} = 0.5\): 무작위 동전 던지기 수준 (쓸모없음)
- \(\text{AUC} < 0.5\): 예측 라벨을 반대로 뒤집어야 하는 비정상 모델
4.1 AUC의 확률적 본질 (Wilcoxon-Mann-Whitney 통계량)
AUC는 단순한 면적 공식 이상의 깊은 통계학적 의미를 갖습니다.
💡 AUC의 수학적 정의
“실제 환자(Positive) 집단에서 무작위로 1명을 뽑고, 실제 정상인(Negative) 집단에서 무작위로 1명을 뽑았을 때, AI가 환자에게 정상인보다 더 높은 점수를 부여했을 확률”\[\text{AUC} = P(\text{Score}_{\text{Positive}} > \text{Score}_{\text{Negative}})\]
위의 8명 예제 데이터(\(P=4, N=4\))에서 가능한 매칭 쌍은 총 \(4 \times 4 = 16\)쌍입니다. 각 환자가 정상인 4명과의 점수 대결에서 승리한 횟수를 세어보면: - 환자 A(0.90): 정상인 4명(0.70, 0.45, 0.20, 0.10) 전원 승리 \(\rightarrow\) 4승 - 환자 B(0.80): 정상인 4명 전원 승리 \(\rightarrow\) 4승 - 환자 D(0.55): C(0.70)에게 패배, 나머지 3명 승리 \(\rightarrow\) 3승 - 환자 F(0.35): C(0.70), E(0.45)에게 패배, 나머지 2명 승리 \(\rightarrow\) 2승
\[\text{총 승리 횟수} = 4 + 4 + 3 + 2 = 13\text{승}\] \[\text{AUC} = \frac{13}{16} = 0.8125 \;(81.25\%)\]
면적 적분값과 랭킹 순위 확률이 정확하게 일치함을 증명할 수 있습니다.
5. PR 곡선(Precision-Recall Curve) 완전 정복
ROC 곡선이 정상인 전체 중 오진율(FPR)에 주목한다면, PR 곡선은 “AI가 양성이라고 지목한 그룹(Positive 판정 집단)”의 내실을 정밀 타격합니다.
- 가로축 (X): \(\text{Recall (재현율)} = \frac{\text{TP}}{\text{TP} + \text{FN}}\)
- 세로축 (Y): \(\text{Precision (정밀도)} = \frac{\text{TP}}{\text{TP} + \text{FP}}\)
- 이상적인 방향: 우측 상단 \((1, 1)\) — 100% 재현율을 달성하면서 정밀도 100% 유지
5.1 왜 PR 곡선은 톱니바퀴처럼 울퉁불퉁한가?
동일한 8명 데이터로 임계값을 내릴 때 정밀도와 재현율의 변화를 관찰해 봅니다.
| 임계값 | 판정 대상 | TP | FP | 정밀도 (Precision, Y) | 재현율 (Recall, X) |
|---|---|---|---|---|---|
| 0.90 | A | 1 | 0 | \(1/1 = 100\%\) | \(1/4 = 25\%\) |
| 0.80 | A, B | 2 | 0 | \(2/2 = 100\%\) | \(2/4 = 50\%\) |
| 0.70 | A, B, C(정상인) | 2 | 1 | \(2/3 \approx 66.7\%\) | \(2/4 = 50\%\) |
| 0.55 | A, B, C, D(환자) | 3 | 1 | \(3/4 = 75.0\%\) (상승!) | \(3/4 = 75\%\) |
| 0.45 | A, B, C, D, E(정상인) | 3 | 2 | \(3/5 = 60.0\%\) (하락) | \(3/4 = 75\%\) |
| 0.35 | A, B, C, D, E, F(환자) | 4 | 2 | \(4/6 \approx 66.7\%\) (상승!) | \(4/4 = 100\%\) |
flowchart TD
    Step["임계값을 낮추어 추가 판정자가 유입될 때"] --> Cond{"유입된 대상의 정체는?"}
    Cond -->|"실제 환자 (TP) 유입"| Up["재현율 상승 (우측 이동)<br/>정밀도 반등 또는 방어 (위쪽 이동)"]
    Cond -->|"정상인 (FP) 유입"| Down["재현율 불변 (가로축 정지)<br/>정밀도 급락 (아래쪽 수직 낙하)"]

    style Step fill:#f8f9fa,stroke:#6c757d
    style Up fill:#dcfce7,stroke:#16a34a,stroke-width:2px
    style Down fill:#fee2e2,stroke:#dc2626,stroke-width:2px
임계값을 내릴 때 진짜 환자(TP)가 추가되면 정밀도의 분자와 분모가 함께 증가하여 곡선이 위로 튀어 오르고, 정상인(FP)이 추가되면 분모만 증가하여 정밀도가 수직 추락합니다. 따라서 PR 곡선은 매끄러운 곡선이 아닌 계단식 톱니(Sawtooth) 형상을 띱니다.
6. ROC vs PR: 데이터 불균형(Class Imbalance) 환경의 치명적 착시
현업 머신러닝에서 ROC 곡선만 신뢰하다가 참사를 겪는 가장 결정적인 이유는 클래스 불균형입니다.
실전 시나리오: 100,000명의 환자 중 실제 희귀 질환자는 100명(0.1%), 정상인은 99,900명(99.9%)인 데이터셋.
어떤 AI 모델이 정상인 중 1,000명을 환자로 오진(FP = 1,000)하고, 실제 환자 100명 중 90명을 검출(TP = 90)했다고 가정해 보겠습니다.
[ROC 곡선의 시선: 낙관적 착시]
 - TPR = TP / (TP + FN) = 90 / 100 = 0.90 (재현율 90%)
 - FPR = FP / (FP + TN) = 1,000 / 99,900 ≈ 0.010 (오진율 단 1%!)
 => ROC 좌표: (0.01, 0.90) ──► AUROC 0.98 이상으로 "완벽한 모델"처럼 왜곡됨

[PR 곡선의 시선: 냉혹한 실체]
 - Recall = 90 / 100 = 90%
 - Precision = TP / (TP + FP) = 90 / (90 + 1,000) = 90 / 1,090 ≈ 0.082 (정밀도 8.2%!)
=> 현장 의사의 피드백: "AI가 암 환자라고 부른 1,090명 중 진짜 환자는 8%뿐입니다!"- 착시의 수학적 원인:
ROC의 분모에는 거대한 음성 표본 수(\(\text{TN} = 98,900\))가 포함되어 있어, 오진이 1,000건이나 발생해도 비율이 \(1\%\) 수준으로 희석됩니다.
- 반면 PR 곡선은 정상인의 총수(\(\text{TN}\))를 공식에서 전면 배제하고 오직 양성 관련 수치(\(\text{TP}, \text{FP}, \text{FN}\))만 엄격하게 조명하므로, 불균형 데이터의 거품을 걷어내고 민낯을 폭로합니다.
7. 실무 의사결정: 언제 어떤 곡선을 선택해야 하는가?
graph TD
    Start{"데이터셋의 타깃(Positive) 비율은?"}
    Start -->|"균형 데이터 (예: 50:50, 60:40)"| B1["양성/음성 모두의 판별력이 균등하게 중요한가?"]
    B1 -->|YES| UseROC["ROC 곡선 & AUROC 채택"]
    B1 -->|NO| UsePR["PR 곡선 & PR-AUC(AP) 채택"]

    Start -->|"극심한 불균형 (타깃 < 5%)<br/>사기거래, 암진단, 불량검출"| UsePR

    style Start fill:#f8f9fa,stroke:#6c757d
    style UseROC fill:#e0f2fe,stroke:#0284c7,stroke-width:2px
    style UsePR fill:#fef3c7,stroke:#d97706,stroke-width:2px
7.1 ROC 곡선 & AUROC를 채택해야 할 때
- 양성 클래스와 음성 클래스의 비율이 비교적 균형적일 때
- 정상인을 정상인으로 식별하는 성능(\(\text{TN}\)) 자체가 비즈니스적으로 매우 가치 있을 때
- 특정 임계값에 구애받지 않고 분류기 본연의 순위화(Ranking) 성능을 객관적으로 비교할 때
7.2 PR 곡선 & PR-AUC(Average Precision)를 채택해야 할 때
- 사기 거래 탐지(FDS), 반도체 웨이퍼 결함, 암 진단, 스팸 메일 차단처럼 관심 타깃이 전체의 \(1\% \sim 5\%\) 미만인 희귀 이벤트일 때
- False Positive(가짜 양성)의 대가가 막심할 때 (예: 정상 고객의 신용카드를 사기 의심으로 잘못 정지시켜 집단 민원이 발생하는 경우)
8. Scikit-learn 기반 실전 파이썬 시각화 템플릿
현업에서 분류 모델을 구축하고 ROC와 PR 곡선을 동시에 추출하여 비교하는 표준 파이썬 코드입니다.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import roc_curve, roc_auc_score, precision_recall_curve, average_precision_score

# 1. 예제 확률 예측값 및 실제 라벨
y_true = np.array([1, 1, 0, 1, 0, 1, 0, 0])
y_scores = np.array([0.90, 0.80, 0.70, 0.55, 0.45, 0.35, 0.20, 0.10])

# 2. ROC 지표 산출
fpr, tpr, roc_thresholds = roc_curve(y_true, y_scores)
auroc = roc_auc_score(y_true, y_scores)

# 3. PR 지표 산출
precision, recall, pr_thresholds = precision_recall_curve(y_true, y_scores)
pr_auc = average_precision_score(y_true, y_scores)

# 4. 시각화
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6))

# [왼쪽] ROC 곡선
ax1.plot(fpr, tpr, color='#4f46e5', lw=2.5, label=f'ROC Curve (AUC = {auroc:.3f})')
ax1.plot([0, 1], [0, 1], color='gray', linestyle='--', label='Random Chance (AUC = 0.5)')
ax1.set_xlim([-0.02, 1.02])
ax1.set_ylim([-0.02, 1.02])
ax1.set_xlabel('False Positive Rate (FPR)', fontsize=12)
ax1.set_ylabel('True Positive Rate (TPR / Recall)', fontsize=12)
ax1.set_title('Receiver Operating Characteristic (ROC)', fontsize=14, fontweight='bold')
ax1.legend(loc='lower right')
ax1.grid(alpha=0.3)

# [오른쪽] PR 곡선
base_rate = np.mean(y_true)
ax2.plot(recall, precision, color='#db2777', lw=2.5, label=f'PR Curve (AP = {pr_auc:.3f})')
ax2.axhline(y=base_rate, color='gray', linestyle='--', label=f'Baseline (Prevalence = {base_rate:.2f})')
ax2.set_xlim([-0.02, 1.02])
ax2.set_ylim([-0.02, 1.02])
ax2.set_xlabel('Recall (Sensitivity)', fontsize=12)
ax2.set_ylabel('Precision (PPV)', fontsize=12)
ax2.set_title('Precision-Recall (PR) Curve', fontsize=14, fontweight='bold')
ax2.legend(loc='lower left')
ax2.grid(alpha=0.3)

plt.tight_layout()
plt.show()
9. 마치며: 핵심 요약 치트시트
- 임계값 딜레마: 기준을 완화하면 환자를 더 많이 건지지만(Recall \(\uparrow\)), 정상인 오진도 불가피하게 늘어납니다(FPR \(\uparrow\), Precision \(\downarrow\)).
- ROC의 목표: 오진율(FPR) 대비 발견율(TPR)을 보며, 좌상단 \((0, 1)\)에 밀착할수록 우수합니다. 무작위 기준선은 대각선(\(0.5\))입니다.
- PR의 목표: 판정의 순도(Precision) 대비 포착력(Recall)을 보며, 우상단 \((1, 1)\)에 밀착할수록 우수합니다. 무작위 기준선은 양성 비율(Prevalence)입니다.
- 불균형 데이터 주의보: 관심 타깃이 희귀한 데이터에서는 ROC의 거품에 속지 말고, 반드시 PR 곡선과 Average Precision(AP)을 기본 평가지표로 삼아야 합니다.