데이터 마이닝 분야에서 가장 널리 회자되는 고전적 일화가 있습니다. 바로 1990년대 대형 마트의 영수증 데이터를 분석했더니 “금요일 저녁 기저귀를 구매한 젊은 남성 고객들이 맥주를 함께 구매하는 확률이 매우 높았다”는 이야기입니다. 마트 측은 즉시 기저귀 매대 바로 옆에 캔맥주를 진열하여 두 상품의 매출을 동시에 폭발적으로 끌어올렸다고 합니다.
이 전설적인 이야기의 기술적 실체가 바로 장바구니 분석(Market Basket Analysis)이자 비지도 학습의 대표 주자인 연관 분석(Association Rule Mining)입니다.
현대의 이커머스(쿠팡, 아마존 등) 추천 시스템과 오프라인 대형마트의 매대 진열, OTT 콘텐츠 번들링에 이르기까지 연관 분석은 여전히 광범위하게 활용되고 있습니다. 하지만 실무에서 많은 분석가들이 단순히 apriori() 함수를 돌린 뒤 수천 개의 쏟아지는 규칙들 사이에서 정작 비즈니스 가치가 있는 핵심 규칙을 걸러내지 못합니다.
이번 글에서는 연관 규칙을 평가하는 3대 핵심 지표(지지도, 신뢰도, 향상도)의 수학적·통계적 의미를 낱낱이 파헤치고, 조합적 폭발(Combinatorial Explosion)을 방지하는 Apriori 알고리즘의 하향 폐쇄성(Downward-Closure Property) 원리, 그리고 R의 arules와 arulesViz를 이용한 실전 분석 및 인터랙티브 네트워크 시각화 파이프라인을 완벽하게 정리해 보겠습니다.
1. 연관 규칙(Association Rules) 평가 3대 핵심 지표
연관 분석은 대규모 거래 데이터셋에서 “만약 A를 구매했다면, B도 함께 구매할 것이다 (\(A \Rightarrow B\))”라는 형태의 조건부 규칙(If-Then Rule)을 찾아내는 비지도 학습 기법입니다. - \(A\) (LHS, Left Hand Side / 선행사 / Antecedent): 조건절 아이템셋 - \(B\) (RHS, Right Hand Side / 결과절 / Consequent): 결론절 아이템셋
수많은 가능한 규칙 중에서 의미 있는 규칙을 선별하기 위해 다음의 3대 통계 지표를 반드시 이해해야 합니다.
1.1 지지도 (Support): 규칙의 빈도와 실효성
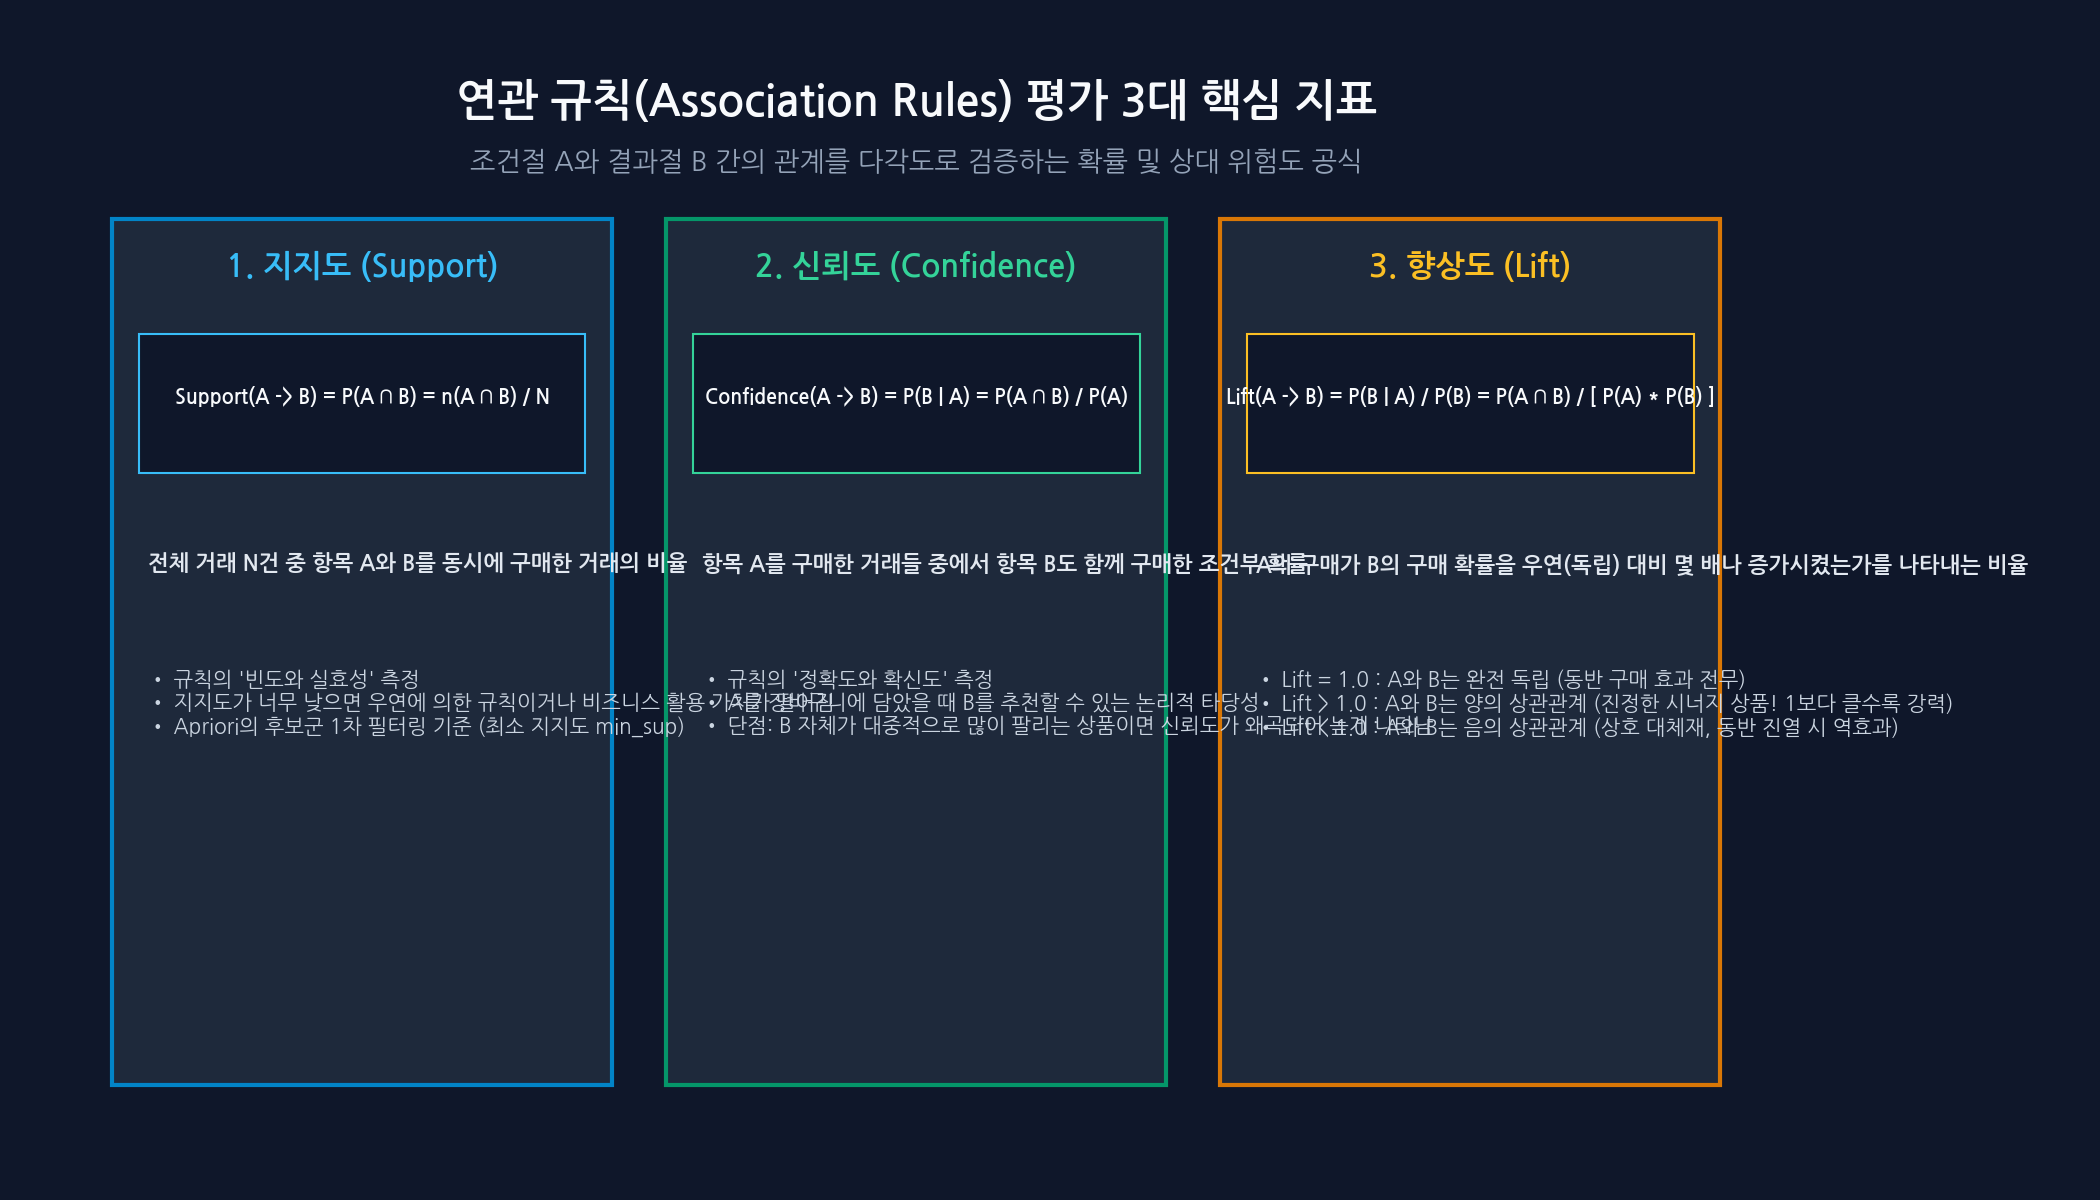
전체 거래 수 \(N\)건 중에서 품목 \(A\)와 \(B\)가 동시에 포함된 거래의 비율입니다.
\[\text{Support}(A \Rightarrow B) = P(A \cap B) = \frac{n(A \cap B)}{N}\]
- 비즈니스 의미: 이 규칙이 전체 거래에서 얼마나 자주 일어나는 대중적인 사건인가를 측정합니다.
- 역할: 지지도가 너무 낮은 규칙은 우연히 한두 번 발생했을 가능성이 높고, 실제 마케팅 전략에 반영하더라도 전체 매출에 미치는 영향이 미미합니다. 따라서 Apriori 알고리즘에서는 1차적으로 최소 지지도(Minimum Support,
min_sup)를 만족하지 못하는 아이템셋을 후보군에서 전면 탈락시킵니다.
1.2 신뢰도 (Confidence): 규칙의 정확도와 확신도
품목 \(A\)를 구매한 거래들 중에서 품목 \(B\)도 함께 구매했을 조건부 확률입니다.
\[\text{Confidence}(A \Rightarrow B) = P(B \mid A) = \frac{P(A \cap B)}{P(A)} = \frac{n(A \cap B)}{n(A)}\]
- 비즈니스 의미: 고객이 장바구니에 \(A\)를 담았을 때, \(B\)를 추천하면 실제로 장바구니에 담을 확률(정확도)이 얼마나 되는가를 의미합니다.
- 치명적 한계점: 신뢰도에는 중대한 맹점이 있습니다. 만약 결과절 품목 \(B\) 자체가 대형 마트의 ’생수’나 ’우유’처럼 거의 모든 고객이 원래 구매하는 베스트셀러라면, \(A\)와 아무런 인과관계가 없더라도 신뢰도 \(P(B \mid A)\)는 자연스럽게 높게 측정됩니다. 이를 방지하기 위해 반드시 향상도(Lift)를 함께 확인해야 합니다.
1.3 향상도 (Lift): 진정한 시너지의 척도
품목 \(A\)의 구매가 품목 \(B\)의 구매 확률을 우연에 의한 독립 확률 대비 몇 배나 상승시켰는가를 측정하는 상대적 비율입니다.
\[\text{Lift}(A \Rightarrow B) = \frac{P(B \mid A)}{P(B)} = \frac{P(A \cap B)}{P(A) \times P(B)}\]
향상도의 값은 다음과 같이 3가지 영역으로 명확하게 해석됩니다:
- \(\text{Lift}(A \Rightarrow B) = 1.0\) (독립 / 관계 없음)
\(A\)와 \(B\)의 구매는 통계적으로 완전히 독립입니다. \(A\)를 구매하든 안 하든 \(B\)를 구매할 확률에는 아무런 변화가 없습니다. - \(\text{Lift}(A \Rightarrow B) > 1.0\) (양의 상관관계 / 동반 시너지 상품)
\(A\)를 구매한 고객은 그렇지 않은 고객에 비해 \(B\)를 구매할 확률이 Lift 배만큼 높습니다. 진정한 연관 상품, 함께 묶어서 번들링하거나 크로스셀링을 진행해야 하는 핵심 타겟입니다. - \(\text{Lift}(A \Rightarrow B) < 1.0\) (음의 상관관계 / 상호 대체재)
\(A\)를 구매하면 오히려 \(B\)를 구매할 확률이 떨어집니다. 코카콜라와 펩시콜라처럼 상호 대체 관계이거나 취향이 극명히 갈리는 품목군입니다. 이 둘을 함께 진열하거나 묶음 상품으로 제안하는 것은 역효과를 냅니다.
2. Apriori 알고리즘의 원리: 하향 폐쇄성과 가지치기
품목이 \(d\)개 있는 마트에서 생성할 수 있는 모든 가능한 부분집합(아이템셋)의 개수는 \(2^d - 1\)개에 달합니다. 품목이 100개만 되어도 부분집합 수는 무려 \(1.26 \times 10^{30}\)개에 달하여 현대 슈퍼컴퓨터로도 전수 조사(Brute-force)가 불가능합니다.
1994년 라케시 아그라왈(Rakesh Agrawal)과 람크리슈난 스리칸트(Ramakrishnan Srikant)는 이 계산 복잡도를 획기적으로 줄이기 위해 하향 폐쇄성(Downward-Closure Property)에 기반한 Apriori 알고리즘을 제안했습니다.
하향 폐쇄성 (Apriori Property)
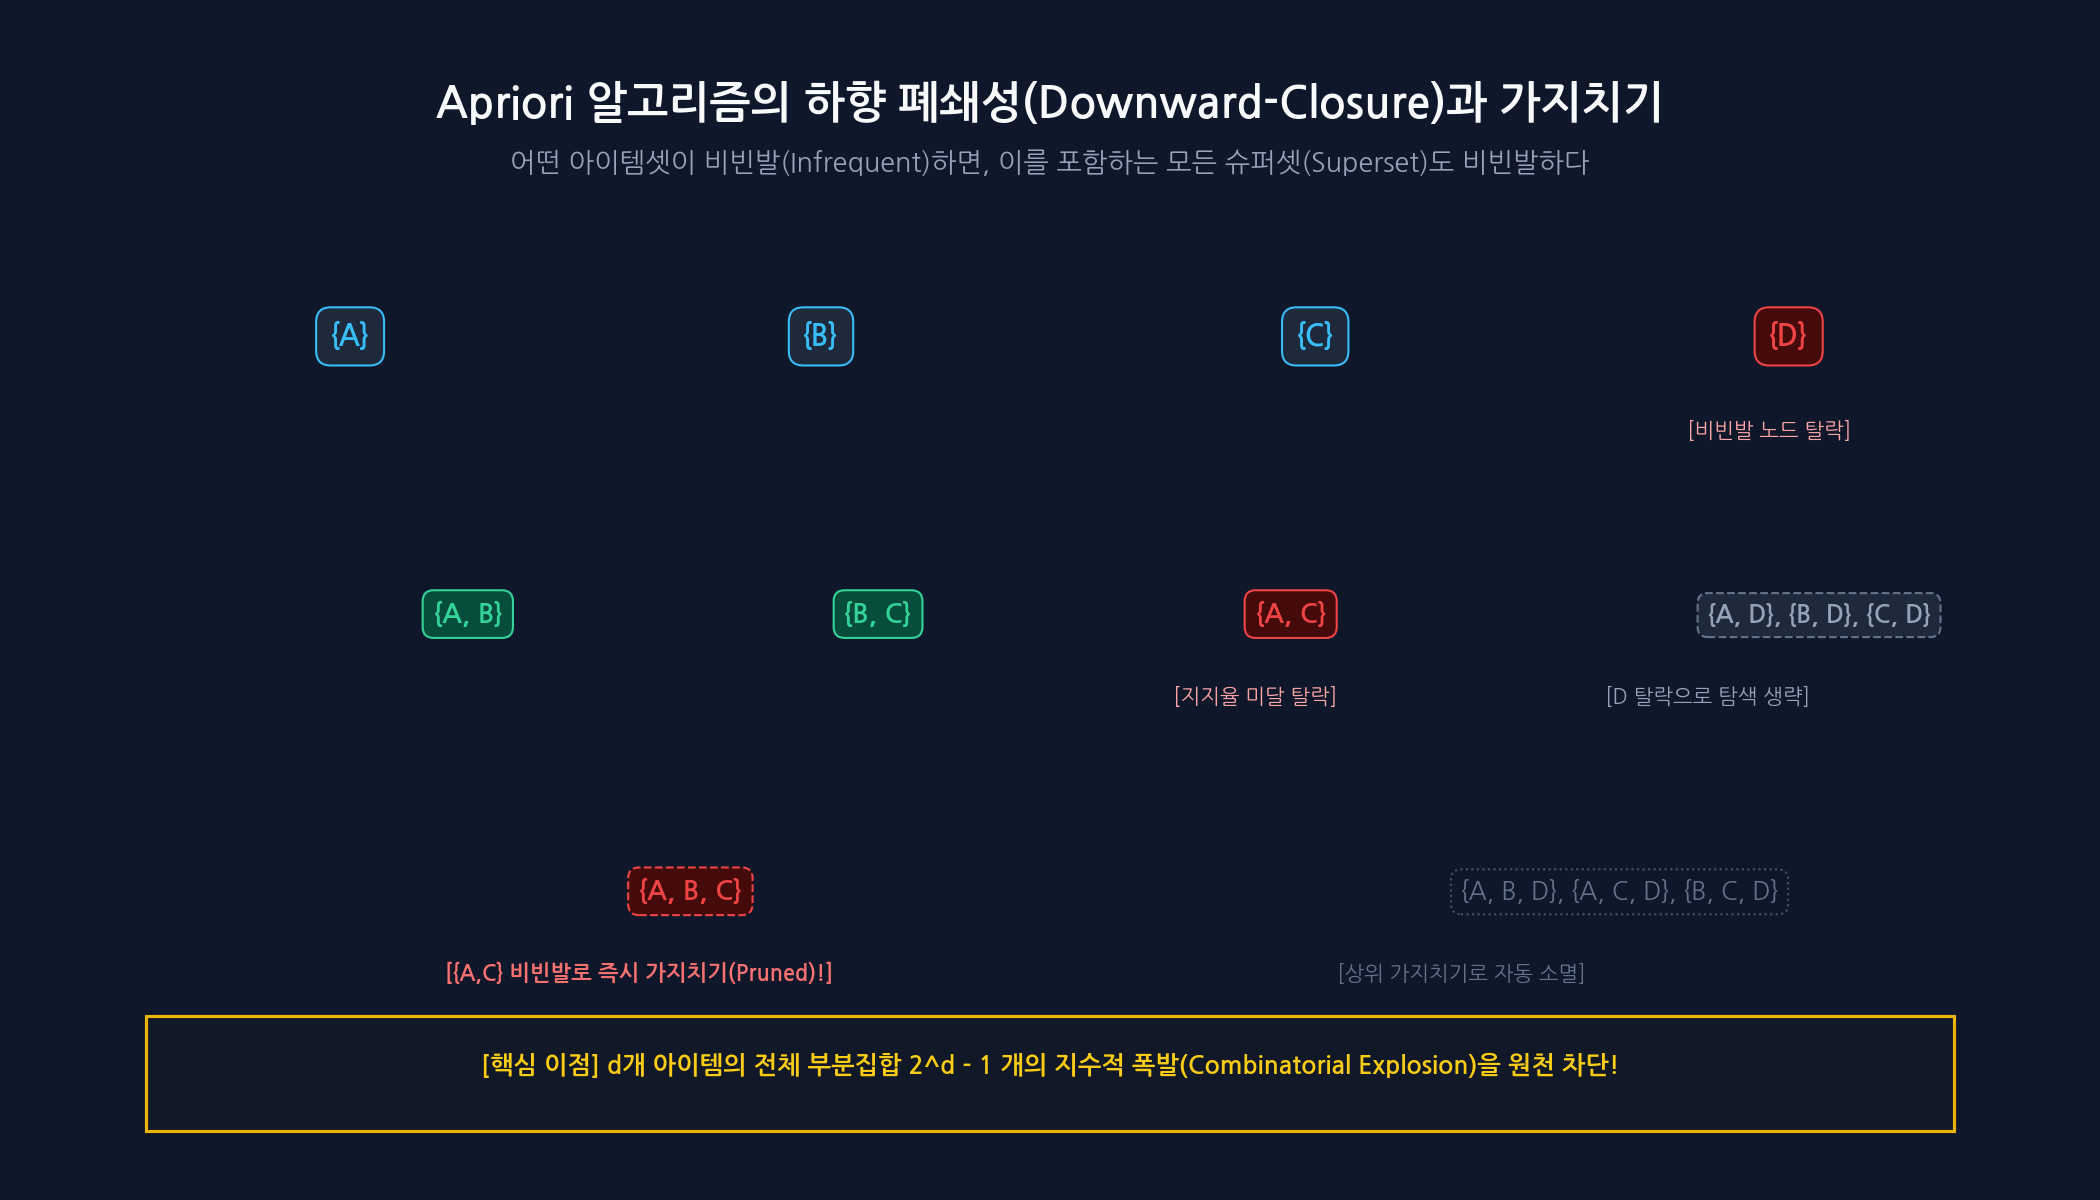
“만약 어떤 아이템셋 \(S\)가 최소 지지도를 넘지 못해 비빈발(Infrequent)하다면, 그 아이템셋을 부분집합으로 포함하는 모든 상위 슈퍼셋(Superset) 역시 무조건 비빈발하다.”
수학적으로 어떤 거래 \(T\)가 \(S \cup \{X\}\)를 포함하려면 반드시 \(S\)를 포함해야 하므로, \(n(S \cup \{X\}) \le n(S)\)가 성립합니다. 따라서 상위 집합의 지지도는 하위 집합의 지지도를 절대 초과할 수 없습니다.
단계별 가지치기(Pruning) 과정
- \(k=1\) (단일 품목 집계): 모든 개별 아이템의 빈도를 세어 최소 지지도 미만인 아이템(예: \(\{D\}\))을 즉시 제거합니다.
- \(k=2\) (후보 쌍 생성 및 가지치기): 탈락한 \(\{D\}\)가 포함된 모든 쌍(\(\{A, D\}\), \(\{B, D\}\), \(\{C, D\}\))은 계산조차 하지 않고 즉시 소멸합니다. 나머지 쌍 중에서도 지지도가 미달인 쌍(예: \(\{A, C\}\))을 제거합니다.
- \(k=3\) (3개 품목 결합): \(\{A, B, C\}\)를 검토할 때, 그 부분집합인 \(\{A, C\}\)가 이미 비빈발하므로 \(\{A, B, C\}\)의 데이터 스캔을 수행하지 않고 사전에 잘라냅니다(Pruning).
이 간단하지만 강력한 논리적 원리 덕분에 알고리즘은 탐색 공간의 99% 이상을 순식간에 가지치기하여 수백만 건의 영수증 데이터에서도 수초 만에 의미 있는 규칙을 뽑아낼 수 있습니다.
3. R arules 데이터 변환 파이프라인
R에서 연관 분석을 수행하려면 일반적인 data.frame을 arules 패키지가 요구하는 희소 트랜잭션(Transactions) 객체로 변환해야 합니다.
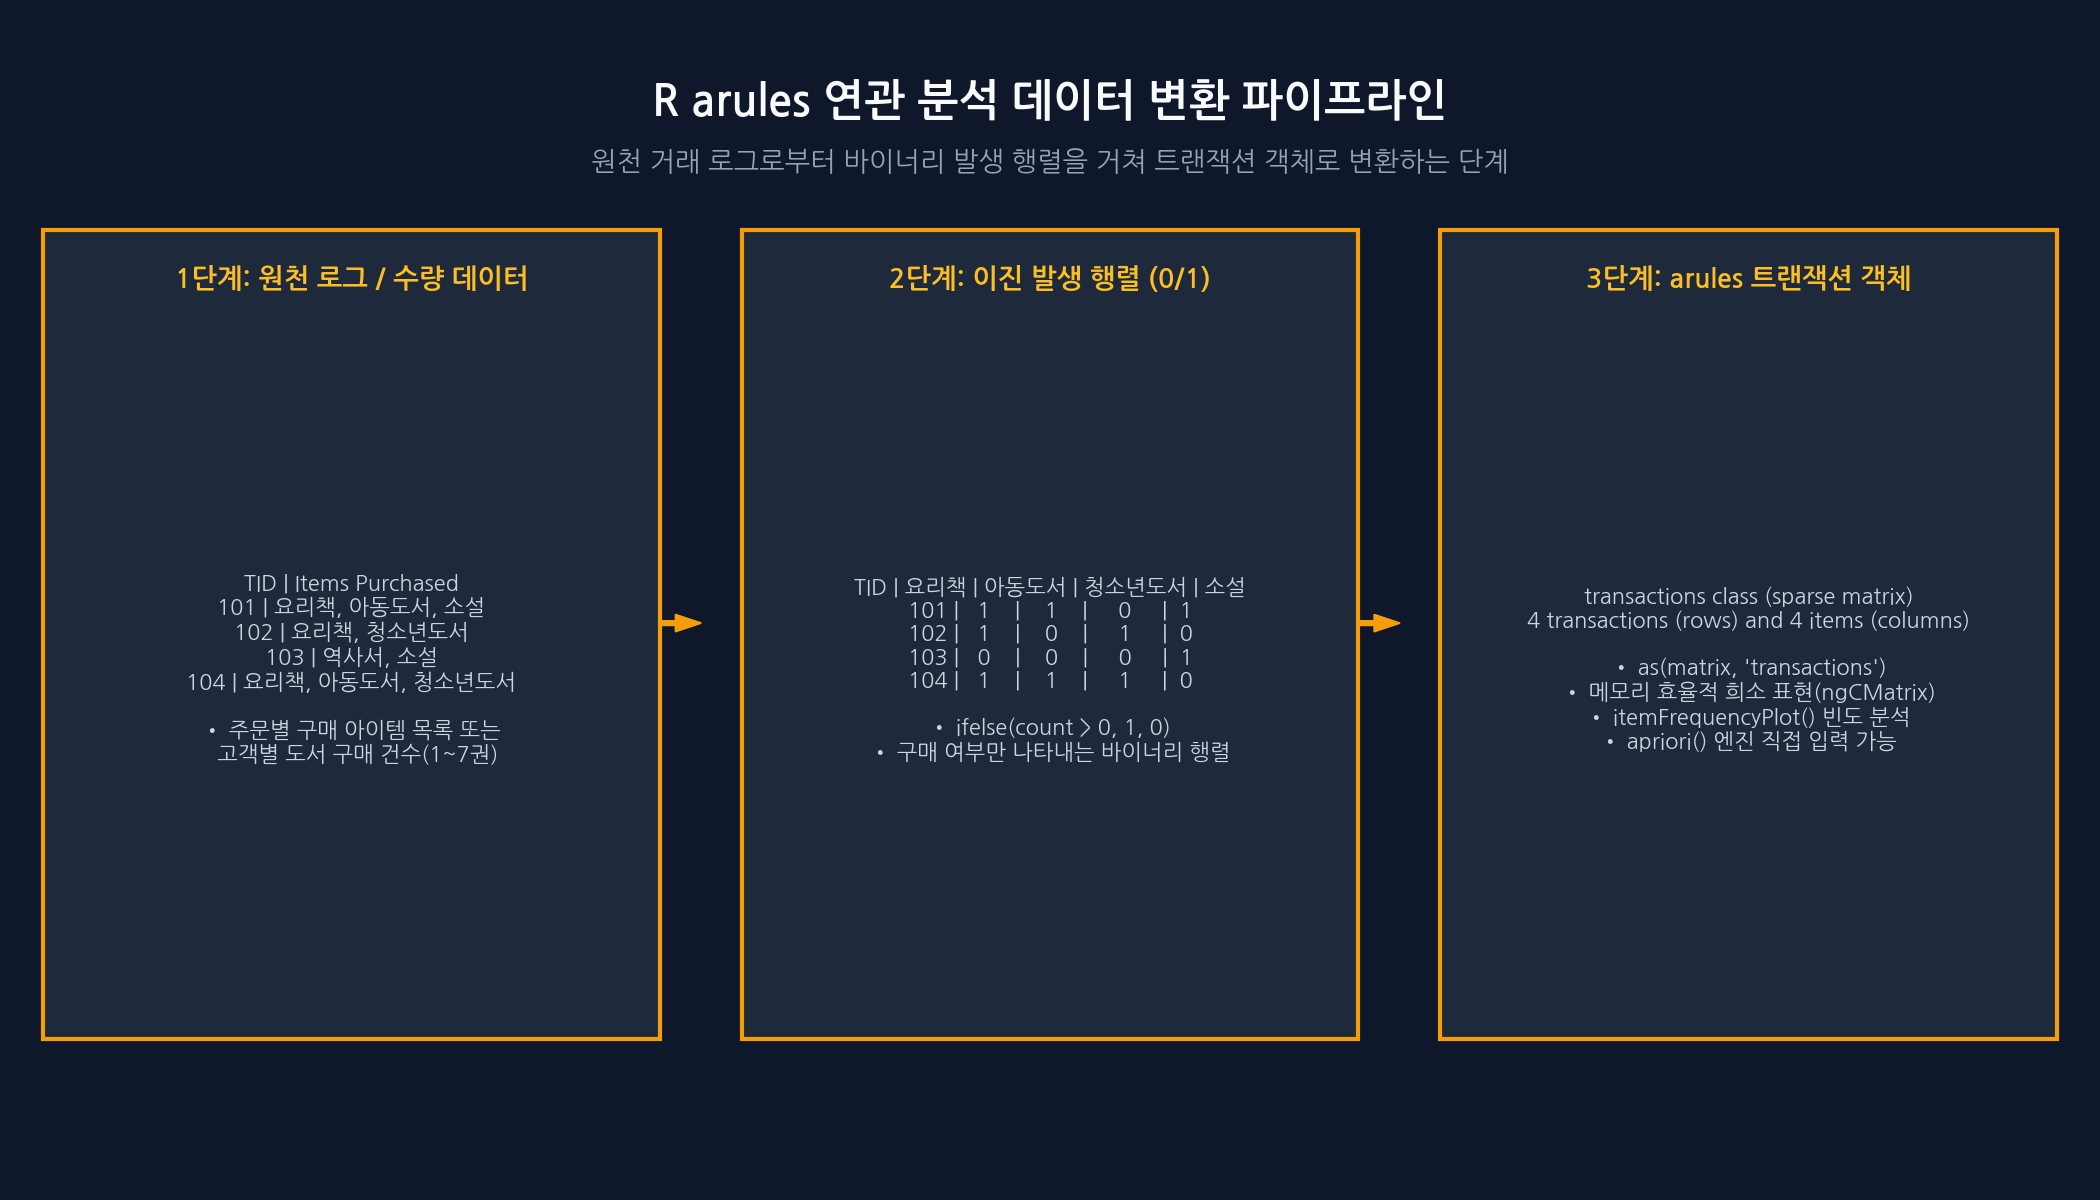
- 원천 데이터: 주문별 영수증 로그(TID와 품목명) 또는 고객별 품목 구매 수량(1~7권) 형태입니다.
- 이진 발생 행렬 (Binary Incidence Matrix): 구매 수량이 얼마이든 연관 분석은 ’구매 여부(0 또는 1)’만 고려하므로
ifelse(count > 0, 1, 0)으로 변환합니다. transactions희소 행렬 객체: 대다수의 고객은 매장의 수많은 상품 중 극히 일부만 구매하므로, 데이터의 대부분이 0으로 채워진 희소 행렬(Sparse Matrix)입니다.as(mat, "transactions")를 실행하면 메모리 낭비를 방지하는 고효율ngCMatrix구조로 압축 변환됩니다.
4. CharlesBookClub 도서 구매 실전 실습
찰스 북클럽(CharlesBookClub) 데이터셋은 4,000명의 회원이 구매한 11개 도서 카테고리(아동도서, 요리책, 청소년도서, 역사서 등)의 구매 이력을 담고 있습니다. 이를 활용하여 연관 규칙을 도출해 보겠습니다.
# 필수 패키지 로드
library(tidyverse)
library(arules)
library(arulesViz)

# 1. 데이터 불러오기 및 가상 데이터 생성 (실습 재현용)
set.seed(42)
n_cust <- 1000

# 11개 도서 카테고리 구매 여부 시뮬레이션
book_data <- tibble(
  UserID   = 1:n_cust,
  ChildBks = rbinom(n_cust, 1, 0.42),
  YouthBks = rbinom(n_cust, 1, 0.25),
  CookBks  = rbinom(n_cust, 1, 0.44),
  DoItYBks = rbinom(n_cust, 1, 0.28),
  RefBks   = rbinom(n_cust, 1, 0.21),
  ArtBks   = rbinom(n_cust, 1, 0.24),
  GeogBks  = rbinom(n_cust, 1, 0.27),
  ItalCook = rbinom(n_cust, 1, 0.11),
  ItalAtlas= rbinom(n_cust, 1, 0.04)
)

# 2. 이진 행렬 및 arules transactions 객체 변환
incid_mat <- as.matrix(book_data %>% select(-UserID))
books_trans <- as(incid_mat, "transactions")

# 트랜잭션 기본 정보 확인
summary(books_trans)

# 3. 품목별 지지도(구매 빈도) 상위 8개 시각화
itemFrequencyPlot(
  books_trans,
  topN = 8,
  col = "#f59e0b",
  main = "Top 8 Frequent Book Categories",
  ylab = "Relative Item Frequency (Support)"
)
4.1 Apriori 알고리즘 실행 및 규칙 필터링
이제 최소 지지도(0.05)와 최소 신뢰도(0.5) 조건을 부여하여 연관 규칙을 마이닝합니다:
# 4. Apriori 알고리즘 실행
rules <- apriori(
  books_trans,
  parameter = list(
    supp   = 0.05,        # 전체 거래의 최소 5% 이상 발생
    conf   = 0.50,        # 조건절 구매 시 최소 50% 이상 동반 구매
    minlen = 2,           # 최소 2개 이상 아이템 포함 (LHS 1개 + RHS 1개)
    maxlen = 4,           # 최대 4개 아이템까지 탐색
    target = "rules"
  )
)

cat("생성된 총 연관 규칙 수:", length(rules), "\n")

# 5. 향상도(Lift) 기준 내림차순 정렬 및 상위 규칙 확인
inspect(head(sort(rules, by = "lift"), n = 5))
4.2 비즈니스 타겟 맞춤형 규칙 서브셋 추출
만약 마케팅 팀에서 “요리책(CookBks)의 판매량을 늘리기 위해, 어떤 책을 장바구니에 담은 고객에게 요리책을 추천해야 하는가?”를 묻는다면, 결과절(RHS)이 CookBks인 규칙만 필터링합니다:
# 6. 특정 타겟 상품(RHS == CookBks) 추천 규칙 서브셋 추출
cook_rules <- subset(rules, rhs %in% "CookBks" & lift > 1.2)

# Tibble 변환 후 가독성 높은 표 형태로 정리
rules_df <- cook_rules %>%
  DATAFRAME() %>%
  as_tibble() %>%
  arrange(desc(lift))

print(head(rules_df, 10))
분석 결과, 예를 들어 {ChildBks, DoItYBks} => {CookBks} 규칙의 향상도가 1.6 이상이고 신뢰도가 70%를 상회한다면, 아동도서와 DIY 도서를 함께 장바구니에 담은 학부모 고객층에게 요리책 할인 쿠폰을 발급하거나 결제 직전 추천 팝업을 노출하는 전략이 데이터 기반으로 입증됩니다.
5. arulesViz 기반 규칙 시각화
텍스트 표로 된 수십 개의 규칙을 비즈니스 의사결정자에게 전달하는 것은 설득력이 떨어집니다. arulesViz 패키지를 사용하면 규칙의 전체 조감도와 품목 간 네트워크를 아름답게 시각화할 수 있습니다.
5.1 그룹화 매트릭스 플롯 (Grouped Matrix Plot)
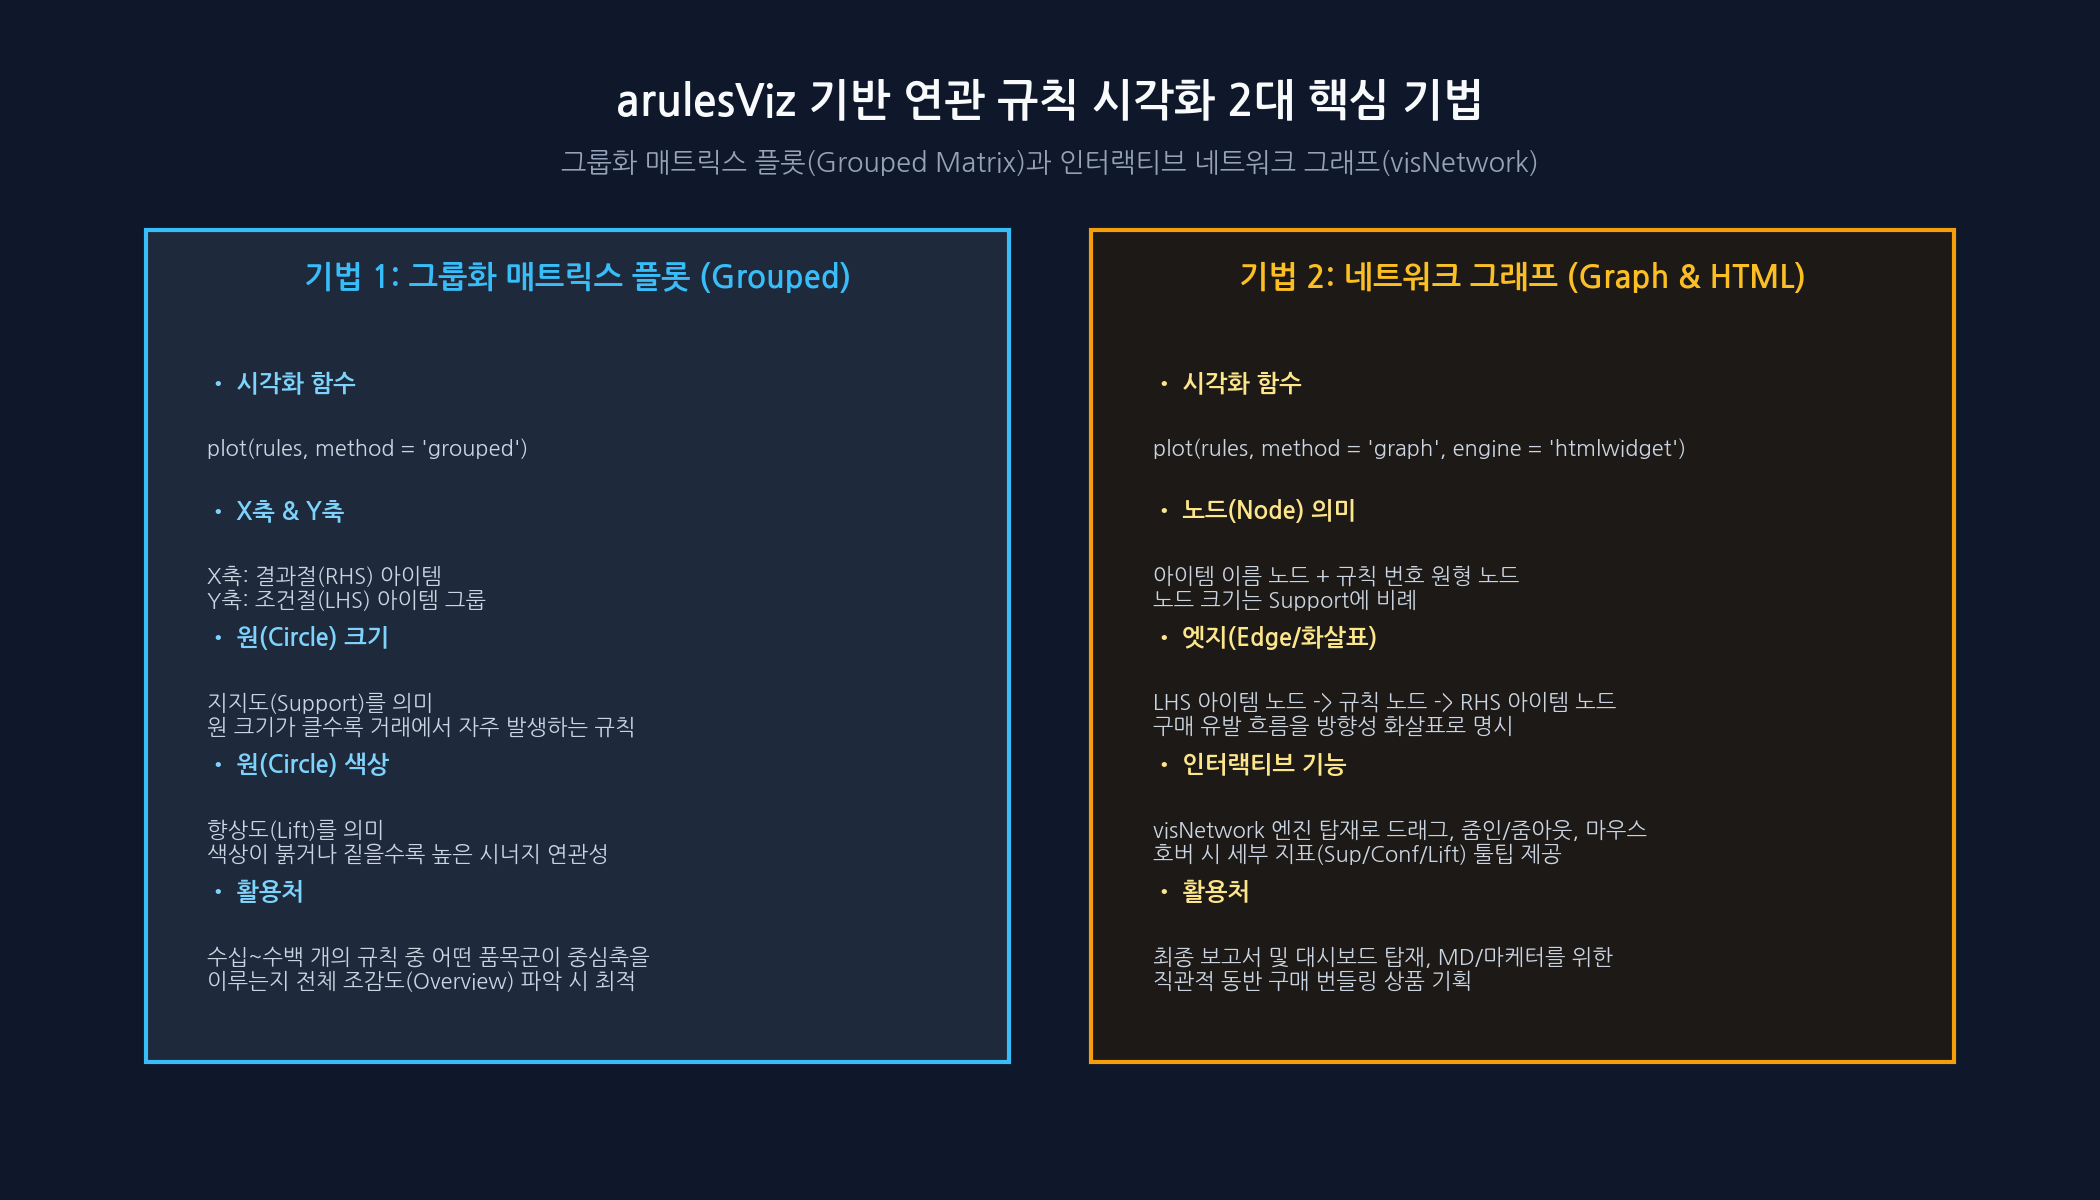
조건절(LHS) 그룹과 결과절(RHS) 간의 전체적인 규칙 분포를 2차원 버블 차트로 조망합니다:
# 그룹화 매트릭스 시각화 (버블 크기: Support, 버블 색상: Lift)
plot(sort(rules, by = "lift")[1:20], method = "grouped")
5.2 인터랙티브 네트워크 그래프 (visNetwork)
D3.js / visNetwork 기반의 동적 HTML 위젯 그래프를 생성하여, 마우스 드래그와 확대/축소, 툴팁 확인이 가능한 웹용 다이어그램을 출력합니다:
# 인터랙티브 네트워크 그래프 출력 (상위 15개 규칙 대상)
plot(
  sort(rules, by = "lift")[1:15],
  method = "graph",
  engine = "htmlwidget"
)
이 네트워크 그래프에서는 각 도서 카테고리가 원형 노드로 표시되고, 화살표 엣지를 통해 어떤 품목이 결합되어 어떤 품목으로 유입되는지 직관적인 구매 유발 동선(Flow)을 파악할 수 있습니다.
6. 실무 적용 시 3대 주의사항
연관 분석을 실제 이커머스나 리테일 실무에 적용할 때 반드시 점검해야 할 체크리스트입니다:
- 상식적이거나 자명한 규칙(Trivial Rules)의 함정
- 예:
{컴퓨터 본체} => {모니터},{햄버거} => {콜라}
- 이러한 규칙은 신뢰도와 지지도가 매우 높게 나오지만, 비즈니스적으로 누구나 아는 당연한 사실입니다. 분석가의 역할은 데이터 속에서 인간의 직관으로 쉽게 떠올리기 어려운 ‘비자명하지만 높은 향상도를 가진 숨은 규칙(Hidden Gems)’을 발굴하는 것입니다.
- 예:
- 최소 지지도(min_sup) 설정의 딜레마
- 지지도를 너무 높게 잡으면 매출 기여도가 높은 틈새 상품(고가 프리미엄 가전, 명품 등)의 의미 있는 규칙이 모두 잘려나갑니다.
- 반대로 지지도를 너무 낮게 잡으면 잡음(Noise)에 불과한 수십만 개의 잉여 규칙이 생성되어 알고리즘이 멈추게 됩니다. 품목의 단가와 거래 빈도에 맞추어 지지도를 단계적으로 낮추며 튜닝해야 합니다.
- 잉여 규칙(Redundant Rules)의 사전 제거
{A} => {B}의 신뢰도가 0.8인데,{A, C} => {B}의 신뢰도도 0.8이라면 품목 C는 규칙에 아무런 가치를 더하지 못하는 불필요한 노이즈입니다.arules::is.redundant()함수를 사용하여 상위 규칙에 종속된 중복 규칙들을 정기적으로 청소해야 합니다.
7. 마치며: 고객의 무의식적 구매 동선을 설계하는 법
연관 분석(Market Basket Analysis)은 고객이 매장이나 웹사이트를 돌아다니며 남긴 영수증과 클릭 로그 속에서 인간의 무의식적인 동반 행동 패턴을 수학적으로 건져 올리는 강력한 데이터 마이닝 도구입니다.
지지도(Support)로 실효성을 검증하고, 신뢰도(Confidence)로 인과적 확신을 다지며, 향상도(Lift)를 통해 진정한 시너지 아이템을 판별해 내는 능력은 데이터 사이언티스트와 마케터 모두에게 필수적인 소양입니다.
이번 글에서 살펴본 Apriori 알고리즘의 가지치기 원리와 R arules 파이프라인, 그리고 네트워크 시각화 기법을 바탕으로 여러분의 비즈니스 데이터 속에 잠들어 있는 숨은 연관 규칙을 발굴해 보시기 바랍니다.
💡 연관 포스트 안내
- 인공신경망(ANN) 완벽 입문 가이드: 퍼셉트론·역전파 수학적 원리부터 R 실습까지
- 교차분석과 카이제곱 독립성 검정 완벽 가이드: 분할표 통계 원리부터 R 실습까지
- 서포트 벡터 머신(SVM) 완전 정복: 마진 최대화부터 커널 트릭, SVR & R 실습