넷플릭스에 접속했을 때 메인 화면에 뜨는 ‘회원님을 위한 추천 콘텐츠’, 아마존에서 상품을 장바구니에 담았을 때 나타나는 ‘이 상품을 구매한 고객이 함께 본 상품’, 유튜브와 스포티파이의 끊김 없는 개인화 플레이리스트. 이 모든 서비스의 이면에는 사용자의 취향을 정밀하게 저격하는 추천 시스템(Recommender Systems)이 작동하고 있습니다.
2006년 넷플릭스는 기존 자사 추천 알고리즘(Cinematch)의 정확도를 10% 향상시키는 팀에게 100만 달러(약 13억 원)의 상금을 내걸고 ‘넷플릭스 프라이즈(Netflix Prize)’ 대회를 개최했습니다. 전 세계 수만 명의 머신러닝 연구자들이 격돌했던 이 대회에서 승리를 거머쥔 핵심 알고리즘의 뼈대가 바로 협업 필터링(Collaborative Filtering, CF)입니다.
아이템의 텍스트나 장르 같은 메타데이터를 분석하는 내용 기반 필터링(Content-based Filtering)과 달리, 협업 필터링은 오직 사용자들의 과거 행동 로그(평점, 클릭, 구매)라는 집단 지성(Wisdom of the Crowds)에만 기반하여 놀라운 수준의 ’의외의 발견(Serendipity)’을 선사합니다.
이번 글에서는 협업 필터링의 양대 산맥인 사용자 기반(UBCF)과 아이템 기반(IBCF)의 수학적 원리와 유사도 측정 기법, 사용자 편향(Rating Bias)을 보정한 평점 예측 공식을 깊이 있게 다루고, R의 대표 추천 패키지인 recommenderlab을 활용하여 Top-N 추천 및 evaluationScheme 기반의 정밀 검증 파이프라인을 구축해 보겠습니다.
1. UBCF vs IBCF: 추천의 주체와 시스템 확장성
협업 필터링은 누구를 기준으로 ’이웃(Neighbor)’을 정의하느냐에 따라 크게 두 가지 방식으로 나뉩니다.
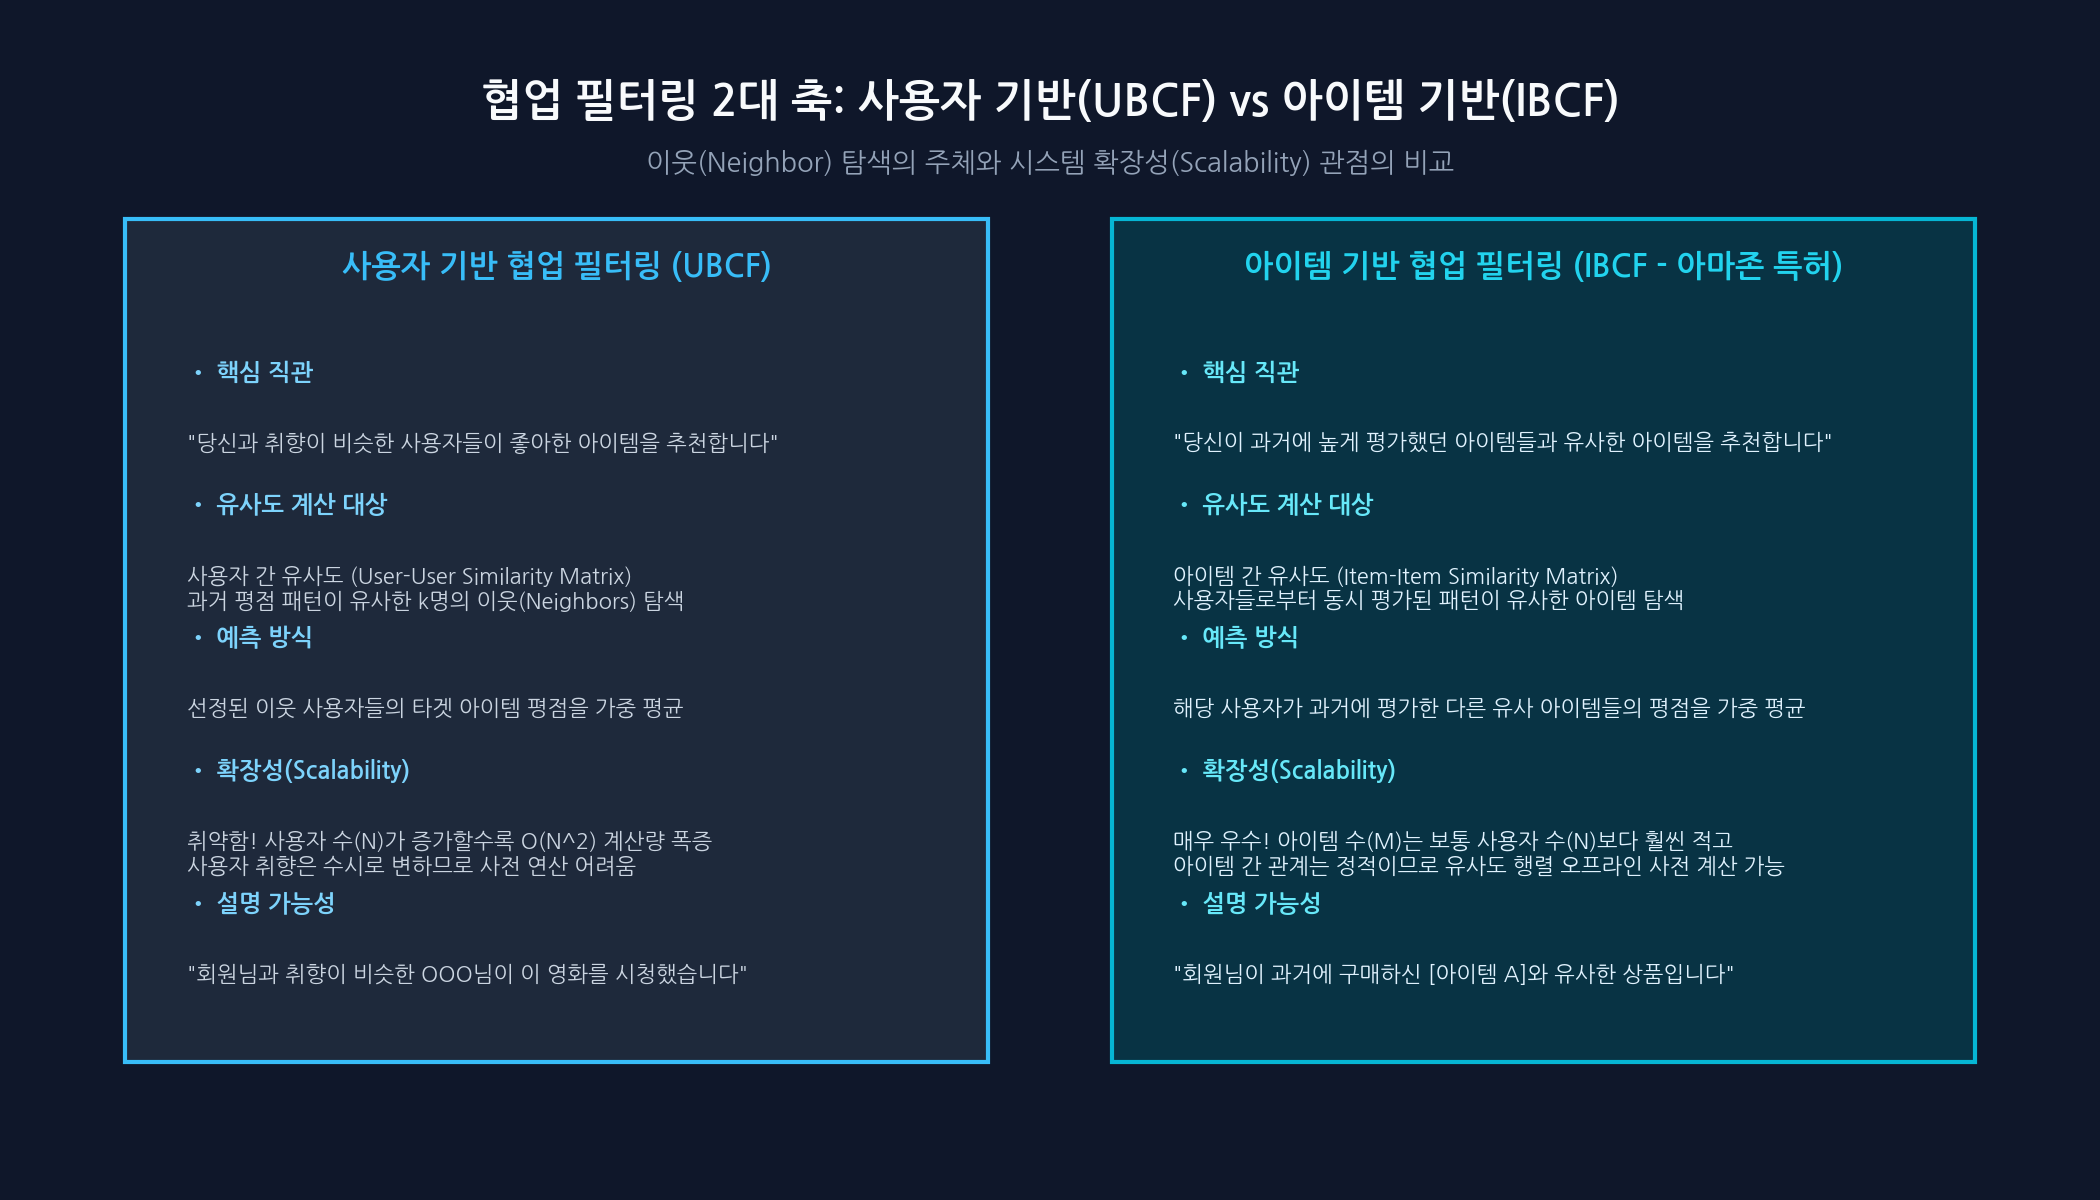
1.1 사용자 기반 협업 필터링 (User-Based Collaborative Filtering, UBCF)
- 핵심 철학: “당신과 과거에 비슷한 영화를 좋아했던 저 사람들은 이 영화도 좋아했습니다.”
- 작동 메커니즘:
- 타겟 사용자 \(u\)와 전체 사용자 풀 간의 평점 유사도를 계산합니다.
- \(u\)와 취향이 가장 비슷한 상위 \(k\)명의 이웃(Neighbors)을 선정합니다.
- 이웃들이 높게 평가했지만 사용자 \(u\)는 아직 보지 않은 아이템들을 찾아 추천합니다.
- 치명적 단점 (확장성 한계):
넷플릭스나 유튜브처럼 사용자가 수억 명(\(N \approx 10^8\))에 달하는 플랫폼에서는 사용자 간 유사도 행렬의 크기가 \(O(N^2)\)로 폭증합니다. 게다가 사용자의 취향과 평점은 시시각각 변하므로 유사도 행렬을 오프라인에서 미리 계산해 두기 어렵습니다.
1.2 아이템 기반 협업 필터링 (Item-Based Collaborative Filtering, IBCF)
- 핵심 철학: “당신이 과거에 높게 평가했던 [인셉션]과 평가 패턴이 매우 유사한 [인터스텔라]를 추천합니다.”
- 작동 메커니즘:
- 모든 아이템 쌍 간의 평가 패턴 유사도를 계산합니다 (사용자들이 아이템 A와 아이템 B에 얼마나 비슷한 평점을 주었는가).
- 타겟 사용자 \(u\)가 과거에 높은 평점을 주었던 아이템들과 유사도가 높은 아이템을 찾아 추천합니다.
- 아마존의 대성공 비결 (Greg Linden et al., 2003):
아마존과 같은 리테일 플랫폼에서는 사용자 수(\(N\))가 아이템 수(\(M\))보다 훨씬 많습니다 (\(N \gg M\)). 또한 아이템 간의 관계(예: 해리포터 1편과 2편의 유사도)는 매우 정적(Static)이어서, 아이템 유사도 행렬을 매일 밤 오프라인 배치(Batch)로 미리 계산해 둘 수 있습니다. 실시간 서비스 단계에서는 \(O(1)\)의 초고속 조회만으로 즉각적인 추천이 가능해집니다.
2. 협업 필터링의 수학적 원리: 유사도와 평점 예측 공식
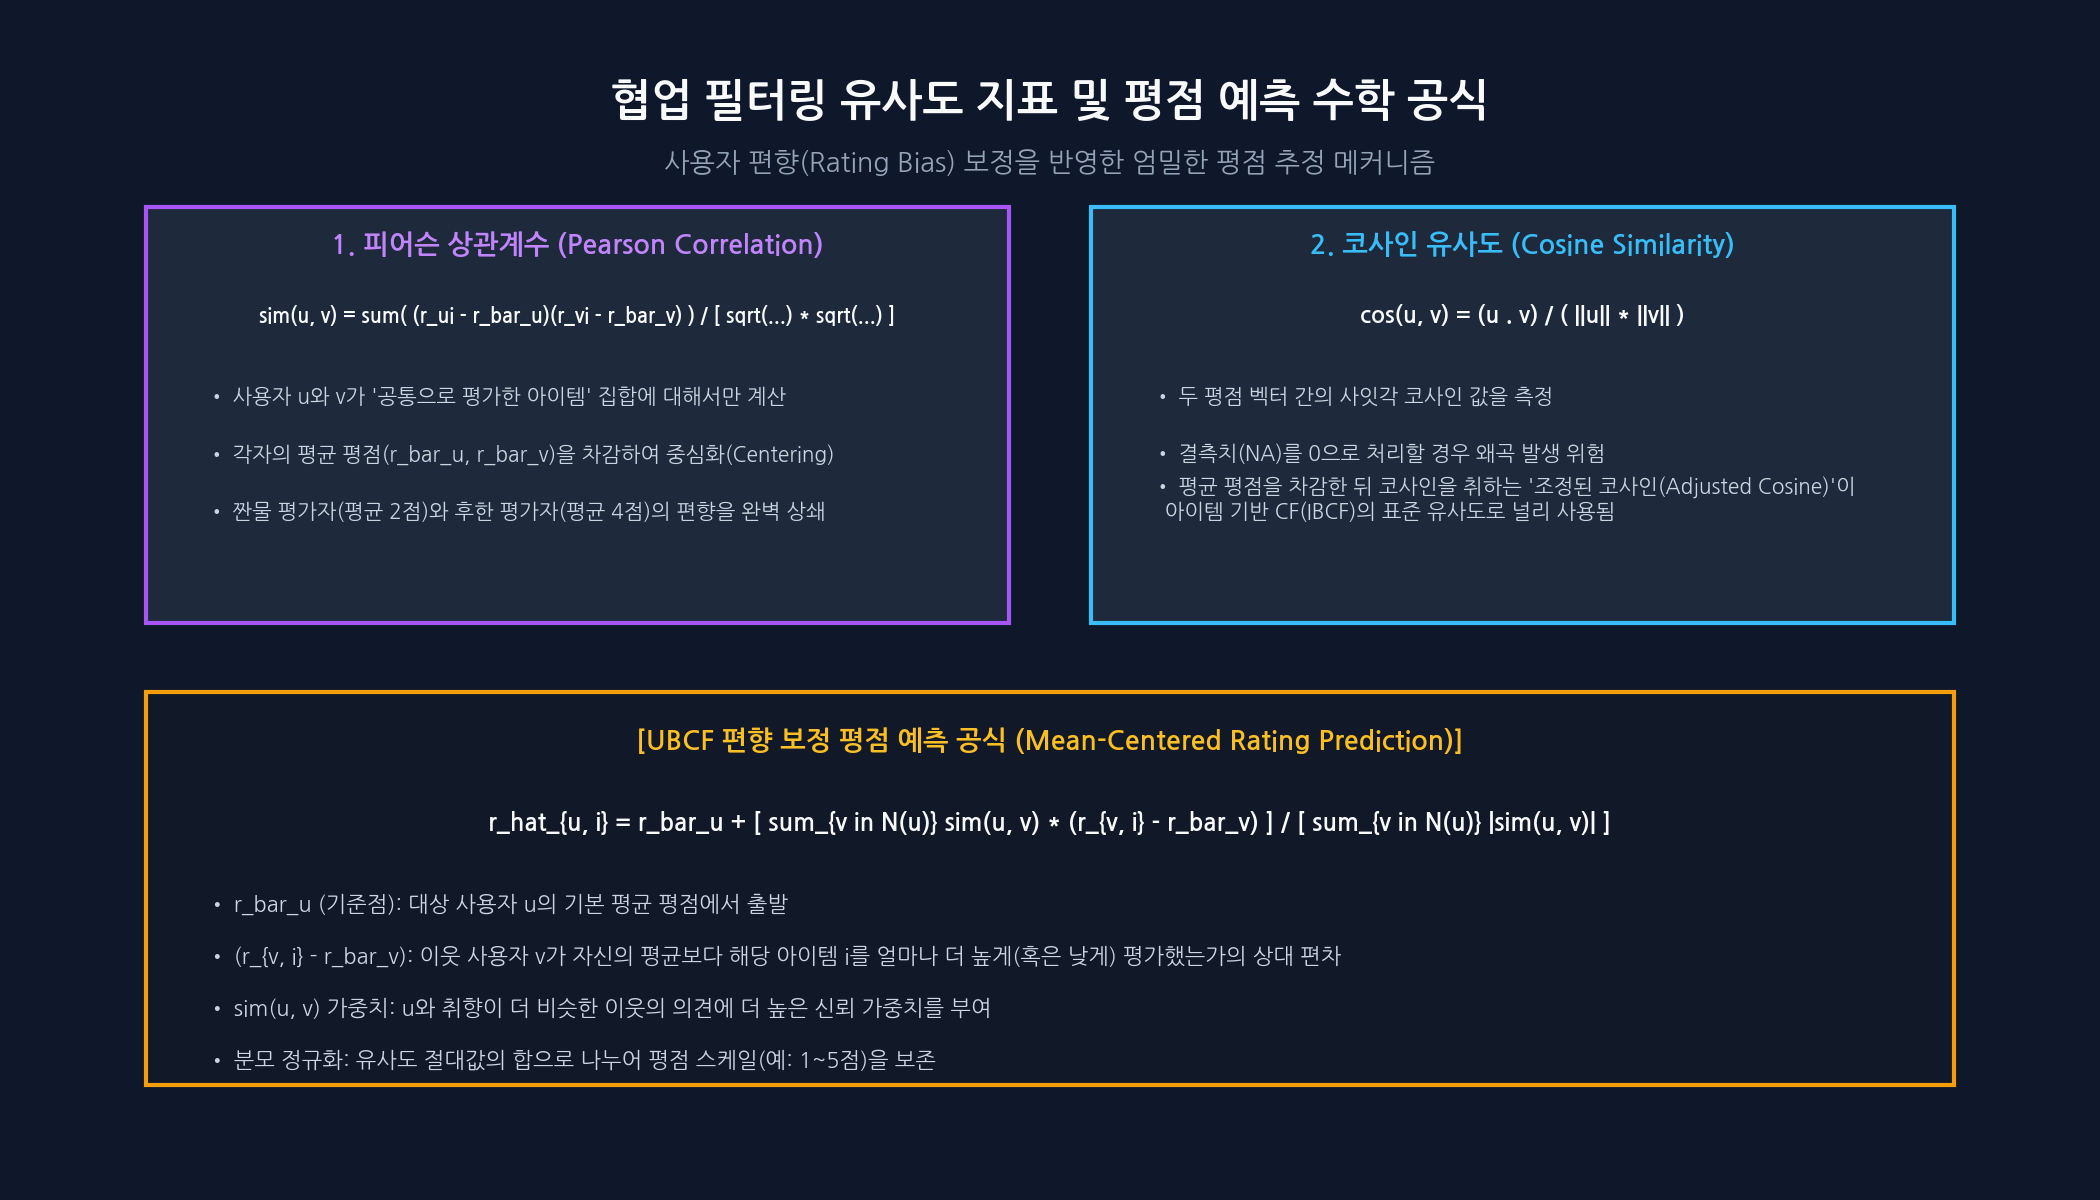
단순히 이웃들의 평점을 산술 평균하면 심각한 왜곡이 발생합니다. 어떤 사용자는 평점을 아주 후하게 주어 평균 4.5점을 주는 반면, 어떤 사용자는 매우 엄격하여 평균 2.0점을 주기 때문입니다. 이를 수학적으로 해결하는 표준적인 수식을 살펴보겠습니다.
2.1 유사도 측정 지표: 피어슨 상관계수 (Pearson Correlation)
두 사용자 \(u\)와 \(v\) 사이의 유사도를 구할 때 가장 널리 쓰이는 지표는 피어슨 상관계수입니다. 두 사용자가 공통으로 평가한 아이템 집합(\(I_{uv}\))에 대해서만 계산합니다:
\[\text{sim}(u, v) = \frac{\sum_{i \in I_{uv}} (r_{u,i} - \bar{r}_u)(r_{v,i} - \bar{r}_v)}{\sqrt{\sum_{i \in I_{uv}} (r_{u,i} - \bar{r}_u)^2} \sqrt{\sum_{i \in I_{uv}} (r_{v,i} - \bar{r}_v)^2}}\]
- \(\bar{r}_u, \bar{r}_v\): 각 사용자의 전체 평균 평점
- 핵심 원리: 각 사용자의 평균 평점을 빼줌으로써(Mean-centering), 후한 평가자와 짠물 평가자의 개인별 평점 성향(Rating Bias)을 완벽하게 제거합니다. 상관계수가 1에 가까울수록 두 사용자는 상대적인 호불호 패턴이 정확히 일치함을 뜻합니다.
2.2 사용자 편향 보정 평점 예측 공식 (Mean-Centered Rating Prediction)
사용자 \(u\)가 아직 보지 않은 아이템 \(i\)에 대해 부여할 가상 평점 \(\hat{r}_{u,i}\)는 다음과 같이 추정됩니다:
\[\hat{r}_{u,i} = \bar{r}_u + \frac{\sum_{v \in N(u)} \text{sim}(u, v) \cdot (r_{v,i} - \bar{r}_v)}{\sum_{v \in N(u)} |\text{sim}(u, v)|}\]
이 공식은 4가지 정교한 수학적 장치를 담고 있습니다: 1. 기준점 (\(\bar{r}_u\)): 사용자 \(u\)의 평소 평균 평점을 기본 베이스라인으로 설정합니다. 2. 이웃의 상대 편차 (\(r_{v,i} - \bar{r}_v\)): 이웃 \(v\)가 아이템 \(i\)를 자신의 평균보다 얼마나 더 높게(혹은 낮게) 평가했는지를 측정합니다. 3. 유사도 가중치 (\(\text{sim}(u, v)\)): \(u\)와 취향이 더 비슷한 이웃의 의견일수록 최종 결과에 더 큰 영향력을 행사합니다. 4. 분모 정규화 (\(\sum |\text{sim}|\) ): 가중치의 합으로 나누어 최종 예측 평점이 원래의 평점 척도(예: 1~5점)를 벗어나지 않도록 보존합니다.
3. R recommenderlab 데이터 구조: realRatingMatrix vs binaryRatingMatrix
추천 시스템 데이터의 99% 이상은 사용자가 평가하지 않은 결측치(NA)로 채워져 있습니다. R의 recommenderlab 패키지는 대규모 평점 데이터를 메모리 효율적으로 다루기 위해 특수한 S4 희소 행렬(Sparse Matrix) 클래스를 제공합니다.
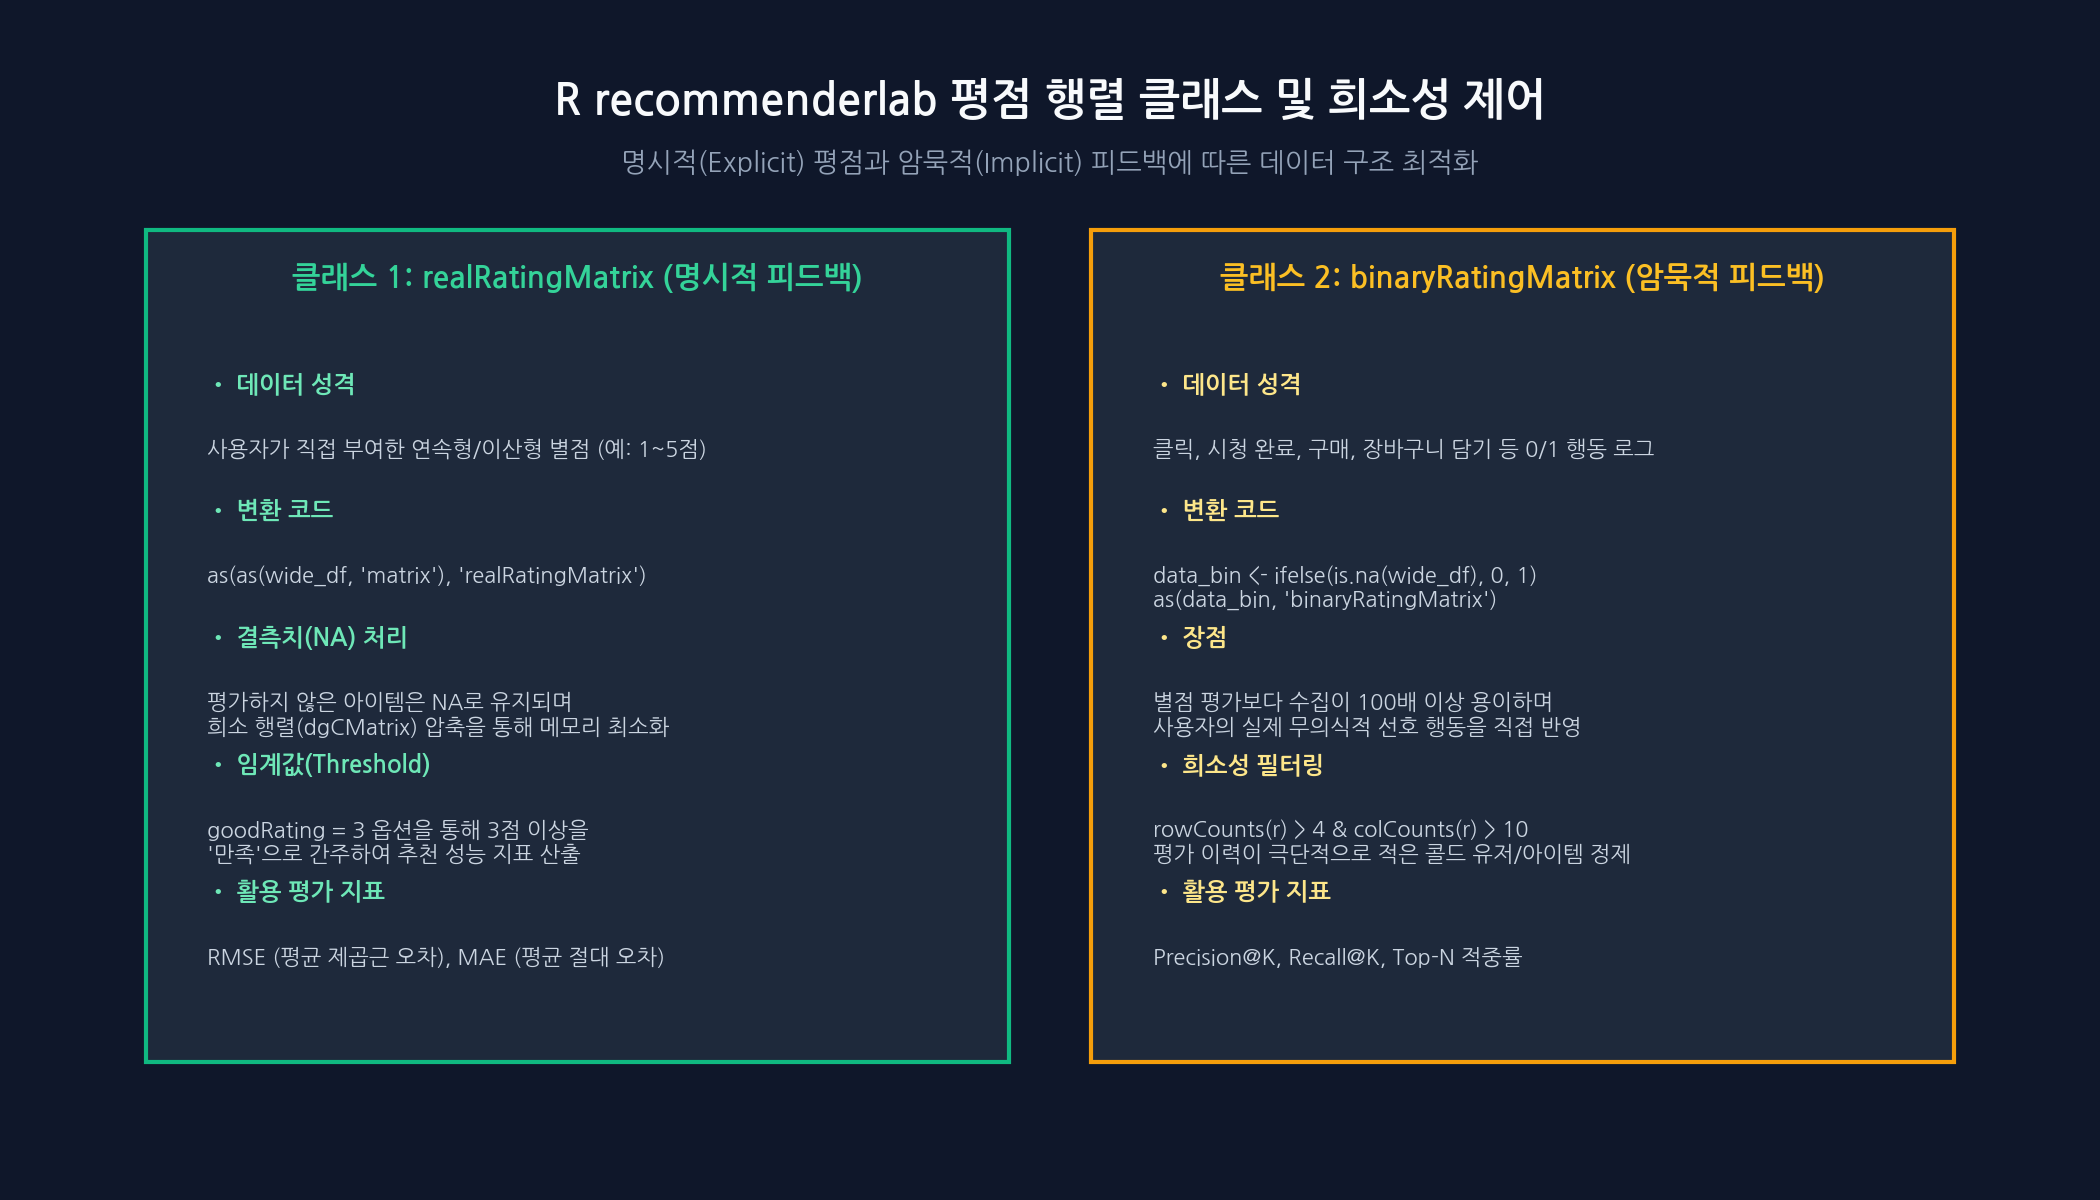
| 클래스명 | 피드백 성격 | 데이터 형태 | 주요 활용 목적 및 평가 지표 |
|---|---|---|---|
realRatingMatrix |
명시적(Explicit) 피드백 | 1~5점 별점 등 연속형/이산형 수치 (미평가 항목은 NA) | 평점 예측 정확도 측정 (RMSE, MAE), 별점 추천 |
binaryRatingMatrix |
암묵적(Implicit) 피드백 | 클릭, 장바구니, 시청 여부 등 0 또는 1의 바이너리 로그 | Top-N 랭킹 추천, 적중률(Hit Ratio), Precision@K |
실무에서는 평가 건수가 3~4개 미만인 신규 유저나 평가를 거의 받지 못한 비인기 아이템이 노이즈를 유발하므로, rowCounts(r) > 4 및 colCounts(r) > 10 같은 임계치 필터링을 사전에 수행해야 합니다.
4. R 실무 실습: 데이터 전처리부터 Top-5 추천까지
실제 추천 시스템 모델링 과정을 코드로 구현해 보겠습니다. 긴 형태(Long format)의 원천 로그를 와이드 평점 행렬로 피벗하고, recommenderlab 객체로 변환하여 모델을 학습합니다.
# 필수 패키지 로드
library(tidyverse)
library(recommenderlab)

# 1. 재현 가능한 가상 영화 평점 로그 데이터 생성 (User, Movie, Rating)
set.seed(42)
n_records <- 1200
sample_logs <- tibble(
  user_id  = paste0("User_", sample(1:80, n_records, replace = TRUE)),
  movie_id = paste0("Movie_", sample(1:30, n_records, replace = TRUE)),
  rating   = sample(1:5, n_records, replace = TRUE, prob = c(0.1, 0.15, 0.3, 0.25, 0.2))
) %>%
  distinct(user_id, movie_id, .keep_all = TRUE) # 중복 평가 제거

# 2. Long 포맷 -> Wide 포맷 (User-Item Matrix) 피벗 변환
rating_wide <- sample_logs %>%
  pivot_wider(names_from = movie_id, values_from = rating) %>%
  column_to_rownames(var = "user_id")

# 3. realRatingMatrix S4 희소 행렬 객체로 변환
r_mat <- as(as.matrix(rating_wide), "realRatingMatrix")

# 희소 행렬 기본 요약 확인
summary(r_mat)
cat("총 사용자 수:", nrow(r_mat), "| 총 영화 수:", ncol(r_mat), "\n")

# 4. 활동성이 충분한 사용자 필터링 (최소 5편 이상 평가한 사용자만 유지)
r_clean <- r_mat[rowCounts(r_mat) >= 5]

# 5. 학습용(70%) 및 검증용(30%) 사용자 분할
set.seed(123)
n_users <- nrow(r_clean)
train_idx <- sample(1:n_users, size = floor(n_users * 0.7))

train_data <- r_clean[train_idx]
test_data  <- r_clean[-train_idx]
4.1 UBCF 및 IBCF 추천 모델 생성 및 Top-5 추천 추출
피어슨 상관계수를 기반으로 하는 사용자 기반 협업 필터링 모델을 생성하고, 테스트 사용자를 위한 상위 5개 추천 아이템을 도출합니다:
# 6. UBCF 추천 모델 학습 (피어슨 상관계수, 이웃 수 nn = 20)
ubcf_model <- Recommender(
  data      = train_data,
  method    = "UBCF",
  parameter = list(method = "pearson", nn = 20)
)

# 7. 테스트 데이터 내 사용자별 상위 5개(Top-5) 영화 추천 리스트 생성
pred_top5 <- predict(ubcf_model, newdata = test_data, n = 5)

# 추천 결과 인덱스를 실제 영화명 데이터프레임으로 매핑
top5_recommendations <- map_df(pred_top5@items, function(item_indices) {
  if (length(item_indices) == 0) {
    return(tibble(V1 = NA, V2 = NA, V3 = NA, V4 = NA, V5 = NA))
  }
  recs <- colnames(test_data)[item_indices]
  length(recs) <- 5 # 5개 길이로 맞춤
  as_tibble(as.list(recs))
})

# 상위 5개 사용자 추천 결과 확인
head(top5_recommendations, 5)
5. evaluationScheme을 활용한 정밀 검증 프로토콜
추천 모델을 일반 머신러닝처럼 단순히 Train/Test로 나누면 안 됩니다. 테스트 사용자가 가진 모든 평점을 모델에 주어버리면 추천할 대상이 남지 않기 때문입니다.
recommenderlab은 추천 시스템의 현실적 사용 시나리오를 반영한 Given-Holdout 프로토콜 (evaluationScheme)을 제공합니다.
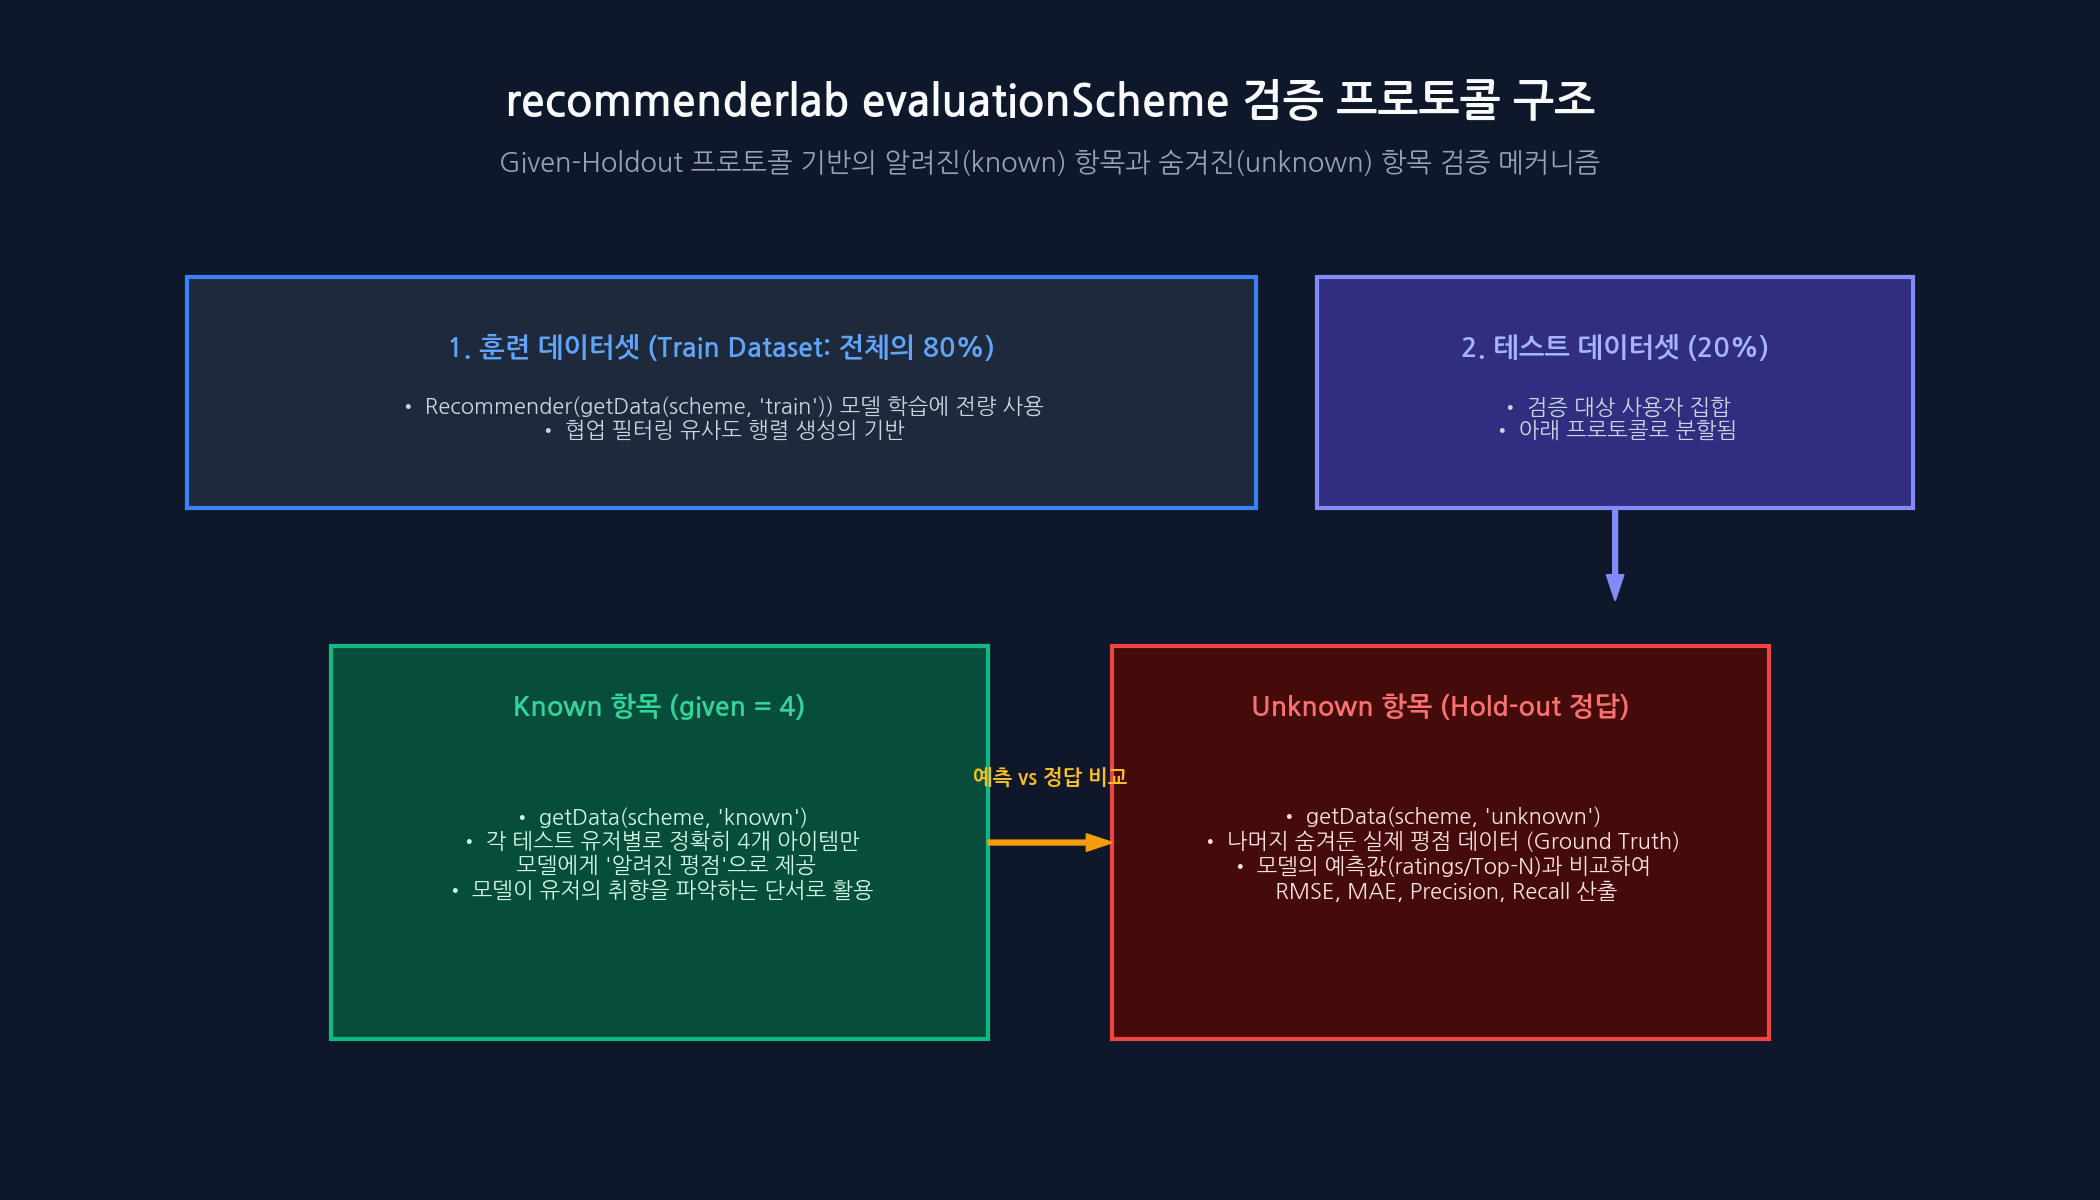
train(80%): 추천 모델의 유사도 행렬을 학습하는 사용자들given = 4(Known): 검증 대상 사용자의 전체 평점 중 정확히 4개만 모델에게 힌트로 제공하여 사용자의 취향을 파악하게 함unknown(Hold-out 정답): 모델에게 감추어둔 나머지 실제 평점들. 모델이 예측한 평점과 비교하여 오차(RMSE, MAE)를 산출하는 기준 정답
# 1. 5-Fold 교차 검증 평가 체계(evaluationScheme) 구축
set.seed(42)
scheme <- evaluationScheme(
  data        = r_clean,
  method      = "cross-validation",
  k           = 5,
  given       = 4,            # 테스트 유저마다 4개 평점만 모델에 공개
  goodRating  = 3             # 3점 이상을 만족으로 판단
)

# 2. 훈련 세트로 모델 학습
cv_model <- Recommender(
  data      = getData(scheme, "train"),
  method    = "UBCF",
  parameter = list(method = "pearson", nn = 25)
)

# 3. Known 데이터를 바탕으로 미평가 아이템들의 평점 예측 (type = 'ratings')
pred_ratings <- predict(
  cv_model,
  newdata = getData(scheme, "known"),
  type    = "ratings"
)

# 4. Unknown 실제 정답과 비교하여 최종 오차 지표 산출
accuracy_results <- calcPredictionAccuracy(
  x    = pred_ratings,
  data = getData(scheme, "unknown")
)

print(accuracy_results)
산출된 RMSE(Root Mean Squared Error)와 MAE(Mean Absolute Error)를 통해, 우리 모델이 사용자의 실제 만족도를 평균 몇 점 오차 범위 내에서 정확하게 예측하고 있는지 객관적으로 검증할 수 있습니다.
6. 협업 필터링 실무의 3대 한계와 현대적 극복 방안
협업 필터링을 현업 서비스에 도입할 때 반드시 마주치는 구조적 한계와 해결책입니다:
- 콜드 스타트(Cold Start) 문제
- 신규 가입자나 새로 등록된 상품은 과거 평가 이력이 전혀 없어 추천 대상에서 완전히 배제됩니다.
- 해결책: 신규 유저에게는 초기 가입 시 선호 장르를 선택하게 하거나, 가입 초기에는 대중적 인기 상품(Popularity-based) 또는 메타데이터 기반 내용 기반 필터링(Content-based)을 결합한 하이브리드 추천(Hybrid Recommender)을 적용합니다.
- 데이터 희소성(Sparsity)과 롱테일(Long Tail) 문제
- 수백만 개의 상품 중 상위 1%의 메가 히트 상품에만 평점이 몰리고 나머지 99%는 거의 평가되지 않습니다.
- 해결책: 행렬 분해(Matrix Factorization, SVD) 기법이나 잠재 요인 모델(Latent Factor Models)을 도입하여 고차원 희소 행렬을 저차원의 밀집 임베딩 벡터로 압축합니다.
- 그레이 쉽(Gray Sheep) 문제
- 대중의 취향과 완전히 동떨어진 매우 특이한 취향을 가진 소수 사용자는 어떤 이웃과도 유사도가 높게 나오지 않아 추천 품질이 급격히 저하됩니다.
7. 마치며: 취향을 잇는 추천의 미학
협업 필터링은 복잡한 도메인 지식이나 정교한 특성 공학(Feature Engineering) 없이도, “사람들의 행동 데이터 속에 이미 개인의 취향과 패턴이 새겨져 있다”는 단순하면서도 강력한 전제 위에 세워진 알고리즘입니다.
사용자 기반(UBCF)의 친근한 커뮤니티적 추천부터, 아마존의 확장성을 견인한 아이템 기반(IBCF), 그리고 recommenderlab의 엄밀한 Given-Holdout 검증 체계까지 이해한다면, 여러분의 서비스 사용자들에게 단순한 정보 나열을 넘어 진정한 개인화 경험을 선사할 수 있을 것입니다.
💡 연관 포스트 안내
- 연관 분석(Apriori) 완벽 정복: 지지도·신뢰도·향상도 수학적 원리부터 R 실습까지
- 인공신경망(ANN) 완벽 입문 가이드: 퍼셉트론·역전파 수학적 원리부터 R 실습까지
- 서포트 벡터 머신(SVM) 완전 정복: 마진 최대화부터 커널 트릭, SVR & R 실습